 AIREITER
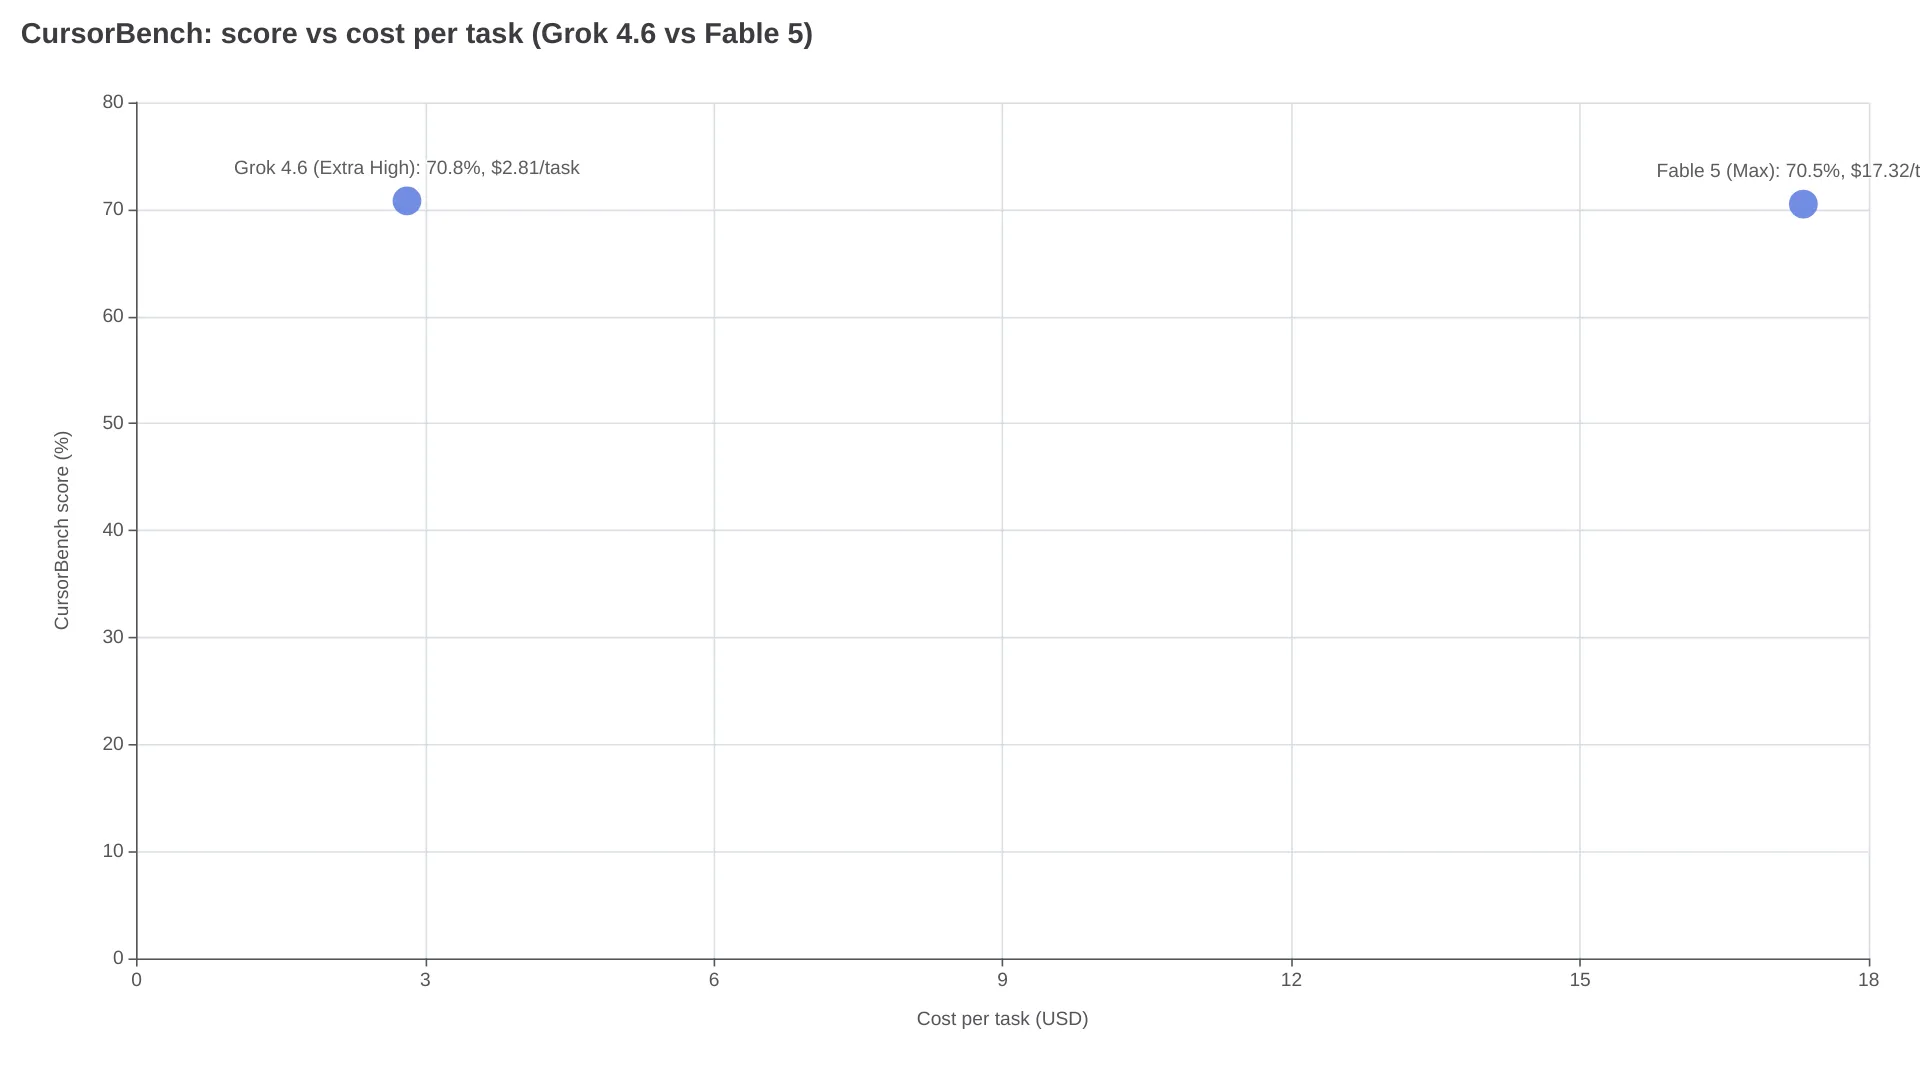
Quando duas IAs entregam praticamente o mesmo resultado em programação, o custo para chegar lá passa a importar muito. No CursorBench, o Grok 4.6 Extra High atingiu 70,8% por US$ 2,81 por tarefa concluída, enquanto o Fable 5 Max marcou 70,5% a um custo de US$ 17,32. É, na prática, um empate no benchmark de agentes de código — com uma diferença de preço de 6x por tarefa. O Fable 5 ainda preserva duas vantagens relevantes: lidera o índice mais amplo de inteligência da Artificial Analysis e tem o dobro da janela de contexto.
Como o Grok 4.6 encostou no Fable 5
Há dois meses, esta comparação tinha um vencedor mais claro. Em julho de 2026, a Artificial Analysis deu 56 pontos ao Grok 4.5 no Intelligence Index, contra 62 do Fable 5 — uma distância de seis pontos. Lançado em agosto de 2026, o Grok 4.6 ganhou cerca de cinco pontos, chegando a ~59 e praticamente empatando com o GPT-5.6 Sol, segundo deltas de benchmark reportados. Com isso, a vantagem do Fable 5 caiu para aproximadamente três pontos.
Entre agentes de programação, a distância encolheu ainda mais. Quando o Fable 5 chegou ao Cursor, em junho de 2026, estabeleceu um novo recorde de 72,9% no CursorBench (r/accelerate), 8 pontos acima do melhor resultado anterior. No confronto publicado no r/cursor em agosto, após o lançamento do Grok 4.6, o Grok 4.6 Extra High fez 70,8%, contra 70,5% do Fable 5 Max. Com o mesmo harness de agente, o resultado é efetivamente um empate. Ainda assim, vale considerar a ressalva de um usuário do Cursor que rodou a comparação:
"O Grok 4.6 me fez pensar: quanto do CursorBench vem do modelo e quanto vem do harness?" - thread no r/cursor, agosto de 2026
As pontuações de benchmark medem toda a pilha do agente — estrutura de prompts, ferramentas e tentativas adicionais —, não apenas o modelo-base. Além disso, os 72,9% obtidos pelo Fable 5 no lançamento e os 70,5% de agosto vieram de configurações diferentes. Portanto, os dois números devem ser vistos como indicativos.
É no custo por tarefa que o Grok 4.6 dispara
Os números por tarefa da comparação de agosto contam a história principal:
| Métrica (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| Pontuação | 70,8% | 70,5% |
| Custo por tarefa | US$ 2,81 | US$ 17,32 |
| Etapas por tarefa | 46 | 72 |
O Fable 5 precisou de 57% mais etapas de agente para alcançar a mesma pontuação. Essas etapas extras, junto dos tokens de raciocínio que carregam, ajudam a explicar a diferença de custo. Por isso, desenvolvedores que alternaram entre os dois começaram a questionar a utilidade de comparar agentes só pelo preço de tabela:
"US$/token está se tornando a forma errada de comparar agentes de IA." - título de thread no r/grok, agosto de 2026
Os preços por token explicam parte dessa diferença. O Fable 5 custa US$ 10 de entrada e US$ 50 de saída por milhão de tokens na API da Anthropic. A tarifa publicada da API da xAI para o Grok 4.5 era de US$ 2 / US$ 6 por milhão de tokens em prompts abaixo de 200K tokens. A xAI não divulgou uma tabela separada para o 4.6, e a comunidade do r/grok relata que o 4.6 entrega "desempenho de nível Sol por uma fração do preço da API". Para consultar a tabela completa do Fable 5 em todas as faixas, veja o detalhamento de preços da API do Fable 5.
Na prática, dois fatores reduzem essa vantagem. O preço do Grok praticamente dobra acima de prompts de 200K tokens — US$ 4 / US$ 12 por milhão nessa faixa, segundo as tarifas publicadas da xAI — e, se o seu fluxo já depende bastante do Fable 5, há formas estruturais de reduzir os custos de tokens do Fable 5 antes de trocar de modelo.
Onde o Fable 5 ainda leva vantagem
| Área | Evidência | Impacto na prática |
|---|---|---|
| Índice de inteligência | O Fable 5 segue em 1º lugar no AA Intelligence Index: 62 contra aproximadamente 59 do Grok 4.6 | Três pontos da antiga vantagem de seis pontos sobreviveram ao salto do 4.6 |
| Janela de contexto | O Fable 5 oferece 1.000.000 de tokens de contexto; o Grok fica em 500.000 | Um repositório grande com o histórico da tarefa cabe de uma vez, e a vantagem de preço do Grok diminui na faixa acima de 200K |
| Confiabilidade nas tarefas mais difíceis | No teste de criação da TryAI, o Fable 5 renderizou o Cubo de Rubik 3D na primeira tentativa e produziu o melhor SVG; o Grok 4.5 precisou de uma nova execução. O Goldie Bench colocou o Fable 5 à frente por 20 a 17 em 47 tarefas one-shot, vencendo criações de shaders e física de GPU por 0,8 a 1,6 ponto | Quando a tarefa é ambígua e há apenas uma chance, o teto de raciocínio do Fable 5 aparece |
Velocidade, latência e vazão
Números medidos pela TryAI, com o mesmo roteamento de provedor, limite de 400 tokens e três execuções por tipo de prompt:
| Métrica | Grok 4.5 | Fable 5 |
|---|---|---|
| Tempo até o primeiro token | 0,44 s | 3,47 s |
| Vazão | 110 tok/s | 28 tok/s |
| Custo por resposta | US$ 0,00002 | US$ 0,00009 |
| Taxa de sucesso | 100% | 100% |
O Grok gerou 110 tok/s — aproximadamente o dobro do GPT-5.5 e do Opus 4.8, e cerca de quatro vezes os 28 tok/s do Fable 5. A Artificial Analysis traz um número ainda mais severo para o Fable 5 no raciocínio de esforço máximo: 113,68 segundos até o primeiro token da resposta, contra 8,68 do Grok. Depois que o streaming começa, porém, o Fable 5 decodifica um pouco mais rápido, com 63,1 contra 58,9 tok/s. Na prática, o Grok parece ágil em ciclos interativos; o Fable 5 concentra um longo período de raciocínio no início e paga por isso no tempo total.
Acesso, assinaturas e ferramentas de agente
Fable 5 está disponível pela API da Anthropic, pelo Claude Code e pelo Cursor, enquanto as assinaturas de valor fixo do Claude Pro cobrem a maior parte do uso fora da API. O ecossistema do Claude Code — CLAUDE.md, plugins, skills e servidores MCP — tem anos de maturidade.
Grok 4.6 está disponível pela API da xAI e pela CLI Grok Build (curl -fsSL https://x.ai/cli/install.sh | bash), com acesso ao chat incluído no X Premium. Segundo a ClockedCode, o Grok Build lê arquivos CLAUDE.md, plugins do Claude Code, skills, servidores MCP, agentes e hooks existentes sem qualquer configuração. Ele também funciona em modo headless com a flag -p para CI e expõe um Agent Client Protocol para integração embarcada. O ecossistema é mais novo, mas essa compatibilidade com o Claude Code deixa o custo de migração próximo de zero em configurações compatíveis.
Há uma questão de cobrança válida para os dois: assinantes do Claude Pro e do X Premium pagam valores fixos. Assim, os limites de uso sob a sua carga de trabalho real importam mais do que a tabela de preços.
Qual escolher em cada cenário
| Sua situação | Escolha | Motivo |
|---|---|---|
| Tarefas de programação bem definidas e em alto volume | Grok 4.6 | US$ 2,81 por tarefa contra US$ 17,32 com pontuações empatadas no CursorBench |
| Trabalho crítico para a correção em um repositório grande | Fable 5 | Janela de contexto de 1M, 1º lugar no índice de inteligência e melhor confiabilidade na primeira tentativa |
| Sessões interativas com agentes e iteração rápida | Grok 4.6 | 0,44 s até o primeiro token, 110 tok/s |
| Criações one-shot ambíguas e raciocínio mais exigente | Fable 5 | Venceu a tarefa mais difícil da TryAI e os confrontos diretos do Goldie Bench |
| Orçamento limitado para gastos com API | Grok 4.6 | Tokens de saída custam aproximadamente um oitavo do preço do Fable 5 |
Minha leitura: use o Grok 4.6 como padrão em trabalhos delimitados e repetitivos, e deixe o Fable 5 para tarefas em que uma resposta errada custa mais do que os tokens. Equipes com volume real deveriam operar os dois e rotear as solicitações pelo tamanho representativo das tarefas, taxa de novas tentativas e custo por tarefa concluída — uma alternativa mais barata do que se comprometer exclusivamente com um deles.
Perguntas frequentes
O Grok 4.6 é melhor que o Fable 5 para programação?
No CursorBench, eles empataram: 70,8% para o Grok 4.6 Extra High contra 70,5% para o Fable 5 Max na comparação de agosto. O Fable 5 ainda lidera o índice mais amplo de inteligência da Artificial Analysis, com 62 contra ~59, e vence as tarefas one-shot mais difíceis. Portanto, o "melhor" depende de o seu gargalo ser custo por tarefa ou teto de correção.
O Grok 4.6 é mais barato que o Fable 5?
Sim, por aproximadamente 6x por tarefa concluída no CursorBench: US$ 2,81 contra US$ 17,32. A comparação por token usa a tarifa publicada do Grok 4.5 — US$ 6 de saída contra US$ 50 do Fable 5 por milhão — porque a xAI ainda não divulgou uma tabela específica para o 4.6. Essa diferença diminui acima de 200K tokens, faixa em que o preço do Grok praticamente dobra.
Qual modelo tem a maior janela de contexto?
O Fable 5, com 1.000.000 de tokens, contra 500.000 do Grok. Em cargas de trabalho que mantêm uma base de código inteira no contexto, essa diferença pode superar a vantagem de preço do Grok.
O Grok Build pode usar minha configuração do Claude Code?
Sim. O Grok Build lê automaticamente CLAUDE.md, plugins do Claude Code, skills, servidores MCP, agentes e hooks sem necessidade de portabilidade, além de incluir seu próprio diretório .grok/ para configurações específicas do Grok.
Os benchmarks do Grok 4.5 são uma boa referência para o Grok 4.6?
Não para capacidade. O Grok 4.6 ganhou cerca de cinco pontos no Intelligence Index em relação ao 4.5, transformando uma desvantagem de seis pontos para o Fable 5 em aproximadamente três, e empatou com o Fable 5 Max no CursorBench, onde o 4.5 ficava claramente atrás. Os números de velocidade e preço por token deste artigo são medições do Grok 4.5, pois ainda não há dados equivalentes publicados para o Grok 4.6.
O dilema que os benchmarks não resolvem
Nenhum benchmark desta comparação determina se a vantagem de custo se mantém quando o repositório tem 50.000 linhas, o ticket é ambíguo e uma tentativa frustrada custa uma hora de depuração. É exatamente para esse cenário que existem o contexto de 1M do Fable 5 e seu teto de inteligência mais alto: a certeza cara do Fable 5 contra as etapas baratas do Grok 4.6. A diferença é grande o suficiente para que a maioria das equipes mantenha os dois ativos.
Leituras relacionadas: Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5