 AIREITER
Um agente de programação pode parecer barato até ultrapassar uma faixa de cobrança por contexto ou gastar seu teto de saída com raciocínio. Nesta decisão entre Grok 4.6 e Opus 5, escolha o Grok 4.6 para workloads sensíveis a custo abaixo de 200 mil tokens de prompt. O Claude Opus 5 faz mais sentido quando uma janela de 1 milhão de tokens, 128 mil tokens de saída ou seus controles de agentes documentados são requisitos reais.
A escolha começa pelo perfil da carga de trabalho
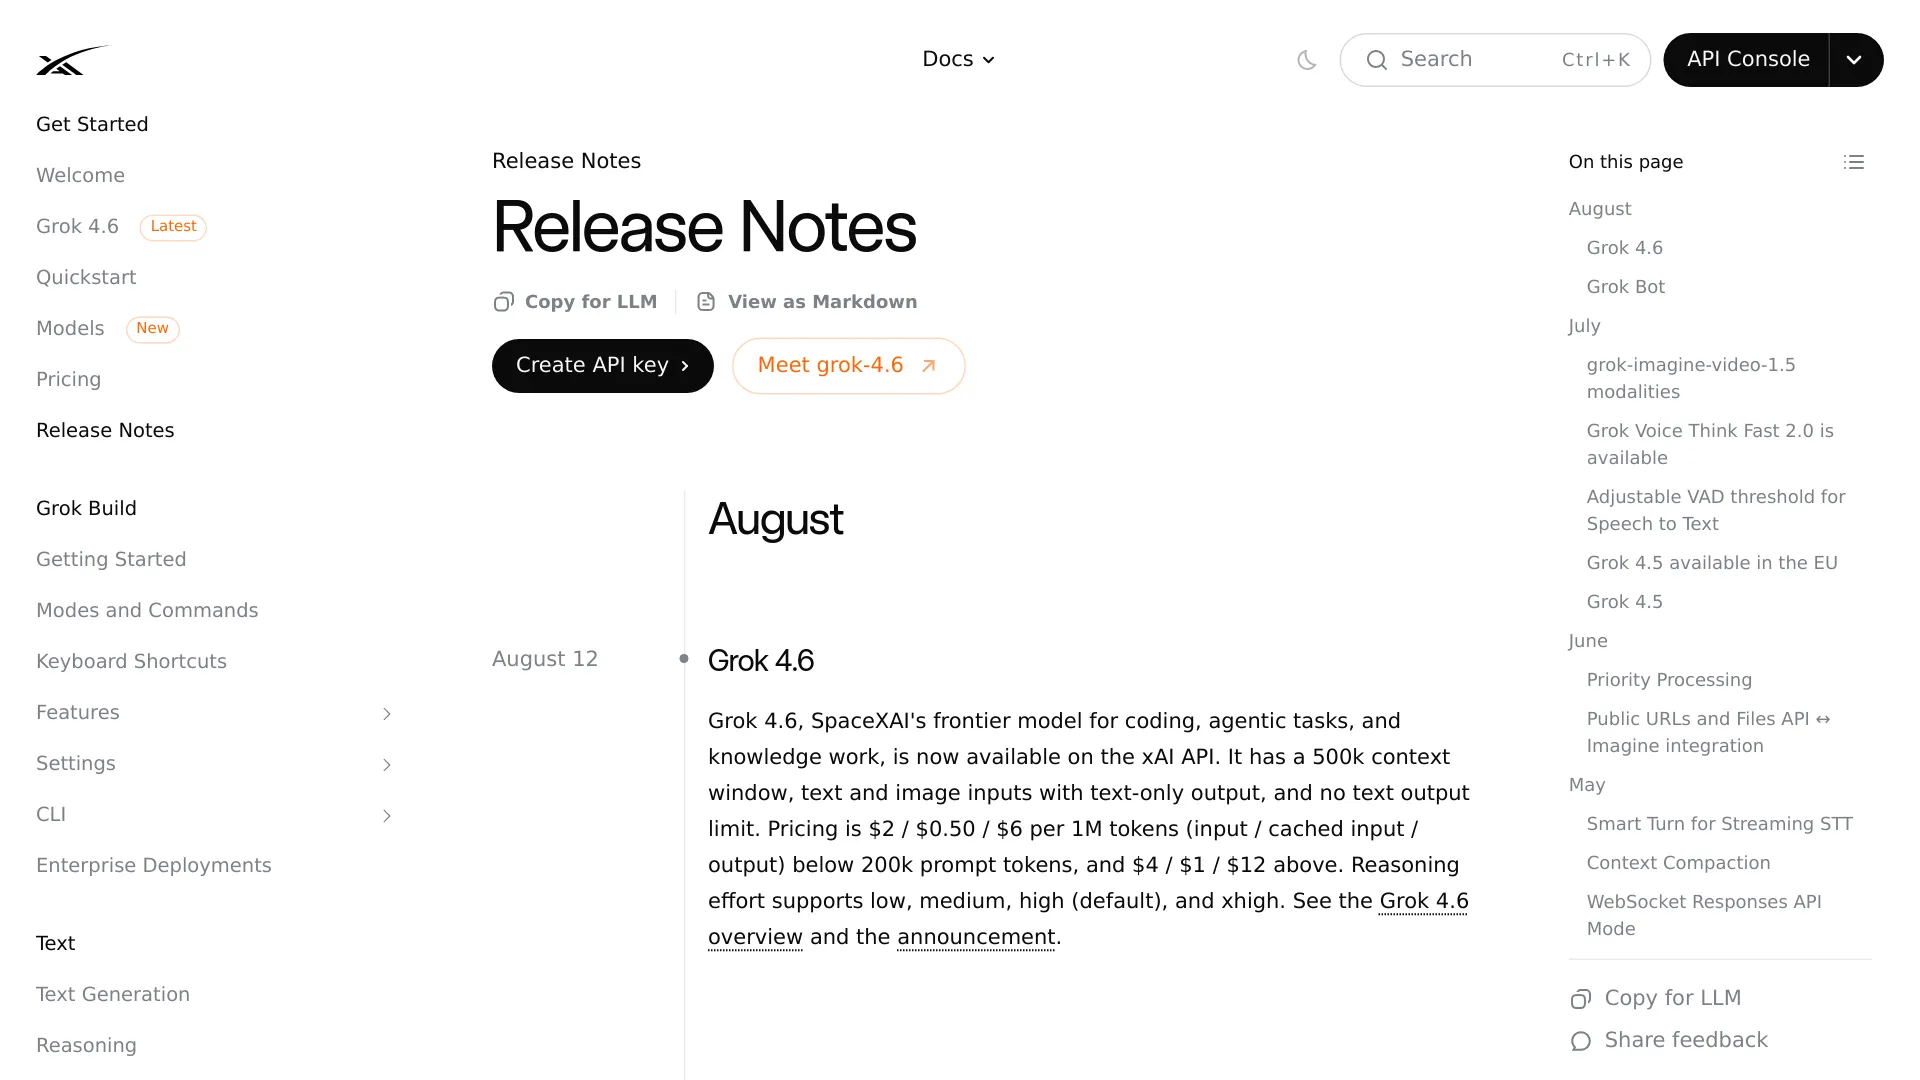
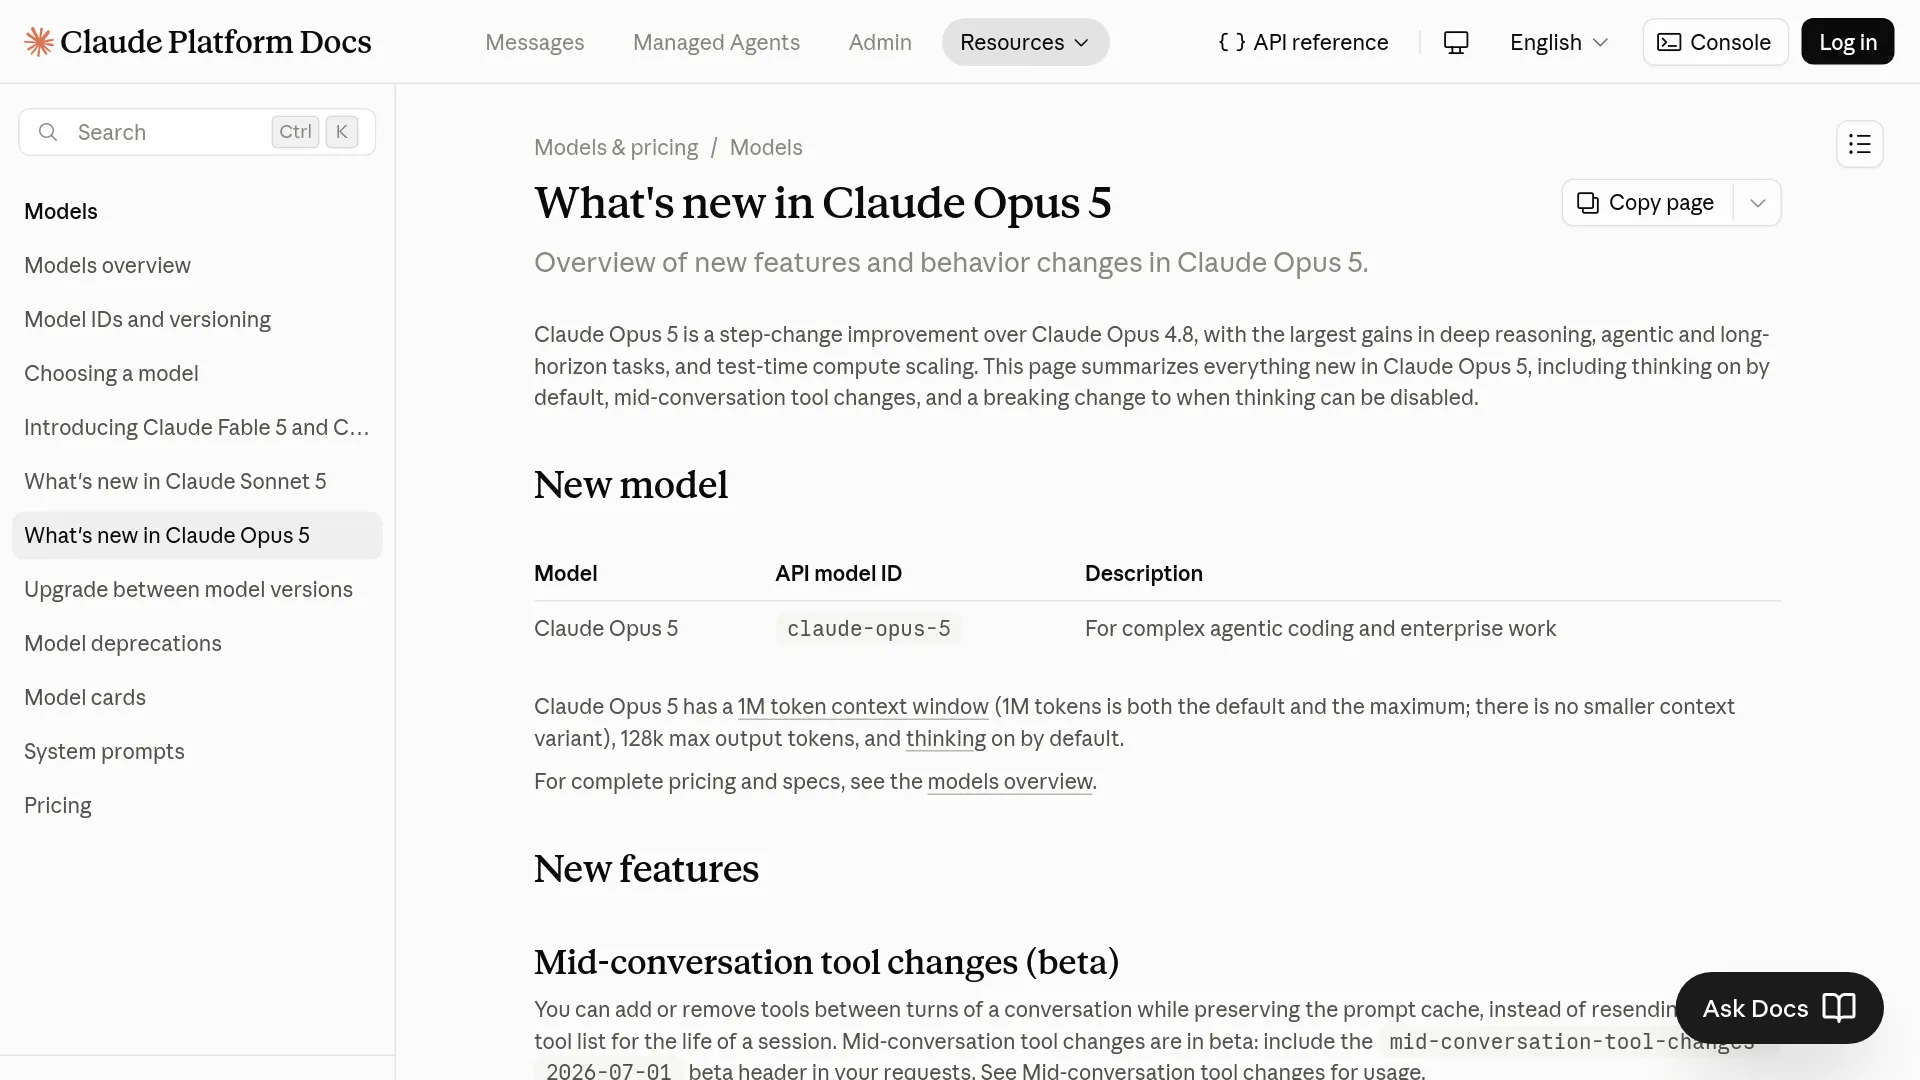
O Grok 4.6 é a escolha prática padrão para um agente de programação ou trabalho intelectual que gera texto e permanece abaixo do limite de preço da xAI de 200 mil tokens de prompt. Nas notas de lançamento de 12 de agosto de 2026, a xAI informa janela de contexto de 500 mil tokens, entradas de texto e imagem, saída de texto e quatro níveis de esforço, de low a xhigh. As notas de lançamento para desenvolvedores da xAI são a fonte principal dessas especificações.
O Claude Opus 5 é mais indicado quando 500 mil tokens não bastam, quando o fluxo exige até 128 mil tokens de saída ou quando a integração depende dos recursos de fallback e lista dinâmica de ferramentas da Anthropic. A Anthropic documenta uma janela de contexto padrão e máxima de 1 milhão de tokens, thinking ativado por padrão e disponibilidade de claude-opus-5 em sua API e nos principais parceiros de nuvem. A documentação do Opus 5 no Claude Platform pesa mais nessa escolha do que uma pequena diferença em leaderboard.
As fontes citadas não oferecem um benchmark compartilhado que decida todas as tarefas de programação. Comece pelo tamanho máximo do prompt, pela extensão de saída necessária, pelo contrato de ferramentas e pelo custo por tarefa concluída no seu próprio ambiente de testes.
Compare as restrições da API antes de olhar para os scores
Grok 4.6 e Claude Opus 5 aceitam texto e imagens e geram texto. As diferenças que realmente importam estão na capacidade de contexto, na cobrança de prompts longos, no contrato de saída e nos controles de integração.
| Característica da API | Grok 4.6 | Claude Opus 5 |
|---|---|---|
| Janela de contexto | 500 mil tokens | 1 milhão de tokens |
| Modalidades de entrada | Texto, imagem | Texto, imagem, fluxos com PDF/documentos descritos pela Anthropic |
| Modalidade de saída | Texto | Texto |
| Máximo de texto na saída | Sem limite numérico informado nas notas de lançamento da xAI | 128 mil tokens |
| Níveis de esforço | low, medium, high, xhigh | low, medium, high, xhigh, max |
| Esforço padrão | high | high |
| Preço padrão de entrada | US$ 2/M tokens | US$ 5/M tokens |
| Preço padrão de saída | US$ 6/M tokens | US$ 25/M tokens |
| Regra para prompts longos | US$ 4/M de entrada e US$ 12/M de saída acima de 200 mil tokens de prompt | Nenhum limite equivalente informado na documentação de lançamento do Opus 5 |
| Entrada em cache | US$ 0,50/M abaixo de 200 mil; US$ 1/M acima de 200 mil | Prompt mínimo de 512 tokens para cache, com preços de cache documentados separadamente |
O Grok 4.6 tem tarifas unitárias listadas menores, mas elas dobram acima de 200 mil tokens de prompt. O Opus 5 custa mais, porém seu contexto de 1 milhão de tokens pode evitar overhead de segmentação ou recuperação em fluxos que precisam dessa capacidade.
Como o Grok 4.6 altera a conta de custos
O Grok 4.6 cobra US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída abaixo de 200 mil tokens de prompt. Quando o prompt passa de 200 mil tokens, a xAI informa US$ 4/M para entrada e US$ 12/M para saída; entradas em cache custam US$ 0,50/M e US$ 1/M, respectivamente. Esse limite importa mais do que a tarifa promocional aparente da faixa inferior. As notas de lançamento da xAI especificam as duas faixas.
Nas tarifas informadas, 100 mil tokens de entrada sem cache mais 20 mil tokens de saída custam US$ 0,32; 250 mil tokens de entrada mais 20 mil de saída custam US$ 1,24 após a aplicação da faixa mais cara. São cálculos por requisição, não estimativas de execução de agentes, porque retentativas, chamadas de ferramentas, prefixos em cache e contexto acumulado podem dominar a fatura.
Uma discussão recente no r/grok relata resultados específicos de configuração no CursorBench 3.2: US$ 2,81 por tarefa e 46 etapas para o Grok 4.6 Extra High, contra US$ 8,23 e 78 etapas para o Opus 5 Max. Trate esses números como resultados do ambiente relatado pelo autor, não como garantia neutra entre fornecedores: a mesma publicação aponta 26,0% para o Grok 4.6 no Terminal-Bench 3.0, atrás de outros modelos citados.
Como o Opus 5 muda o desenho da integração
O Claude Opus 5 ativa thinking por padrão. max_tokens é um teto rígido compartilhado entre o thinking oculto e a saída visível; por isso, migrar requisições não pensantes do Opus 4.8 pode exigir um orçamento maior para saída. A Anthropic também informa que combinar thinking: {"type":"disabled"} com xhigh ou max retorna HTTP 400. As notas de migração apresentam duas alternativas: reduzir o nível de esforço ao desativar thinking ou remover a configuração que o desativa.
O Claude Opus 5 também reduz o prompt mínimo elegível para cache de 1.024 tokens no Opus 4.8 para 512 tokens. Seus controles beta permitem alterar ferramentas no meio da conversa sem invalidar o cache do prompt e oferecem o modo gerenciado fallbacks: "default". Isso é relevante para agentes com permissões ou conjuntos de ferramentas que mudam; em um endpoint simples de completion sem estado, não faz diferença.
O Fast mode é uma prévia de pesquisa exclusiva da API, a US$ 10/M de entrada e US$ 50/M de saída: o dobro da tarifa padrão do Opus 5. A Anthropic afirma que ele não está disponível via Amazon Bedrock, Google Cloud ou Microsoft Foundry; portanto, não dá para pressupor simultaneamente portabilidade e velocidade. O anúncio de lançamento da Anthropic lista o preço padrão de US$ 5/M para entrada e US$ 25/M para saída.
Os dados para agentes de código apontam tendências, não um vencedor universal
A Anthropic relata que o Opus 5 no esforço máximo alcança cerca de 70,0% no CursorBench 3.2, a aproximadamente US$ 8,50 por tarefa, ficando a 0,5 ponto percentual da melhor pontuação relatada para o Fable 5 por cerca de metade do custo. São resultados plotados pela Anthropic e devem ser lidos como evidência de avaliação do fornecedor, não como uma auditoria entre provedores. O anúncio do Opus 5 descreve o método Frontier-Bench como cinco tentativas por tarefa usando a execução interna da Anthropic.
Uma medição aparentemente independente, embora mais restrita, é mais útil para revisão de código. A CodeRabbit testou cerca de 100 padrões de erro verificados em pull requests reais de código aberto, executou cada configuração três vezes e avaliou comentários de revisão após filtragem. No esforço xhigh, a configuração testada do Opus 5 detectou 55,2% dos problemas conhecidos, contra 61,1% da baseline de produção; a precisão acionável foi de 39,3%, contra 35,2%, mas também gerou 92 observações menores, ante 23. A avaliação da CodeRabbit sobre o Opus 5 recomenda um papel específico focado em precisão, em vez de usar o Opus 5 como única rede de segurança.
As evidências sustentam uma regra concreta: avalie o Opus 5 em mais de um nível de esforço e meça recall, precisão, uso de tokens e ruído de revisão nos seus próprios pull requests. Para o Grok 4.6, as notas de lançamento atuais da xAI descrevem o contrato da API e os preços, mas não publicam um estudo de revisão de código diretamente comparável. Não conclua que ele vence em revisão de código a partir de uma pontuação de agente de programação.
Escolha conforme este cenário de implantação
O Grok 4.6 é a recomendação para agentes cujo prompt usual permanece abaixo de 200 mil tokens e cuja prioridade é o menor custo listado de API. Defina um orçamento de avaliação em torno desse limite, pois um agente de repositório pode ultrapassá-lo depois de saídas de ferramentas e retentativas, mesmo quando o primeiro prompt é pequeno.
O Claude Opus 5 é a recomendação para sessões com repositórios, documentos ou agentes que exigem mais de 500 mil tokens de contexto ativo, até 128 mil tokens de saída ou os controles documentados da Anthropic para mudança de ferramentas e fallbacks. Comece em high e teste níveis menores antes de presumir que max se paga.
Para revisão automatizada de código, não escolha nenhum dos dois com base em um leaderboard geral de programação. Execute um conjunto rotulado de pull requests, registre o recall de problemas e a carga de falsos positivos e mantenha uma segunda via de revisão para defeitos de concorrência, uso de API e validação. A CodeRabbit encontrou essas como categorias mais fracas nas configurações testadas do Opus 5. Suas conclusões por categoria são um motivo para testar a adequação à tarefa, não uma afirmação sobre todas as implantações do Claude.
| Situação de implantação | Escolha padrão | Fator decisivo |
|---|---|---|
| Agente de programação sensível a custo abaixo de 200 mil tokens de prompt | Grok 4.6 | Suas tarifas listadas de US$ 2/M para entrada e US$ 6/M para saída |
| Sessão longa com repositório ou documentos acima de 500 mil tokens de contexto | Claude Opus 5 | Janela de contexto de 1 milhão de tokens e limite de saída de 128 mil tokens |
| Agente com ferramentas que mudam dinamicamente | Claude Opus 5 | Mudanças beta de ferramentas durante a conversa preservam o cache |
| Tarefa com prompts frequentes acima de 200 mil tokens | Avalie os dois | O Grok 4.6 dobra as tarifas listadas por token nesse limite |
| Pipeline de revisão de código | Avalie os dois em PRs rotulados | Recall, precisão, retentativas e ruído de revisão importam mais que uma pontuação de destaque |
Perguntas frequentes
Grok 4.6 é mais barato que Opus 5?
Abaixo de 200 mil tokens de prompt, a xAI lista o Grok 4.6 a US$ 2/M para entrada e US$ 6/M para saída, contra US$ 5/M para entrada e US$ 25/M para saída no Opus 5. Os preços listados do Grok 4.6 dobram acima de 200 mil tokens de prompt; compare o custo da tarefa concluída, não apenas a requisição inicial.
Qual modelo devo usar para programação?
Escolha o Grok 4.6 pelas menores tarifas de API listadas quando seu agente normalmente fica abaixo de 200 mil tokens de prompt. Escolha o Opus 5 quando contexto de 1 milhão de tokens, saída de 128 mil tokens ou os controles de agentes da Anthropic forem necessários; valide qualquer uma das opções na linguagem, no formato de repositório e no loop de ferramentas que você realmente utiliza.
Próximo passo para a implantação
Execute as mesmas 20 a 50 tarefas representativas em cada candidato, com ferramentas fixas, limite fixo de retentativas e registro de tokens. Escolha o modelo que atinge sua taxa de aprovação necessária com o menor custo por tarefa concluída e mantenha o outro como opção roteada para cargas em que sua vantagem de contexto ou plano de controle seja decisiva.
Leitura relacionada: guia de preços da API do Claude Opus 5, detalhes do lançamento do Grok 4.6 e Grok 4.6 vs GPT-5.6.