 AIREITER
O nome que aparece nas buscas é “3-5”, mas os IDs oficiais dos modelos do Google são gemini-3.5-transcribe e gemini-3.5-transcribe-live. A API existe e custa pouco, mas a escolha depende do que você precisa: texto bem editado, transcrição rastreável ou legendas em tempo real.
O veredito da review da API Gemini 3.5 Transcribe em uma tabela
Vale a pena prototipar o Gemini 3.5 Transcribe para arquivos gravados, ditados e experiências curtas de legendas ao vivo. Ele não deve ser o padrão para transcrições exatas ou registros ao vivo de longa duração: o modo Smart edita a fala, as sessões ao vivo não têm identificação de falantes nem marcação de tempo por palavra, e o serviço continua em prévia pública.
| Se você precisa de… | Use… | Veredito da review |
|---|---|---|
| Uma transcrição de reunião, chamada ou podcast enviado para a API | gemini-3.5-transcribe | Use; escolha o modo literal quando as palavras exatas forem importantes |
| Ditado limpo ou atas de reunião fáceis de ler | Modelo para áudio gravado com o modo Smart | Use com revisão se a edição do texto for aceitável |
| Legendas enquanto alguém está falando | gemini-3.5-transcribe-live | Prototipe em sessões interativas curtas |
| Identificação de falantes e marcação de tempo por palavra | Modelo gravado com anotações no modo literal | Use com limitações; 30 minutos e 3+ falantes são recursos experimentais |
| Uma fonte de verdade jurídica, médica, regulatória ou arquivística | Pipeline literal com revisão humana | Não use como única fonte |
Esta é uma review baseada em evidências, não um benchmark controlado de WER. O guia de configuração e preços da API Gemini 3.5 Transcribe explica o fluxo das requisições; aqui, o foco está no que as limitações documentadas significam depois da primeira chamada bem-sucedida.
Na prática, a família de modelos oferece dois contratos de API
O gemini-3.5-transcribe processa áudio enviado ou pré-gravado por meio da Interactions API, enquanto o gemini-3.5-transcribe-live lida com áudio em streaming pela Live API.
Transcrição de áudio gravado: gemini-3.5-transcribe
A rota de áudio gravado é a opção mais completa para transcrições duráveis. O Google documenta detecção automática de idioma em mais de 85 idiomas, vocabulário personalizado, saída Smart ou literal, diarização de falantes e timestamps por palavra na documentação de transcrição de áudio.
O limite normal para áudio é de até uma hora. Quando a diarização de falantes ou os timestamps por palavra são ativados, esse limite cai para 30 minutos. O Google também classifica como experimental a atribuição para três ou mais falantes, embora a referência do modelo liste suporte para até oito pessoas.
Essa rota atende bem a ditados, entrevistas e chamadas curtas. Reuniões mais longas que exigem identificação de falantes e alinhamento temporal precisam ser divididas e remontadas pela aplicação.
Transcrição ao vivo: gemini-3.5-transcribe-live
A rota ao vivo foi criada para gerar legendas progressivamente, não para reproduzir pelo WebSocket tudo o que a rota gravada faz. A documentação de transcrição ao vivo do Google descreve eventos de transcrição provisórios e finais, detecção automática de idioma, vocabulário personalizado, modo Smart e detecção de atividade de voz automática, híbrida ou manual.
Uma sessão contínua ao vivo dura 10 minutos. O streaming ao vivo não oferece diarização de falantes nem timestamps por palavra, e o áudio precisa estar em PCM bruto de 16 bits, 16 kHz, mono e little-endian. Esses limites funcionam para prévias de legendas, mas tornam a gravação de chamadas longas dependente de reconexão, remontagem dos trechos e tratamento do texto provisório.
O equilíbrio entre recursos que define o veredito
O diferencial do Gemini 3.5 Transcribe é a limpeza “inteligente” do texto, mas esse recurso muda o significado de precisão. Um texto mais polido pode ser melhor para ditados e, ao mesmo tempo, menos adequado como registro literal da conversa.
O modo Smart edita o texto — não é um registro original
O modo Smart do Google remove palavras de preenchimento, gaguejadas e falsos começos; resolve autocorreções faladas; e organiza pontuação, números, listas e parágrafos. A frase “Vamos nos encontrar na terça, não, na quarta” pode virar “quarta-feira”, sem preservar o falso começo.
Isso é útil para um rascunho de e-mail, uma nota de voz ou anotações de reunião fáceis de ler. Mas pode ser um problema quando a hesitação, o erro original ou a sequência exata das palavras tem importância.
O guia oficial de transcrição deixa o limite claro: o modo Smart não pode ser combinado com diarização de falantes nem com timestamps por palavra. A API obriga você a escolher entre texto limpo e anotações rastreáveis.
Mantenha uma transcrição literal como fonte de verdade e depois gere uma cópia no modo Smart ou tratada por outra etapa para os leitores. Não tente resolver essa incompatibilidade apenas com um prompt; trata-se de uma restrição do contrato de saída.
Timestamps e identificação de falantes aumentam a rastreabilidade, mas restringem a rota
O áudio gravado pode retornar anotações word_info com o texto de cada palavra, offsets e identificadores de falantes quando configurado no modo literal. Esses dados permitem criar legendas, avançar a reprodução até um ponto específico, calcular a duração da fala de cada pessoa e revisar evidências.
| Requisito | Rota gravada | Rota ao vivo |
|---|---|---|
| Diarização de falantes | Compatível; até 8 documentados, 3+ em caráter experimental | Não compatível |
| Timestamps por palavra | Compatível | Não compatível |
| Saída Smart com anotações | Não compatível | Não compatível com anotações por palavra |
| Limite de duração | 1 hora no uso normal; 30 minutos com diarização ou timestamps por palavra | 10 minutos por sessão contínua |
| Observação sobre precisão | O Google alerta que timestamps por palavra podem reduzir a precisão | O texto provisório pode mudar antes da finalização |
Por isso, dizer que a API “oferece timestamps” é uma afirmação incompleta na hora de comparar soluções. O recurso existe, mas reduz o limite de duração dos arquivos e pode sacrificar a precisão do reconhecimento. Teste a atribuição de falantes em vez de tratar o máximo documentado como uma garantia de confiabilidade para reuniões maiores.
Vocabulário personalizado e detecção de idioma
As duas rotas oferecem detecção automática de idioma e vocabulário personalizado. O Google documenta mais de 85 idiomas e alternância entre idiomas, além de recomendar dicas como en-US quando a aplicação já conhece o idioma do áudio.
O vocabulário personalizado aceita até 1.000 termos, mas a orientação prática do Google diz que os melhores resultados costumam aparecer com até 100. Use a lista para nomes de produtos, siglas, nomes próprios e termos técnicos — não para palavras comuns.
“Compatível” não significa a mesma qualidade em diferentes sotaques, dialetos, ambientes barulhentos e trocas de idioma no meio da frase. Uma discussão inicial no Reddit perguntou especificamente se a rota ao vivo conseguiria lidar com idiomas misturados. É um bom caso de teste, mas não uma prova de falha.
“Eu preferiria que o vídeo tivesse um pequeno atraso e que as legendas ficassem sincronizadas com as palavras faladas.” — u/WaterObjective5107, Reddit
O comentário resume um problema de produtos ao vivo que o WER não mede: uma legenda pode estar linguisticamente correta e ainda parecer errada se não estiver sincronizada com o vídeo.
O que os números de precisão realmente permitem concluir
Os números publicados pelo Google são animadores, mas representam contextos de avaliação diferentes, não uma pontuação universal do Gemini 3.5 Transcribe. Eles justificam um piloto sério, mas não substituem testes com seus microfones, sotaques, termos e padrões de fala.
| Contexto da avaliação | WER informado | O que o dado mostra |
|---|---|---|
| Artificial Analysis, streaming | 4,0% | Uma média de streaming citada, não uma pontuação de latência ou diarização |
| Artificial Analysis, sem streaming | 2,6% | Uma média citada para áudio gravado nas condições de teste da análise |
| FLEURS, streaming | 5,50% | Um resultado multilíngue em streaming para localidades selecionadas |
| FLEURS, sem streaming | 5,04% | Um resultado separado para áudio gravado multilíngue |
Esses números aparecem no anúncio de lançamento do Google, que também afirma uma melhora de 70% no tempo até a transcrição final em comparação com o Chirp 3. Essa é uma afirmação do Google, não um teste independente do seu fluxo de trabalho.
A diferença entre 2,6% e 5,50% não é uma contradição. As rotas, os conjuntos de dados, a combinação de idiomas e as condições de streaming são diferentes. Avalie os erros que geram custo, como nomes, IDs de pedidos, datas, valores, termos de produto e turnos de fala, em vez de confiar apenas no WER agregado.
Relatos iniciais da comunidade apontam troca de idiomas, atribuição de falantes, comportamento dos timestamps e conclusão de gravações longas como casos que merecem teste; um usuário no X afirmou que um clipe de 20 minutos retornou apenas cinco minutos. São relatos indicativos, não fatos controlados sobre o produto. (relato no X)
Os obstáculos de produção que o guia de configuração não responde
Um upload concluído ou uma conexão WebSocket estabelecida prova apenas que o transporte funciona, não que a solução está pronta para produção. Os riscos aparecem depois da demonstração: texto ao vivo mutável, limites específicos de cada rota, gestão de credenciais, status de prévia e a política para manter uma transcrição confiável.
Legendas ao vivo exigem gerenciamento de estado
As respostas ao vivo têm duas funções. interim_input_transcription é uma hipótese mutável para a prévia da legenda; input_transcription é o segmento finalizado que pode ser anexado ao estado persistente da transcrição.
Use este modelo de estado:
- Substitua a legenda visível a cada atualização provisória.
- Adicione ao texto persistente apenas os trechos finalizados.
- Renove ou reconecte antes do limite de 10 minutos da sessão.
- Una as sessões com um marcador explícito de limite e uma lógica para eliminar duplicidades.
- Não permita que ações irreversíveis dependam de texto provisório.
Use tokens efêmeros em clientes web e móveis para não expor uma chave de API de longa duração no código do frontend. É necessário um backend para emitir e restringir esses tokens; depois, o áudio pode seguir diretamente do cliente para a Live API, se essa arquitetura fizer sentido para a aplicação. Monitore erros de conexão, atraso na finalização e segmentos duplicados.
Fluxos com áudio gravado precisam de uma política de fonte de verdade
Defina o contrato de saída antes de escolher o modo. Use o modo Smart para gerar prosa legível; escolha o modo literal quando as palavras exatas, os falantes ou os offsets forem importantes.
Armazene o resultado literal e as anotações. Depois, gere uma transcrição limpa separada para buscas, resumos ou notas voltadas ao cliente. Isso acrescenta uma etapa ao processamento, mas é mais seguro do que tentar reconstruir palavras de preenchimento removidas ou autocorreções sobrescritas.
O status de prévia muda a decisão de implantação
O Google anunciou o Gemini 3.5 Transcribe em 26 de agosto de 2026 como uma família de modelos em prévia pública. A referência de modelos do Google documenta recursos e limites, mas o status de prévia significa que preços, cotas, comportamento e disponibilidade precisam ser verificados novamente antes de uma migração.
Comece com um conjunto pequeno e não sensível de avaliação, acompanhado de transcrições de referência salvas. Meça separadamente a precisão de entidades críticas, a atribuição de falantes, o atraso até a finalização, o comportamento após reconexões e a taxa de correções feitas por revisores. Defina por escrito os limites mínimos antes dos testes e avance apenas quando cada um deles for atingido.
Preço versus custo da transcrição realmente aprovada
O Gemini 3.5 Transcribe é barato nas estimativas exibidas, mas a cobrança é baseada em tokens, e não em uma tarifa fixa garantida por minuto. A tabela oficial de preços do Google informa aproximadamente US$ 0,003 por minuto de entrada de áudio gravado mais US$ 0,002 de saída de texto, ou cerca de US$ 0,005 por minuto no total; o Live custa aproximadamente US$ 0,009 por minuto no total.
| Rota | Estimativa de entrada de áudio | Estimativa de saída de texto | Estimativa combinada para planejamento | 100 horas |
|---|---|---|---|---|
Gravado gemini-3.5-transcribe | US$ 0,003/min | US$ 0,002/min | US$ 0,005/min | Cerca de US$ 30 |
Live gemini-3.5-transcribe-live | Cerca de US$ 0,005/min | Cerca de US$ 0,004/min | US$ 0,009/min | Cerca de US$ 54 |
O primeiro orçamento fica em aproximadamente US$ 30 para 100 horas de áudio gravado ou US$ 54 no modo Live, antes de contabilizar novas tentativas, armazenamento, conversão de áudio, correção humana e geração de resumos. O tamanho da saída e o contexto adicional podem alterar a cobrança, portanto mantenha registros de uso.
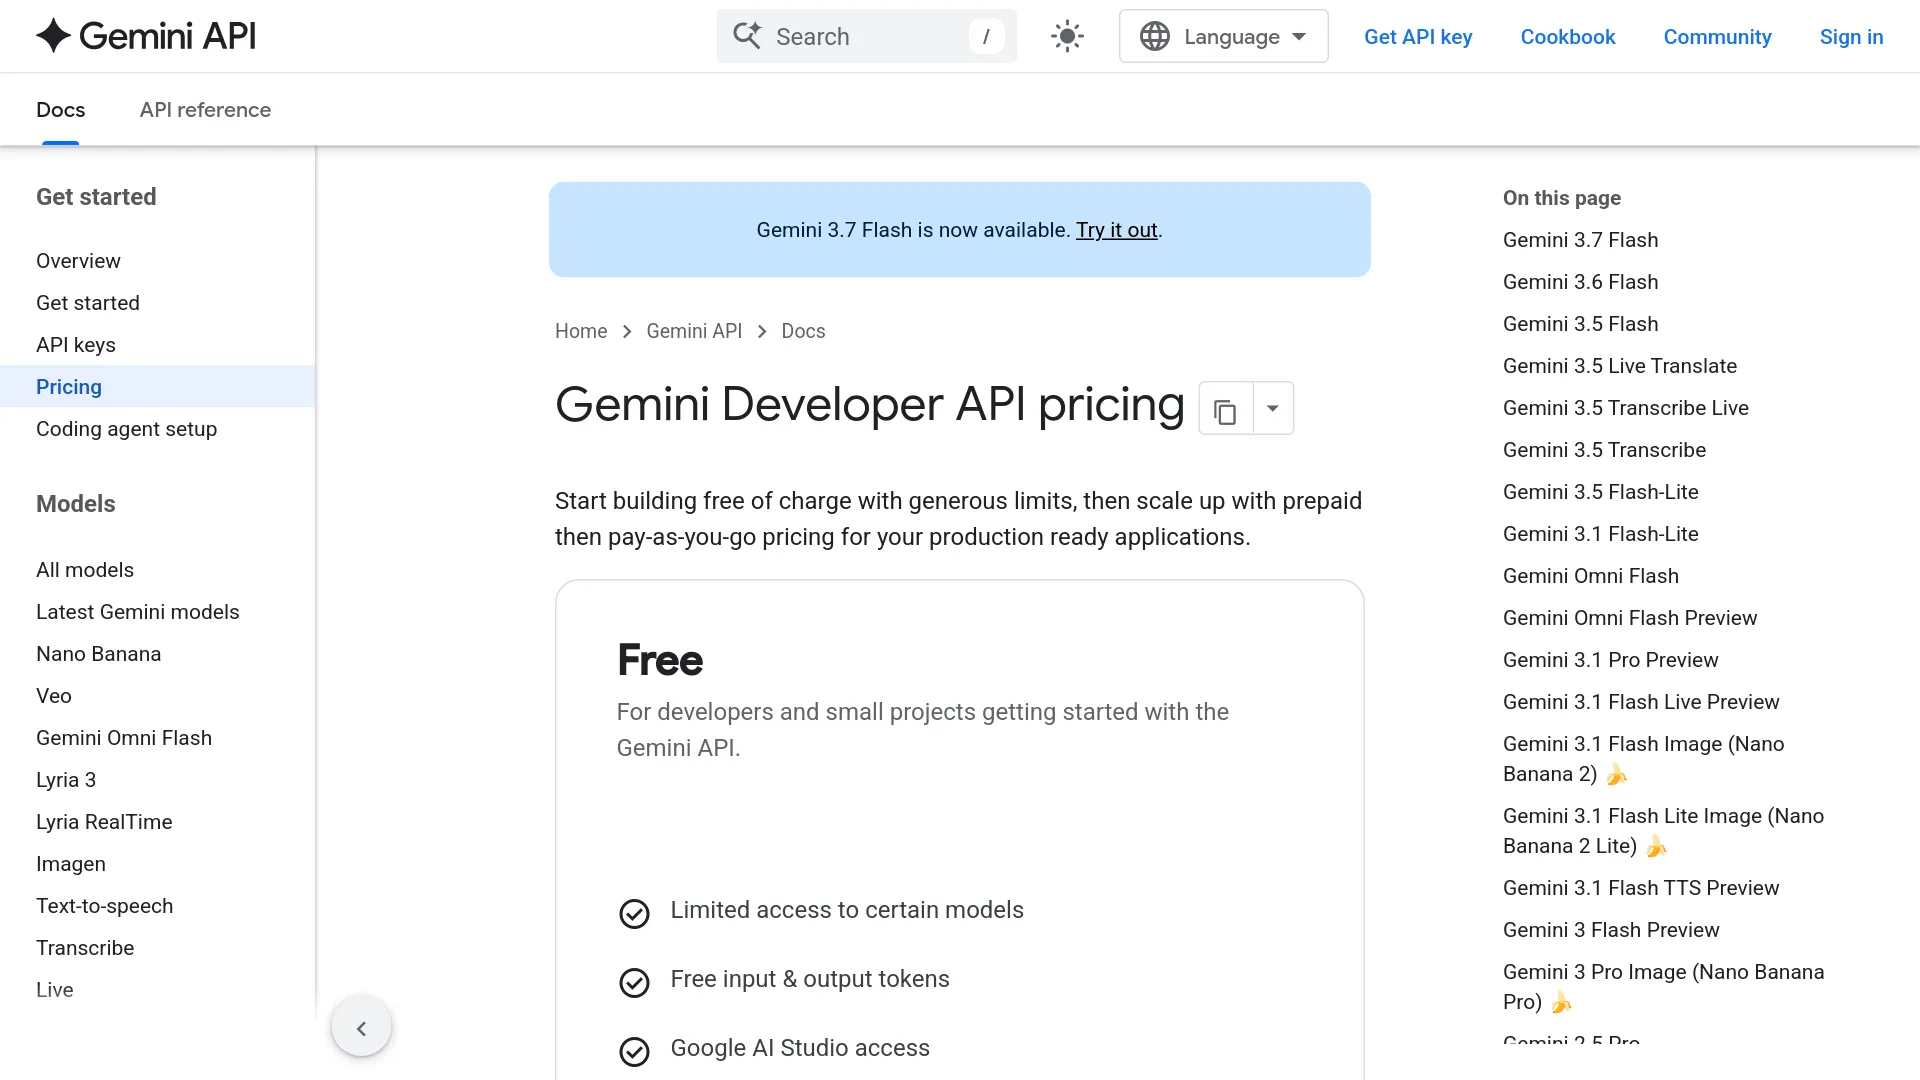
Captura feita na página pública de preços do Google; confirme a tabela atual antes de comprometer um volume significativo. Consulte a documentação oficial de preços da Gemini API.
Calcule o custo da transcrição aprovada somando uso da API, tempo de revisão, valor pago ao revisor, novas tentativas, armazenamento, conversão e processamento posterior. As correções do modo Smart ou uma segunda etapa de anotação podem tornar uma API mais cara mais econômica no total se reduzirem o trabalho manual.
FAQ da review da API Gemini 3.5 Transcribe
A transcrição no modo Smart preserva as palavras exatas?
Não. O modo Smart edita disfluências e autocorreções. Por isso, mantenha o modo literal como fonte quando as palavras exatas forem importantes.
A Live API oferece identificação de falantes ou timestamps por palavra?
Não. Use a rota gravada quando precisar de diarização ou timestamps por palavra.
O Gemini 3.5 Transcribe consegue lidar com uma reunião longa?
O limite normal da rota gravada é de uma hora, ou 30 minutos com diarização ou timestamps por palavra; o Live é limitado a 10 minutos por sessão contínua.
Ele é adequado para transcrições jurídicas, médicas ou regulatórias?
Use-o apenas como uma camada de apoio, com saída literal, checagem de campos críticos e revisão humana. Não use a saída do modo Smart como único registro em situações de alto risco.
A decisão: vale prototipar, mas não deixe que ele vire o registro por acidente
O Gemini 3.5 Transcribe é uma boa opção quando o objetivo é obter transcrição multilíngue, barata e sensível ao contexto, e não uma captura literal perfeita. Comece pela rota gravada, compare as saídas Smart e literal usando seus próprios áudios e só adicione anotações se o limite de 30 minutos for aceitável.
Migre para o Live em legendas ou interfaces de voz depois que o cliente conseguir transmitir com segurança o formato PCM exigido e separar o texto provisório do texto finalizado. Em registros sensíveis, preserve a rota literal e inclua a revisão humana nos critérios de aceitação — não como um reparo emergencial depois que o modo Smart já tiver reescrito a fonte.