 AIREITER
Uma chamada para gemini-2.5-pro em 2 de dezembro não vai falhar. Ela simplesmente será respondida por outro modelo. O Google descontinuou gemini-2.5-pro e gemini-2.5-flash em 2 de novembro de 2026 e, a partir de 1º de dezembro de 2026, a Gemini Developer API redirecionará esses IDs automaticamente para gemini-3.8-flash e gemini-3.5-flash-lite, aplicando as tarifas dos modelos substitutos. O problema é que não se trata apenas de trocar o nome do modelo: há uma mudança de categoria, parâmetros incompatíveis e comportamento diferente. Por isso, continuar usando a string antiga até dezembro é a opção mais arriscada.
O que o Google anunciou para 1º de dezembro
O Google descontinuou gemini-2.5-pro e gemini-2.5-flash na Gemini Developer API. Os dois identificadores também desapareceram do seletor do Google AI Studio, e o acesso pela API agora está limitado a desenvolvedores que já usaram cada modelo. A partir de 1º de dezembro de 2026, as requisições continuarão funcionando, mas serão executadas por modelos diferentes e cobradas com outras tarifas.
O mapeamento vem da página de descontinuação da Gemini API do Google:
| ID antigo usado na chamada | Modelo que responderá a partir de 1º de dezembro de 2026 | Cobrança a partir de 1º de dezembro |
|---|---|---|
gemini-2.5-pro | gemini-3.8-flash | Tarifas do Gemini 3.8 Flash |
gemini-2.5-flash | gemini-3.5-flash-lite | Tarifas do Gemini 3.5 Flash-Lite |
gemini-2.5-flash-lite | sem alteração, não haverá redirecionamento | sem alteração |
O Google lista 1º de dezembro de 2026 como a data de redirecionamento dos dois IDs estáveis. O aviso foi publicado no changelog de 2 de novembro de 2026. Patrick Loeber, integrante da equipe do Google DeepMind, compartilhou o aviso em um PSA e alertou que integrações mais avançadas exigem trabalho de migração.
O comunicado vale apenas para a Gemini Developer API e o AI Studio. O Vertex AI segue um cronograma de aposentadoria separado para o Gemini 2.5, com o Google Cloud indicando datas em outubro de 2026 para os mesmos nomes de modelo. Já o Firebase AI Logic mantém sua própria lista de modelos compatíveis. Usuários do Vertex devem consultar o console do Cloud, sem presumir que 1º de dezembro vale para todos os produtos.
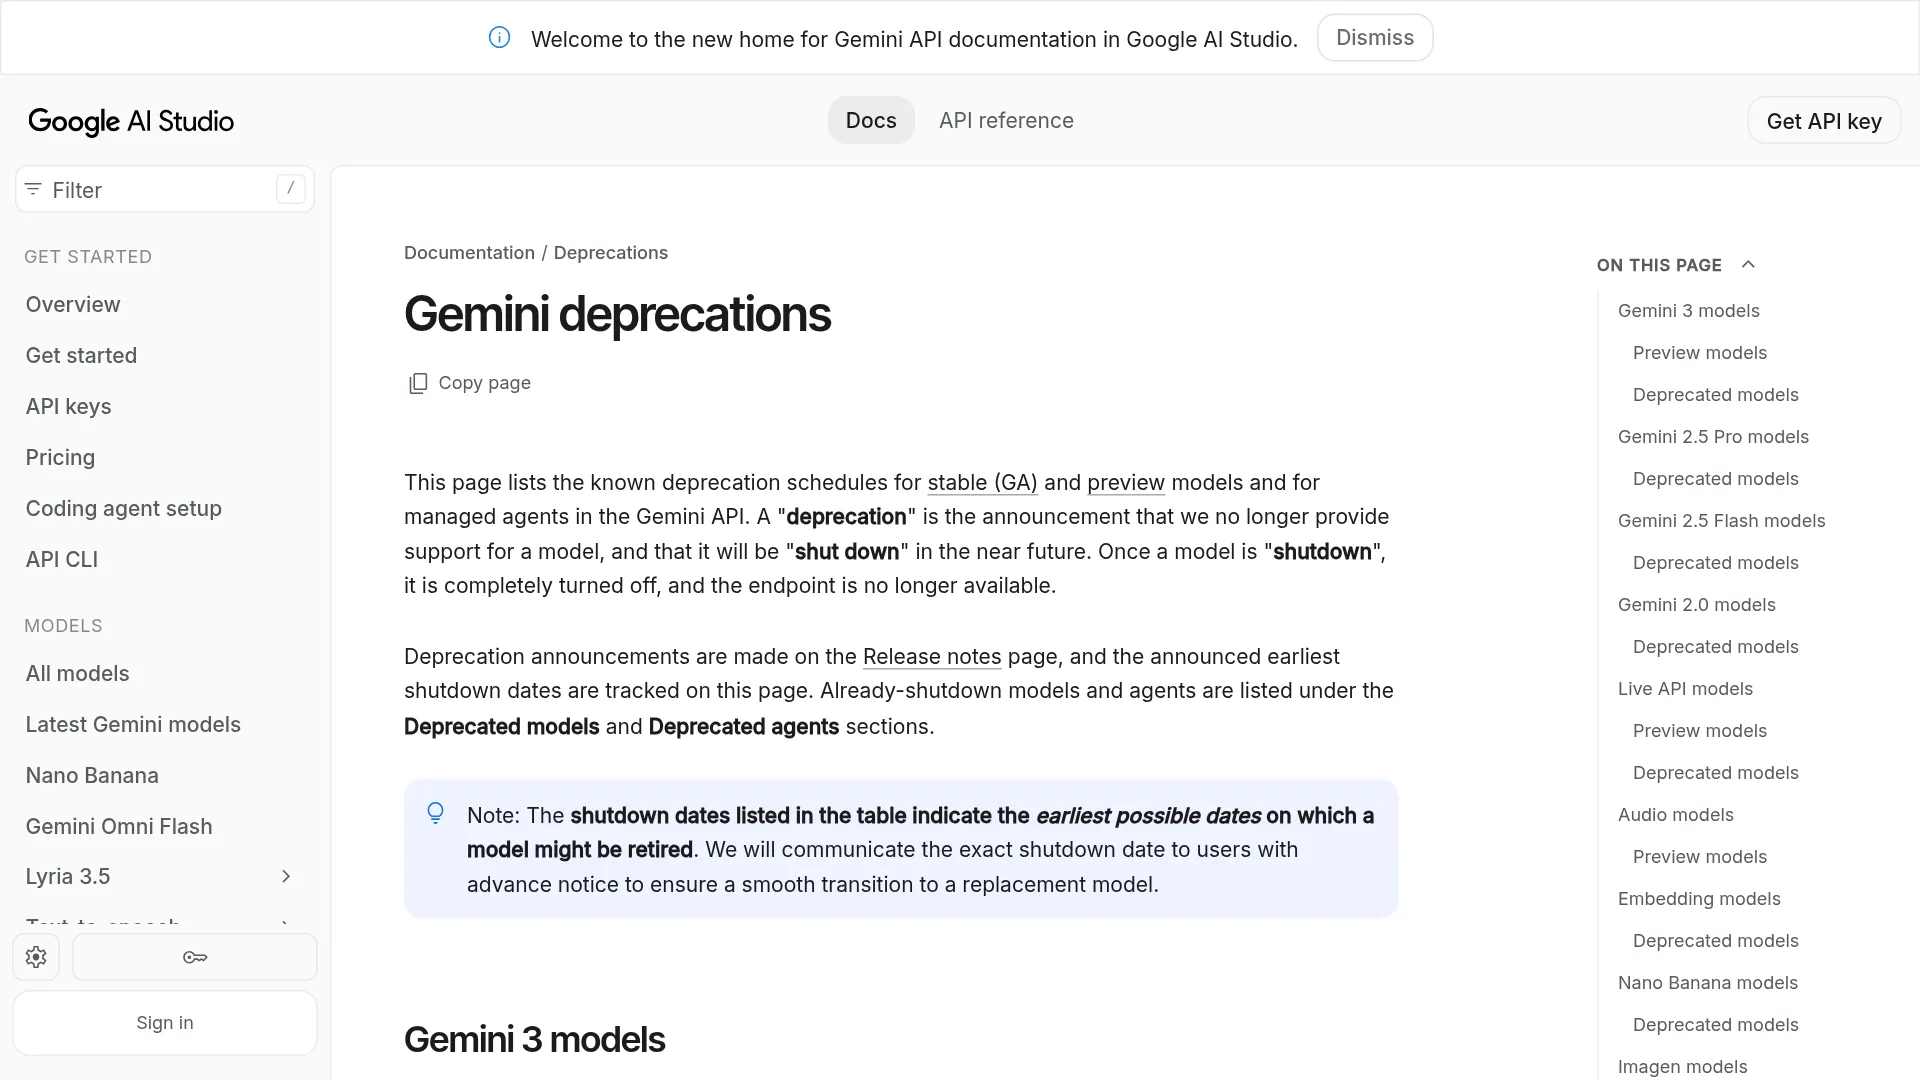
Em 18 de setembro, o Google dizia que o 2.5 "não estava descontinuado". Em 2 de novembro, porém, o modelo foi descontinuado. Portanto, trate 1º de dezembro como uma data definitiva. O histórico do changelog mostra essa mudança de posição.
Quanto as chamadas redirecionadas vão custar em dezembro e janeiro
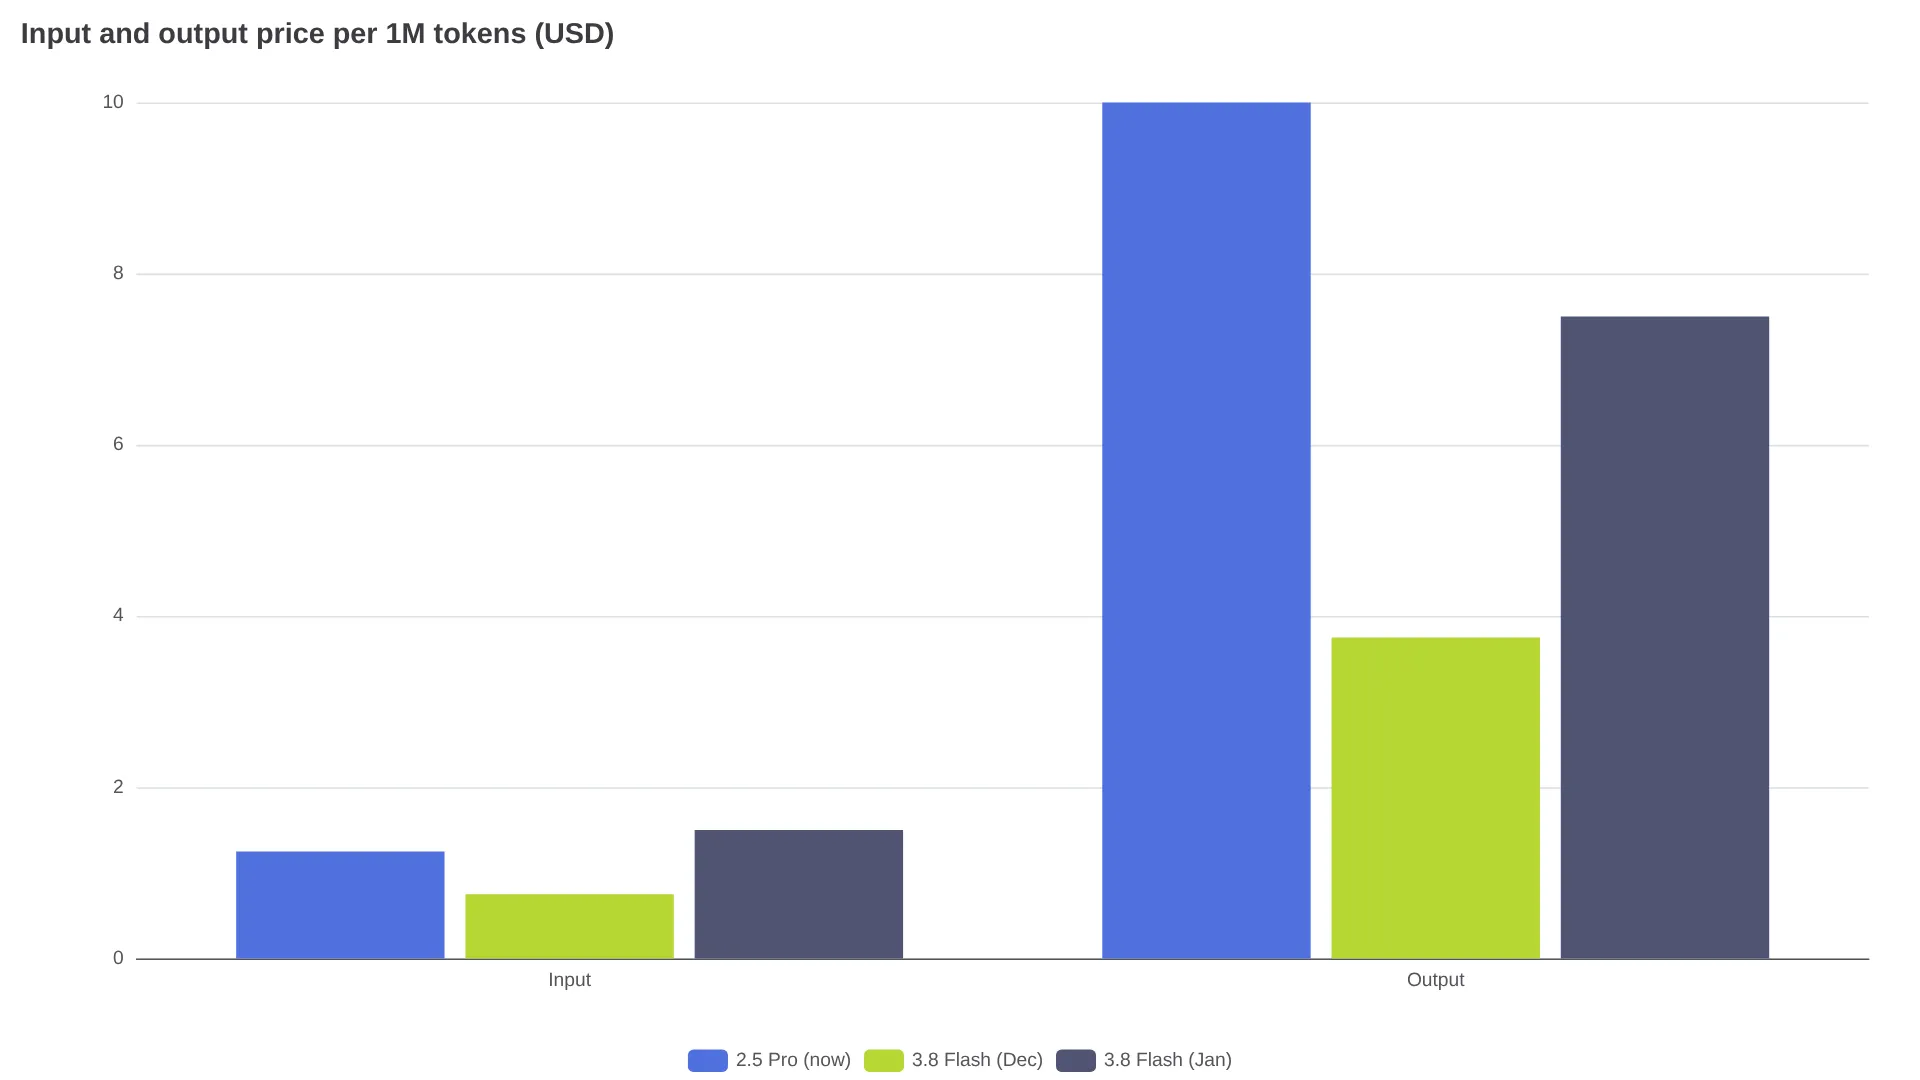
O tráfego do Gemini 2.5 Pro ficará mais barato em dezembro, mas o preço de entrada aumentará em janeiro. Para o Gemini 2.5 Flash, o texto continuará com o mesmo preço após a mudança, enquanto a entrada de áudio ficará bem mais barata. Todos os valores abaixo são preços de tabela do plano pago por 1 milhão de tokens, retirados da página de preços da Gemini API e registrados em 3 de novembro de 2026. Para entender melhor cada modelo, consulte também os artigos sobre o preço do Gemini 3.8 Flash e do Gemini 3.5 Flash-Lite.
| Modelo e período | Entrada / 1 milhão | Saída, incluindo raciocínio / 1 milhão |
|---|---|---|
gemini-2.5-pro, prompts ≤200 mil tokens, até 30 de novembro | $1.25 | $10.00 |
gemini-2.5-pro, prompts >200 mil tokens, até 30 de novembro | $2.50 | $15.00 |
gemini-3.8-flash, de 1º a 31 de dezembro de 2026 | $0.75 | $3.75 |
gemini-3.8-flash, a partir de 1º de janeiro de 2027 | $1.50 | $7.50 |
O Gemini 3.8 Flash tem uma única faixa de preço, independentemente do tamanho do prompt. Por isso, cargas com contexto longo, acima de 200 mil tokens, terão a maior redução. Um prompt com 300 mil tokens de entrada e 4 mil de saída, por exemplo, custa cerca de $0.81 no Gemini 2.5 Pro, com tarifas de $2.50/$15.00; cerca de $0.24 no Gemini 3.8 Flash durante o preço de dezembro, a $0.75/$3.75; e cerca de $0.48 com o preço de janeiro, a $1.50/$7.50. O único cenário que se aproxima da conta antiga em janeiro é o de chats curtos com uso intenso de tokens de entrada.
A mudança do Flash é mais simples:
| Modelo | Entrada de texto/imagem/vídeo | Entrada de áudio | Saída |
|---|---|---|---|
gemini-2.5-flash até 30 de novembro | $0.30 | $1.00 | $2.50 |
gemini-3.5-flash-lite a partir de 1º de dezembro | $0.30 | $0.30 | $2.50 |
O cache de contexto, o processamento em lote e a prioridade seguem a mesma lógica: as tarifas de texto permanecem, enquanto as de áudio caem. Há, no entanto, um detalhe importante para o orçamento: os tokens de raciocínio são cobrados como saída, e os modelos substitutos podem gerar quantidades diferentes desses tokens em tarefas longas. Portanto, não dá para assumir que o volume de saída será igual. Antes de fechar uma projeção, compare o usage_metadata do tráfego real.
Por que a mesma string de modelo pode quebrar um código que funcionava
O redirecionamento automático mantém o HTTP 200, mas troca o modelo executado nos bastidores. O Gemini 3.x aplica regras de requisição que o Gemini 2.5 aceitava. Assim, um código que nunca mexeu no nome do modelo pode começar a falhar ou apresentar mudanças silenciosas depois de 1º de dezembro.
O Gemini 3.x substitui thinking_budget por thinking_level. O Gemini 3.8 Flash aceita low, medium e high, mas rejeita minimal; o Gemini 3.5 Flash-Lite usa minimal por padrão. Enviar os dois campos resulta em HTTP 400, e compartilhar uma configuração com minimal entre os dois modelos substitutos quebra o caminho do 3.8 Flash. O Google recomenda minimal para extração, roteamento e classificação, e medium ou high para subagentes, chamadas de ferramentas, execução de código e raciocínio em várias etapas, evitando que as ferramentas sejam encerradas cedo demais.
Os controles de amostragem e histórico também mudam, segundo o guia de migração do Gemini 3. Atualmente, temperature, top_p e top_k são ignorados no Gemini 3.x e devem passar a retornar HTTP 400 em gerações futuras. candidate_count não é compatível. Qualquer requisição cujo último turno não vazio tenha a função model — a clássica técnica de prefill que termina com Translation: — retorna HTTP 400. O Google recomenda usar system_instruction e saídas estruturadas.
O uso de chamadas de função também ficou mais rigoroso. O Gemini 3.x valida thought_signature e exige que cada FunctionResponse traga o ID e o nome da chamada correspondente. Remover a assinatura ou reconstruir o turno do modelo sem ela pode gerar respostas STOP vazias ou conclusões MISSING_THOUGHT_SIGNATURE, em vez de um erro claro. Os testes de regressão precisam verificar o texto da resposta, não apenas a ausência de exceções.
Usuários reais relataram exatamente esse tipo de problema poucas horas depois do anúncio:
O Google acabou de marcar a data final do Gemini 2.5, mas o detalhe importante não é a descontinuação. É o redirecionamento automático. ... Seu código não vai retornar 404. Ele simplesmente começará a responder usando outro modelo. — @VarunChopr17597
Se o seu agente ainda chama gemini-2.5-flash, em 1º de dezembro ele começará a rodar no Gemini 3.5 Flash-Lite, que usa raciocínio mínimo por padrão. — @MarMarLabs
Faça a migração em novembro: checklist com 7 etapas
O caminho mais seguro é trocar explicitamente os IDs dos modelos, revisar os parâmetros em novembro e depois comparar o modelo substituto com o atual em uma avaliação lado a lado. Não trate o roteador automático como estratégia de migração.
- Encontre todas as referências e aliases de preview. Pesquise no código, nas configurações, nos ambientes de avaliação e na documentação pelos dois IDs afetados, excluindo o modelo Lite que não será alterado:
grep -rnE 'gemini-2\.5-(pro|flash)([^-]|$)' .
- Troque os IDs explicitamente. Altere
gemini-2.5-proparagemini-3.8-flashegemini-2.5-flashparagemini-3.5-flash-liteem uma branch, e não na manhã de 1º de dezembro. - Ajuste a configuração de raciocínio. Substitua
thinking_budgetporthinking_level, defina o valor por modelo —mediumouhighpara agentes no 3.8 Flash;minimal,mediumouhighexplicitamente para cargas no Flash-Lite — e não compartilheminimalcom o 3.8 Flash. - Remova parâmetros antigos. Elimine
temperature,top_p,top_k,candidate_counte os turnos finais do modelo preenchidos manualmente antes dos testes. - Atualize o SDK e a integração com ferramentas. Migre para um SDK atual, preserve os turnos completos do modelo, incluindo
thoughtSignature, monte oFunctionResponsecom o ID e o nome da chamada e teste novamente as chamadas de ferramentas em múltiplos turnos de ponta a ponta. - Execute novamente os testes de referência no modelo substituto. Compare qualidade, latência, tamanho da resposta e contagem de tokens em
usage_metadatausando prompts de produção. Um modelo Flash não terá necessariamente o mesmo estilo de um modelo Pro em todas as tarefas. - Refaça o cálculo de custo duas vezes. Reserve o orçamento de dezembro usando $0.75/$3.75 para a rota do Pro e, a partir de janeiro, $1.50/$7.50. Na rota do Flash, revise também as linhas de áudio e cache.
Equipes que já usam o Gemini 3.x ou o gemini-2.5-flash-lite podem ignorar esta migração. Todos os demais devem concluir a etapa 6 antes de 30 de novembro, porque uma suíte de testes verde em 1º de dezembro pode significar apenas que o roteador está respondendo — não que o comportamento foi preservado.
Quem desenvolve agentes também deve ler a análise de preços do Gemini 3.8 Flash em tarefas de agentes antes de definir os níveis de raciocínio para cargas com muitas ferramentas.
Perguntas frequentes
O Gemini 2.5 Pro será desligado em 1º de dezembro de 2026?
Não. O Google define 1º de dezembro de 2026 como a data de redirecionamento na Gemini Developer API: as requisições para gemini-2.5-pro serão encaminhadas para gemini-3.8-flash, em vez de retornar um erro.
As requisições redirecionadas usarão os preços antigos ou os novos?
Os novos. Depois de 1º de dezembro, uma requisição enviada como gemini-2.5-pro será cobrada pelas tarifas do Gemini 3.8 Flash, enquanto uma chamada para gemini-2.5-flash usará as tarifas do Gemini 3.5 Flash-Lite.
Preciso alterar o código se o redirecionamento for automático?
Sim. A configuração de raciocínio, os parâmetros de amostragem, os turnos preenchidos manualmente e a integração com chamadas de função são diferentes no Gemini 3.x. Um código inalterado pode receber parâmetros ignorados, erros HTTP 400 ou um comportamento de raciocínio silenciosamente diferente.
1º de dezembro também vale para o Vertex AI?
Não. 1º de dezembro é a data da Gemini Developer API. O Google Cloud documenta datas separadas, em outubro de 2026, para a aposentadoria do Gemini 2.5 no Vertex AI e no Enterprise Agent Platform.
O Gemini 2.5 Flash-Lite será afetado?
Não. O Google afirma que o gemini-2.5-flash-lite não foi descontinuado e continuará disponível até novo aviso.
Qual substituto usar em cada tipo de carga?
Escolha de acordo com a tarefa e valide com testes. Não presuma que um modelo Flash será equivalente ao antigo modelo Pro.
| Carga atual | Alvo explícito | Ponto de atenção |
|---|---|---|
| Prompts gerais do Pro, programação e documentos longos | gemini-3.8-flash com medium ou mais | Mudança de categoria do Pro para o Flash; reavalie qualidade, tamanho da resposta e preço de entrada em janeiro |
| Agentes com ferramentas | gemini-3.8-flash com medium ou high | thought_signature, IDs das respostas e encerramento prematuro com minimal |
| Classificação, extração e roteamento | gemini-3.5-flash-lite com minimal | É a opção mais barata; aumente para medium se ferramentas forem adicionadas |
| Fluxos de transcrição de áudio | gemini-3.5-flash-lite | A entrada de áudio cai de $1.00 para $0.30; revise as linhas de cache |
O que fazer antes de 30 de novembro
Troque as duas strings de modelo ainda esta semana, ajuste o raciocínio e a integração com ferramentas e crie uma nova referência usando os modelos substitutos enquanto o Gemini 2.5 ainda responde. O redirecionamento de dezembro manterá o serviço funcionando, mas somente uma migração feita em novembro manterá o comportamento e a conta sob controle.