 AIREITER
O Hyra 2.0, da Tencent, foi criado para transformar pesquisas em modelos e ferramentas científicas reutilizáveis — em vez de resolver um problema pontual e descartar todo o trabalho depois. Mas há uma limitação importante: o agente continua restrito à Tencent, enquanto apenas alguns resultados foram publicados.
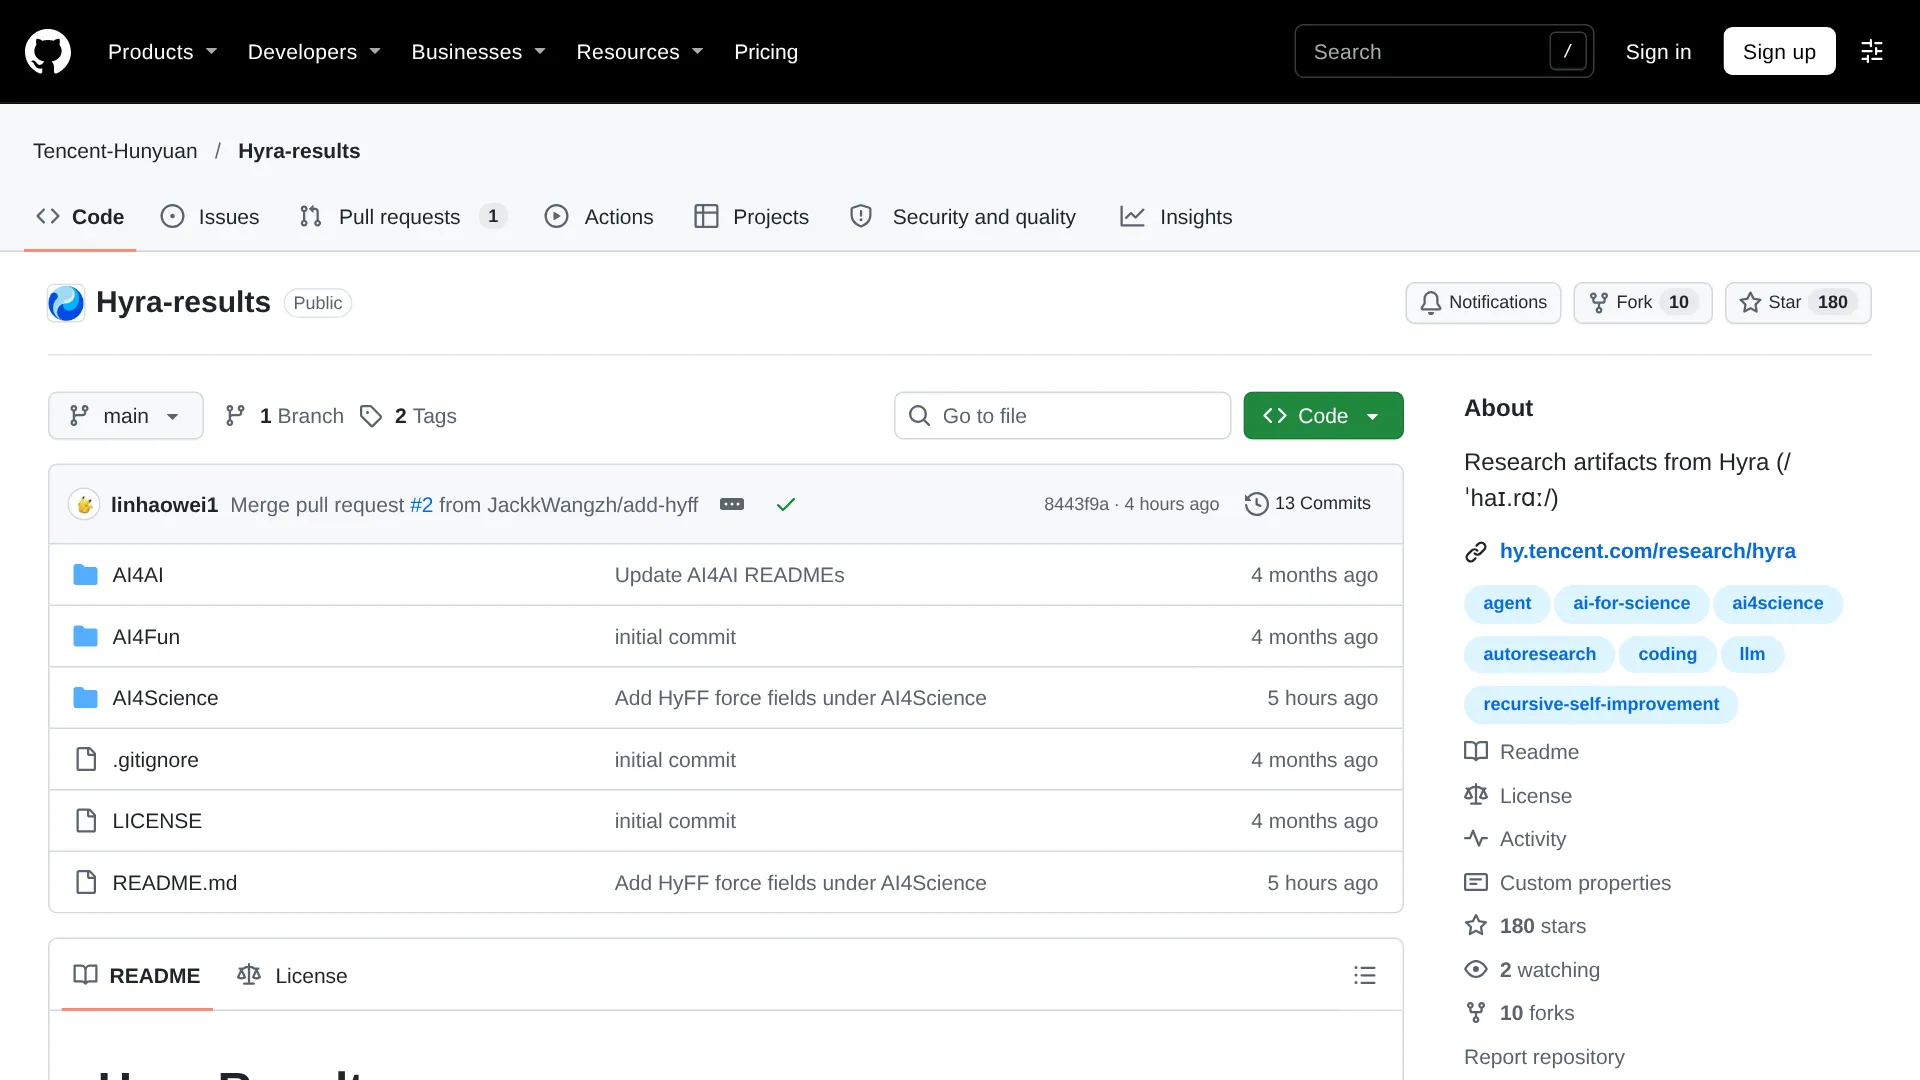
O repositório Hyra-results deixa clara a diferença entre artefatos que podem ser baixados e resultados divulgados apenas como anúncio. É essa separação que orienta o restante deste guia.
O que o Hyra 2.0 é — e o que ele não é
Abreviação de Hunyuan Research Agent 2.0, o Hyra 2.0 é o sistema hierárquico da Tencent Hunyuan para automatizar pesquisa científica e engenharia. A Tencent o apresenta como uma infraestrutura capaz de desenvolver modelos científicos reutilizáveis, pipelines de validação e fluxos de trabalho em várias etapas — não como mais um modelo de conversa genérico da linha Hunyuan.
Em seu anúncio oficial no X, publicado em 2 de novembro de 2026, a Tencent descreve o Hyra 2.0 como “a próxima evolução do Hunyuan Research Agent”, que passa “da resolução de problemas à criação de ferramentas, modelos e fluxos de trabalho reutilizáveis”. Já o repositório público Hyra-results reúne resultados e alguns modelos treinados, não o sistema completo de orquestração. Nem o anúncio nem o repositório informam a existência de demo pública, pacote de instalação, API, preço ou cota. A melhor forma de entender o projeto é pensar no Hyra 2.0 como o laboratório, enquanto os modelos de proteínas HyInv e HyPLM-Flash são amostras que saíram dele.
Como o Hyra 2.0 mantém um projeto de semanas nos trilhos
O Hyra 2.0 distribui pesquisas de longa duração entre três camadas de agentes, armazenamento persistente e uma etapa independente de revisão. Segundo o relato de lançamento do IT之家, baseado na conta oficial da Tencent Hunyuan no WeChat, a divisão entre agentes Overall, Mission e Worker permite manter experimentos em andamento por dias ou semanas sem perder o contexto.
Agentes Overall conversam com os pesquisadores, alinham objetivos e distribuem o orçamento computacional. Agentes Mission ficam responsáveis por uma linha de pesquisa, escolhem os caminhos experimentais e respondem pelas conclusões. Agentes Worker leem código, executam experimentos reais, analisam falhas e podem contestar a avaliação de um agente Mission. Vários Workers podem trabalhar em paralelo, usando modelos-base diferentes.
Essa estrutura se apoia em três mecanismos de persistência:
- Estado do projeto registra o andamento de um programa de pesquisa, permitindo que as tarefas sobrevivam a interrupções em filas persistentes.
- Memória em camadas dos agentes separa observações de curta duração de descobertas que precisam ser acompanhadas por mais tempo, em vez de despejar tudo em uma única janela de contexto.
- Shared Books armazenam conhecimento classificado conforme o nível de evidência — observações de uma única execução, resultados reproduzidos e convenções confirmadas por humanos. Métodos que demonstram ser transferíveis são extraídos como pequenas skills reutilizáveis em execuções futuras.
Dois mecanismos de controle completam o desenho. Cada conclusão vem acompanhada de logs concretos e versões do código, enquanto um Worker de revisão separado reexamina a afirmação a partir de um ponto de partida independente antes que ela chegue aos humanos. Grandes tarefas computacionais ainda exigem aprovação humana. De acordo com a análise técnica da Eyerys, o sistema também se conecta a infraestruturas comuns de laboratório, como mensageria corporativa, plataformas de envio de jobs e repositórios de código.
Essa verificação tem um custo. Um profissional estimou que fazer os Workers inspecionarem as sessões uns dos outros poderia elevar bastante o consumo de tokens (@d6355v). A Tencent não divulgou orçamento de tokens, custo computacional, taxa de falhas nem a frequência com que a revisão independente identifica erros. Por isso, a arquitetura deve ser vista como uma proposta para aumentar a confiabilidade em pesquisas longas, ainda com custos operacionais não revelados.
O que o Hyra 2.0 realmente lançou até agora
As evidências públicas do Hyra 2.0 se dividem em duas categorias: artefatos baixáveis, com pesos e código, e resultados divulgados pela Tencent que ainda aguardam reprodução externa. A tabela abaixo leva cada item à fonte que pode ser conferida.
| Artefato | O que é | Principal número divulgado | Status da evidência |
|---|---|---|---|
| HyInv | Modelo de inverse folding de proteínas com 1.96M de parâmetros, pesos de 7.8 MB, CLI + API Python | Geração ~57x mais rápida que o ProteinMPNN; 25 ms contra ~1 s em proteínas de 148 resíduos (1 GPU H20), segundo a análise da TSN | Artefato disponível para inspeção (MIT); benchmark executável; resultado principal ainda não reproduzido de forma independente |
| HyPLM-Flash | Modelo de linguagem mascarado para proteínas com 650M de parâmetros, pesos de 2.6 GB e mecanismo INT8 | ~130.000 resíduos/s em 1x H20; inferência mais rápida no teste da Tencent com 12 modelos/35 tarefas, média na 3ª posição; Spearman de 0.409 no ProteinGym, empatado com a classe ESM-2 650M, segundo a análise da TSN | Artefato disponível para inspeção (MIT); requer GPU CUDA; as duas avaliações cobrem quantidades diferentes de modelos e tarefas |
| HyFF | 5 campos de força de ML (Presto, Vivace, Moderato, Andante, Largo), com 2.3M–1.2B de parâmetros e 83 elementos | Erro de energia do Largo de 0.364 meV/átomo contra 0.380 do DPA4-Pro, a 9.7x da velocidade; Andante é 29x mais rápido que o UMA-S-1.2 em uma simulação MD com 2.586 átomos, usando 1x H20 | Artefato disponível para inspeção (Apache-2.0), com o pacote hyff; as velocidades estão vinculadas a uma carga de trabalho em uma H20 |
| Conjectura de Petty, dimensão 5 | Artefato de prova: todo espaço normado real de 5 dimensões contém 6 pontos equidistantes (o melhor resultado anterior era a dimensão 4, Makeev 2005), segundo o índice do repositório | Resolve a dimensão 5 | Artigo disponível para inspeção; nenhuma revisão por pares em periódico foi informada |
| Ação de círculo de Yau | Contraexemplo alegado: 7-variedade fechada, com curvatura seccional positiva e sem ação efetiva de círculo, segundo o índice do repositório | Resolve o caso irrestrito; o caso simplesmente conexo continua em aberto | Artigo disponível para inspeção; nenhuma revisão por pares em periódico foi informada |
| HyQEC | Código de correção de erros quânticos derivado da linhagem do qLDPC Challenge, segundo a Prompt Blueprints | ~48% mais eficiência de codificação que o líder anterior | Anunciado; artefato completo ainda pendente no GitHub |
| XiangShan RISC-V | Otimização de processador de código aberto, segundo a Prompt Blueprints | +5.79% de pontuação por GHz, com aumento mínimo de área; bugs multicore corrigidos | Anunciado; nome do benchmark e baseline não divulgados |
| Mão robótica | Mão de cinco dedos com comprimentos graduais, segundo a Eyerys | +28.6% na velocidade de rotação de objetos em uma simulação com orçamento fixo | Anunciado; até agora, apenas em simulação |
Em comparação com o Hyra 1.0, a mudança é clara: sair de respostas e passar a entregar ativos reutilizáveis. O Hyra 1.0 mostrou que o ciclo poderia funcionar: sua entrada sums_diffs melhorou uma constante de combinatória de 1.14489 para 1.21079, e a Tencent atribui ao sistema avanços em um problema de combinatória aditiva com 50 anos. A análise de lançamento da Prompt Blueprints observa que o Hyra 2.0 mantém esse mecanismo iterativo, mas acrescenta a hierarquia, projetos persistentes e extração de skills para tornar cada sucesso reutilizável.
O que você pode executar hoje — e o que continua dentro da Tencent
É possível executar os produtos do Hyra 2.0, mas o orquestrador não tem instalação pública. O repositório Hyra-results usa a licença Apache-2.0, e cada pasta de resultado tenta incluir os artefatos finais e scripts de reprodução. O ponto de partida é este:
git clone https://github.com/Tencent-Hunyuan/Hyra-results.git
ls AI4Science/hyinv
Depois, escolha um dos caminhos:
- HyInv (mais simples): abra
AI4Science/hyinvpara acessar os pesos, o código de inferência e o relatório técnico. O caminho de referência roda em CPU e GPU; o caminho acelerado em BF16 foi validado apenas em GPUs da classe Hopper. - HyPLM-Flash (exige CUDA): abra
AI4Science/hyplm_flashe executeweights/download.shpara baixar, mesclar e verificar os pesos de 2.6 GB. Reserve uma GPU da classe H20/H100; use INT8 para extração de representações e BF16 para regressão detalhada de variantes. - HyFF (H20 para as velocidades anunciadas): use a seção do HyFF para acessar os cinco modelos de campos de força, com 9 MB–4.8 GB cada, e o pacote
hyff, que oferece suporte a estruturas individuais, processamento em lote e dinâmica molecular NVE/NVT/NPT.
O que continua fechado: o orquestrador Overall/Mission/Worker, os prompts, os schedulers, os avaliadores e o armazenamento de Books/skills. A aprovação humana para grandes jobs computacionais também significa que o sistema não é totalmente autônomo na alocação de recursos. Em resumo: não há nada para instalar no agente; para testar o artefato mais simples, o download é de 7.8 MB, já que a TSN observa que é barato configurar uma comparação direta entre HyInv e ProteinMPNN usando backbones idênticos.
Os números de destaque resistem à análise?
A TSN informou que todos os números de desempenho vieram da Tencent ou da documentação dos modelos, sem reprodução independente publicada até 2 de novembro de 2026. Cada número precisa ser lido junto com suas condições de medição.
Primeiro: velocidade não é qualidade. O 57x do HyInv compara o throughput de geração em uma Nvidia H20 — cerca de 25 ms contra cerca de 1 s para 148 resíduos, e 54 ms contra 2.6 s para 402 resíduos —, não o sucesso em laboratório. A similaridade estrutural é calculada com base em estruturas previstas, e não há validação em laboratório úmido:
57x sobre o ProteinMPNN e ~2.500 designs/s representam throughput, não qualidade dos designs. O que eu gostaria de ver em seguida: RMSD de autoconsistência e recuperação de sequência... Na prática, o inverse folding raramente é o gargalo — o refold posterior é.
Segundo: afirmações de eficiência precisam vir acompanhadas do hardware e do escopo. O “mais rápido entre 12” do HyPLM-Flash se refere à avaliação da Tencent com 12 modelos e 35 tarefas; a avaliação equivalente do repositório cobre 28 checkpoints e 32 tarefas, com Spearman zero-shot de 0.409 no ProteinGym, estatisticamente empatado com ESM-2 650M, ESM C 600M e E1-600M. As velocidades de 29x e 9.7x do HyFF estão vinculadas a um sistema de 2.586 átomos em uma H20, e o erro de força do Andante (7.65 meV/Å) é ligeiramente pior que o do UMA-S-1.2 (7.55 meV/Å): velocidade com precisão quase equivalente, não uma vitória em todas as categorias.
Terceiro: a reutilização — a tese central do 2.0 — ainda não foi comprovada. Os materiais de lançamento não explicam como uma skill gerada é validada antes de ser reutilizada, quem a aprova nem se a reutilização foi medida entre projetos:
Criar ferramentas reutilizáveis em vez de respostas únicas é o caminho certo. A maioria das execuções de agentes descarta tudo o que descobriu quando a tarefa termina. Gostaria de saber como o Hyra decide que uma ferramenta é boa o bastante para ser mantida e reutilizada.
Outro profissional levantou a mesma questão de validação, mas pelo ponto de vista do humano no circuito (@ModelPlaneHQ). Os materiais de lançamento da Tencent e as análises independentes citadas acima não publicam um benchmark frente a frente com concorrentes como o AI Co-Scientist, do Google, ou o AI Scientist, da Sakana AI. Qualquer ranking hoje, portanto, dependeria dos próprios números da Tencent. Ao avaliar um modelo criado por agentes, faça quatro perguntas: em qual hardware, com qual nível de qualidade, reproduzido por quem e reutilizado onde?
Perguntas frequentes
O Hyra 2.0 é open source? Posso testá-lo?
O framework é fechado; os artefatos são abertos. Não há demo pública, API ou instalação disponível para o agente. HyInv e HyPLM-Flash usam pacotes de modelos licenciados sob MIT, enquanto o HyFF segue os termos Apache-2.0 do repositório. Consulte o README e a licença de cada pasta.
Qual é a diferença entre o Hyra 2.0 e o Hyra 1.0?
O Hyra 1.0 era focado na resolução iterativa de problemas, incluindo um resultado em combinatória que estava em aberto havia muito tempo. O Hyra 2.0 acrescenta a hierarquia Overall/Mission/Worker, o estado persistente dos projetos, o conhecimento em Books, a extração de skills e o objetivo explícito de produzir modelos e fluxos de trabalho reutilizáveis.
Os resultados matemáticos passaram por revisão por pares?
Não como publicações em periódicos. Os artigos sobre a dimensão 5 de Petty e o contraexemplo de Yau estão públicos e podem ser inspecionados. O índice do repositório também registra formalizações em Lean 4 para três resultados anteriores de núcleo finito (Beurling-Ahlfors, Hadamard parcial e comutador). Todos devem ser tratados como afirmações que ainda aguardam revisão de especialistas.
De qual hardware preciso para reproduzir os modelos de proteínas?
O caminho de referência do HyInv roda em CPU e GPU e exige um download de 7.8 MB. O HyPLM-Flash precisa de uma GPU CUDA — recomenda-se uma H20/H100 — para seu mecanismo INT8 de 2.6 GB, e os números de velocidade do HyFF pressupõem uma H20.
Como avaliar o Hyra 2.0 sem exagerar nas conclusões
O Hyra 2.0 aposta que a unidade do progresso científico deve ser a ferramenta, não a resposta, com skills reutilizáveis se acumulando e gerando o que a Tencent chama de retornos compostos sobre a inteligência (智能复利). O lançamento mostra modelos e ferramentas atribuídos ao sistema; saber se eles realmente aceleram pesquisas futuras de forma recorrente dependerá de dados sobre taxa de reutilização, custo de validação e reprodução independente — métricas que ainda não aparecem ao lado dos recordes de velocidade.