 AIREITER
Para filas rotineiras no Devin, o SWE-2 Flash parece ser a escolha padrão: entrega 200 tokens por segundo por um quinto do custo do SWE-2. A exceção são tarefas parecidas com as do Terminal-Bench 4.0, em que o SWE-2 Flash ainda fica em 20,0%, contra 27,3% do SWE-2 e mais de 40% dos líderes.
Veredito: Flash para a fila, SWE-2 para os 10% mais difíceis
O SWE-2 Flash merece o posto de padrão para trabalhos de engenharia em alto volume e baixa ambiguidade dentro do Devin. A troca são algumas perdas de qualidade em benchmarks específicos por uma geração 3x mais rápida e um custo por tarefa bem menor.
| Perfil da tarefa | Use | Motivo |
|---|---|---|
| Automações, revisão de código, recursos pequenos e atualizações de documentação | SWE-2 Flash | A Cognition posiciona o SWE-2 Flash para o trabalho cotidiano; nesse caso, a velocidade pesa mais que o planejamento profundo |
| Refatorações grandes, repositórios desconhecidos e trabalho de terminal parecido com o Terminal-Bench-4.0 | SWE-2 | O SWE-2 supera o SWE-2 Flash por 27,3% a 20,0% no Terminal-Bench 4.0 e por 73,0% a 60,1% no DeepSWE 1.1 |
| Trabalho sensível do ponto de vista de segurança ou executado on-premises | Aguarde | Os pesos do SWE-2 Flash não são públicos; por enquanto, só existe a promessa de um futuro programa de compartilhamento seguro |
O acesso gratuito no Devin Desktop e no CLI até 30 de novembro de 2026 torna o teste barato. Comece as novas filas rotineiras com o SWE-2 Flash e meça o retrabalho antes de adotá-lo de vez.
O que é o SWE-2 Flash: Inkling-Small com uma etapa extra de treinamento
O SWE-2 Flash é o modelo de código rápido da Cognition, construído sobre o Inkling-Small, da Thinking Machines. Ele combina uma base de mistura de especialistas com 276B de parâmetros totais e 12B ativos a uma nova etapa de treinamento intermediário da Cognition, antes do aprendizado por reforço.
Nessa etapa intermediária, a equipe escolheu as misturas de dados usando gráficos de eficiência em tokens e treinou o modelo com alguns trilhões de tokens, divididos em três fases, deixando os dados mais escassos para o fim. A perda em dados não utilizados caiu a uma taxa log-linear estável. Depois, o aprendizado por reforço com tarefas auditadas elevou o resultado no Terminal-Bench 4.0 de 0,9% para 20,0% e no FrontierCode 2.0 de 3,2% para 24,0%, segundo uma publicação da Cognition de 4 de novembro de 2026. A empresa também informa 200 tokens por segundo no SWE-2 Flash, contra 60 tokens por segundo no SWE-2.
"A novidade da Cognition chegou: SWE-2 Flash! Um modelo Flash com 276B de parâmetros totais e 12B ativos. Eu não esperava ver um modelo Flash para o SWE-2; fiquei surpreso, mas gostei da ideia. Os resultados nos benchmarks parecem ótimos — ele não está tão distante do modelo SWE-2 de 2,8T." — @ItsmeAjayKV, primeira reação de um usuário real
Os benchmarks contam histórias diferentes — veja cada suíte separadamente
Os resultados do SWE-2 Flash variam bastante entre as suítes. O modelo se sai bem em tarefas de software estruturadas, mas perde terreno de forma significativa no trabalho de terminal mais aberto. Por isso, uma média única pode ser enganosa.
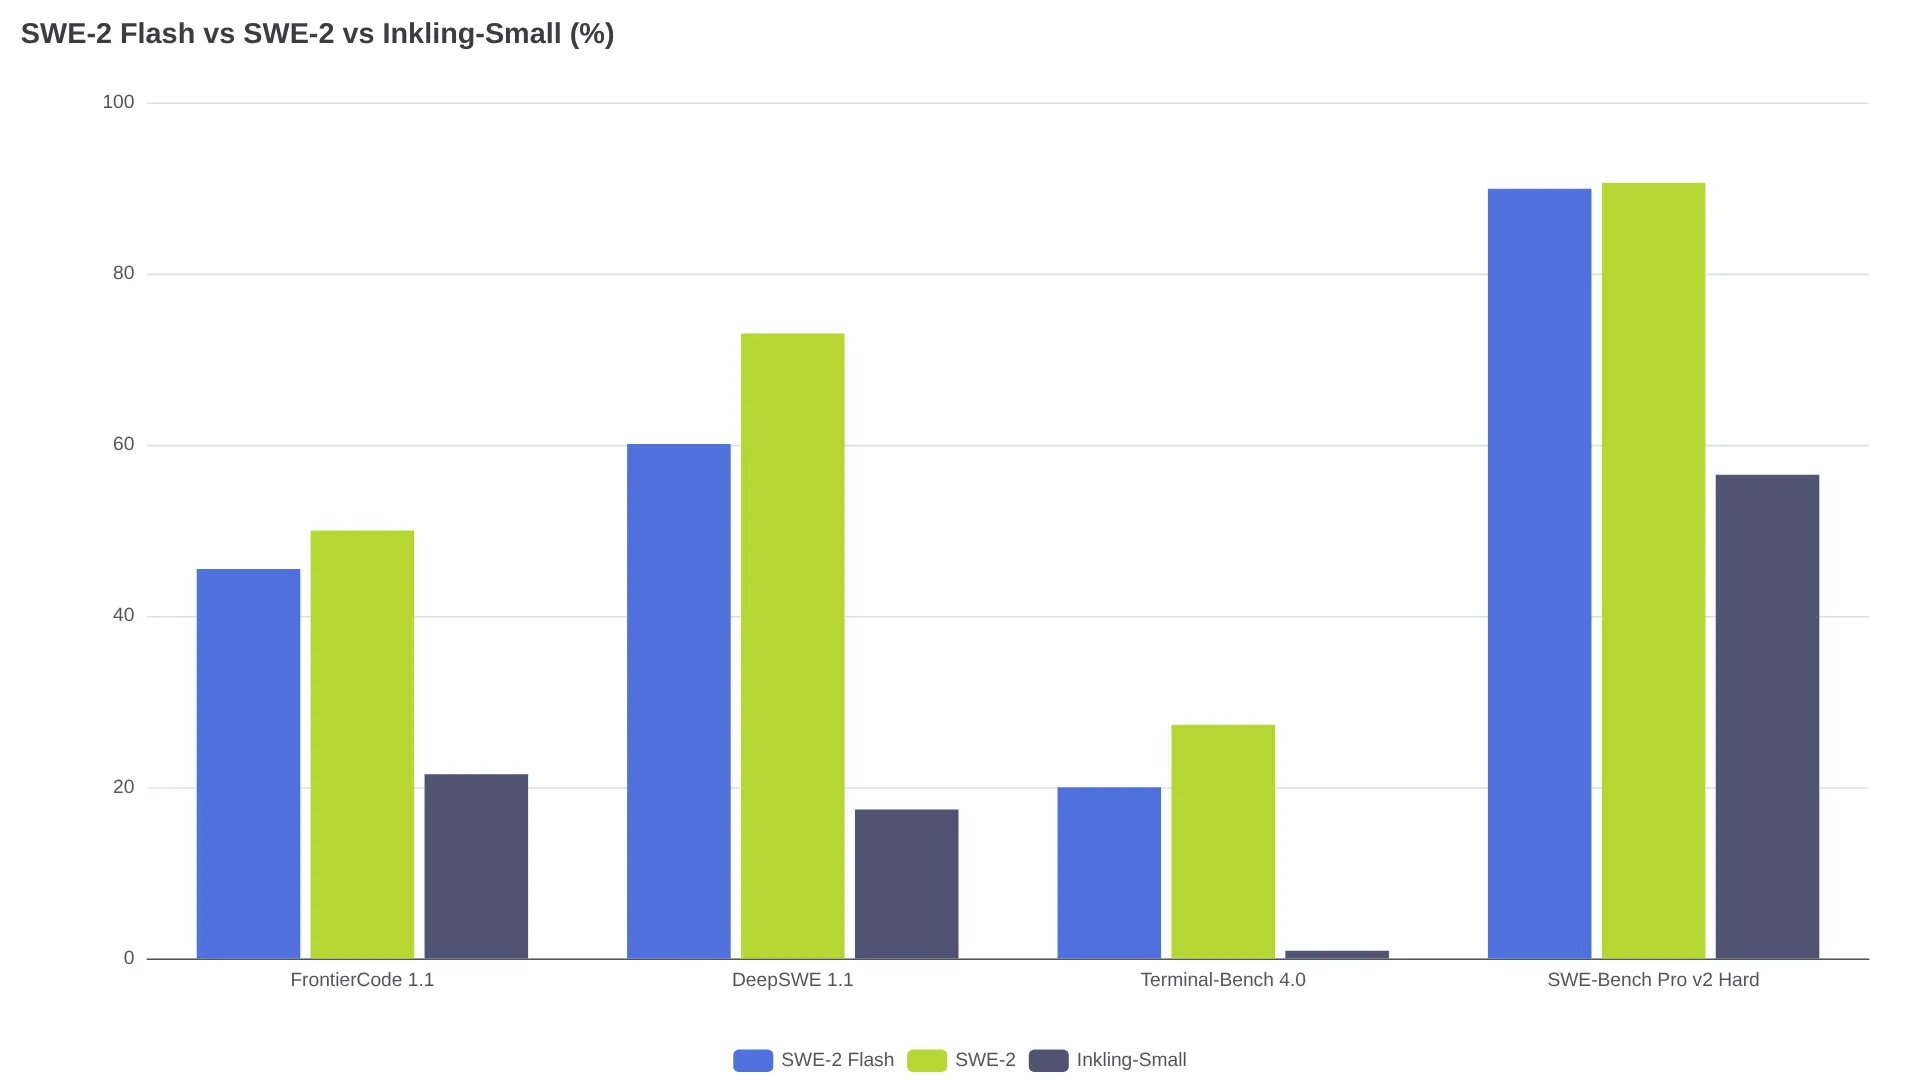
| Benchmark | SWE-2 Flash | SWE-2 (2.8T-A104B) | Inkling-Small | Melhor resultado na tabela da Cognition |
|---|---|---|---|---|
| FrontierCode 1.1 Main | 45,5% | 50,0% | 21,5% | 50,0% SWE-2 |
| FrontierCode 2.0 | 24,0% | 23,8% | 3,2% | 27,7% Claude Haiku 5.5 |
| DeepSWE 1.1 | 60,1% | 73,0% | 17,4% | 77,0% DeepSeek V4.1 Flash |
| Terminal-Bench 2.1 | 89,2% | 92,8% | 64,7% | 94,4% Claude Haiku 5.5 |
| Terminal-Bench 4.0 | 20,0% | 27,3% | 0,9% | 42,3% DeepSeek V4.1 Flash |
| SWE-Bench Pro v2 Hard | 89,9% | 90,6% | 56,5% | 90,6% SWE-2 |
| SWE-Atlas QA | 50,0% | 56,3% | 27,4% | 71,0% DeepSeek V4.1 Flash |
| ExploitBench | 34,8% | 36,1% | 11,3% | 44,7% GPT-6 Luna |
O ganho tem limites. O SWE-2 Flash mais que dobra o resultado do Inkling-Small no FrontierCode 1.1 Main (45,5% contra 21,5%) e salta de 56,5% para 89,9% no SWE-Bench Pro v2 Hard, praticamente empatando com o SWE-2, que marcou 90,6%.
O Flash não resolve os pontos fracos do SWE-2. Não extrapole o bom desempenho no SWE-Bench Pro para sessões longas de terminal; o GLM 5.3 Flash chega a 41,8% no Terminal-Bench 4.0 da mesma tabela.
A afirmação sobre pesos abertos precisa de contexto. O SWE-2 Flash supera o Muse Spark Open na maioria das linhas (60,1% contra 60,0% no DeepSWE 1.1 e 24,0% contra 6,2% no FrontierCode 2.0), mas o DeepSeek V4.1 Flash e o GLM 5.3 Flash vencem o SWE-2 Flash no Terminal-Bench 4.0, no SWE-Atlas QA e no DeepSWE 1.1. Todos os números são informados pelos próprios fornecedores, com cada modelo executado em sua configuração de melhor esforço; além disso, os harnesses variam entre os fornecedores.
O que significa custar um quinto quando não existe tabela de preços
Não há preço por token porque não existe um endpoint independente. O único sinal de preço é a proporção de custo por tarefa divulgada pela Cognition: um quinto dos dólares por execução do SWE-2, incluindo o modelo, o harness e a infraestrutura de serviço.
Essa proporção ajuda, mas não conta a história toda. A Cognition também nunca publicou o custo por tarefa do SWE-2; a análise do SWE-2 feita pela OrcaRouter só conseguiu usar o Fable 5.1 como referência, a $3.28 por tarefa do FrontierCode em esforço médio e $12.83 no esforço máximo. Os planos do Devin listados ali eram Free $0, Pro $20 por mês, Max $200 por mês e Teams $80 mais $40 por assento — cobrança por assinatura, não por tokens consumidos. Portanto, um custo por tarefa equivalente a um quinto não aparece automaticamente como uma fatura menor do Devin.
Na prática, o período gratuito até 30 de novembro de 2026 no Devin Desktop e no CLI, disponível para usuários Pro, Max e Teams, é a forma mais barata de medir o consumo real. Acompanhe quantas tarefas são concluídas por semana e a taxa de retrabalho, não a quantidade de tokens. Se o SWE-2 Flash concluir os chamados rotineiros de primeira, a 200 tok/s, a economia real será maior que a indicada pela proporção de 1/5; se for preciso escalar as tarefas para o SWE-2, a vantagem desaparece.
Quem pode usar: acesso exclusivo ao Devin e um programa de pesos que não significa pesos abertos
Hoje, a disponibilidade do SWE-2 Flash é restrita. A Cognition informa que ele pode ser usado no Devin Desktop e no Devin CLI.
Não existe identificador de API público, pesos no Hugging Face nem caminho para hospedagem própria. A Cognition justifica a restrição como uma medida de gerenciamento de risco cibernético: o treinamento do SWE-2 Flash foi direcionado deliberadamente para tarefas de segurança, elevando o resultado no ExploitBench de 11,3% para 34,8%; a mesma capacidade poderia ajudar atacantes. A solução proposta é um programa para compartilhar os pesos com segurança com parceiros confiáveis do setor e laboratórios de pesquisa, com detalhes prometidos para as próximas semanas. Portanto, trate isso como um plano de acesso controlado, não como um compromisso com pesos abertos.
Fora do Devin, não é possível avaliar o SWE-2 Flash diretamente hoje: não há endpoint público nem caminho para hospedagem própria.
Flash ou SWE-2? Uma regra de roteamento por tarefa
Volume vai para o SWE-2 Flash; ambiguidade vai para o SWE-2.
Use primeiro o SWE-2 Flash para automações, atualizações de dependências, inclusão de testes, respostas a revisões, recursos pequenos com critérios de aceitação claros e alterações na documentação. Essas tarefas correspondem às suítes em que o SWE-2 Flash fica a poucos pontos do SWE-2: 24,0% contra 23,8% no FrontierCode 2.0 e 89,9% contra 90,6% no SWE-Bench Pro v2 Hard.
Escalone para o SWE-2 quando a tarefa exigir planejamento entre vários arquivos, sequências longas de terminal ou raciocínio relacionado à exploração de vulnerabilidades. Nesses casos, as diferenças são relevantes: o Flash fica 12,9 pontos atrás no DeepSWE 1.1, 6,3 pontos atrás no SWE-Atlas QA e 7,3 pontos atrás no Terminal-Bench 4.0. A análise do SWE-2 feita pela HamiRev descreve o modelo como otimizado para usar menos etapas e fazer edições mais cedo que o SWE-1.7 — uma preferência por tarefas curtas que o SWE-2 Flash leva ainda mais adiante.
Comece cada chamado no SWE-2 Flash, com um limite de duas rodadas, e escale o trabalho travado para o SWE-2. Reavalie a decisão depois do período gratuito de novembro, quando o gasto real no Devin substituir a proporção de 1/5. A questão ainda em aberto é a transparência: o programa de compartilhamento seguro de pesos pode viabilizar implantações privadas, mas equipes de setores regulados não conseguem planejar em torno do SWE-2 Flash antes que os termos sejam divulgados.
FAQ do SWE-2 Flash
O SWE-2 Flash está disponível por API?
Não existe uma API independente do SWE-2 Flash. O acesso é feito pelo Devin Desktop e pelo Devin CLI, gratuitamente para usuários Pro, Max e Teams até 30 de novembro de 2026.
O SWE-2 Flash tem pesos abertos?
Não. A Cognition cita riscos cibernéticos e promete apenas um futuro programa de compartilhamento seguro para parceiros selecionados e laboratórios de pesquisa.
Como o SWE-2 Flash se compara ao SWE-2?
O SWE-2 Flash roda a 200 tok/s, contra 60 tok/s do SWE-2, e custa um quinto por tarefa segundo a conta de custos da Cognition. O SWE-2 ainda lidera no DeepSWE 1.1 (73,0% contra 60,1%) e no Terminal-Bench 4.0 (27,3% contra 20,0%).
Qual é a janela de contexto do SWE-2 Flash?
A Cognition não publicou as especificações de janela de contexto, saída máxima ou modalidades do SWE-2 Flash. Não presuma que ele herda os limites do Inkling-Small.
O que acontece depois do período gratuito de 30 de novembro?
A Cognition não informou como será a cobrança do SWE-2 Flash depois da promoção. A expectativa é de consumo dentro da assinatura do Devin, e não de um preço separado por token.