 AIREITER
O Gemini 3.8 Flash custa $0.75 por milhão de tokens de entrada e $3.75 por milhão de tokens de saída até December 31, 2026, mas o raciocínio mais avançado pode deixar cada tarefa concluída mais cara. Teste o modelo em agentes multimodais e especializados antes de migrar todas as solicitações do Gemini 3.7 Flash.
A resposta no lançamento: o que o Gemini 3.8 Flash realmente é
O Gemini 3.8 Flash foi lançado em September 2, 2026, segundo o anúncio de lançamento do Google, com o ID estável de modelo da API gemini-3.8-flash. O Google posiciona o modelo para engenharia de software, agentes autônomos e fluxos de trabalho corporativos com várias etapas. A página do modelo no Google AI for Developers o classifica como estável, enquanto o model card do Google DeepMind informa que ele é baseado no Gemini 3.7 Flash.
O que mudou em relação ao Gemini 3.7 Flash
O Google afirma que o Gemini 3.8 Flash executa mais etapas de raciocínio e chama ferramentas de forma iterativa em tarefas difíceis, mas alerta que um nível maior de esforço pode consumir mais tokens. A Artificial Analysis registra um Intelligence Index de 59 no nível alto de raciocínio, contra 56 do Gemini 3.7 Flash, mas também um custo por tarefa de $0.58, contra $0.40. (Anúncio de lançamento do Google; comparação da Artificial Analysis)
Escolha pelo fluxo de trabalho antes de escolher o modelo
O Gemini 3.8 Flash se destaca quando uma solicitação se beneficia de um contexto amplo, várias ferramentas ou evidências multimodais. Tarefas curtas e repetitivas podem não aproveitar os ciclos extras de raciocínio.
Use o Gemini 3.8 Flash em agentes multimodais e especializados
A BenchmarkList registra 61.4% no Finance Agent v2, 54.9% no HLE-Verified, 87.8% no LVBench, 86.2% no CharXiv-R e 86.2% no LABBench2. Os registros distinguem resultados divulgados no lançamento, autodeclarados e obtidos de fontes independentes. Portanto, esses números são sinais úteis, mas não formam um único teste independente e uniforme. (registro do modelo na BenchmarkList)
| Fluxo de trabalho | Evidência a considerar | Decisão |
|---|---|---|
| Análise financeira e estruturada | Finance Agent v2: 61.4% | Forte candidato para um piloto controlado |
| Compreensão de vídeos longos ou gráficos | LVBench: 87.8%; CharXiv-R: 86.2% | Forte candidato quando modelos apenas de texto não são adequados |
| Biologia e fluxos científicos | LABBench2: 86.2%; BioMysteryBench human-difficult: 56.5% | Teste com revisão de especialistas |
| Documentos longos e PDFs | Limite de entrada de 1,048,576 tokens; entrada de PDF compatível | Útil para recuperação e síntese; depois, valide a capacidade de recuperar informações |
O model card do Google ainda lista alucinações, timeouts e lentidão ocasional entre as limitações. (model card do Gemini 3.8 Flash)
Mantenha o Gemini 3.7 Flash para tráfego simples e focado em eficiência
Um pipeline de classificação, extração, etiquetagem ou geração de resumos curtos talvez não precise de raciocínio adicional. A Artificial Analysis mediu o Gemini 3.8 Flash a $0.24 por tarefa e 0.8 minutos no nível baixo de raciocínio, contra $0.58 e 2.5 minutos no nível alto. No Gemini 3.7 Flash, os números no nível alto de raciocínio foram $0.40 por tarefa e 2.2 minutos.
Use o 3.8 quando o raciocínio adicional evitar uma tarefa malsucedida; mantenha o 3.7 quando a saída extra apenas aumentar o custo.
Não trate o modelo como vencedor universal em agentes de programação
A BenchmarkList registra 89.4% no Terminal-Bench 2.1 e 73.7% no DeepSWE 1.1, mas apenas 19.1% no Terminal-Bench 4.0. A lista também registra 59.0% no OSWorld 2.0, uma avaliação de uso de computador em horizontes longos. (resultados de programação e agentes da BenchmarkList)
Para um agente de terminal ou desktop que precise lidar com estado oculto, verificar alterações e continuar depois de falhas em ferramentas, compare o Gemini 3.8 Flash com o modelo atual no mesmo fluxo de trabalho antes de fazer a troca.
A decisão de custo é por tarefa, não por milhão de tokens
Preços da API do Gemini 3.8 Flash até 2026
O anúncio oficial de lançamento do Google apresenta as seguintes tarifas diretas da API. O preço introdutório termina em December 31, 2026, e a tarifa padrão começa em January 1, 2027. (anúncio de lançamento do Google)
| Período | Preço de entrada | Preço de saída | Leitura prática |
|---|---|---|---|
| Até Dec. 31, 2026 | $0.75 / 1M tokens | $3.75 / 1M tokens | Tarifa introdutória |
| A partir de Jan. 1, 2027 | $1.50 / 1M tokens | $7.50 / 1M tokens | As duas tarifas dobram |
Na tarifa introdutória, a saída custa cinco vezes mais que a entrada. A documentação do Google também lista Batch API, Flex inference e Priority inference, mas a página do modelo citada não informa os preços numéricos dessas opções.
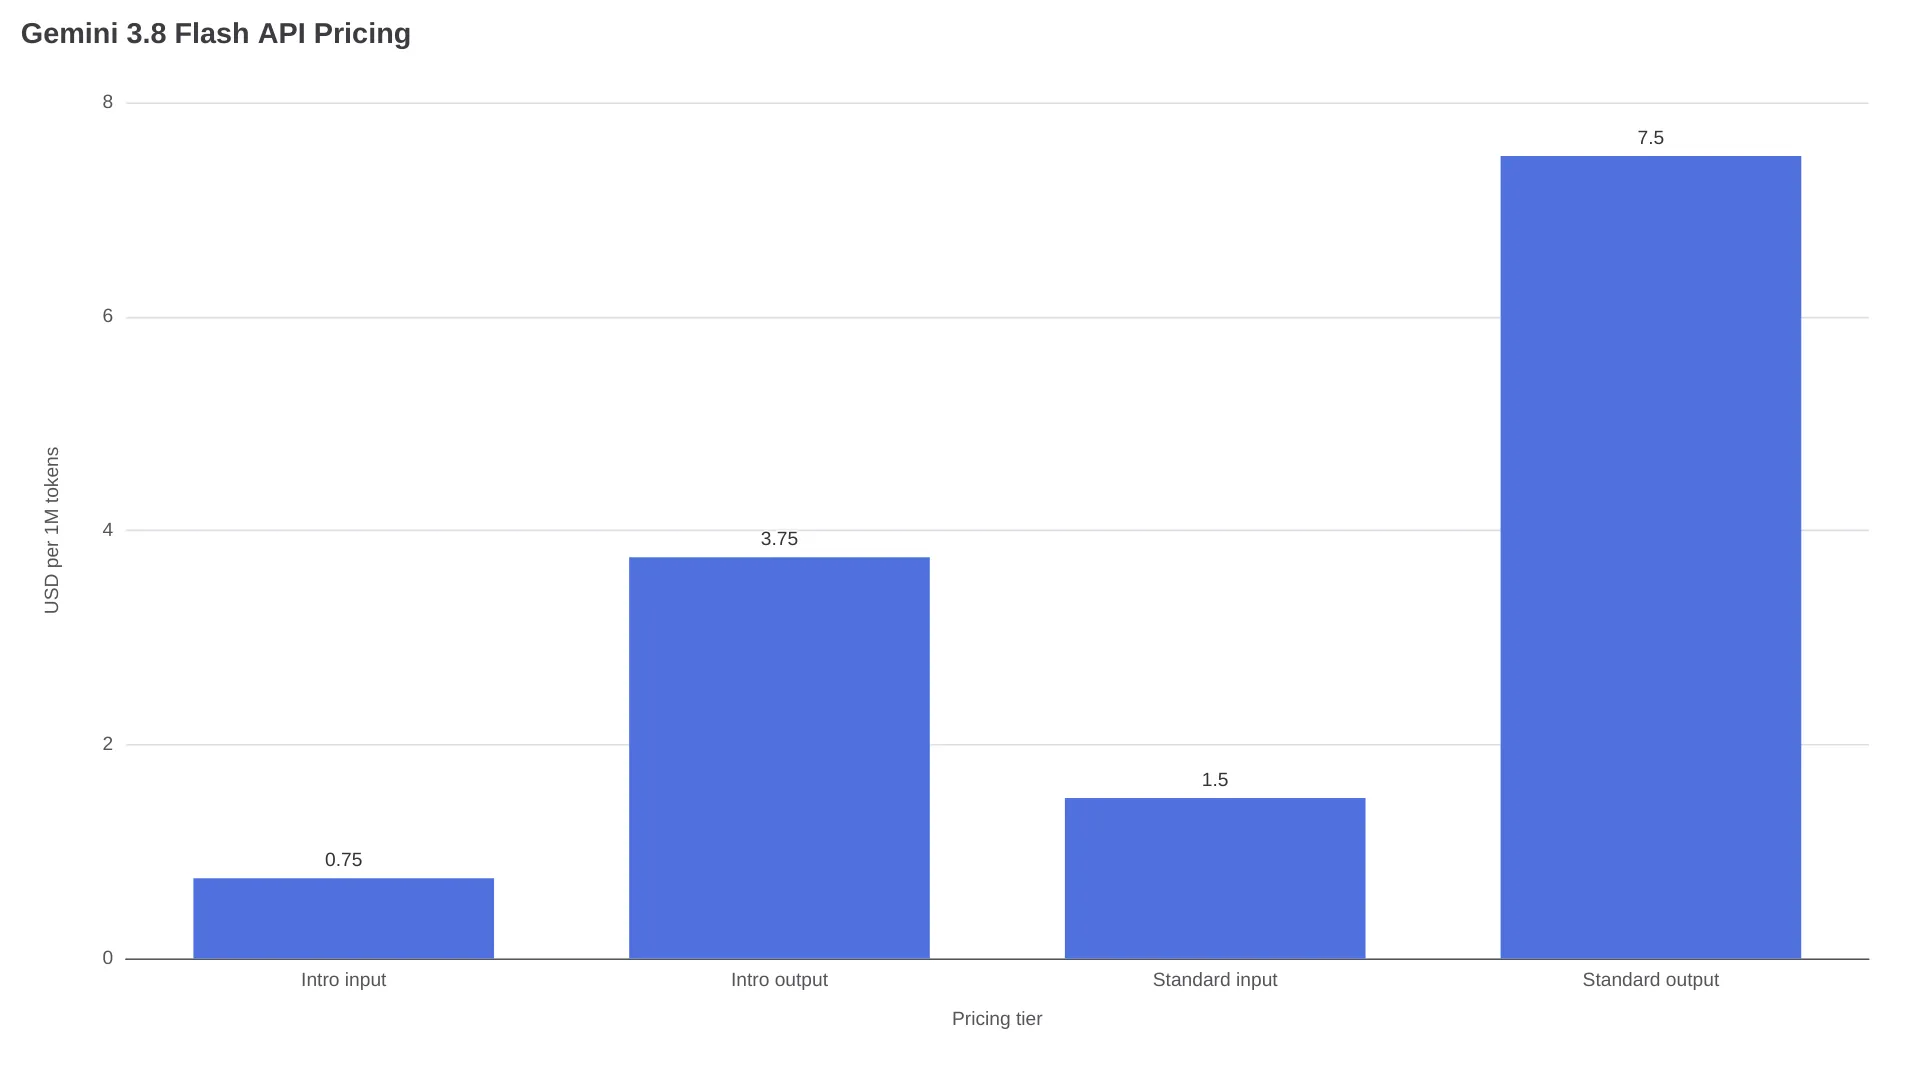
Uma tarefa que use 2 milhões de tokens de entrada e 500,000 tokens de saída custa $3.38 na tarifa introdutória: (2 × $0.75) + (0.5 × $3.75). A mesma combinação custa $6.75 a partir de January 1, 2027: (2 × $1.50) + (0.5 × $7.50).
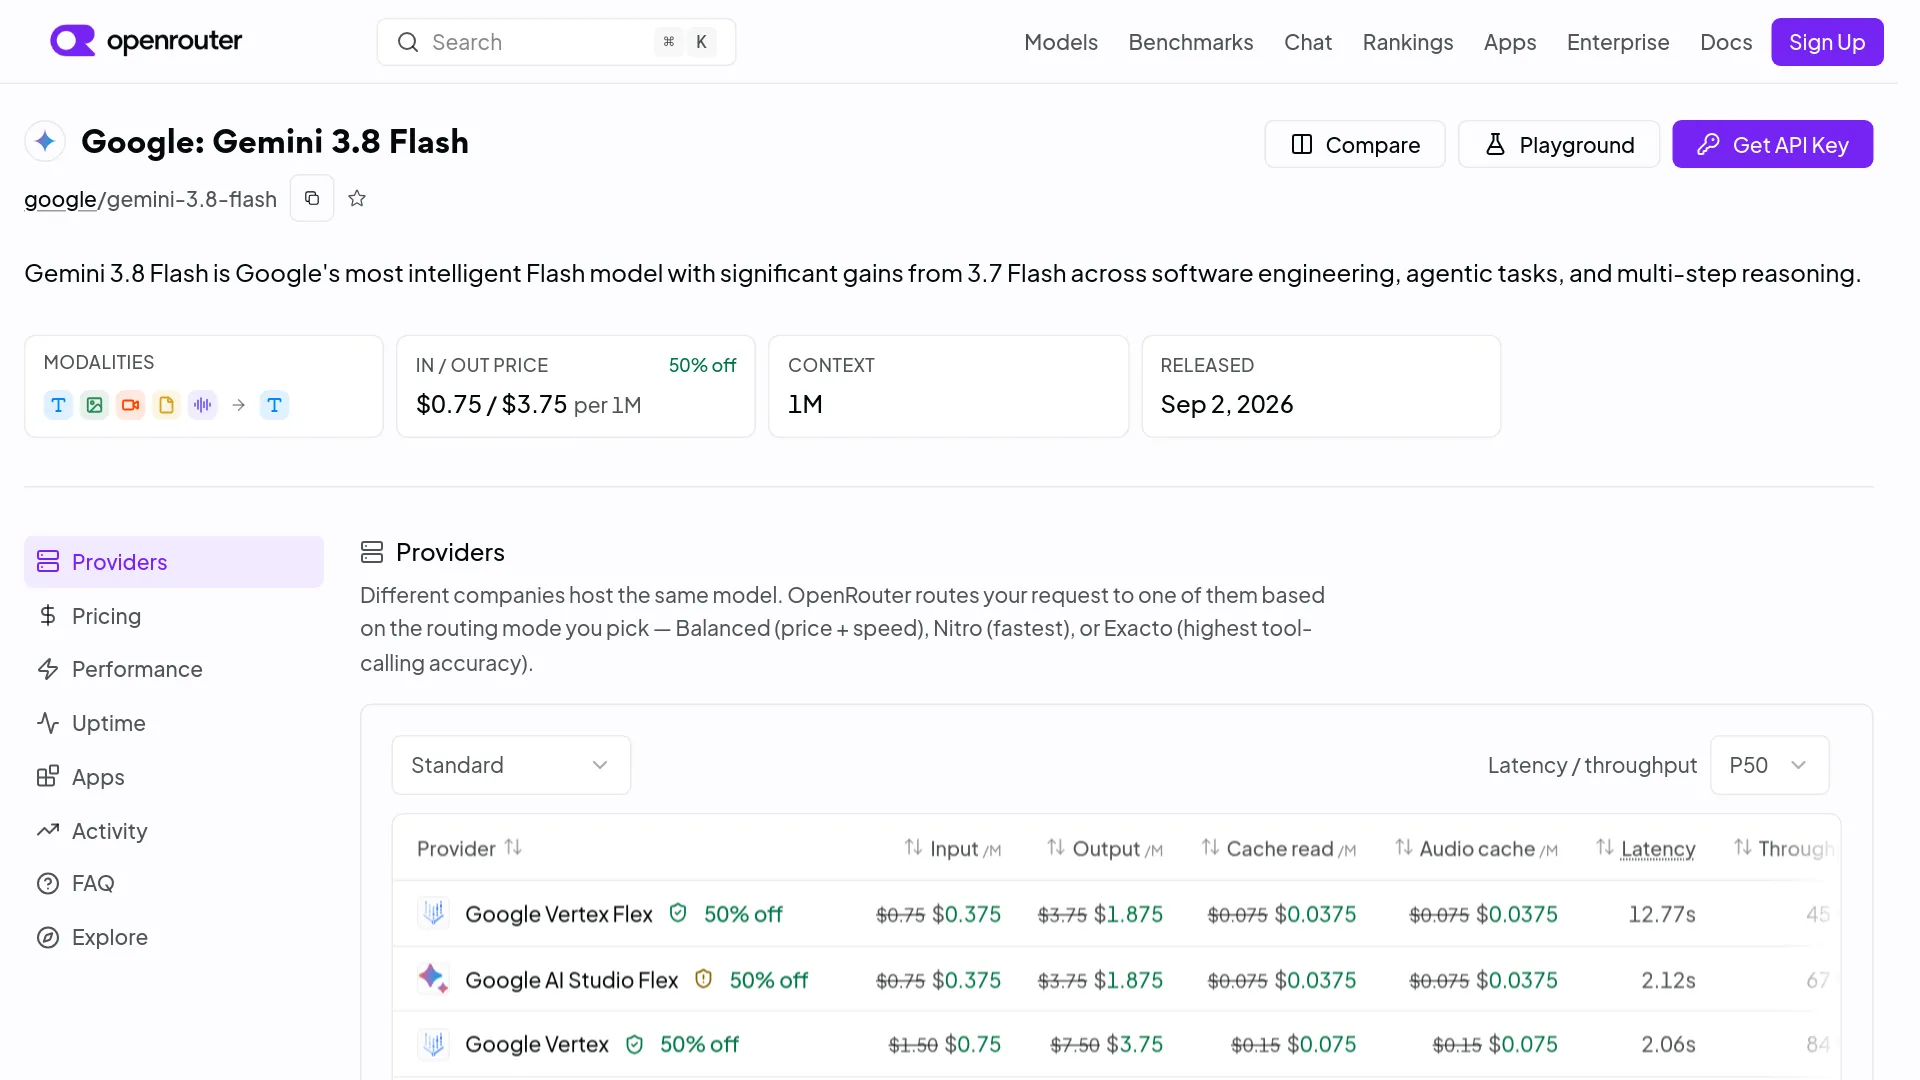
A página do Gemini 3.8 Flash na OpenRouter lista separadamente as rotas Google Vertex e Google AI Studio, preços de cache, latência, throughput e um desconto exibido na página. Confira o provedor e o caminho de cobrança antes de comparar o preço de um roteador com a tabela direta de tarifas do Google.
Por que um token mais barato pode gerar uma fatura maior
A Artificial Analysis apresenta as seguintes medições do Gemini 3.8 Flash em cada nível de raciocínio:
| Nível de raciocínio | Intelligence Index | Custo por tarefa | Tempo por tarefa |
|---|---|---|---|
| Baixo | 52 | $0.24 | 0.8 minutos |
| Médio | 57 | $0.41 | Não informado |
| Alto | 59 | $0.58 | 2.5 minutos |
A Artificial Analysis não informa o tempo no nível médio de raciocínio na análise citada. O mesmo estudo diz que o Gemini 3.8 Flash gerou 120 milhões de tokens de saída durante sua avaliação do Intelligence Index, contra uma mediana de 71 milhões de tokens nos modelos comparáveis. Essa é uma medição de toda a avaliação, não uma previsão para cada solicitação da API. Ainda assim, ela mostra por que o preço por token, sozinho, é um indicador fraco para orçamentos de produção. (perfil do modelo na Artificial Analysis)
Para uma comparação interna, calcule o total de tokens de entrada, entrada armazenada em cache, raciocínio e saída por tarefa concluída. Depois, divida o gasto da API pelo número de tarefas bem-sucedidas, e não pelo total de solicitações enviadas. Inclua chamadas de ferramentas, novas tentativas e correções humanas.
Limites e recursos da API
O que a API estável oferece
A página oficial do modelo informa um limite máximo de entrada de 1,048,576 tokens e um limite máximo de saída de 65,536 tokens. O Gemini 3.8 Flash aceita entradas de texto, imagens, vídeo, áudio e PDF, e retorna texto. O modelo é compatível com cache, execução de código, pesquisa em arquivos, chamadas de função, fundamentação no Google Maps, fundamentação em buscas, saídas estruturadas, contexto de URL e uso do computador em Preview. (documentação oficial do modelo)
Os níveis de raciocínio são low, medium e high; minimal não é compatível e retorna um erro. O modelo não oferece geração nativa de imagens ou áudio, e a documentação para desenvolvedores não lista suporte à Live API.
Onde usar o modelo — e por que o Cyber é diferente
O Google lista o Gemini 3.8 Flash na Gemini API, no Google AI Studio, no Android Studio, no Stitch, no Google Antigravity, no Gemini Enterprise, no aplicativo Gemini, no AI Mode da Google Search e no Gemini in Google Sheets. (anúncio de lançamento do Google)
O Gemini 3.8 Flash Cyber é uma variante separada, voltada à cibersegurança. O Google afirma que o acesso ao Fairwind é priorizado para defensores confiáveis, incluindo autoridades governamentais, operadores de infraestrutura crítica e responsáveis pela manutenção de software. O anúncio de lançamento relata mais de 70% de sucesso em um benchmark interno de descoberta de vulnerabilidades em 20 linguagens de programação e 47.2% pass@1 no patching do CWE-Bench; esses números se referem ao Cyber, não ao modelo geral. O anúncio do Google descreve o acesso por meio do Fairwind, portanto não presuma que a rota geral da API do Flash ofereça acesso ao Cyber. (anúncio do Google sobre o Cyber)
A disponibilidade inicial de um produto pode variar conforme a conta e a plataforma. Um usuário do Reddit relatou:
“O 3.8 Flash também apareceu para mim no aplicativo web do Gemini, então parece que foi oficialmente liberado. Estou na Austrália, com uma assinatura Pro, mas ele ainda não apareceu no AntiGravity nem no aplicativo para iOS.” — u/DMAC80, r/GeminiAI
Em uma aplicação, verifique o ID configurado do modelo da API, gemini-3.8-flash, e todos os metadados de resposta disponíveis para sua integração; a autodescrição de um modelo não confirma o endpoint utilizado.
O que as evidências ainda não comprovam
| Limitação documentada | Implicação prática |
|---|---|
| A Artificial Analysis registra 13.39 segundos até o primeiro token de resposta no nível alto de raciocínio, apesar de cerca de 304.6 tokens de saída por segundo depois disso. (perfil do modelo na Artificial Analysis) | Espere uma pausa inicial para o raciocínio, seguida de uma geração rápida. |
| O model card do DeepMind informa um corte de conhecimento em March 2026, com alguns domínios limitados a January 2025. (model card do Gemini 3.8 Flash) | Use fundamentação em buscas ou recuperação com fontes verificadas para informações atuais. |
| O uso do computador está disponível apenas em Preview, a documentação para desenvolvedores não lista uma opção de hospedagem própria e a saída é texto, não imagem, áudio ou vídeo. (documentação para desenvolvedores do Google) | Mantenha uma implantação ou um fallback de modelo separado para esses requisitos. |
Um plano de adoção gradual e de baixo risco para o tráfego de produção
- Selecione 30–50 tarefas reais que representem sua combinação de produção, incluindo casos de contexto longo e falhas conhecidas.
- Execute o Gemini 3.8 Flash nos níveis baixo, médio e alto de raciocínio em comparação com o modelo atual.
- Registre o total de tokens, acertos de cache, turnos de ferramentas, novas tentativas, tempo até o primeiro token, tempo de conclusão, correções humanas e taxa de tarefas aceitas.
- Calcule o custo por tarefa bem-sucedida e separe o tráfego interativo do tráfego em lote.
- Libere uma pequena parcela das solicitações de produção como canário antes de alterar a rota padrão.
- Mantenha o Gemini 3.7 Flash para tarefas simples se o raciocínio adicional não melhorar o custo por tarefa aceita.
- Faça o orçamento considerando a tarifa de January 1, 2027: $1.50 por milhão de tokens de entrada e $7.50 por milhão de tokens de saída.
O melhor primeiro teste tem um resultado verificável: uma alteração em vários arquivos acompanhada de testes, um fluxo de documentos com resposta conhecida ou uma tarefa de extração multimodal com rótulos revisados.
Perguntas frequentes sobre os preços da API do Gemini 3.8 Flash
Quanto custa o Gemini 3.8 Flash?
A tarifa introdutória direta da API do Google é de $0.75 por milhão de tokens de entrada e $3.75 por milhão de tokens de saída até December 31, 2026. A partir de January 1, 2027, as tarifas listadas passam a ser $1.50 e $7.50.
O Gemini 3.8 Flash é melhor que o Gemini 3.7 Flash?
Ele é mais forte em várias medições de raciocínio e desempenho de agentes divulgadas no lançamento, incluindo o resultado de 59 contra 56 no Intelligence Index da Artificial Analysis no nível alto de raciocínio. O Gemini 3.7 Flash ainda pode ser mais barato para operar em tráfego simples, porque o 3.8 pode usar mais tokens de saída.
O Gemini 3.8 Flash é bom para agentes de programação?
É um candidato plausível, com resultados divulgados de 89.4% no Terminal-Bench 2.1 e 73.7% no DeepSWE 1.1. O resultado de 19.1% no Terminal-Bench 4.0 indica que fluxos de trabalho longos em terminais e desktops precisam de uma avaliação própria.
O Gemini 3.8 Flash é gratuito?
A API é paga de acordo com as tarifas de tokens listadas. Consulte separadamente os termos atuais dos projetos no AI Studio e a tabela direta de tarifas da API.
O que é o Gemini 3.8 Flash Cyber e quem pode acessá-lo?
O Gemini 3.8 Flash Cyber é ajustado para descoberta de vulnerabilidades e aplicação automatizada de patches. O Google afirma que o acesso é priorizado por meio do Fairwind Program para defensores confiáveis; não se trata de um modelo público geral disponível com uma chave comum da API do Gemini 3.8 Flash.
Comece com raciocínio baixo ou médio em um conjunto fixo de tarefas, meça o custo por resultado aceito e aumente o nível de esforço apenas nos casos em que o trabalho adicional evite uma falha mensurável.