 AIREITER
A Anthropic agora coloca o Claude Opus 5.5 como modelo padrão para trabalho intelectual nos planos pagos. Na maior parte dos casos, a decisão se sustenta — mas há um porém que domina os relatos de usuários: as cotas de Pro, Max e Team somem mais depressa do que o esperado.
O Opus 5.5 chegou em 22 de setembro de 2026 como o primeiro modelo da família Claude 5.5. A Anthropic afirma que ele entrega, na maioria dos trabalhos, desempenho no nível do Claude Fable 5.1, com custo operacional 40% menor que o Opus 5 (anthropic.com). Em 12 de novembro de 2026, o guia da empresa sobre uso diário deixou a estratégia clara: comece pelo Opus 5.5 em esforço Medium para pesquisa, análise, redação, relatórios, planilhas e apresentações; só então aumente o nível (claude.com). Esta análise reúne essa orientação oficial, benchmarks independentes e relatos sobre cotas de usuários — não é um teste de laboratório próprio.
Veredito em 30 segundos: deixe como padrão, use Medium
Mantenha o Opus 5.5 selecionado e rode o trabalho intelectual do dia a dia no esforço Medium. Antes de trocar de modelo, aumente o esforço. Quando velocidade ou volume importarem mais que capacidade de julgamento, desça para Sonnet 5.5 ou Haiku 5.5.
Não é uma questão de fidelidade, mas de conta. Nas avaliações de programação e trabalho intelectual da Anthropic, o Opus 5.5 em Medium igualou ou superou o Opus 5 em High. A Factory, citada no guia de uso diário da Anthropic, informou que Medium equiparou o Opus 5 em High usando 20–25% menos tokens de saída. Medium também é o padrão nos apps Claude e no Claude Code, portanto a maioria dos assinantes recebe esse comportamento sem mudar nenhuma configuração.
A ressalva é que, para assinantes, o gargalo é a cota, não o preço de tabela da API. A API custa US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída, abaixo dos US$ 5/US$ 25 do Opus 5; leituras de cache custam US$ 0,20 por milhão. Porém, modelos mais caros consomem os limites de assinatura mais rapidamente, segundo o guia de uso diário da Anthropic. Na prática, usuários relatam janelas de 5 horas esgotadas em 15–30 minutos de sessões pesadas, além de limites semanais acabando bem antes do que na fase inicial de setembro.
O que a mudança de padrão em novembro significa para Pro, Max e Team
Para quem assina, o ponto central são as regras de cota com o novo padrão. No lançamento, a Anthropic disse que aumentaria os limites de uso em cinco horas nos planos Pro, Max, Team e Enterprise baseado em assentos, além de oferecer aos assinantes uma redefinição de limite de taxa que pode ser guardada (anthropic.com). Isso ocorreu apesar de relatos de usuários no fim de outubro sobre esgotamento mais rápido, detalhados adiante. O guia da Anthropic observa que os assentos Pro, Team padrão e Enterprise baseado em assentos normalmente não incluem o Fable 5.2 nos limites regulares, fora de ofertas de lançamento: o Fable usa créditos de consumo. Planeje o Opus como cavalo de batalha incluído e o Fable como exceção cobrada à parte.
Onde a promessa de modelo para o dia a dia se confirma: pesquisa, análise e escrita
Memorandos de pesquisa que passam por auditoria de cada número
O teste mais exigente foi um relatório de desempenho empresarial com fontes, em que o comunicado de resultados foi deliberadamente difícil de encontrar e qualquer número ou citação inventada invalidava todo o trabalho. O Opus 5.5 passou em 16 de 18 relatórios considerando diferentes níveis de esforço; segundo a Anthropic, nem o Fable 5.1 nem o Opus 5 atingiram o mesmo padrão em qualquer tentativa (claude.com). A verificação externa da Walleye Capital, também relatada no post de lançamento da Anthropic, complementa o cenário: o Opus 5.5 resolveu em grande parte a suíte no menor nível de esforço e, em esforço mais alto, identificou um erro de indexação de uma posição nas instruções do próprio avaliador — algo que, segundo a Walleye, nenhum modelo testado anteriormente havia detectado.
Na rotina, isso significa delegar pesquisas abertas com uma entrega bem definida e fontes anexadas; depois, audite os números, não a prosa.
Análise de planilhas, cálculos de fusão e gráficos densos
Em uma fusão fictícia entre duas empresas de software de RH, Opus 5 e Opus 5.5 criaram um modelo no Excel e uma apresentação executiva, chegando à mesma conclusão sobre o negócio. O Opus 5.5 terminou em 63 minutos, contra 93 minutos, teve custo de produção relatado 50% menor, entregou um modelo mais completo e cometeu menos erros menores (claude.com). Em fluxos financeiros de forma mais ampla, a Hebbia relatou cobertura de 86,6% dos critérios para o Opus 5.5, ante 60,3% do Opus 5. A Rogo informou que o modelo superou o Opus 5 em High no BigFinance Bench com cerca de 60% menos tokens de saída, segundo o post de lançamento da Anthropic.
A capacidade visual faz parte do mesmo pacote. A Anthropic classifica o Opus 5.5 como seu melhor modelo Opus para visão: documentos densos, valores em gráficos, capturas de tela e diagramas. Ela também relata que o Opus 5.5 no menor esforço leu gráficos densos com mais precisão que o Opus 5 no maior esforço (claude.com). A pontuação publicada no Chartography é de 64,4% sem ferramentas na configuração avaliada mais alta (claude.com) e de 89,0% com ferramentas no placar de lançamento. Já o Elo de trabalho profissional GDPval-AA é 1846, contra 1735 para o Fable 5.1 e 1708 para o Opus 5 (anthropic.com).
Na prática, peça diretamente a planilha ou apresentação finalizada, anexe a imagem do gráfico em vez de transcrever valores e deixe claro o critério de encerramento já na primeira mensagem.
Escrita: documentos e apresentações prontos, não apenas esboços
A alegação sobre escrita é mais específica que simplesmente dizer que o estilo é melhor: trata-se de seguir instruções e facilitar auditoria. A Anthropic afirma que o Opus 5.5 mantém o foco, abre com conclusões, usa menos jargão, respeita regras de estilo fornecidas e explica o que fez, o que encontrou e quais informações ainda precisa receber. Avaliações independentes seguem a mesma direção: o Hayz Labs dá nota 100 ao Opus 5.5 em escrita e 100 em programação, com 94 em pesquisa, colocando-o em primeiro para WebDev e agentes e em segundo em escrita criativa na Arena, na checagem de outubro.
O limite real é que reproduzir exatamente o estilo interno de uma empresa ainda exige iteração.
O seletor de esforço define o custo
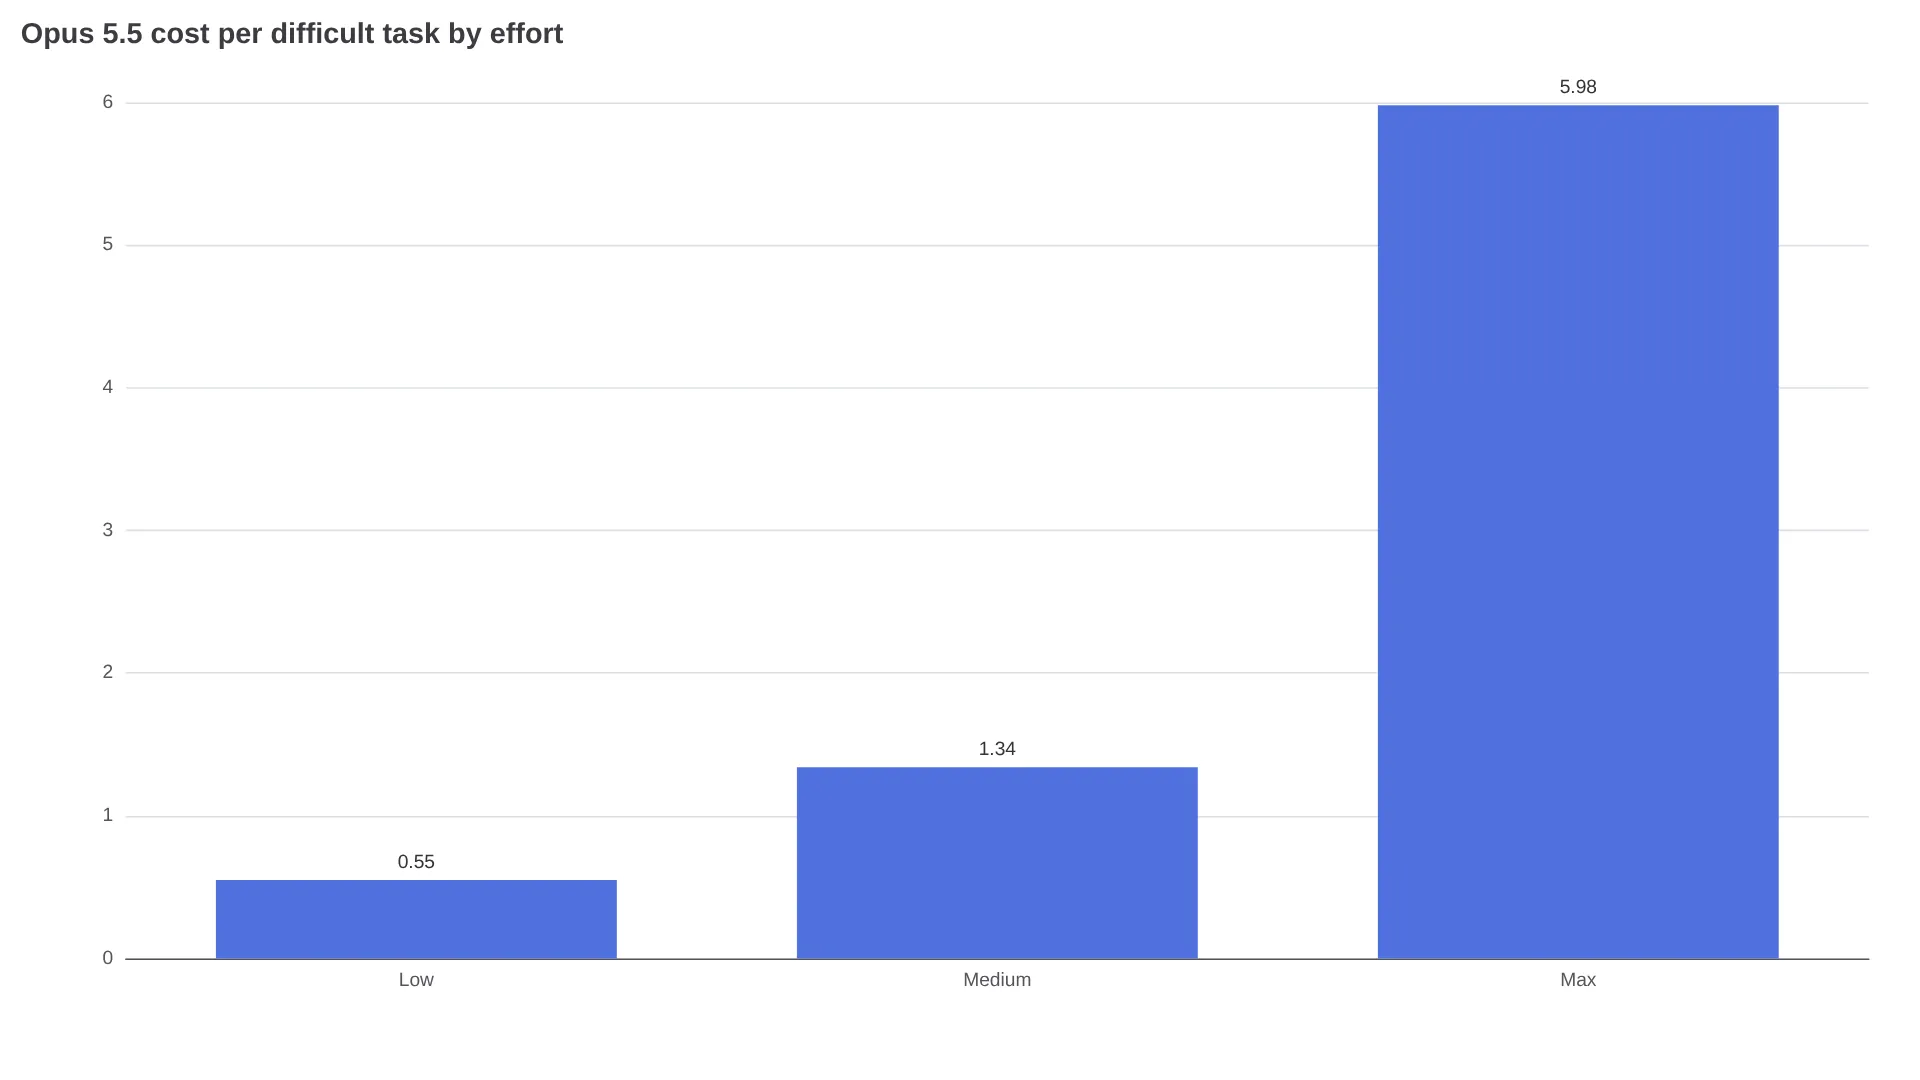
O Opus 5.5 tem cinco níveis de esforço — Low, Medium, High, Very High/Extra High e Max — segundo o detalhamento de esforço da eesel. E o raciocínio não pode ser desativado, de acordo com o Hayz Labs. Esse seletor pesa muito mais na conta do que pequenas variações no preço por token.
Os cálculos por tarefa relatados no resumo da eesel sobre os números da Artificial Analysis estimam a mesma tarefa difícil em aproximadamente US$ 0,55 no Low, US$ 1,34 no Medium e US$ 5,98 no Max, com pontuações no Intelligence Index de cerca de 42, 51 e 58, respectivamente. Uma execução em Max pode gerar na ordem de 119.000 tokens de saída; a US$ 20 por milhão de tokens de saída, é aí que o dinheiro vai. A visão de Pareto do Hayz Labs chega perto: cerca de US$ 1,61 de mediana por tarefa de agente ao longo de 14 dias (US$ 1,76 de mediana na tabela principal), com High em torno de US$ 1,82.
Mais esforço aumenta tempo e custo, sem necessariamente melhorar a resposta. A recomendação da própria Anthropic é remover expressões como "think hard": o raciocínio já está ativo, e a profundidade depende do nível de esforço e da tarefa. Suba o nível apenas quando o Medium realmente travar.
A janela de contexto é de 1 milhão de tokens, com até 128.000 tokens de saída (300.000 em Batch) e visão nativa, segundo a ficha técnica da eesel. Não há cobrança adicional por contexto longo, conforme a análise de preços da eesel, algo relevante para fluxos de auditoria de documentos extensos.
Como escolher entre Opus 5.5, Sonnet 5.5, Haiku 5.5 e Fable 5.2
O guia de novembro da Anthropic e as análises independentes de custo chegam à mesma regra: primeiro ajuste o esforço; só depois mude de modelo. Os preços abaixo seguem a tabela de preços do guia diário da Anthropic.
| Modelo | Preço da API por 1M (entrada/saída) | Use para | Troque quando |
|---|---|---|---|
| Haiku 5.5 | US$ 0,10 / US$ 0,50 até 100K tokens | Consultas rápidas, resumos, classificação e tarefas estreitas em alto volume | A análise ficar extensa ou exigir muito julgamento |
| Sonnet 5.5 | US$ 2 / US$ 10 | Tarefas claras e bem delimitadas, revisão de documentos, slides a partir de um briefing definido | Você chegar a Extra High ou Max com frequência |
| Opus 5.5 | US$ 4 / US$ 20 | A maior parte das pesquisas, análises, trabalhos financeiros e documentos finalizados | O Medium travar mesmo após uma tentativa real em High |
| Fable 5.2 | US$ 8 / US$ 40 | Trabalho técnico aberto, ciência, programação e finanças com equipes de subagentes de longa duração | O trabalho intelectual comum — em geral, é excessivo |
O ponto de virada a memorizar: levar o Sonnet 5.5 a Extra High ou Max pode fazer uma tarefa custar quase tanto quanto no Opus 5.5, mesmo ainda ficando atrás em julgamento. Usuários de planos de programação relatam a mesma dinâmica no lado da assinatura: em vez de manter o Sonnet acima de Medium, leve a tarefa para o Opus 5.5 em Low (veja, por exemplo, @cupid25157). Isso combina com a escala oficial de "esforço antes de modelo" e com a matemática de custo por tarefa.
O Fable é o teto, não o concorrente direto. A thread da Anthropic sobre o Fable 5.2 em novembro posiciona Fable e Mythos para os trabalhos técnicos abertos mais ambiciosos, enquanto o Opus 5.5 é o modelo principal mais forte para a maioria das tarefas de programação e trabalho intelectual (@claudeai). Em assinaturas, a diferença é ainda mais relevante: assentos Pro/Team padrão frequentemente cobram Fable em créditos, portanto usar Fable casualmente pode transformar o impulso de escolher o "melhor modelo" em uma conta de créditos.
Como fazer a cota render: por que a janela de 5 horas evapora
É aqui que os benchmarks oficiais não ajudam e os relatos de usuários se concentram. A reclamação mais concreta não é sobre capacidade, mas sobre consumo de cota.
"Os limites do Opus 5.5 estão sendo DESTRUÍDOS esta noite!! Várias pessoas relatam cotas de 5 horas acabando em APENAS 15-30 minutos em sessões normais. Os limites semanais estão drenando MUITO mais rápido" — @TekonBurns, relatando o consumo em sessões do Claude Code
Alguns usuários descrevem a mudança como o fim repentino da fase de lua de mel. @kgauravnm escreve que "a fase de lua de mel do Claude Opus 5.5 acabou oficialmente", citando comportamento preguiçoso e consumo semanal acelerado. Relatos de assentos Team, como o de @ps_ios_dev, dizem que o uso no esforço Medium está "correndo" mesmo após a redefinição semanal gratuita. Vale manter uma ressalva: uma análise de 67.000 mensagens de logs do Claude Code feita por @sonuv_dev encontrou chamadas de ferramentas, taxas de falha e taxas de reclamação praticamente estáveis — "basicamente zero evidência de um nerf". Isso sugere que ao menos parte da dor vem do uso padrão mais pesado e de raciocínio mais caro, não de uma redução secreta de capacidade. A escolha do modelo também importa no limite máximo: @mohitsharmadl relata um caso em que o Fable 5.2 em Medium resolveu bugs que o Opus 5.5 em High não conseguiu, portanto usar "Opus para tudo" desperdiça cota no teto errado.
Um plano para preservar a cota, alinhado tanto à orientação oficial quanto ao que usuários dizem funcionar:
- Deixe tudo no Opus 5.5 Medium por padrão; trate High como uma escalada diagnosticada, não como um traço de personalidade.
- Divida por subtarefa: Haiku para busca e classificação, Sonnet para rascunho e refinamento bem delimitados, Opus para julgamento, auditoria e aprovação final.
- Não mantenha o Sonnet acima de Medium por hábito: calcule o ponto de virada e transfira a tarefa para Opus em Low/Medium.
- Anexe arquivos e conecte repositórios em vez de colar repetidamente o mesmo contexto; reenviar contexto longo adiciona tokens a cada turno e aumenta o uso medido.
- Guarde a redefinição do limite de taxa para uma semana com prazo real, em vez de gastá-la em experimentos.
- Reserve o Fable para a categoria estreita em que ele vence — trabalho técnico aberto, de longo horizonte e com múltiplos agentes — e confirme antes se seu assento o cobra em créditos.
Perguntas frequentes sobre usar o Opus 5.5 no dia a dia
O Claude Opus 5.5 é bom o bastante para ser meu modelo principal?
Sim, para cargas de pesquisa, análise e escrita em que julgamento e auditabilidade importam. O Hayz Labs o coloca em primeiro para agentes e WebDev, com notas máximas em escrita, e as verificações empresariais citadas pela Anthropic apontam na mesma direção. Ainda assim, mantenha um modelo mais barato disponível para trabalhos de volume.
O Opus 5.5 é melhor que o Sonnet 5.5 para o trabalho diário?
Para tarefas ambíguas ou de alta consequência, sim. Em tarefas claras, bem definidas e de grande volume, o Sonnet em Low ou Medium é mais rápido — a Anthropic classifica o Sonnet como Fast e o Opus como Moderate (claude.com) — e custa aproximadamente metade por token. O erro é deixar o Sonnet em Extra High ou Max por padrão, pois isso elimina a economia.
Quando usar o Opus 5.5 em vez do Fable 5.2?
Use o Opus para a maior parte do trabalho intelectual e para tarefas padrão de programação. Suba para o Fable em projetos técnicos abertos, longos ou fortemente baseados em agentes, quando o Opus em High ainda travar — e verifique antes a cobrança do plano, pois assentos Pro/Team padrão frequentemente faturam o Fable em créditos.
O contexto de 1 milhão de tokens funciona bem para documentos longos?
Para trabalhos de auditoria com arquivos anexados, esta é a configuração Opus mais forte que a Anthropic já lançou, incluindo o resultado de 16 em 18 relatórios com fontes. Trabalhos muito longos ainda consomem rapidamente a cota da assinatura; por isso, mantenha a recuperação de informação no Haiku e o julgamento no Opus, em vez de rodar tudo no maior contexto.
O trade-off que merece atenção
O Opus 5.5 é o padrão certo para trabalho intelectual em esforço Medium. A questão em aberto é se o aperto de cotas relatado por usuários no fim de outubro será o novo normal; se for, uma parcela maior de cada semana continuará rodando no Sonnet do que a comunicação de lançamento sugeria.
Leitura relacionada: análise de preços do Claude Opus 5.5, análise do Claude Opus 5.5 High, Claude Opus 5.5 vs GPT-6.1 Sol.