 AIREITER
Para quem roda agentes de código o dia inteiro, a disputa entre Gemini 4 Hydrogen e Claude Sonnet 5.5 se resume a dois pontos: o Hydrogen custa cerca de 25% menos em uma divisão equilibrada de entrada e saída ($4.50 contra $6.00 por milhão), mas o Sonnet 5.5 ainda conclui mais tarefas de terminal e uso de computador sem precisar de tanta supervisão. Nem o preço nem a tabela de benchmarks mostram, sozinhos, quanto custa entregar uma tarefa completa.
Tanto o Gemini 4 Hydrogen quanto o Claude Sonnet 5.5 apostam em uma janela de contexto de 1M de tokens para programação rápida e fluxos agênticos. O Hydrogen ainda oferece quatro níveis ajustáveis de raciocínio.
O que muda ao trocar o Sonnet 5.5 pelo Hydrogen amanhã?
Uma equipe que executa 200 tarefas de agente por dia sente a troca em dois lugares: na fatura e na quantidade de intervenções necessárias. O Hydrogen reduz o preço por token e, na amostra independente de velocidade do LLM Leaderboard, gera cerca de 198 tokens por segundo, contra aproximadamente 144 do Sonnet 5.5. É o perfil de um executor de alto volume: rascunhos rápidos, leitura paralela de arquivos e correções ágeis.
O Sonnet 5.5 é o "finalizador cuidadoso". A tabela de lançamento do Google coloca o Sonnet 5.5 à frente nos três benchmarks mais focados em terminal e uso de computador (Terminal-Bench 4.1, OSWorld 2.1 e Terminal-Bench-Science), detalhados na tabela abaixo. São justamente os cenários em que um agente precisa se recuperar de um comando que falhou — ou acaba travando.
A discussão no Reddit durante a semana de lançamento mostra a mesma divisão no nível das tarefas:
"hydrogen is alright but honestly i don't feel it's better than sonnet 5.5." — u/FewKey5274 no r/GeminiAI
Essa discussão não traz um benchmark de programação controlado. Portanto, encare-a como um sinal de cautela: vitórias em tarefas isoladas não prevêem o desempenho de ponta a ponta em um harness. Teste os dois no mesmo fluxo antes de migrar.
A conta: $4.50 contra $6.00 no custo combinado é só o começo
As tarifas oficiais de API são simples. O Hydrogen custa $1.50 por milhão de tokens de entrada e $7.50 por milhão de tokens de saída, sem variação em toda a janela de contexto, segundo o anúncio do Google. O Sonnet 5.5 custa $2.00 por milhão de tokens de entrada e $10.00 por milhão de tokens de saída, de acordo com os preços da Anthropic e a comparação lado a lado da OpenRouter.
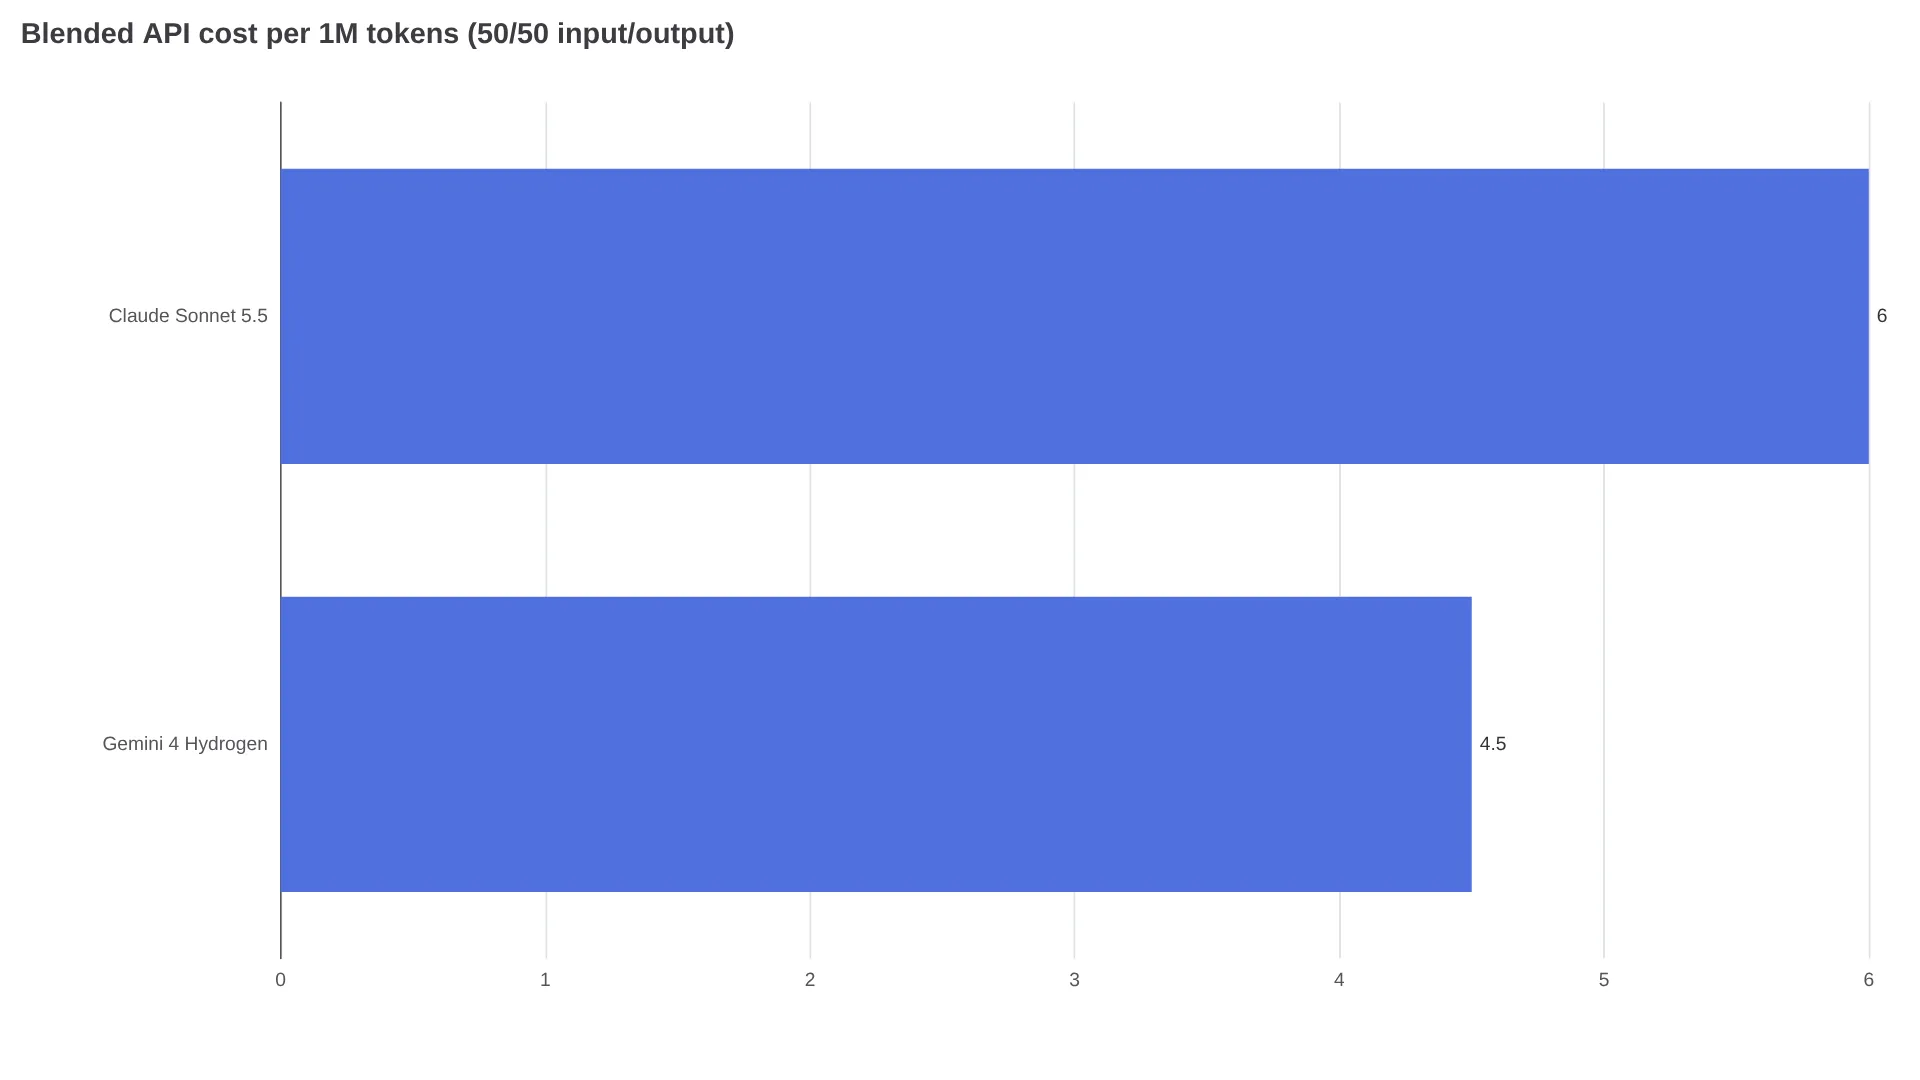
Na conta dividida em 50/50 — 500K tokens de entrada mais 500K de saída — o Hydrogen chega a $4.50 por milhão, contra $6.00 do Sonnet 5.5. A diferença de 25% é real, mas três fatores determinam se ela continuará no seu caso:
- Agentes que geram muita saída ampliam a diferença. Fluxos agênticos com longos rastros de raciocínio tendem a consumir mais tokens de saída, justamente onde o desconto de $2.50 por milhão do Hydrogen pesa mais.
- Cache e planos em lote ficaram de fora. As leituras de prompt em cache da Anthropic e os descontos da Batch API podem alterar a fatura real em vários pontos percentuais. O LLM Leaderboard também informa que o cache explícito não era compatível com sua amostra de velocidade do Hydrogen.
- Um exemplo prático deixa a conta clara. Considere um turno de agente com média de 10K tokens de entrada e 3K de saída, em 1.000 turnos por dia. Isso representa 10M tokens de entrada e 3M de saída: aproximadamente $37.50 por dia no Hydrogen contra $50.00 por dia no Sonnet 5.5, pelas tarifas de tabela. Em 22 dias úteis, a diferença chega a cerca de $275 por mês para cada agente concorrente — antes das tentativas repetidas.
As tentativas repetidas definem o vencedor de verdade. O custo por tarefa concluída equivale ao custo em tokens de cada tentativa dividido pela taxa de sucesso, somado ao tempo de correção humana. Apenas como ilustração, um dia de $37.50 no Hydrogen com taxa de sucesso na primeira tentativa de 80% custa cerca de $46.90 por 1.000 tarefas concluídas apenas em tokens, enquanto um dia de $50.00 no Sonnet com taxa de 95% sai por aproximadamente $52.60. A diferença diminui rapidamente quando as taxas de sucesso divergem. Por isso, acompanhe a taxa de merge na primeira tentativa por duas semanas, em vez de confiar cegamente na tabela de qualquer fornecedor.
Os benchmarks se dividem por tipo de trabalho — não há um vencedor absoluto
A tabela de lançamento do Google, também publicada no model card do DeepMind, compara Hydrogen, Sonnet 5.5 e GPT-6.1 Terra em dez avaliações. O Hydrogen lidera sete das dez disputas contra o Sonnet 5.5; o Sonnet 5.5 vence nas outras três. As linhas dos fornecedores usam o harness de cada lado; as linhas independentes vêm de novas execuções do LLM Leaderboard.
| Família de tarefa | Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| Programação em repositórios | SWE-sweep (fornecedor) | 13.5% | 3.1% |
| Programação em repositórios | Terminal-Bench 4.1, ajustado para trapaças (fornecedor) | 57.0% | 63.9% |
| Automação de conhecimento | Agents' Last Exam v1.1 (fornecedor, sensível ao harness) | 71.6% | 60.4% |
| Automação de conhecimento | AutomationBench-AA (fornecedor) | 76.1% | 71.8% |
| Automação de conhecimento | Vending-Bench 2, saldo final (fornecedor) | $14,549 | $11,165 |
| Uso de computador | OSWorld 2.1, subconjunto offline (fornecedor) | 77.6% | 83.9% |
| Multimodal | MKA Climb WSR (fornecedor; independente 49.52%) | 53.4% | 52.0% |
| Multimodal | Chartography (origens mistas) | 66.6% | 61.6% |
| Ciência | Terminal-Bench-Science 0.1 (fornecedor; independente 49.52%) | 51.4% | 59.9% |
| Raciocínio | HLE-Diamond (independente xhigh) | 58.8% | 53.3% |
É nas chamadas de ferramentas que os agentes vencem ou travam
Benchmarks avaliam respostas. Agentes dependem das chamadas de ferramentas: agrupar leituras, chamar a função certa e se recuperar quando uma busca não retorna nada ou um comando falha.
O Google afirma que o Hydrogen agrupa leituras de arquivos e buscas em paralelo, em vez de inspecionar os arquivos sequencialmente, e faz alterações pontuais no repositório sem reescrever arquivos que não têm relação com a tarefa. Relatos de parceiros no post de lançamento citam desempenho de 2x a 2.8x maior em tarefas com grafos e SQL, usando de 12% a 23% menos tokens que o Gemini 3.8 Flash, além de conclusão 2.5x mais rápida no nível padrão de raciocínio alto. São números selecionados pelo fornecedor e por parceiros: indicam uma direção, não uma garantia.
O contraponto é a maturidade do harness, visível na discussão sobre Claude Code e Antigravity, em que usuários relatam problemas de disponibilidade do Antigravity e recursos de fluxo ausentes, como SSH, hooks reutilizáveis, skills e subagentes. Isso representa a percepção de usuários durante a semana de lançamento, não uma medição controlada, e diz respeito ao harness, não aos pesos do modelo.
Antes de mover um agente de produção, verifique três pontos: a confiabilidade das chamadas paralelas de ferramentas com a quantidade de servidores MCP que você usa, a taxa de recuperação depois de uma etapa de bash ou navegador malsucedida e o comportamento nos limites de permissão. As verificações internas do Google afirmam até 81% menos extrapolação de escopo agêntica, 79% menos subatendimento e 96.7% de honestidade na avaliação de honestidade do agente. Confirme esses números com um canário próprio de 50 tarefas, incluindo ações bloqueadas e buscas sem saída.
Níveis de raciocínio: high é o padrão; xhigh deve ser usado com critério
O Hydrogen oferece os níveis low, medium, high e xhigh, com high definido como padrão. Segundo a tabela de níveis de raciocínio do Google, o Artificial Analysis Intelligence Index v5.0.1 passa de 27 / 41 / 51 / 54 do nível low ao xhigh, com o high padrão (51) superando por pouco o Argon (50). No Terminal-Bench 4.0, a mesma tabela mostra o high com 54.0%, acima dos 53.5% do xhigh. Já no AutomationBench-AA (60.5% para 76.1%) e no HLE-Diamond (32.2% para 58.8%), a pontuação sobe de forma consistente.
A regra para fluxos de agentes é simples: comece em high e eleve tarefas individuais para xhigh apenas quando o gargalo for o raciocínio — análise, síntese ou pesquisa em vários documentos. Depois, confira a diferença no consumo de tokens. Segundo o model card do DeepMind, o Hydrogen pode consumir mais tokens nos níveis altos de raciocínio. Além disso, seu corte de conhecimento é de março de 2026, então trabalhos sensíveis à atualidade precisarão de recuperação de informações de qualquer maneira.
A pergunta sobre o harness vem antes da migração
Segundo o model card do DeepMind, o Hydrogen oferece contexto de 1,048,576 tokens e até 64K de saída síncrona (até 1M por meio de decodificação longa em segundo plano). Já a documentação da Anthropic informa que o Sonnet 5.5 oferece 1M de entrada e até 128K de saída. As janelas anunciadas parecem equivalentes, mas é a compactação que decide o resultado em bases de código grandes: a pergunta não é o que diz a ficha técnica, e sim quanto permanece depois de 50 turnos.
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| Limite de contexto / saída | 1,048,576 tokens de entrada; 64K de saída síncrona (decodificação em segundo plano de 1M) | 1,000,000 de tokens de entrada; 128K de saída |
| Onde roda | Gemini API, AI Studio, Antigravity, aplicativo Gemini, segundo o Google | Claude API, Bedrock, Vertex AI, Microsoft Foundry, segundo a Anthropic |
A discussão sobre Antigravity e Claude Code coloca a estabilidade do harness como um risco de migração maior que a qualidade do modelo: usuários questionam a preservação após a compactação, a persistência das cotas e a disponibilidade. Rode o mesmo repositório, no mesmo commit, com o mesmo prompt e os mesmos testes de aceitação nos dois harnesses. Depois, compare as tarefas concluídas por janela de assinatura e a taxa de merge na primeira tentativa.
Escolha em 60 segundos: três perfis de agente
Nenhum vencedor atende a todos os agentes. Como avaliação editorial baseada na divisão dos benchmarks acima — não como resultado de um teste próprio —, direcione execuções paralelas e repetitivas para o Hydrogen e trabalhos longos, sensíveis à recuperação, para o Sonnet 5.5. Manter planejador e executor no mesmo fornecedor ajuda a preservar consistência de autenticação e compactação. Misturar um planejador Claude com um executor Hydrogen vale ser testado apenas depois de medir a linha de base com um único fornecedor.
| Seu agente | Escolha | Motivo (nível de evidência) |
|---|---|---|
| Executor de alto volume: correções em massa, boilerplate, tratamento de dados, triagem multimodal | Hydrogen em high | Liderança em benchmarks do fornecedor no AutomationBench, Agents' Last Exam e Vending-Bench; amostra independente de velocidade de ~198 contra ~144 tok/s |
| Finalizador de longo horizonte: depuração focada em terminal, automação de sistema/navegador, ferramentas científicas | Sonnet 5.5 | Liderança em benchmarks do fornecedor no Terminal-Bench 4.1, OSWorld 2.1 e Terminal-Bench-Science; avaliação do ecossistema sobre hooks e subagentes do Claude Code |
| Sintetizador de pesquisa: documentos longos, gráficos, áudio/vídeo, análises intensivas em Sheets | Hydrogen em high; xhigh nas etapas mais difíceis | Liderança do fornecedor no HLE-Diamond, Chartography e MKA; com a ressalva de que a nova execução independente do MKA ficou em 49.52% |
O Hydrogen é realmente mais rápido que o Sonnet 5.5?
O Hydrogen leva vantagem em throughput na amostra do LLM Leaderboard (cerca de 198 contra 144 tokens por segundo), mas o feed p50 em tempo real da OpenRouter mostra o Sonnet 5.5 à frente em latência (2.08s contra 6.92s de mediana), porque provedor, região e carga são diferentes. Faça a medição no seu próprio provedor.
O Hydrogen pode substituir o Sonnet 5.5 dentro do Claude Code?
Não basta trocar o ID do modelo. O Sonnet 5.5 roda nativamente no Claude Code, em que as equipes dependem de hooks, skills e subagentes. O Hydrogen roda pela Gemini API, AI Studio, Antigravity e pelo aplicativo Gemini. Substituí-lo significa migrar o harness.