 AIREITER
한 번의 문제를 풀고 작업물을 버리는 연구 에이전트와 달리, Tencent의 Hyra 2.0은 다음 연구에도 쓸 수 있는 과학 모델과 도구를 만드는 데 초점을 맞춘다. 다만 핵심 에이전트 시스템 자체는 Tencent 내부에 남아 있으며, 일부 결과물만 외부에 공개됐다.
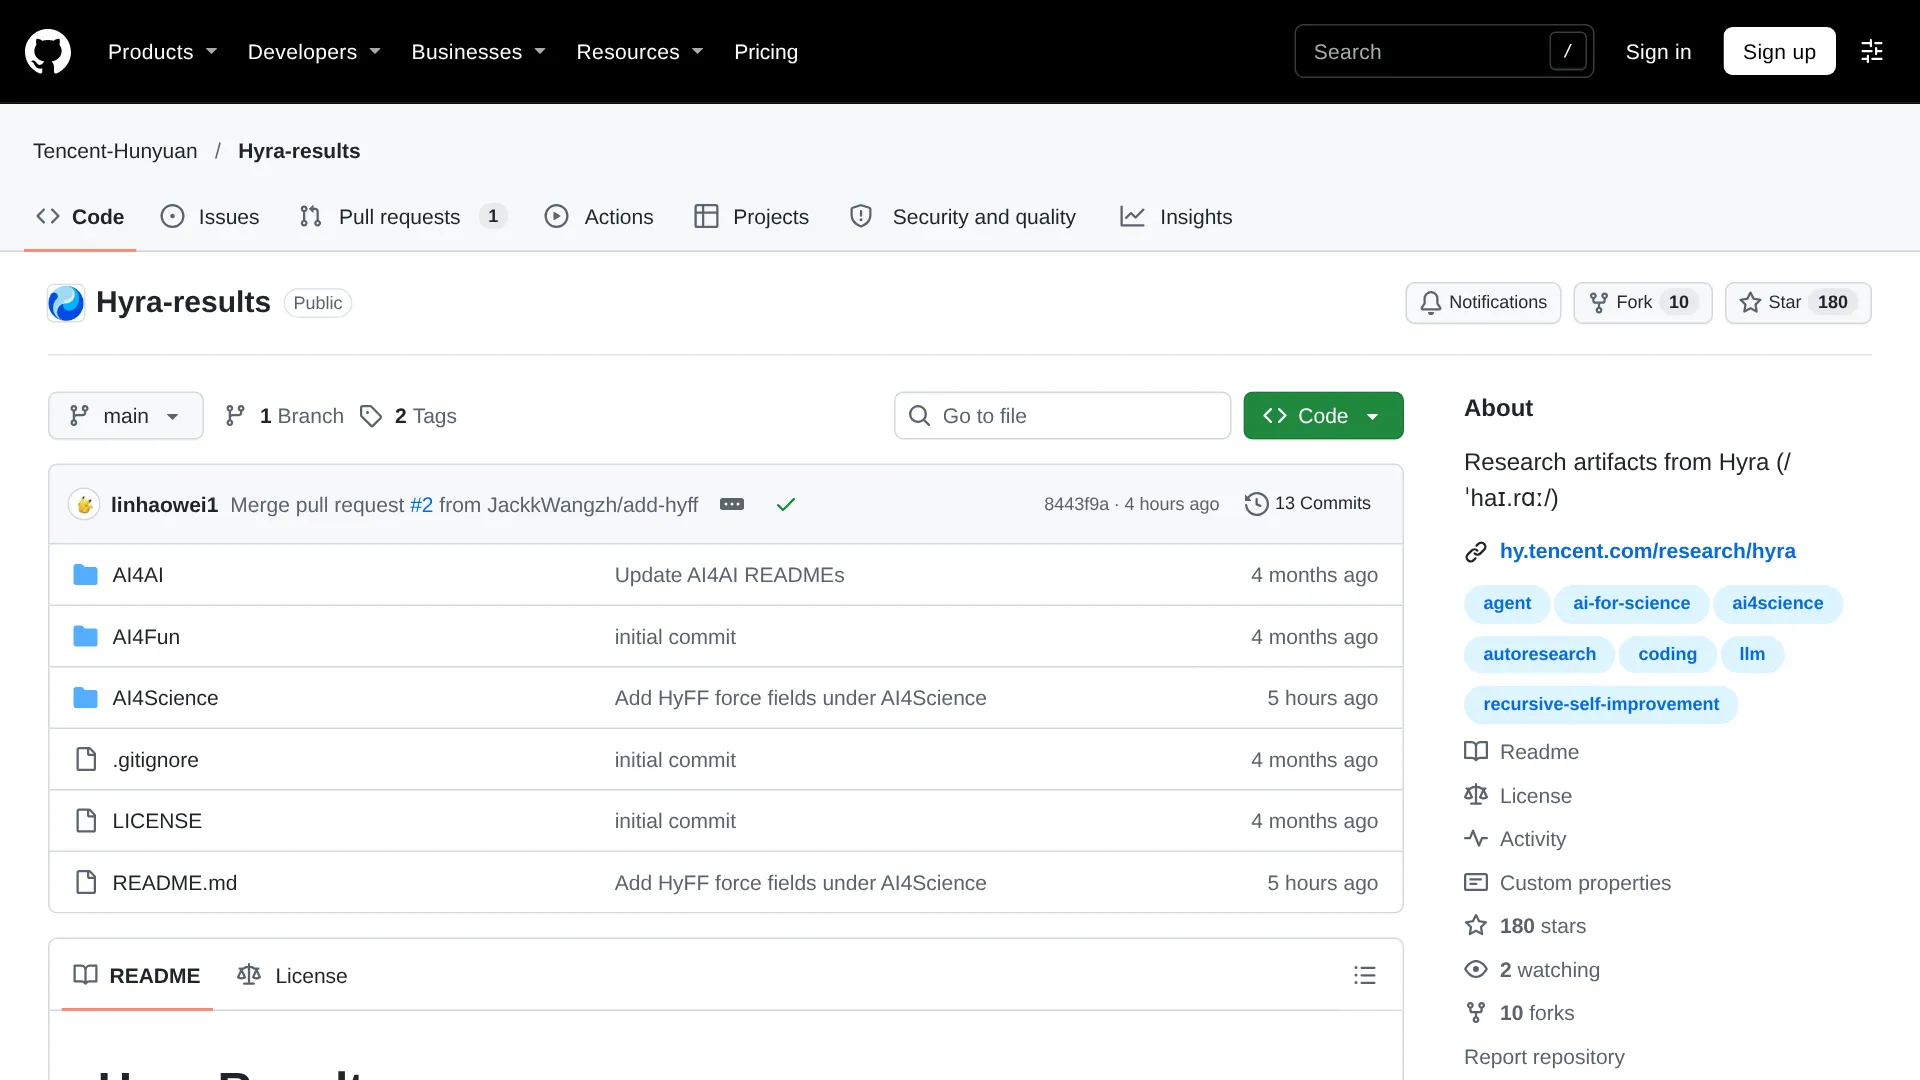
Hyra-results 리포지터리는 실제로 내려받아 확인할 수 있는 결과물과 발표로만 알려진 성과를 구분해 둔다. 이 차이를 염두에 두고 Hyra 2.0을 살펴볼 필요가 있다.
Hyra 2.0은 무엇이고, 무엇이 아닌가
Hyra 2.0은 Hunyuan Research Agent 2.0의 약자로, 과학 연구와 엔지니어링을 자동화하기 위해 Tencent Hunyuan이 만든 계층형 시스템이다. Tencent는 이를 범용 Hunyuan 채팅 모델의 연장선이 아니라, 재사용 가능한 과학 모델·검증 파이프라인·다단계 워크플로를 만들어내는 인프라로 소개한다.
Tencent의 공식 X 발표는 2026년 11월 2일 Hyra 2.0을 "Hunyuan Research Agent의 다음 진화"로 설명하며, "문제 해결에서 재사용 가능한 도구, 모델, 워크플로 구축으로" 나아간다고 밝혔다. 공개된 Hyra-results 리포지터리에는 전체 오케스트레이션 시스템이 아닌 결과물과 일부 학습 모델이 담겨 있다. 발표와 리포지터리 어디에도 공개 데모, 설치 패키지, API, 가격, 할당량은 제시되지 않았다. Hyra 2.0을 연구실 자체라고 보면, 공개된 HyInv와 HyPLM-Flash 단백질 모델은 그 연구실에서 나온 표본에 가깝다.
수주짜리 연구를 이어 가는 Hyra 2.0의 구조
Hyra 2.0은 장기 연구를 세 단계의 에이전트, 영속 저장소, 독립 검토 단계로 나눠 관리한다. Tencent Hunyuan 공식 WeChat 계정을 인용한 IT之家의 출시 보도에 따르면 Overall, Mission, Worker로 나뉜 구조는 실험이 수일 또는 수주간 이어져도 맥락을 잃지 않도록 설계됐다.
Overall 에이전트는 인간 연구자와 목표를 조율하고 컴퓨팅 예산을 배분한다. Mission 에이전트는 각자 하나의 연구 방향을 맡아 실험 경로를 선택하고 결론에 책임진다. Worker 에이전트는 코드를 읽고 실제 실험을 실행하며 실패를 분석한다. Mission 에이전트의 판단에 이의를 제기할 수도 있고, 서로 다른 기반 모델 위에서 여러 Worker가 병렬로 동작할 수 있다.
이 구조를 뒷받침하는 영속성 장치는 세 가지다.
- 프로젝트 상태는 연구 프로그램이 현재 어느 단계에 있는지 기록한다. 작업이 중단돼도 영속 큐에서 이어갈 수 있다.
- 계층형 에이전트 메모리는 단기 관찰과 장기 발견을 분리한다. 모든 정보를 단일 컨텍스트 윈도에 밀어 넣지 않는 방식이다.
- 공유 Books에는 증거 수준에 따라 지식이 저장된다. 단일 실행의 관찰, 재현된 발견, 사람이 확인한 관례를 구분하며, 다른 작업에도 통할 것으로 입증된 방법은 작은 재사용형 skills로 추출된다.
여기에 두 가지 안전장치가 더해진다. 모든 결론에는 구체적인 로그와 코드 버전이 연결되고, 별도 검토 Worker가 인간에게 전달되기 전에 새로운 출발점에서 주장을 다시 점검한다. Eyerys의 기술 분석에 따르면 대규모 컴퓨팅 작업은 여전히 사람의 승인이 필요하며, 시스템은 기업 메신저, 작업 제출 플랫폼, 코드 리포지터리 같은 일반적인 연구 인프라와 연결된다.
이 검증 방식에는 비용이 따른다. 한 실무자는 Worker들이 서로의 세션을 검토하면 토큰 비용이 크게 늘어날 수 있다고 추정했다(@d6355v). Tencent는 토큰 예산, 컴퓨팅 비용, 실패율, 독립 검토가 오류를 잡아내는 빈도를 공개하지 않았다. 따라서 이 아키텍처는 장기 연구의 신뢰성을 겨냥한 설계로 볼 수 있지만, 실제 운영 비용은 아직 알 수 없다.
현재 공개된 Hyra 2.0 결과물
Hyra 2.0의 공개 근거는 두 부류로 나뉜다. 가중치와 코드까지 내려받을 수 있는 결과물, 그리고 외부 재현을 기다리는 Tencent 발표 성과다. 아래 표는 각 항목의 확인 가능한 출처를 연결했다.
| 결과물 | 무엇인가 | 주요 수치 | 근거 상태 |
|---|---|---|---|
| HyInv | 196만 파라미터 단백질 역접힘 모델, 7.8 MB 가중치, CLI + Python API | TSN의 리뷰 기준 ProteinMPNN보다 생성 속도 약 57배, 148개 잔기 단백질에서 25 ms 대 약 1초(1x H20 GPU) | 결과물 확인 가능(MIT), 벤치마크 실행 가능, 주요 결과는 아직 독립 재현되지 않음 |
| HyPLM-Flash | 6억 5,000만 파라미터 마스크드 단백질 언어 모델, 2.6 GB 가중치, INT8 엔진 | TSN의 리뷰 기준 1x H20에서 초당 약 130,000개 잔기, Tencent의 12개 모델·35개 작업 테스트에서 가장 빠른 추론과 평균 3위, ProteinGym Spearman 0.409으로 ESM-2 650M급과 동률 | 결과물 확인 가능(MIT), CUDA GPU 필요, 두 평가는 모델 및 작업 수가 서로 다름 |
| HyFF | 5개 ML 포스 필드(Presto, Vivace, Moderato, Andante, Largo), 230만~12억 파라미터, 83개 원소 | Largo 에너지 오차 0.364 meV/atom, DPA4-Pro의 0.380 대비 9.7배 속도; Andante는 1x H20의 2,586원자 MD에서 UMA-S-1.2보다 29배 빠름 | hyff 패키지와 함께 결과물 확인 가능(Apache-2.0), 속도는 하나의 H20 워크로드에 한정됨 |
| Petty conjecture dim-5 | 리포지터리 인덱스 기준 증명 결과물. 모든 5차원 실수 노름 공간에 등거리 점 6개가 존재함을 보임(기존 최고 차원은 Makeev 2005의 4차원) | 5차원 문제 해결 | 논문 확인 가능, 학술지 동료 심사 보고 없음 |
| Yau circle-action | 리포지터리 인덱스 기준 주장된 반례. 양의 단면 곡률을 가지면서 유효한 원 작용이 없는 닫힌 7-다양체 | 제한 없는 경우 해결, 단일연결 경우는 여전히 미해결 | 논문 확인 가능, 학술지 동료 심사 보고 없음 |
| HyQEC | Prompt Blueprints 기준 qLDPC Challenge 계보에서 나온 양자 오류 정정 코드 | 기존 선도 결과보다 인코딩 효율 약 48% 향상 | 발표됨, 전체 결과물은 GitHub 공개 대기 중 |
| XiangShan RISC-V | Prompt Blueprints 기준 오픈소스 프로세서 최적화 | GHz당 점수 +5.79%, 면적 증가는 최소화, 멀티코어 버그 수정 | 발표됨, 벤치마크 이름과 기준선은 공개되지 않음 |
| 로봇 손 | Eyerys 기준 손가락 길이에 차이를 둔 다섯 손가락 로봇 손 | 고정 예산 시뮬레이션에서 물체 회전 속도 +28.6% | 발표됨, 현재까지는 시뮬레이션만 수행 |
Hyra 1.0과 비교하면 핵심 변화는 답변에서 자산으로의 이동이다. Hyra 1.0은 반복 루프가 작동할 수 있음을 보였다. sums_diffs 항목은 조합론 상수를 1.14489에서 1.21079로 개선했고, Tencent는 이를 50년 된 가법 조합론 문제의 진전으로 평가한다. Prompt Blueprints의 출시 분석에 따르면 Hyra 2.0은 이 반복 엔진을 유지하되, 성공 사례를 재사용할 수 있도록 계층 구조, 영속 프로젝트, skill 추출을 추가했다.
지금 실행할 수 있는 것과 Tencent 내부에 남는 것
Hyra 2.0이 만든 제품은 실행해 볼 수 있지만, 오케스트레이터 자체를 공개 설치할 방법은 없다. Hyra-results 리포지터리는 Apache-2.0 라이선스로 제공되며, 각 결과 폴더에는 최종 결과물과 재현 스크립트가 포함되는 것을 목표로 한다. 시작은 다음과 같다.
git clone https://github.com/Tencent-Hunyuan/Hyra-results.git
ls AI4Science/hyinv
이후에는 다음 중 하나를 선택하면 된다.
- HyInv(가장 간단한 경로): 가중치, 추론 코드, 기술 보고서는
AI4Science/hyinv에서 확인할 수 있다. 레퍼런스 경로는 CPU와 GPU에서 동작하며, 가속된 BF16 경로는 Hopper급 GPU에서만 검증됐다. - HyPLM-Flash(CUDA 필요):
AI4Science/hyplm_flash를 열고weights/download.sh를 실행하면 2.6 GB 가중치를 내려받고 병합·검증할 수 있다. H20/H100급 GPU를 준비하는 편이 좋다. 표현 추출에는 INT8, 세밀한 변이 회귀에는 BF16을 사용한다. - HyFF(주장된 속도에는 H20 필요): HyFF 섹션에서 5개 포스 필드 모델(각 9 MB~4.8 GB)과 단일 구조, 배치 처리, NVE/NVT/NPT 분자 동역학을 지원하는
hyff패키지를 사용할 수 있다.
비공개로 남는 부분은 Overall/Mission/Worker 오케스트레이터, 프롬프트, 스케줄러, 평가기, Books/skills 저장소다. 대규모 컴퓨팅 작업에는 인간 승인 절차가 있으므로, 리소스 배분까지 완전 자율화된 시스템은 아니다. 요약하면 에이전트 자체는 설치할 수 없고, 가장 쉽게 시험할 수 있는 결과물은 7.8 MB짜리 다운로드다. TSN은 동일한 백본에서 HyInv와 ProteinMPNN을 직접 비교하는 환경을 저렴하게 구성할 수 있다고 언급한다.
주요 성능 수치는 얼마나 믿을 만한가
TSN의 보도에 따르면 모든 성능 수치는 Tencent 또는 모델 문서에서 나온 것이며, 2026년 11월 2일 기준으로 독립 재현 결과는 공개되지 않았다. 따라서 각 수치는 적용 조건과 함께 읽어야 한다.
먼저 속도와 품질은 다르다. HyInv의 57배는 Nvidia H20 한 장에서 측정한 생성 처리량 비교다. 148개 잔기에서는 약 25 ms 대 약 1초, 402개 잔기에서는 54 ms 대 2.6초다. 이는 습식 실험 성공률을 뜻하지 않는다. 구조적 유사성도 예측 구조를 기준으로 평가했으며, 습식 실험 검증은 보고되지 않았다.
ProteinMPNN 대비 57배와 초당 약 2,500개 설계는 처리량이지 설계 품질이 아닙니다. 다음으로 보고 싶은 것은 self-consistency RMSD와 서열 회수율입니다... 역접힘은 애초에 병목인 경우가 드뭅니다. 그 뒤의 재접힘 단계가 문제죠.
둘째, 효율 주장은 하드웨어와 범위를 함께 봐야 한다. HyPLM-Flash의 "12개 중 가장 빠름"은 Tencent 블로그의 12개 모델·35개 작업 평가를 가리킨다. 리포지터리의 조건을 맞춘 평가는 28개 체크포인트와 32개 작업을 다루며, ProteinGym 제로샷 Spearman 0.409는 ESM-2 650M, ESM C 600M, E1-600M과 통계적으로 동률이다. HyFF의 29배와 9.7배 속도 역시 H20 한 장에서 2,586원자 시스템을 돌린 조건에 묶여 있다. Andante의 힘 오차는 7.65 meV/Å로 UMA-S-1.2의 7.55 meV/Å보다 조금 높다. 정확도는 거의 비슷한 수준에서 속도를 높였다는 의미이지, 전 항목에서 압도했다는 뜻은 아니다.
셋째, 2.0의 핵심 주장인 재사용성은 아직 입증되지 않았다. 출시 자료에는 생성된 skill을 재사용 전 어떻게 검증하는지, 누가 승인하는지, 프로젝트 간 재사용을 측정했는지가 공개되지 않았다.
일회성 답변 대신 재사용 가능한 도구를 만든다는 방향은 옳습니다. 대부분의 에이전트 실행은 작업이 끝나면 알아낸 것을 전부 버리니까요. Hyra가 어떤 기준으로 도구를 보관하고 재사용할 만큼 충분히 좋다고 판단하는지 궁금합니다.
또 다른 실무자도 인간 개입 관점에서 같은 검증 문제를 제기했다(@ModelPlaneHQ). Tencent의 출시 자료와 위에서 링크한 제3자 리뷰에는 Google's AI Co-Scientist나 Sakana AI Scientist 같은 경쟁 시스템과의 정면 비교 벤치마크가 없다. 지금 순위를 매긴다면 Tencent 자체 수치에 의존할 수밖에 없다. 에이전트가 만든 모델을 볼 때는 다음 네 가지를 물어보는 편이 낫다. 어떤 하드웨어에서 측정했는가, 어떤 품질 설정인가, 누가 재현했는가, 어디에서 재사용됐는가?
FAQ
Hyra 2.0은 오픈소스인가요? 직접 써볼 수 있나요?
프레임워크는 비공개이고 결과물은 공개다. 에이전트를 위한 공개 데모, API, 설치 방식은 없다. HyInv와 HyPLM-Flash 모델 패키지는 MIT 라이선스를 사용하며, HyFF는 리포지터리의 Apache-2.0 조건을 따른다. 각 폴더의 README와 라이선스를 확인해야 한다.
Hyra 2.0은 Hyra 1.0과 어떻게 다른가요?
Hyra 1.0은 오랫동안 풀리지 않은 조합론 결과를 포함해 반복적인 문제 해결에 초점을 맞췄다. Hyra 2.0은 Overall/Mission/Worker 계층, 영속 프로젝트 상태, Books 지식, skill 추출을 더했고, 재사용 가능한 모델과 워크플로를 만들어내는 것을 명시적 목표로 삼는다.
수학 성과는 동료 심사를 받았나요?
학술지 논문으로는 아직 그렇지 않다. Petty 5차원 및 Yau 반례 논문은 공개되어 검토할 수 있고, 리포지터리 인덱스에는 기존 유한 핵심 결과 세 가지(Beurling-Ahlfors, partial Hadamard, commutator)에 대한 Lean 4 형식화가 기록돼 있다. 모두 전문가 검토를 기다리는 주장으로 받아들이는 것이 적절하다.
단백질 모델을 재현하려면 어떤 하드웨어가 필요한가요?
HyInv의 레퍼런스 경로는 7.8 MB 다운로드로 CPU와 GPU에서 실행된다. HyPLM-Flash의 2.6 GB INT8 엔진에는 CUDA GPU가 필요하며 H20/H100급을 권장한다. HyFF의 속도 수치는 H20 한 장을 전제로 한다.
Hyra 2.0을 과장 없이 평가하는 법
Hyra 2.0은 과학 발전의 단위를 답이 아니라 도구로 보겠다는 시도다. 재사용 가능한 skill이 쌓이며 Tencent가 말하는 지능의 복리(智能复利)를 만든다는 구상이다. 출시는 이 시스템에서 나왔다고 설명되는 모델과 도구를 공개했다. 하지만 이 도구들이 이후 연구를 반복적으로 가속하는지는, 재사용률·검증 비용·독립 재현 결과가 속도 기록과 함께 제시되기 전까지 측정되지 않은 주장으로 남는다.