 AIREITER
Liquid AI의 LFM3는 약 20억 개 파라미터 규모의 모델 6종으로 텍스트, 비전, 오디오, 옴니 상호작용을 다룹니다. 하지만 2026년 10월 27일 기준 Liquid의 공식 가격 페이지에는 LFM3 요금이 아직 없습니다. 지금 LFM3를 저렴한 엣지용 전문 모델로 볼지, 당분간 직접 내려받아 호스팅해야 하는 배포판으로 볼지는 바로 이 공백에 달려 있습니다.
LFM3 한눈에 보기: 2B급 전문 모델 6종, API 가격은 아직 미정
LFM3는 단일 체크포인트가 아니라, 온디바이스 전문 지능을 겨냥한 Liquid AI의 3세대 파운데이션 모델 제품군입니다. 2조 2,000억 토큰으로 사전 학습한 LFM3-1.7B-Base 백본을 공유하며, LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B, d1-Omni-2B 등 6종으로 나뉩니다(발표 자료).
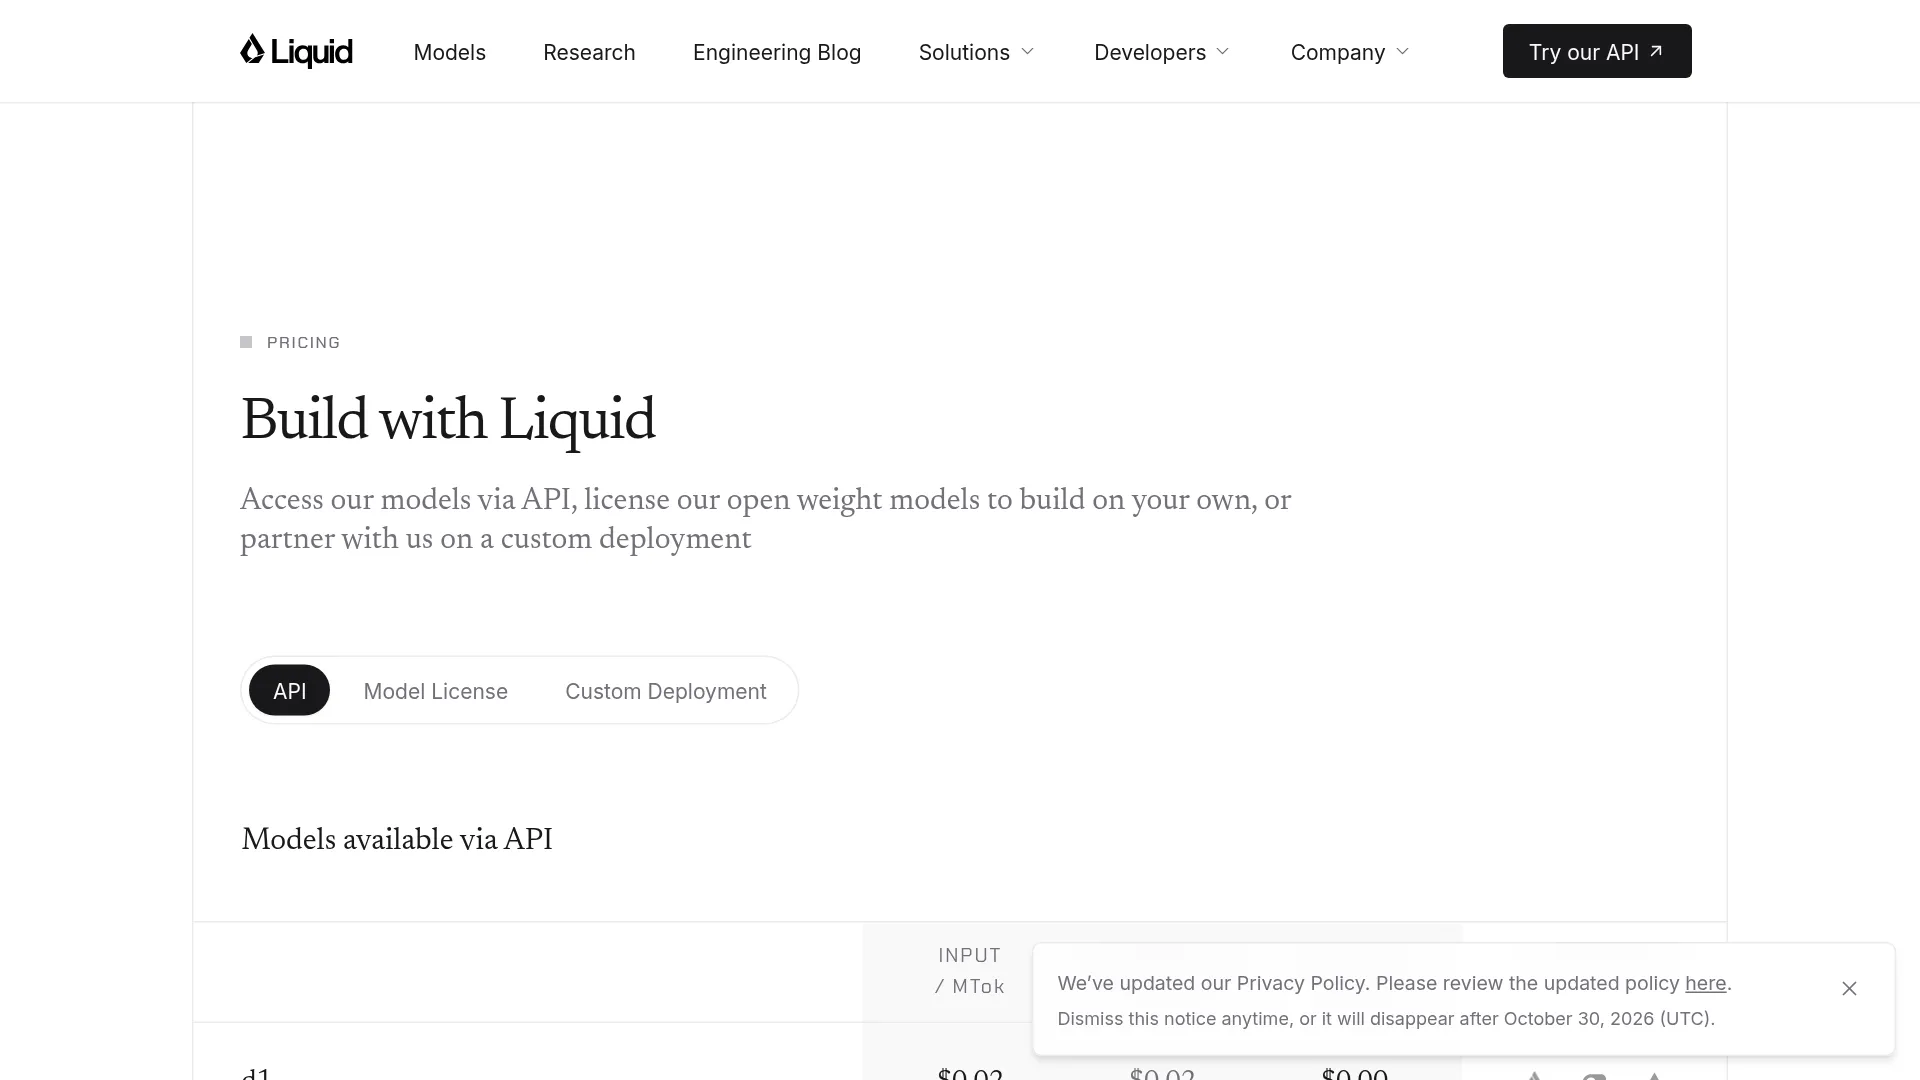
10월 27일 Liquid AI 가격 페이지를 확인했지만 LFM3 항목은 없었고, 아래 표에 정리한 d1, d1-ultra, LFM2.5 요금만 공개돼 있었습니다. LFM3 발표 자료에 따르면 가중치는 Hugging Face, Liquid Playground, Liquid API를 통해 이용할 수 있지만, 현재 직접 확인 가능한 경로는 앞의 두 곳뿐입니다. 신규 조직에는 여전히 2달러 상당의 Liquid Console 무료 크레딧이 제공됩니다(가격 페이지).
6개 모델의 차이와 용도별 선택법
LFM3의 6개 체크포인트는 같은 백본을 쓰지만 입력과 출력 형식, 적합한 작업이 서로 다릅니다.
| 모델 | 대략적인 크기 | 입력 | 출력 | 추천 용도 |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | 텍스트 | 텍스트 | 로컬 에이전트, 툴 호출, 구조화된 출력 |
| LFM3-VL-2B | 1.9B | 텍스트, 이미지, 동영상 | 텍스트 | 이미지·동영상 이해, 비전 에이전트 |
| LFM3-Audio-2B | 2B | 텍스트, 오디오 | 텍스트, 음성 | 음성 대화, 인식, 합성, 18개 언어 번역 |
| LFM3-Omni-2B | 2B | 텍스트, 이미지, 동영상, 오디오 | 텍스트, 음성 | 통합 멀티모달 어시스턴트 |
| d1-2B | 2B | 텍스트, 이미지, 동영상 | 보정된 답변 | 분류, 추출, 단일 패스 의사결정 |
| d1-Omni-2B | 2B | 텍스트, 이미지, 동영상, 오디오 | 보정된 답변 | 신뢰도 점수를 포함한 멀티모달 감지 |
LFM3-1.7B는 256K 토큰 컨텍스트 윈도우와 24개 레이어로 구성된 트라이 하이브리드 구조를 사용합니다. 13개는 게이트 방식의 단기 컨볼루션 레이어, 5개는 256토큰 윈도우의 슬라이딩 윈도우 어텐션 레이어, 6개는 글로벌 어텐션 레이어입니다(발표 자료). 마지막 3조 5,000억 토큰 규모의 중간 학습 단계에는 에이전트 실행 기록과 툴 호출 데이터가 추가됐습니다. Liquid가 이 텍스트 모델을 Hermes Agent, Pi, OpenClaw 스타일의 하네스에 적합하다고 설명하는 이유입니다(발표 자료). LFM3-VL-2B는 Liquid의 첫 비전 모델이자 동영상 입력을 지원하는 모델이며, LFM3-Omni-2B는 사운드트랙과 프레임을 함께 처리하는 첫 옴니모달 모델입니다(발표 자료).
의사결정 모델은 작동 방식부터 다릅니다. d1-2B와 d1-Omni-2B는 자기회귀 방식으로 문장을 생성하는 대신, 한 번의 순전파로 확률이 포함된 보정 답변을 반환합니다(발표 자료). 업체가 공개한 d1-2B 지연 시간은 NVIDIA H100에서 5.7ms, AMD MI325X에서 3.8ms입니다. 10초 오디오 클립을 사용하는 d1-Omni-2B에서는 각각 12.4ms와 8.2ms로 늘어납니다(발표 자료).
Liquid의 주장과 직접 확인할 수 있는 내용
아래 벤치마크 수치는 Liquid AI가 자체적으로 공개한 결과입니다. 독립적인 테스트가 나오기 전까지는 어디까지나 업체 주장으로 보는 편이 안전합니다. 모든 수치는 Liquid의 발표 자료에서 가져왔습니다.
| 모델 | 업체가 제시한 지표 | LFM3 수치 | 이전 모델·경쟁 모델 수치 |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02 (LFM2.5-2.6B) |
| LFM3-1.7B | 크기 / 속도 | 8K 기준 LFM2-1.2B보다 파라미터 35% 감소, 파라미터당 약 25% 향상된 속도 | — |
| LFM3-VL-2B | 62개 비전 평균 / 인코더 | 평균 71.4점; 2.2배 적은 FLOPs로 164M 인코더 | 평균 57.6점; Qwen3.5-2B와 인코더 성능이 동급이라고 주장 |
| LFM3-Audio-2B | UTMOSv2 / 지연 시간 | 3.83; 첫 토큰까지 최소 50ms; M4 Max CPU에서 실시간 대비 87배 | 3.22 (LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0 (d1-3B) |
직접 확인한 내용도 있습니다. Hugging Face의 LiquidAI LFM3 컬렉션에는 6개 모델과 함께 양자화, MLX, ONNX 변형이 모두 올라와 있고, LM Studio 카탈로그에서도 데스크톱용 LFM3 변형을 확인할 수 있습니다. 다만 점수는 보장된 결과라기보다 방향성을 보여주는 자료로 봐야 합니다. 종합 평균만으로는 OCR, 그라운딩, 동영상 세부 평가 결과를 알 수 없고, 4비트 1GB라는 수치에도 KV 캐시와 애플리케이션 오버헤드는 포함되지 않습니다.
“요즘은 정말 놀라울 정도로 빠르게 뭔가를 만들 수 있네요.” — MLX/ExecuTorch로 비행기 모드의 iPhone에서 LFM3를 40 tok/s로 실행한 @Nklockiewicz (출처)
“속도와 지능 면에서는 체급 이상의 성능을 내는 경우가 많지만, 제가 써본 경험으로는 아직 ‘실제 업무’를 맡길 만큼 똑똑하지는 않습니다.” — u/spaceman_, r/LocalLLaMA (출처)
배포 전에 반드시 확인할 1,000만 달러 라이선스 기준
Liquid AI의 오픈 웨이트 라이선스는 기업의 연간 매출이 1,000만 달러를 넘기 전까지 무료입니다(가격 페이지). 연 매출 1,000만 달러 미만인 개발자, 연구자, 비영리단체와 기업은 모든 오픈 LFM을 내려받아 실행하고, 파인튜닝하고, 상용 환경에 배포할 수 있습니다. 파인튜닝 결과를 비공개로 유지할 수 있으며 모바일, 엣지, 온프레미스 환경에도 카피레프트 의무 없이 배포할 수 있습니다(가격 페이지).
연 매출이 1,000만 달러를 넘는 기업은 배포 규모에 따라 영업팀과 별도 가격을 협의하는 유료 엔터프라이즈 라이선스가 필요합니다. 연구, 교육, 비영리 목적의 사용은 매출 상한 없이 무료로 유지됩니다(가격 페이지). LFM Open License는 이 기준을 넘으면 무료 상업 이용 권한이 종료되므로, 상용 앱에 가중치를 포함하기 전에 저작자 표시, 재배포, 수출 관련 조건을 법률 자문과 함께 확인하는 것이 좋습니다.
로컬 실행의 현실: 1GB만으로는 부족한 이유
LFM3-1.7B는 4비트 양자화 기준 약 1GB가 필요하지만, 이 수치는 가중치만 계산한 값입니다(발표 자료). 실제 프로세스에는 런타임과 긴 컨텍스트를 위한 KV 캐시, 비전·오디오 인코더도 함께 올라갑니다. 특히 동영상 프레임이나 오디오 클립을 처리하는 VL 및 Omni 모델은 가중치 외에 추가 RAM을 넉넉히 잡아야 합니다.
처음에는 LFM3-1.7B부터 시작하고, 필요한 경우에만 VL·Audio·Omni 모델을 추가하는 편이 좋습니다. 벤치마크 전에 각 모델 카드에서 추가 의존성도 확인해야 합니다. LFM3는 Hugging Face 컬렉션과 LM Studio 카탈로그에 Ollama, LM Studio, llama.cpp, MLX, ONNX 실행 경로가 안내돼 있습니다.
모델 카드 예제에 trust_remote_code=True가 필요하다면 커밋 해시를 고정하고 저장소 코드를 검토하거나, 먼저 격리된 환경에서 실행하세요. 이 플래그는 저장소에 포함된 코드를 실제로 실행하기 때문입니다. Liquid는 발표 자료에서 18개 오디오 언어를 지원한다고 밝혔지만 언어별 품질 표는 제공하지 않았습니다. 영어 이외의 언어를 사용할 계획이라면 자신의 데이터로 직접 검증해야 합니다.
현재 API 이용법과 요금 구조
LFM3 API 지원은 발표됐지만 Liquid의 공개 가격 페이지에는 별도 요금이 없습니다. 해당 페이지는 Liquid Console, OpenRouter, Vercel AI Gateway를 통한 호출 경로를 안내하고 있습니다(가격 페이지).
| 10월 27일 기준 API 모델 | 입력 / MTok | 캐시 입력 / MTok | 출력 / MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| LFM3-1.7B / VL / Audio / Omni 텍스트 요금 | 미기재 | 미기재 | 미기재 |
현재 확인 가능한 가격 정보는 명확합니다. 당분간 LFM3는 토큰당 요금이 붙는 API 상품이 아니라, 자체 호스팅 컴퓨팅 비용과 엔지니어링 비용을 기준으로 예산을 잡아야 합니다. 오늘 LFM3 토큰 요금을 제시하는 공급자가 있다면, 공개된 d1 및 LFM2.5 기준 요금과 비교하고 Liquid Console을 중계하는 것인지 자체 가중치를 제공하는 것인지 확인해야 합니다. 공개된 d1의 출력 요금은 100만 토큰당 0달러이므로, 대규모 검사 파이프라인에서는 d1이 매력적인 선택지가 될 수 있습니다.
LFM3 FAQ
LFM3 API 가격은 얼마인가요?
2026년 10월 27일 기준 Liquid AI는 LFM3의 별도 토큰당 가격을 공개하지 않았습니다. 공개 페이지에는 d1, d1-ultra, LFM2.5-24B-A2B 요금만 표시돼 있습니다.
LFM3는 상업적으로 무료인가요?
LFM Open License에 따라 연 매출 1,000만 달러 미만 기업은 상용 환경에서 무료로 사용할 수 있습니다. 그보다 규모가 큰 기업은 유료 엔터프라이즈 라이선스가 필요합니다.
LFM3를 휴대폰이나 노트북에서 실행할 수 있나요?
텍스트 모델은 런타임 오버헤드를 제외하고 4비트 기준 약 1GB로 실행할 수 있습니다. Ollama, LM Studio, llama.cpp, MLX, ONNX 경로가 제공됩니다. VL, Audio, Omni 모델은 인코더와 미디어 처리를 위해 더 많은 메모리가 필요합니다.
엣지 에이전트에는 LFM3가 Qwen이나 Gemma보다 나은가요?
제가 확인한 출시 당일 결과에서는 독립적인 비교 자료를 찾지 못했습니다. Qwen3.5-2B 및 Qwen2.5-Omni-7B보다 앞선다는 Liquid의 주장은 업체 자체 테스트 결과입니다(발표 자료). 교체를 결정하기 전에 자신의 하네스에서 LFM3를 Gemma, Qwen과 직접 비교해 보세요.
GPU 한 장으로 LFM3를 파인튜닝할 수 있나요?
Liquid는 SFT, DPO, GRPO, 지속적 사전 학습을 위한 노트북을 제공하며 모든 모델을 GPU 한 장에서 파인튜닝할 수 있다고 설명합니다(발표 자료). 다만 필요한 VRAM이나 데이터셋 규모는 공개하지 않았습니다.
저렴한 비공개 전문 모델인가, 하네스가 필요한 소형 범용 모델인가
데이터를 기기 밖으로 내보낼 수 없거나, 미디어를 로컬에 보관해야 하거나, 처리량이 많아 클라우드 토큰 비용이 부담스러운 경우 LFM3는 잘 맞습니다. 반대로 폭넓은 지식, 긴 창작형 추론, 별도 하네스 튜닝 없이 바로 얻는 완성도를 기대한다면 한계가 있습니다. 모델 하나를 내려받아 자신의 프롬프트와 하드웨어에서 측정해 보세요. 출시 차트가 아니라 그 결과가 선택을 결정해야 합니다.