 AIREITER
짧고 반복적인 API 작업이라면 Haiku 5.5로 충분하다. 다만 프롬프트가 100,000토큰을 넘는 순간 이야기가 달라진다. 이 구간 전까지 Haiku 5.5는 Sonnet 5.5의 20분의 1 가격이지만, 이후 격차는 4배로 좁혀진다. 에이전트 루프는 생각보다 빠르게 이 경계를 넘는다. 디버깅과 여러 단계의 코딩 작업에서는 Sonnet 5.5가 여전히 추가 비용을 정당화한다.
20배 저렴한 Haiku, 100K 토큰을 넘으면 달라진다
Claude Haiku 5.5와 Claude Sonnet 5.5는 표면적인 처리 용량은 같지만 청구 금액은 크게 다르다. 두 모델 모두 1M 토큰 컨텍스트 윈도우와 128K 토큰 최대 출력을 제공하며, 모델 ID는 각각 claude-haiku-5-5, claude-sonnet-5-5다. Anthropic의 Haiku 5.5 발표와 Anthropic의 Sonnet 5.5 발표에 따르면 Sonnet 5.5는 2026년 9월 28일, Haiku 5.5는 2026년 10월 7일 출시됐다. Sonnet 5.5용 Claude 플랫폼 문서에도 동일하게 1M 컨텍스트와 128K 출력 한도가 명시돼 있다.
| 항목 | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| 모델 ID | claude-haiku-5-5 | claude-sonnet-5-5 |
| 출시일 | 2026년 10월 7일 | 2026년 9월 28일 |
| 컨텍스트 / 최대 출력 | 1M / 128K | 1M / 128K |
| 100K 미만 입력 / 출력 | 1M당 $0.10 / $0.50 | 1M당 $2 / $10 |
| 100K 초과 프롬프트 입력 / 출력 | 1M당 $0.50 / $2.50 | 1M당 $2 / $10 (구간 없음) |
| 캐시 읽기 | 1M당 $0.01 | 1M당 $0.10 |
| 기본 effort | medium | high |
가격은 Anthropic의 정가 기준이다. APIKO의 Anthropic 가격 요약에 따르면 Haiku 5.5는 프롬프트 토큰이 100,000개를 초과하면 캐시 읽기와 쓰기를 포함한 요청 전체에 상위 구간 요금을 적용한다.
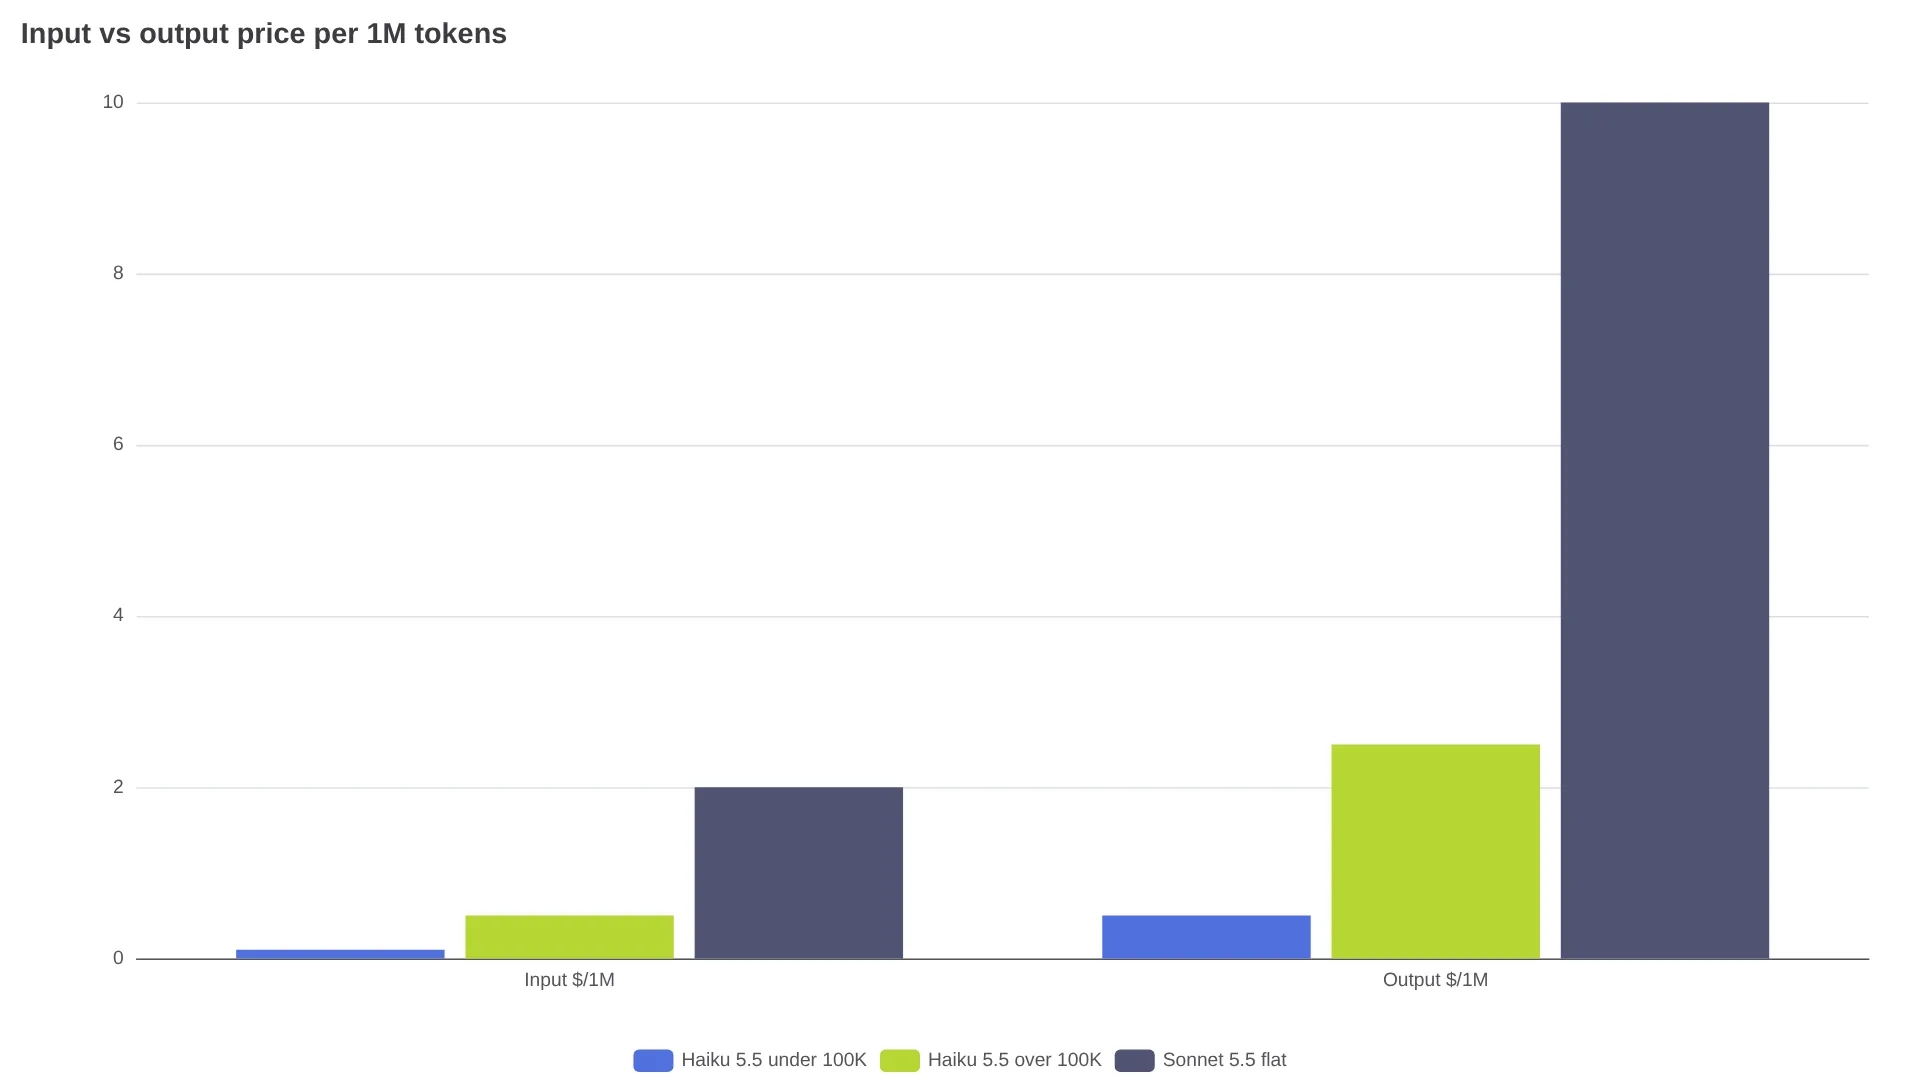
동일한 99K 토큰 문서 1,000건에 각각 1K 토큰 출력을 붙이면 정가 기준 배치 비용은 약 $10.40이다. 반면 문서당 2,000토큰만 늘어난 101K 토큰 문서 1,000건은 약 $53.00이 든다. 문서당 2,000토큰 증가로 비용이 5배가 되는 셈이다. 같은 101K 배치에서 Sonnet 5.5는 약 $212.00이다. 이 계산은 APIKO의 Haiku 5.5 vs Sonnet 5.5 테스트에 보고된 정가를 바탕으로 한 산술값이며, APIKO는 자체 요율로 동일 배치를 $4.54로 제시한다. Sim의 Sonnet 5.5 vs Haiku 5.5 가격 비교에 따르면, 입력 10K와 출력 1K의 호출 1,000건을 가정하면 Sonnet 5.5는 $30.00, Haiku 5.5는 $1.50으로 Haiku가 95% 저렴하다.
실제 에이전트 루프는 의도하지 않아도 이 경계를 넘는다. 한 Haiku 5.5 토큰 사용량 관련 r/ClaudeAI 스레드에서는 약 20번째 모델 호출부터 100K를 넘었고, 히스토리와 도구 출력이 누적되면서 이후 164회 호출 중 145회가 상위 구간으로 청구됐다는 사례가 나왔다. 해당 스레드에서는 작업 티켓을 더 작게 나누고, 파일 범위를 좁히고, 테스트 출력을 조용하게 만들고, 장기 대화 하나를 유지하는 대신 새 서브에이전트를 쓰는 방안이 제안됐다. 짧은 작업은 Haiku에서 여전히 저렴하지만, 긴 컨텍스트 파이프라인은 Sonnet 비용을 예산에 넣어야 한다.
"Haiku 5.5의 저렴한 가격은 100K 컨텍스트 이하에서만 유지된다. 입력이 100K를 넘으면 가격이 5배 뛰므로, 번역이나 요약 같은 작은 작업은 비용을 아끼지만 긴 컨텍스트 작업에는 Sonnet을 써야 한다." — @zookmas1314
모델별 상세 내용은 Claude Haiku 5.5 API 가격과 Claude Sonnet 5.5 API 리뷰 및 가격도 함께 참고하면 좋다.
벤치마크가 보여주는 Haiku 5.5와 Sonnet 5.5의 차이
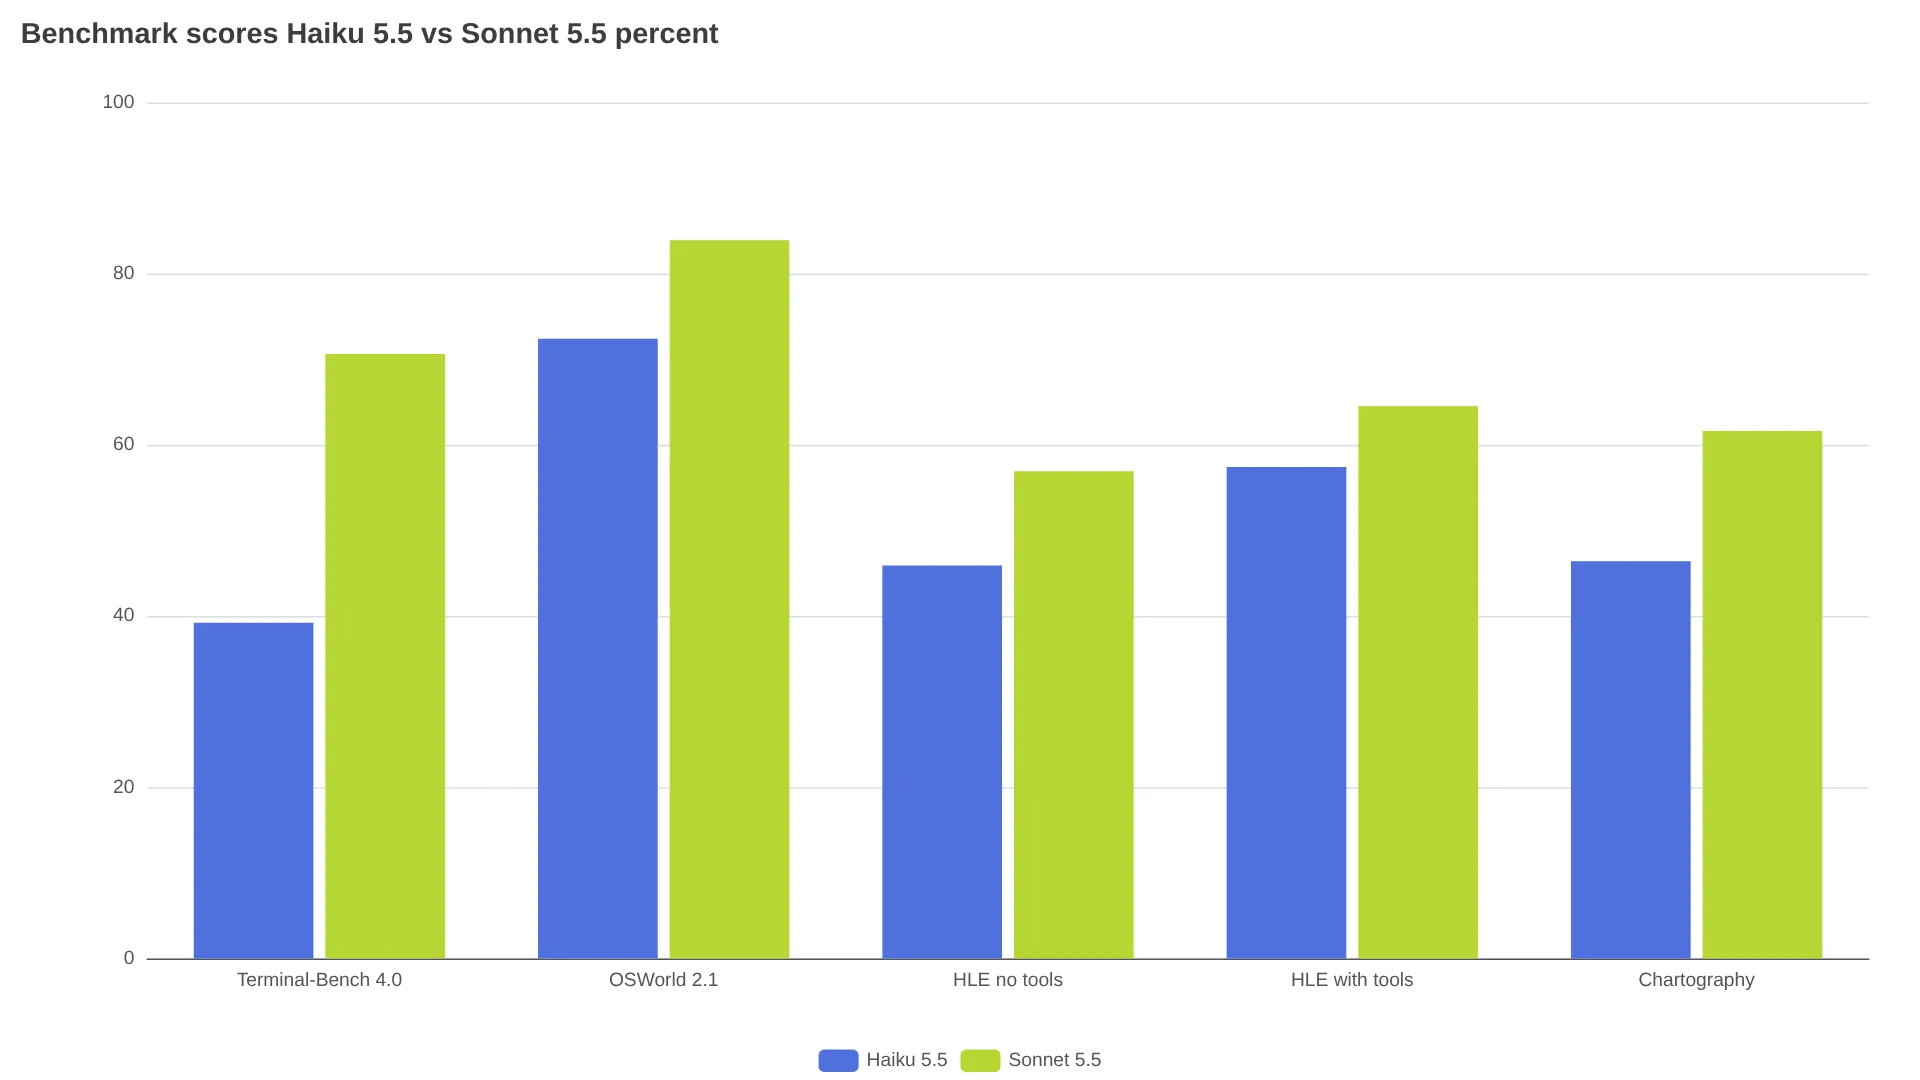
Anthropic이 공개한 정면 비교 결과에서는 Sonnet 5.5가 모두 앞선다. 특히 에이전트가 코드를 작성하고 실행하는 영역에서 격차가 크다. 에이전트 코딩 벤치마크인 Terminal-Bench 4.0은 Haiku 5.5가 39.2%, Sonnet 5.5가 70.6%다. 컴퓨터 사용을 평가하는 OSWorld 2.1에서는 72.4%와 83.9%로 차이가 상대적으로 좁다. 도구 없이 치른 Humanity's Last Exam은 45.9% 대 56.9%, 도구 사용 시에는 57.4% 대 64.5%였으며, 수치는 APIKO의 비교 자료가 정리한 벤치마크 표를 기준으로 한다.
effort 설정에 따라 이 격차는 줄어들거나 커진다. 같은 비교에서 인용한 Artificial Analysis 결과를 보면 Haiku xhigh와 Sonnet medium은 Intelligence Index에서 모두 41점을 받았고, Terminal-Bench 점수도 29.3%와 29.8%로 거의 같았다. 다만 Haiku xhigh는 작업당 $0.12, Sonnet medium은 $0.48이었고, 소요 시간은 각각 295초와 122초였다. 해당 데이터셋에서 Haiku의 어떤 설정도 Sonnet 기본 high의 47점에는 도달하지 못했다. 이 비용 수치에는 Haiku의 100K 초과 구간 요금이 빠져 있으므로, 긴 컨텍스트 작업에서는 최저 비용으로 봐야 한다.
범위가 좁은 추출과 분류에는 Sonnet의 코딩 우위가 필요하지 않다. 반대로 주도 에이전트 코딩, 긴 도구 루프, 시각적 추론에서는 필요하다. Chartography도 46.4% 대 61.6%로 차이가 난다. 단일 Elo나 인덱스 점수를 범용 품질 순위로 받아들이면 안 된다. 한 Reddit 테스트에서는 혼합된 Rust와 레거시 코드베이스에서 Haiku-medium이 Sonnet과 같은 수준을 보이면서 비용은 $1.68 대신 $0.08이었다. 반면 같은 워크플로에서 Haiku-high는 품질 향상 없이 385건의 요청을 만들었다. 출처는 r/ClaudeCode의 통제된 Haiku 5.5 코딩 테스트다.
모델 이름보다 중요한 effort: Haiku low와 Sonnet low
"Haiku는 장황하다"는 평가 상당수는 기본 effort 설정에서 비롯된다. Haiku 5.5의 기본값은 medium, Sonnet 5.5의 기본값은 high이며 모델별 thinking 설정도 다르다. Claude 플랫폼 문서와 APIKO의 동작 메모에 따르면, Haiku는 {"type": "disabled"}로 thinking을 끄는 반면 Sonnet은 high effort 이하에서 {"type": "between_tools"}를 사용한다. xhigh/max에서는 adaptive를 쓰거나 thinking을 생략한다.
APIKO가 2026년 10월 10일 실시한 22개 작업, 528개 요청 규모의 Messages 엔드포인트 평가에서 Haiku low는 66회 중 65회를 통과했다. Sonnet은 설정에 따라 64~66회를 통과했다. 짧은 작업에서 게이트웨이 비용은 Haiku가 약 18분의 1 수준이었다. thinking을 완전히 끄자 Haiku의 통과 횟수는 66회 중 56회로 줄었으며, CSV 합계나 코드 추적처럼 추론과 엄격한 형식 준수가 필요한 문제에서 실패가 집중됐다. 기본값인 Haiku medium은 66회 모두 통과했지만, 대부분 thinking 토큰 때문에 Haiku low보다 출력 토큰을 4.4배 더 생성했다.
이 데이터와 사용자 보고에서 정리할 수 있는 실전 규칙은 다음과 같다.
- 범위가 정해진 작업은 Haiku
low부터 시작한다. 분류, 라우팅, 추출, 짧은 JSON에는 Haiku 기본값인medium보다low가 낫다. - 품질을 더 원한다면 Sonnet
low전에 Haikuhigh또는xhigh를 시도한다. APIKO의 비교에 인용된 Artificial Analysis 수치상 Haikumax는 43점으로 Sonnetlow의 36점보다 높았고, 비용은 약 60% 수준이었다. - Sonnet
medium이상은 디버깅과 다단계 구현에 남겨 둔다. 긴 도구 시퀀스에서 Haiku-high의 추가 지연이 더 이상 품질을 올리지 못할 때 특히 그렇다. - 공유 코드에서는 모델마다 thinking을 명시적으로 설정한다. 하나의 템플릿으로 Haiku에
between_tools를 보내거나 Sonnet에disabled를 보내면 400 upstream 오류가 난다. 이는 APIKO의 게이트웨이 테스트 결과다.
"메인 오케스트레이터와 리뷰어는 Opus/Sonnet으로 두고, Haiku는 실무 작업자로 쓰되 기능마다 새 Haiku 인스턴스를 띄운다." — r/ClaudeAI의 u/ohrajaaa
난이도보다 중요한 기준은 조용한 실패의 비용
라우팅에서 던져야 할 질문은 "이 작업이 어려운가"가 아니다. "Haiku가 그럴듯하게 틀렸는데 검토자가 잡지 못하면 어떤 일이 생기는가"다. 인용된 여러 사용자 테스트는 같은 결론을 보여준다. Haiku는 판단이 필요한 작업에서 조용히 실패할 수 있고, 검증 비용이 큰 곳에서 Sonnet의 값어치가 드러난다.
| 작업 유형 | 주력 모델 |
|---|---|
| 감성 분류, 티켓 라우팅, 허가 문서의 JSON 변환, 로그 요약, OCR 및 주석, SQL 선택, 컨텍스트 압축 서브에이전트 | Haiku 5.5 |
| 코드베이스 검색, 단일 파일 수정, 단일 턴 문서 처리 | Haiku 5.5 |
| 주도 코딩 에이전트, 실제 디버깅, 다단계 리팩터링, 사실 검증, 문서 출처 귀속 | Sonnet 5.5 |
r/ClaudeAI의 "What is Haiku 5.5 best suited for?"에 따르면, 사용자들은 단일 턴의 대량 Haiku 패턴에서 3배 빠른 속도와 큰 사용량 절감을 보고했다. 문서 수 MB를 몇 달러에 처리한 사례도 있다.
6개 작업으로 서브에이전트를 비교한 테스트에서는 Haiku가 저렴하지만 리서치와 사실 판단에서 신뢰성이 크게 떨어졌다. 결과는 깔끔해 보이지만 파일을 놓치는 문제가 있었다. 출처는 r/ClaudeCode의 Haiku vs Sonnet vs Opus 서브에이전트 테스트다. 이 스레드가 제시한 안전장치는 단호하다.
"출력이 어떤 행동을 유발한다면 … 더 큰 모델로 보내거나 더 큰 모델이 검사해야 한다." — r/ClaudeCode의 u/vladgladi
프로덕션에서 한 가지 더 주의할 점은 구조화된 출력 준수에도 Haiku 비용이 공짜가 아니라는 것이다. APIKO 평가에서는 low에서 엄격한 형식 오류가 기록됐다. 레이블 자체는 맞았지만, 순수 배열이어야 할 결과를 JSON 객체로 감쌌다. 같은 통제 코딩 테스트의 r/ClaudeCode 사용자들은 low effort에서 검증 단계를 건너뛰거나 제약 조건을 무시하는 사례도 보고했다.
프로덕션에서도 버티는 Haiku 우선 구성
APIKO가 10월 10일 문서화된 패턴을 대상으로 진행한 게이트웨이 테스트에 따르면, 구성 코드에서는 모델별 thinking, 도구 선택, 히스토리 처리를 구분해야 한다. Haiku는 강제 tool_choice를 허용하지만 Sonnet은 upstream에서 거부하므로 auto 또는 구조화된 출력을 써야 한다. 또한 Haiku는 Sonnet thinking 블록을 읽을 수 없다. 반대로 Sonnet은 히스토리를 append-only로 유지하면 Haiku 블록을 읽을 수 있지만, 수정된 Sonnet 블록을 재전송하면 400 오류가 날 수 있다.
사용자들이 독립적으로 비슷한 결론에 도달한 Haiku 우선 패턴은 다음과 같다.
- 첫 패스는 Haiku 5.5
loweffort로 처리한다. 분류, 추출, 초안 생성이 대상이다. thinking을 완전히 끄려면thinking: {"type": "disabled"}를 사용한다. - 허용 목록의 레이블 또는 스키마를 통과한 JSON만 받는다. 불확실하거나, 형식이 맞지 않거나, 결과가 중요한 경우는 Sonnet 5.5
medium으로 승격한다. - 서브에이전트는 새로 만들고 버릴 수 있게 구성한다. 대화 하나를 100K 이상으로 키우는 대신 파일이나 기능 단위로 Haiku 인스턴스를 하나씩 사용한다.
- 출력이 행동을 유발하거나 메시지를 전송하거나 프로덕션 코드를 수정하면 Sonnet 또는 Opus를 리뷰어로 둔다.
"무엇을 해야 하는지 알고 품질을 검토할 방법이 있다면 Haiku는 아주 좋다." — r/ClaudeCode의 u/Awric
@ClaudeDevs에 따르면 Anthropic은 Haiku 5.5를 Sonnet 또는 Opus와 함께 쓰는 요약 같은 고처리량 작업용 서브에이전트로 포지셔닝한다. @mirku21이 공유한 구성에서는 Haiku 스웜이 리포지터리 검색을 맡고 Sonnet이 diff와 테스트를 맡는다.
Haiku 5.5 vs Sonnet 5.5 FAQ
Haiku 5.5는 Sonnet 5.5보다 얼마나 저렴한가?
정가 기준으로 프롬프트 100K 토큰 미만에서는 20배 저렴하다. 1M 토큰당 입력/출력 가격은 $0.10/$0.50 대 $2/$10이다. 100K 초과 시에는 $0.50/$2.50 대 $2/$10으로 4배 차이다. 캐시 읽기 가격은 1M당 $0.01 대 $0.10이다.
Haiku 5.5와 Sonnet 5.5의 컨텍스트 윈도우는 같은가?
그렇다. Anthropic과 플랫폼 문서 기준으로 두 모델 모두 1M 토큰 컨텍스트 윈도우와 128K 최대 출력을 제공한다.
Haiku 5.5는 프로덕션 API 용도로 충분한가?
범위가 좁고 처리량이 많으며 결과를 검사할 수 있는 작업이라면 그렇다. 보통 low effort와 스키마 검증을 함께 쓰는 방식이 적합하다. 하지만 주도 에이전트 코딩이나 판단 비중이 큰 리서치에서는 사용자들이 Sonnet 5.5보다 더 높은 누락률과 거짓 양성률을 보고한다.
코딩 에이전트에는 어느 모델이 더 적합한가?
주도 에이전트와 디버깅에는 Sonnet 5.5가 낫다. Terminal-Bench는 70.6% 대 39.2%다. Haiku 5.5는 Sonnet 또는 Opus 리뷰어를 붙인 검색, 타이핑, 단일 파일 서브에이전트 작업에 적합하다.
Haiku의 100K 가격 임계값 아래에 머무르려면 어떻게 해야 하나?
문서를 임계값 전에 분할하고, 서브에이전트의 파일 범위를 좁히고, 장황한 테스트 출력을 줄이고, 작업마다 새 서브에이전트를 시작하면 된다. 에이전트 히스토리는 약 20회 호출만으로 100K를 넘길 수 있다.
대화 도중 Sonnet 5.5에서 Haiku 5.5로 옮길 수 있나?
깔끔하게 옮기기는 어렵다. Haiku는 Sonnet thinking 블록을 읽을 수 없으므로 Sonnet에 계속 머물거나 Haiku에서 새로 시작해야 한다. Haiku 히스토리를 Sonnet으로 올리는 경우에는 append-only를 유지하면 추론을 보존할 수 있다.
라우팅으로 피할 수 없는 한 가지 트레이드오프
| 워크로드 유형 | 추천 | 이유 |
|---|---|---|
| 수백 건의 분류, 추출, 요약, JSON 정규화 | Haiku 5.5 low | 검증을 적용하면 짧은 작업에서 Sonnet에 가까운 통과율을 약 1/18 비용으로 낼 수 있음 |
| 대형 코드베이스 하나, 긴 도구 루프, 반드시 정확해야 하는 디버깅 | Sonnet 5.5 | Terminal-Bench에서 31포인트 앞서며 조용한 실패가 더 적음 |
| 100K를 넘나드는 문서 | 두 모델 모두 비용 산정 | Haiku의 5배 구간 요금이 격차 대부분을 지우며, 경계 위에서는 Sonnet이 4배 비쌈 |
| 조용한 오류가 그대로 배포될 수 있는 모든 작업 | Haiku 초안 + Sonnet 검토 | 검증된 성공 1건당 비용이 명목 토큰 가격보다 중요함 |
Haiku 5.5는 시도 1회당 가격에서 이긴다. 하지만 검토와 재실행 비용이 토큰 비용을 압도하기 시작하면 Sonnet이 더 저렴할 수 있다. 라우터를 이 차이를 중심으로 설계하면 어느 모델도 도박이 되지 않는다.