 AIREITER
전체 파라미터는 594B인데 토큰당 실제 활성화되는 규모는 17B. 얼핏 보면 비용 효율이 지나치게 좋아 보이는 구성이다. Inkling 2 Small은 입력 100만 토큰당 $0.30으로 저렴하지만, 현재는 Tinker에서만 쓸 수 있고 코딩 성능의 선두는 DeepSeek-V4.1-Flash-1017에 내줬다. 출시 발표만 보고 폭넓게 도입하기보다는, 맞는 워크로드를 골라 써야 하는 모델이다. 이 평가는 출시 자료와 Tinker 가격을 바탕으로 했으며, 독립적인 지연 시간 및 출력 테스트는 아직 진행할 수 없었다.
Inkling 2 Small은 어떤 모델인가
Inkling 2 Small은 Thinking Machines Lab이 2026년 11월 5일 공개한 2세대 소형 Mixture-of-Experts 모델이다. 전체 594B, 활성 17B 파라미터 구성에 텍스트·이미지 입력을 지원하며, 장기 실행 에이전트 작업을 위해 추론 강도를 조절할 수 있다(Thinking Machines Lab).
| 항목 | Inkling 2 Small |
|---|---|
| 아키텍처 | Mixture-of-Experts |
| 전체 / 활성 파라미터 | 594B / 17B |
| 입력 모달리티 | 텍스트 + 이미지(오디오 미지원) |
| 추론 제어 | 가변 노력도(0.99 / xhigh 기준 벤치마크) |
| 비전 인코더 | 292M 파라미터, 20x20 패치, 2x2 풀링 |
| 수치 형식 | NVIDIA GB300 NVL72에서 NVFP4 |
| 학습 컨텍스트 | 압축을 적용한 256K 토큰(벤치마크 궤적은 최대 1M) |
| Artificial Analysis Index | 31(발표 기준) |
594B에 이르는 전체 가중치 규모와 달리, Tinker의 가격 정책은 소형 모델에 가깝다.
지금 써보려면: Tinker 전용, 가중치는 다음 주 공개
현재 Inkling 2 Small은 Thinking Machines Lab의 Tinker 플랫폼에서만 이용할 수 있다. Playground, 파인튜닝, 샘플링이 제공된다. 다운로드 가능한 가중치는 아직 공개되지 않았으며, 외부 안전성 테스트와 레드팀 평가를 통과하면 다음 주 Apache 2.0 라이선스로 전체 체크포인트를 배포할 계획이다(Thinking Machines Lab).
실제로는 다음 세 가지를 의미한다.
- 출시 발표에서 제공하는 경로는 Tinker뿐이다. 공식 Hugging Face 또는 GGUF 배포, 서드파티 제공업체 경로는 발표되지 않았다.
- 초기 체크포인트는 OpenCode를 통해 Fledge-Alpha라는 이름으로 공개 테스트됐다(Thinking Machines Lab). 따라서 커뮤니티에서 Fledge-Alpha로 표기된 흔적은 이 모델 계열을 가리킨다.
- 셀프 호스팅을 계획한다면 기다리는 편이 낫다. 인용한 출시 자료에는 처리량이나 첫 토큰 생성 시간 수치가 없고, 공식 VRAM 가이드나 양자화 레시피도 공개되지 않았다.
Tinker API 가격과 비교할 만한 대상
256K 컨텍스트 기준 Tinker 서버리스 추론 가격은 입력 100만 토큰당 $0.30, 캐시된 입력 100만 토큰당 $0.03, 출력 100만 토큰당 $1.00이다. Thinking Machines Lab이 호스팅하는 세 모델 가운데 서버리스 출력 및 캐시 입력 단가는 가장 낮다(Thinking Machines Lab).
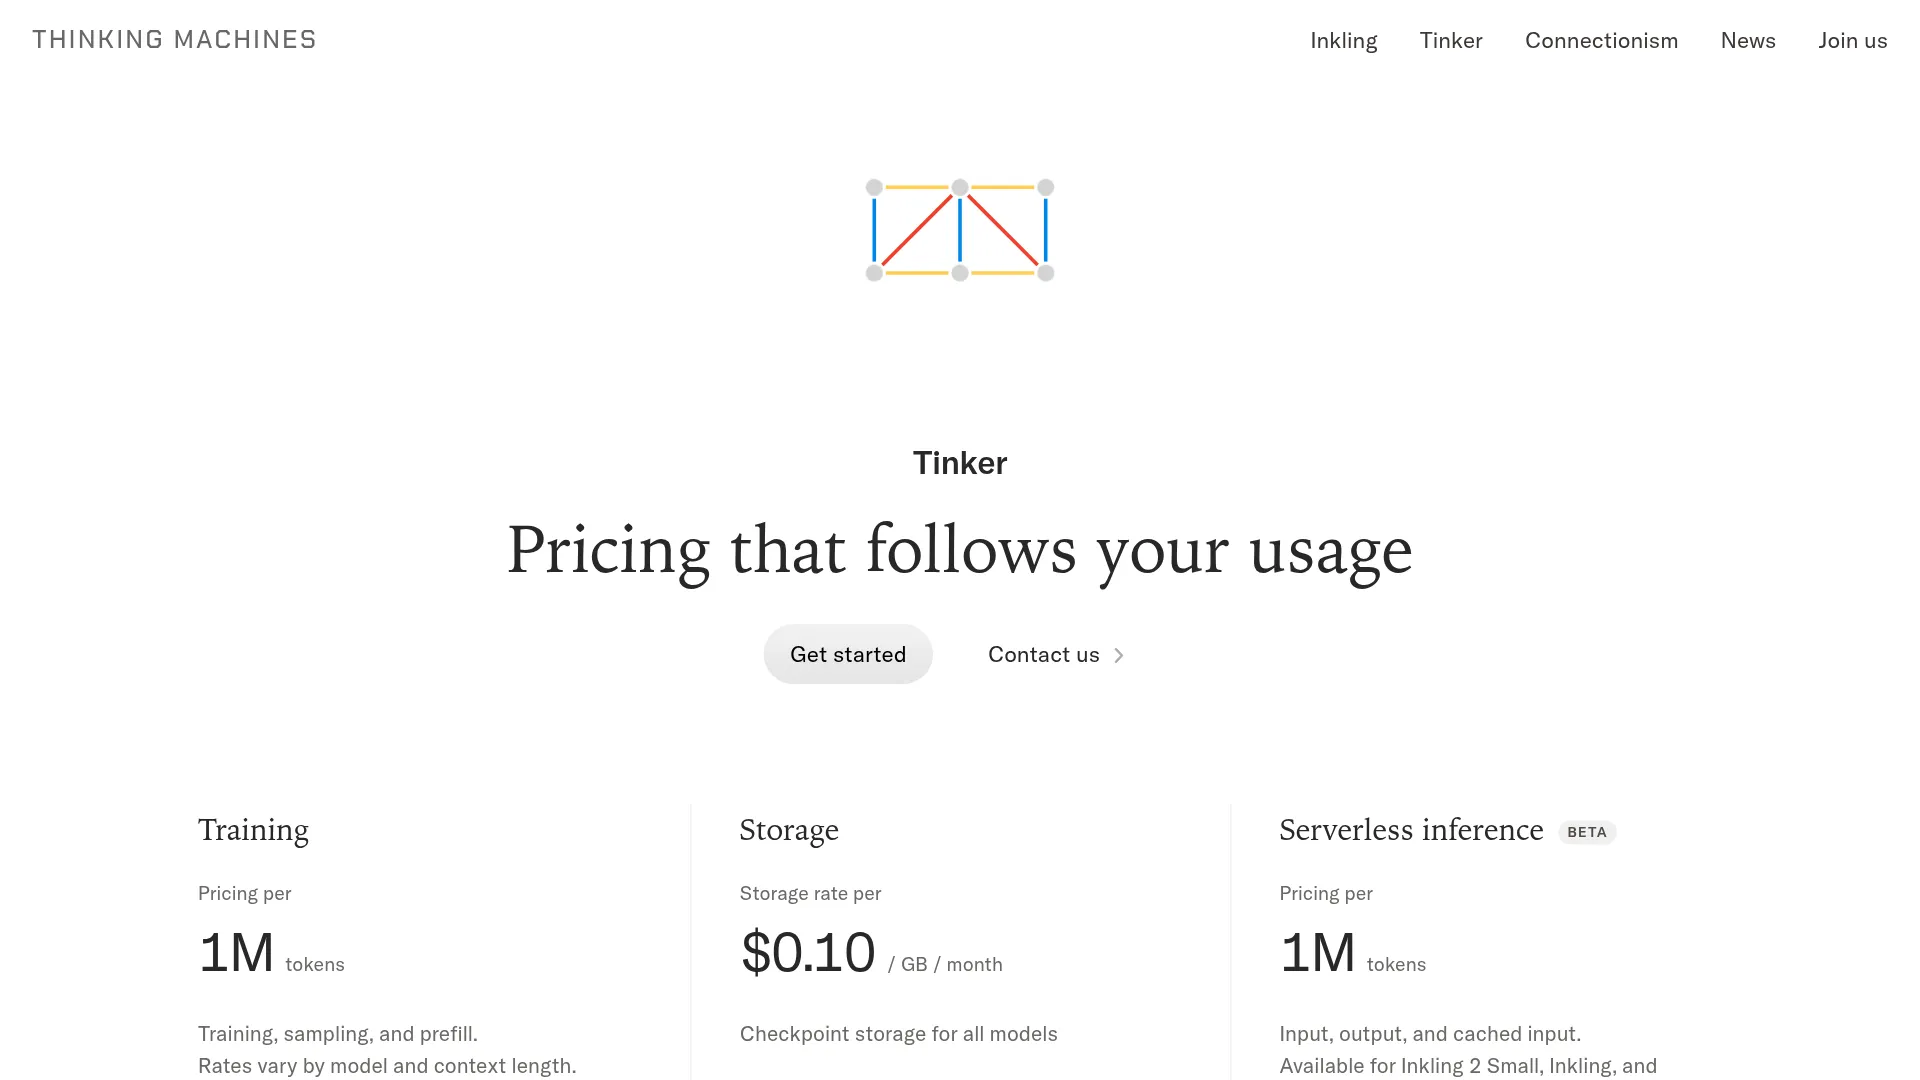
| 모델(서버리스, 256K) | 입력 / 1M | 캐시 / 1M | 출력 / 1M |
|---|---|---|---|
| Inkling 2 Small | $0.30 | $0.03 | $1.00 |
| Inkling-Small (1세대) | $0.30 | $0.06 | $1.20 |
| Inkling (플래그십) | $1.00 | $0.17 | $4.05 |
캐시 적중률이 80%라면 입력 100만 토큰 비용은 약 $0.084다(200K x $0.30 + 800K x $0.03). 긴 압축 롤아웃일수록 이점이 크다. 공급사에 따르면 이 학습 방식에서 롤아웃 토큰 수 중앙값은 43K, p99는 1.5M이다(Thinking Machines Lab).
벤치마크: 강점은 장문·엔터프라이즈, 코딩은 DeepSeek Flash 우세
아래 점수는 승리뿐 아니라 열세 항목도 함께 공개한 공급사의 리포트 카드에서 가져왔다(Thinking Machines Lab).
| 벤치마크 | Inkling 2 Small | 표 내 최고 경쟁 모델 |
|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% DeepSeek-V4.1-Flash-1017 |
| DeepSWE v1.1 | 72.1% | 77.0% DeepSeek-V4.1-Flash-1017 |
| SWEBench Pro v2 Hard | 86.3% | 88.2% Kimi K3 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% DeepSeek-V4.1-Flash-1017 |
| HLE-Diamond | 28.7% | 그룹 선두(Kimi K3 26.9%) |
| LongBench v2 | 70.6% | 그룹 선두(Kimi K3 69.0%) |
| AA-Omniscience (점수 / 비환각률) | 16.1 / 73.3% | 그룹 내 최고 비환각률 |
| DesignArena Web 스냅샷 | 1,340(3위) | 1,366 Muse Wonder(선두) |
| JobBench / Vals Legal / Vals Finance | 70.5% / 73.9% / 61.5% | 표시된 그룹 선두 |
| Terminal Bench Science | 5.7% | 12.9% DeepSeek-V4.1-Flash-1017 |
LongBench v2의 70.6%는 장문 컨텍스트 주장을 뒷받침하고, HLE-Diamond 28.7%는 고난도 추론에서의 선두 성과다. CoreCraft 71.8%, DAYJOB Finance 14.3%를 비롯해 JobBench와 Vals에서도 엔터프라이즈 항목의 표시 그룹 선두를 기록했다. 다만 주의할 점도 있다. DiligenceBench는 58.1%로 Muse Spark Open의 59.0%에 못 미쳤고, kernel autoresearch는 Claude Opus 5.5의 18.80x 대비 6.02x에 그쳤다. 연구소도 장황함, 고르지 못한 구성, 불완전한 도구 선택, 과도한 거부 문제를 인정했다(FORTRESS 20.4, GLM-5.3은 3.2).
1세대 Inkling-Small에서 달라진 점
전체 파라미터는 276B에서 594B로 두 배 이상 늘었고, 활성 파라미터도 12B에서 17B로 증가했다. 환각 관련 특성은 개선됐지만 오디오 입력은 빠졌다. 신모델은 텍스트와 이미지만 받으며, 1세대는 16 kHz WAV도 지원했다(Thinking Machines Lab).
공급사가 제시한 수치상 사실성은 더 좋아 보이지만, 두 세대가 보고한 지표는 서로 다르다. 1세대는 SimpleQA Verified 약 20.6%와 음수 Omniscience 점수를 기록했다(eesel AI). Inkling 2 Small의 비환각률 73.3%는 비교 그룹 선두지만, 연구소는 여전히 장황함과 과도한 거부를 경고한다(Thinking Machines Lab).
1세대의 셀프 호스팅 후기는 참고 자료일 뿐, v2 성능 근거는 아니다.
"Unsloth Studio에서 Q4K_XL로 써봤는데, 다국어 대화 성능이 아주 좋습니다." — 1세대 Inkling-Small 출시 스레드의 u/VotZeFuk(Reddit)
1세대의 2비트 최소 89 GB 요구량은 커뮤니티 Unsloth 빌드에서 나온 수치다(eesel AI). 전체 594B인 v2의 요구 사항은 가중치와 레시피가 나와야 알 수 있다.
에이전트에 Inkling 2 Small을 붙여야 할까?
라우팅 판단은 종합 벤치마크 순위보다 워크로드 형태에 달려 있다.
| 워크로드 | Inkling 2 Small을 호출할까? | 이유 |
|---|---|---|
| 시각 피드백을 활용하는 장기 코딩 에이전트 | Tinker에서 시험 | 압축 학습과 시각적 반복 루프가 이 작업 형태와 맞는다 |
| 검색을 활용하는 엔터프라이즈 리서치·금융·법률 초안 작성 | 우선 시험 | 공급사 표에서 JobBench, Vals Legal/Finance, DAYJOB Finance 선두지만 자체 문서로 검증해야 한다 |
| 요약형 작업 파인튜닝 | 시험(공급사 테스트만 존재) | 공급사의 200단계 테스트에서 75단계 만에 1세대 최종 품질에 도달했다(Thinking Machines Lab) |
| 최저 오류율이 필요한 순수 SWE-bench형 코딩 | 아니요, DeepSeek-V4.1-Flash-1017 | DeepSWE 72.1% 대 77.0%, FrontierCode 25.4% 대 28.5% |
| 검색이나 가드레일 없는 사실 질의응답 | 아니요, 아직은 | 전체 Omniscience 16.1은 최고 경쟁 모델보다 낮다. RAG와 신뢰도 기반 라우팅을 유지해야 한다 |
| 멀티 프로바이더 장애 조치가 필요한 경우 | 아니요, 기다릴 것 | Tinker 단일 공급사 경로이며 서드파티 경로가 발표되지 않았다 |
이전 모델보다 정렬 점수는 개선됐다. 내부 오작동은 66.8~75.2에서 14.9로 낮아졌으며, 낮을수록 좋다. 다만 GPT-6.1 Sol의 0.8에는 미치지 못한다(Thinking Machines Lab).
Inkling 2 Small FAQ
Inkling 2 Small은 이미 오픈 웨이트 모델인가?
아니다. 2026년 11월 5일 기준으로 Tinker의 클로즈드 웨이트 모델이며, 안전성 테스트를 전제로 Apache 2.0 가중치가 다음 주 공개될 예정이다.
Inkling-Small과 무엇이 다른가?
594B/17B 대 276B/12B 구성이고, 오디오 입력은 지원하지 않는다. 비환각률은 73.3%이며, 출력 가격은 100만 토큰당 $1.20에서 $1.00로 낮아졌다.
API는 100만 토큰당 얼마인가?
Tinker 서버리스의 256K 컨텍스트 기준으로 입력 $0.30, 캐시 입력 $0.03, 출력 $1.00이다.
로컬에서 실행할 수 있나?
아직은 불가능하다. 가중치, 레시피, VRAM 가이드가 공개되지 않았다.
함께 읽기: DeepSeek-V4.1-Flash-1017 코딩 리뷰 및 Kimi K3.1 Pro API 가격.