 AIREITER
Arena의 Code Arena Frontend 보드에서 1,595 Elo로 2위에 오른 GLM-5.2는 FrontierSWE에서도 Claude Opus 4.8과 1점 차이에 불과하다. 그런데도 이 모델에서 벗어나려는 개발자는 적지 않다. 성능이 부족해서인 경우는 드물다. 2026년 6월 출시 이후 개발자 커뮤니티에서는 작업 도중 바닥나는 코딩 플랜 쿼터, 피크 시간대 오류, 긴 에이전트 루프에서 체감 비용을 키우는 토큰 소비량이 반복해서 문제로 언급됐다. 표시 가격이 입력 $1.40, 출력 $4.40이라고 해서 실제 운영비까지 가볍다는 뜻은 아니다. 어떤 GLM-5.2 대안이 적합한지는 지금 부딪힌 문제가 무엇인지에 달려 있다.
한눈에 보는 추천: GLM-5.2를 바꾸는 이유별 선택
먼저 결론부터 정리하면 다음과 같다. 근거와 세부 비교는 아래에서 이어진다.
- 쿼터 소진 / 에이전트 루프당 비용: 입력 $0.14/M, 출력 $0.28/M, 1M 컨텍스트를 제공하는 DeepSeek V4 Flash.
- 불안정한 에이전트 루프: 입력 $0.95/M, 출력 $4.00/M의 Kimi K2.7 Code.
- 가장 어려운 작업의 성능 한계: GLM-5.2보다 SWE-Marathon 점수가 두 배 높은 Claude Opus 4.8. 단, 클로즈드 모델 가격을 감수해야 한다.
- 자체 호스팅 또는 데이터 통제: Qwen3-Coder(Apache 2.0), 또는 4비트 빌드에 372–475 GB RAM을 확보할 수 있다면 GLM-5.2의 MIT 가중치.
- 문제는 없고 최신 버전만 원할 때: 출시 당일 Z.ai가 확인한 동일한 $1.40/$4.40 가격의 GLM-5.3.
GLM-5.2의 강점과 실제 운영 비용
Z.ai 공식 문서에 따르면 GLM-5.2는 텍스트 전용 플래그십 모델이다. 컨텍스트 윈도는 1M 토큰, 최대 출력은 128K 토큰이며 API 가격은 입력 $1.40/M, 출력 $4.40/M, 캐시 입력 $0.26/M이다. 가중치는 MIT 라이선스로 공개됐으며, 2026년 6월 13일 처음 GLM Coding Plan 전용으로 배포된 뒤 6월 16일 정식 출시됐다. 모델 카드 기준 Terminal-Bench 2.1은 81.0(Opus 4.8: 85.0), SWE-bench Pro는 62.1(Opus 4.8: 69.2), FrontierSWE는 74.4 대 75.1이다.
숫자만 보면 폐쇄형 최상위 모델에 근접하면서도 오픈 웨이트 가격대를 제시한다. 다만 사용자가 불편을 호소하는 지점은 운영 환경이다. GLM-5.2 출시 전후 Coding Plan Pro 요금제는 월 $35 미만에서 $65로 올랐고, 이 변화는 당일 @bridgemindai가 기록했다. 하지만 가격 자체보다 플랜 내 쿼터에 대한 불만이 더 크다.
"GLM 5.2는 하루 만에 주간 사용 한도를 끝내 버립니다." — u/intl_spy, r/opencode
"GLM-5.2가 마음에 들긴 하는데, 정말 토큰을 엄청 먹습니다." — @atomtanstudio
실제 업무용으로 자기진화 에이전트를 GLM-5.2에서 돌린 한 개발자는 주말 하루 만에 $500 이상을 썼다고 밝혔다. 실행 중 모델을 바꾸면 KV 캐시가 사라져 같은 컨텍스트 비용을 다시 내야 한다는 설명도 덧붙였다(@Xianbao_QIAN). 전체 가치 제안의 한계를 다음처럼 요약한 사용자도 있다.
"GLM 5.2는 훌륭하지만, 월 $200짜리 Codex 구독이 GLM 5.2 API에 $200을 쓰는 것보다 사용량을 더 많이 줍니다. 보조 모델로는 좋지만... 어떤 의미에서도 대체재는 아닙니다." — @mweinbach
피크 시간대 수용량 문제도 있다. GLM-4.5부터 플랜을 구독해 온 @gengdaJ는 저녁이면 서버가 "터진다"며 이전 모델로 돌아가야 했다고 전했다. GLM-5.2를 좋아하면서도 대안을 찾게 되는 이유는 결국 이 조합이다.
문제별 대안 모델: 가격과 교체 이유
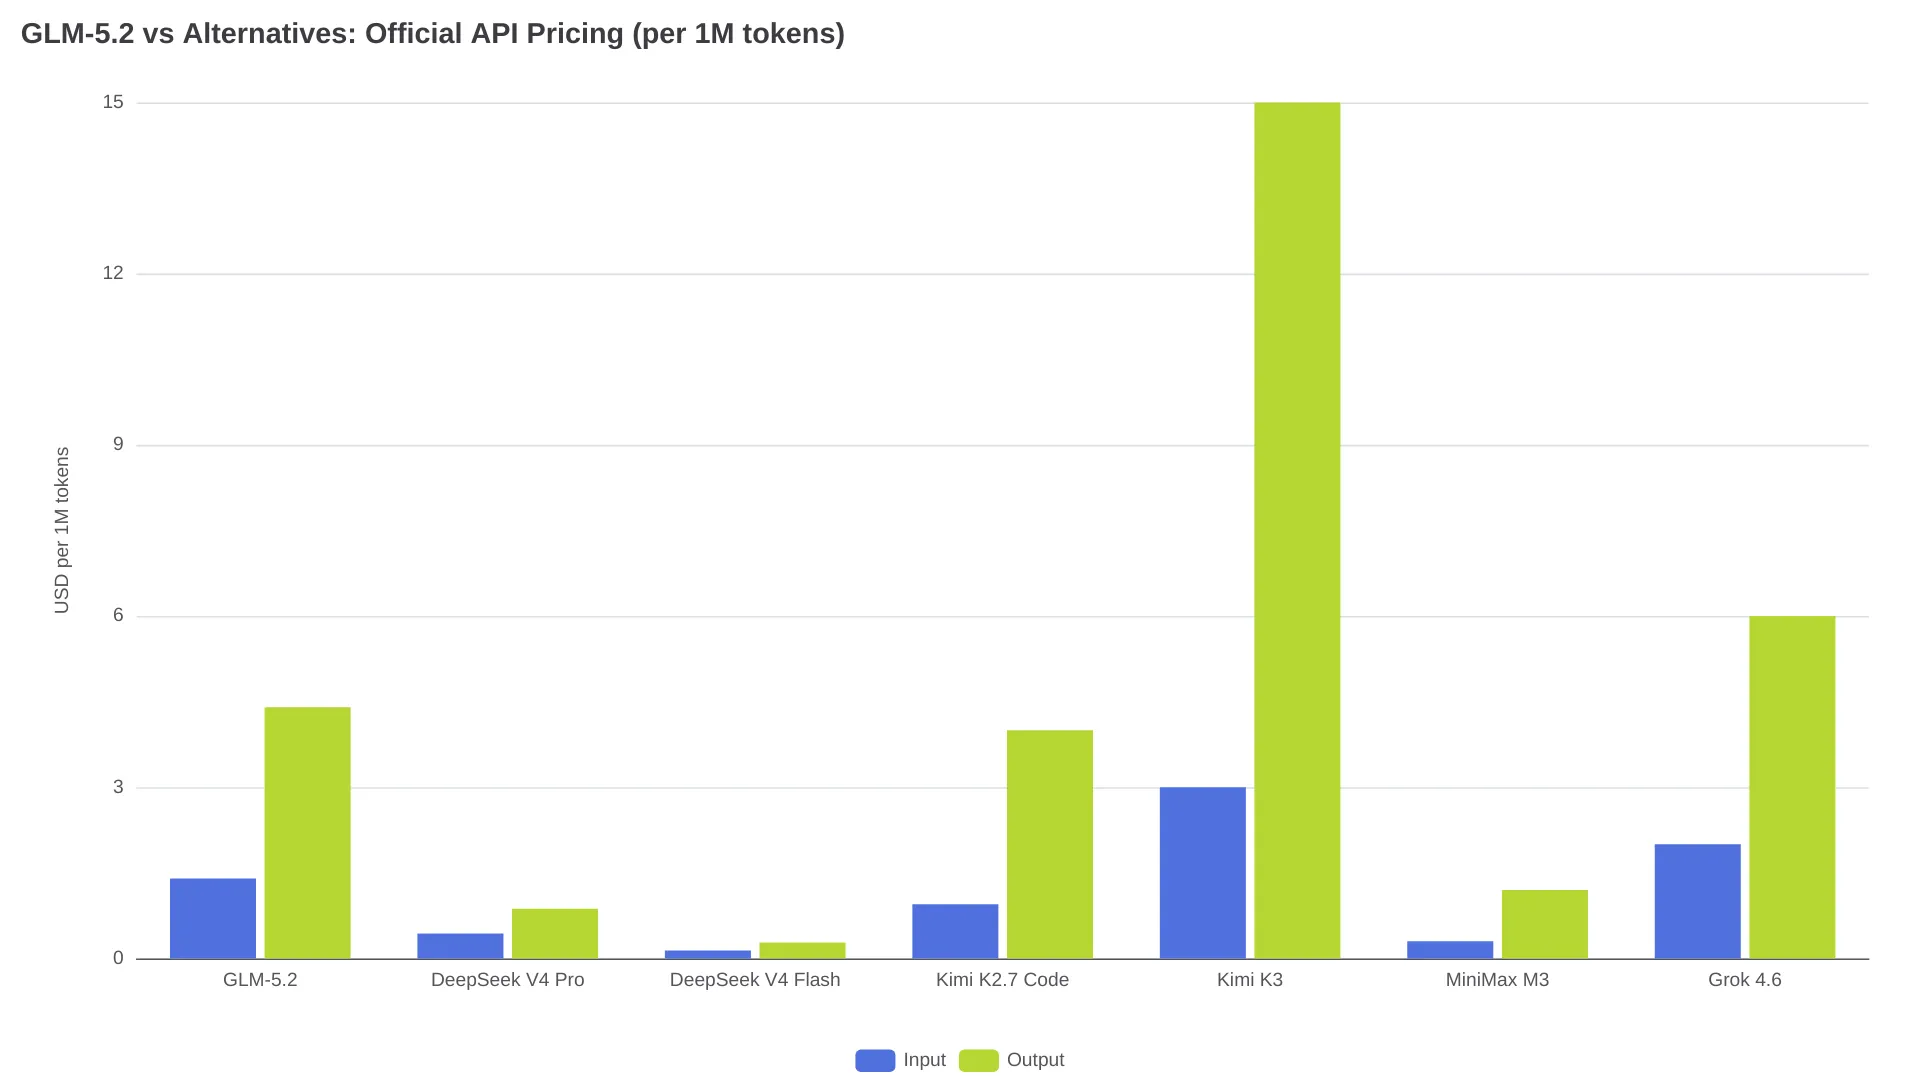
아래 가격은 모두 2026년 8월에 확인한 각 벤더의 공식 가격 페이지 기준이다. Kimi K3와 MiniMax M3의 가격은 캐시 미스 입력 기준이며, 캐시 히트 등급은 훨씬 저렴하다.
| 모델 | 컨텍스트 | 가중치 / 라이선스 | API 가격($/1M, 입력 / 출력) | 이럴 때 교체 |
|---|---|---|---|---|
| GLM-5.2 (기준) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | 오픈(MIT, Layer3 Labs 기준) | $0.435 / $0.87 | 같은 컨텍스트 크기에서 더 저렴한 고난도 추론이 필요할 때 |
| DeepSeek V4 Flash | 1M | 오픈 | $0.14 / $0.28 | 쿼터 소진이 유일한 문제일 때 |
| Kimi K2.7 Code | 256K | 오픈(Modified MIT) | $0.95 / $4.00 | 컨텍스트 크기보다 에이전트 루프 안정성이 중요할 때 |
| Kimi K3 | 1M | 클로즈드 | $3.00 / $15.00 | Kimi의 안정성과 1M 컨텍스트가 모두 필요할 때 |
| MiniMax M3 | 1M | 클로즈드 | $0.30 / $1.20* | 멀티모달 입력 또는 대규모 비용 민감형 작업 |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | 가중치 무료; 호스팅 가격은 상이 | 자체 호스팅이나 파인튜닝이 목표일 때 |
| Grok 4.6 | 500K | 클로즈드 | $2.00 / $6.00 | 속도와 충분히 큰 컨텍스트의 균형이 필요할 때 |
이 7개 외에도 두 가지 업그레이드 경로가 있다. 가장 어려운 작업에서 계속 실패하는 팀에는 Claude Opus 4.8을, 같은 계열에서 같은 가격으로 올리고 싶은 경우에는 GLM-5.3을 아래에서 다룬다.
\* MiniMax M3의 이 등급은 입력이 512K 토큰 이하일 때 적용되며, 이 기준을 넘으면 가격이 두 배가 된다. GLM-5.3은 Z.ai 출시 발표에 따라 GLM-5.2와 가격이 동일하므로 비용 비교에서는 제외했다.
증상별로 고르는 교체 모델
쿼터가 너무 빨리 닳는다면: DeepSeek V4 Flash로 실행 루프 분리
가격 차이는 분명하다. 캐시 미스 입력 기준 GLM-5.2는 $1.40/M으로 DeepSeek V4 Flash의 $0.14/M보다 10배 비싸다. 출력은 $4.40 대 $0.28로 15.7배 차이다. 파일 수정, 테스트 수정, 보일러플레이트 생성처럼 에이전트 루프의 구현 단계에서는 매 턴마다 이 차이가 누적된다. DeepSeek는 동일한 1M 토큰 컨텍스트와 384K 최대 출력도 제공한다. 입력 $0.435/M, 출력 $0.87/M인 V4 Pro는 대부분의 할인 폭을 유지하면서 더 어려운 추론 작업을 겨냥한다. 어느 쪽이 강한지는 GLM-5.2 vs DeepSeek V4 Pro 분석에서, 예산형 모델 비교는 V4 Flash 정면 비교에서 확인할 수 있다.
OpenCode Go 구독자 커뮤니티에서 수렴한 패턴은 완전한 교체보다 역할 분담이다. GLM-5.2는 계획과 리뷰에만 쓰고, 반복 실행은 저렴한 모델에 맡긴다. u/narkeeso는 "OpenCode Go의 GLM 5.2는 계획에만 사용한다"고 썼고, 같은 생태계의 u/Endoky도 "GLM 5.2는 에스컬레이션 모델이나 계획용으로만 쓴다"고 정리했다.
에이전트 루프가 자주 끊긴다면: Kimi K2.7 Code
문제가 모델 능력이 아니라 서비스 안정성이라면, 검토한 스레드에서 가장 자주 대안으로 거론된 이름은 Kimi였다. 한 사용자는 중국어로 처음 올린 글에서 이렇게 요약했다.
"모델 성능은 비슷하지만, 안정적으로 서비스하지 못하는 점 때문에 GLM 대신 Kimi를 선택했습니다." — @wonjder
Kimi K2.7 Code는 코딩 특화 선택지다. 입력 $0.95/M, 출력 $4.00/M이며 캐시 히트 입력은 $0.19/M이다. 컨텍스트는 262,144 토큰으로 GLM-5.2의 4분의 1이며, 이것이 가장 큰 교환 조건이다. 텍스트, 이미지, 영상 입력을 받기 때문에 텍스트 전용인 GLM-5.2가 비워 둔 멀티모달 영역도 커버한다. 256K에 리포지토리가 들어가지 않는다면 Kimi K3가 $3.00/$15.00에 1M 윈도를 제공한다. 다만 출력 $15는 GLM-5.2의 3.4배이므로 K3는 절약용이 아니라 안정성을 위한 구매다. 벤치마크 측면은 Kimi K2.7 Code vs GLM-5.2 비교에서 다뤘다.
가장 어려운 작업의 상한을 올리려면: Claude Opus 4.8
컴파일러 빌드, 커널 작업, 수 시간짜리 자율 작업을 다루는 SWE-Marathon에서 Opus 4.8은 26.0점을 기록해 GLM-5.2의 13.0보다 높다. NL2Repo는 69.7 대 48.9로, 수치는 Z.ai의 모델 카드 기준이다. 같은 모델 카드에 따르면 GLM-5.2는 두 보드 모두에서 최고 순위의 오픈 모델이지만, 작업 시간이 길어질수록 격차는 커진다. Opus는 클로즈드 소스라 자체 호스팅할 수 없고 프리미엄 가격도 따른다. 그 비용이 언제 회수되는지는 GLM-5.2 vs Opus 비교에서 자세히 확인할 수 있다.
자체 호스팅과 데이터 통제가 목적이라면: Qwen3-Coder 또는 GLM 가중치
Qwen3-Coder와 Qwen3.8 Max는 Apache 2.0 라이선스와 1M 토큰 컨텍스트로 제공되며, 단일 GPU 서빙을 겨냥한 소형 변형도 갖췄다. Layer3 Labs와 glm5.app 모두 이들을 자체 호스팅용 선택지로 꼽는다. 파인튜닝과 프라이빗 배포가 목적이라면, 이 대안들 중에서는 가장 현실적인 선택이다. 모델군 전반은 Qwen 3.8 Max 오픈 웨이트 글에서 다뤘다.
의외의 선택지는 GLM-5.2 자체를 호스팅하는 것이다. MIT 라이선스가 이를 허용하기 때문이다. 다만 물리적 요구 사항이 만만치 않다. BF16 가중치는 1.51 TB를 차지하며, Unsloth의 GGUF 릴리스에 있는 4비트 양자화 버전조차 로드하려면 372–475 GB 메모리가 필요하다. 실질적으로 4비트 빌드는 멀티 GPU 서버 영역이고, 전체 BF16은 클러스터급이다. 로컬 도구 지원도 아직 초기 단계다. llama.cpp가 GLM-5.2 인덱서 지원을 얻은 것은 2026년 7월 24일(PR #25407)이었다. GLM-5.2 자체 호스팅은 편의성이 아니라 데이터 주권을 위한 선택이다. 클러스터가 없다면 Qwen의 소형 변형이 워크스테이션급 대안이 된다.
멀티모달과 저렴한 처리량이 필요하다면: MiniMax M3
MiniMax M3는 1M 컨텍스트와 멀티모달 입력을 묶어 입력 $0.30/M, 출력 $1.20/M에 제공한다. 이는 512K 토큰 이하 등급 기준이며, 이 기준을 넘으면 두 가격 모두 두 배가 되므로 예산 산정 시 반영해야 한다. 팀 단위 예산 관점에서는 MiniMax의 토큰 플랜이 월 $20/$50/$120이며, 회사의 M3, M2.7, 이미지, 음성 라인업 전체에 적용된다. 쿼터는 5시간 롤링 윈도와 주간 윈도로 측정된다.
속도가 최우선이라면: Grok 4.6
Grok 4.6의 가격은 입력 $2.00/M, 출력 $6.00/M이고 컨텍스트는 500K다. xAI API 페이지는 벤치마크 표를 공개하지 않은 채 업계 최고 수준의 코딩 및 툴 호출 성능을 주장한다. 따라서 이 포지셔닝은 말 그대로 포지셔닝으로 받아들이는 편이 좋다. 다만 사용자 경험 신호는 있다. @bourneliu66는 자신의 "빅 3"에서 GLM의 자리를 Grok이 가져갔다며, 본인 기준으로 더 강하고 빠르며 저렴하다고 평가했다. 이 순위를 받아들이기 전에는 반드시 자체 워크로드로 검증해야 한다.
문제는 없고 최신 GLM만 원한다면: GLM-5.3
Z.ai 발표에 따르면 GLM-5.3은 2026년 8월 18일 GLM-5.2와 동일한 가격으로 API에 출시됐다. 대안을 찾는 이유가 실제 불편이 아니라 업그레이드 불안이라면, 무엇이 바뀌었는지는 GLM-5.2 vs GLM-5.3 비교에서 확인할 수 있다.
완전히 떠나지 말고 역할을 낮추는 분할 스택
위 스레드에서 반복해서 보이는 결론은 전체 마이그레이션이 아니다. GLM-5.2를 플래너와 리뷰어 역할로 내리고, 실행은 더 저렴한 모델에 맡기는 방식이다. 이는 모델의 성격과도 맞는다. Z.ai는 GLM-5.2를 장시간 엔지니어링 에이전트 작업용으로 포지셔닝하며, 예산형 모델군에서는 토큰당 가격이 가장 높다.
이 분할 전략의 성패를 좌우하는 요소는 두 가지다. 첫째, KV 캐시 손실이다. 실행 중 모델을 바꾸거나 같은 모델이라도 제공업체를 바꾸면 컨텍스트 비용을 다시 내야 한다. 둘째, 제공업체별 편차다. r/opencodeCLI 사용자들은 같은 모델을 제공하는 Fireworks, NeuralWatt, OpenCode Go 사이에 큰 속도 차이가 있다고 보고한다.
운영 측면은 단일 OpenAI 호환 엔드포인트로 처리할 수 있다. 두 단계 모두에서 하나의 GLM-5.2 API 요청 형식을 유지하고, 제공업체 품질이 떨어지면 라우팅을 바꾸며, 청구서도 하나로 합칠 수 있다. 그렇다고 컨텍스트가 무료가 되는 것은 아니다. 캐시 재사용은 모델이나 제공업체를 넘어서 이전되지 않는다. 이것이 $500 주말 사례의 비용 원인이기도 하다. 따라서 실행 중간이 아니라 작업 경계에서 라우팅해야 한다. 분할 구성을 Claude Code 안에서 운영한다면 Claude Code에서 GLM-5.2 쓰기 가이드가 하네스 구성에 도움이 된다.
30초 결정표
| 겪는 문제 | 추천 모델 | 감수할 점 |
|---|---|---|
| 하루 만에 주간 쿼터 소진 | DeepSeek V4 Flash | GLM 대비 일부 에이전트 코딩 완성도 |
| 제공업체 오류로 에이전트 루프 중단 | Kimi K2.7 Code | 1M 컨텍스트 대신 256K |
| 가장 어려운 수 시간 작업 실패 | Claude Opus 4.8 | 오픈 웨이트, 저렴한 가격, 자체 호스팅 |
| 자체 장비에서 가중치 실행 필요 | Qwen3-Coder | GLM의 Elo 선도 프런트엔드 코딩 |
| 일반 작업에서 토큰 소비가 과도함 | MiniMax M3 | 입력 512K 초과 시 가격 두 배 |
| 규제 또는 조달 제약이 있음 | 자체 호스팅 Qwen 또는 GLM 가중치 | 관리형 서비스의 편의성 |
| 최신 GLM이 필요함 | GLM-5.3 | 없음; 가격 동일 |
FAQ
전체적으로 가장 좋은 GLM-5.2 대안은 무엇인가요?
DeepSeek V4 Pro가 가장 가까운 전반적 대체재다. 1M 컨텍스트와 오픈 웨이트를 제공하면서 토큰당 가격은 3-5배 저렴하다. 긴 에이전트 실행에서 벤치마크 차이보다 안정성이 중요하다면 Kimi K2.7 Code가 더 나은 선택이다.
코딩에는 DeepSeek가 GLM-5.2보다 더 좋은가요?
고난도 알고리즘 추론에서는 glm5.app의 비교가 DeepSeek V4 Pro를 더 높게 평가한다. 반면 장기적이고 여러 파일에 걸친 에이전트 작업에서는 GLM-5.2의 1M 컨텍스트와 장기 에이전트 학습(Z.ai가 밝힌 특화 분야)이 우위로 남는다. 실무적으로는 DeepSeek가 실행하고, GLM이 계획하는 구도다.
가장 저렴한 GLM-5.2 대안은 무엇인가요?
DeepSeek V4 Flash다. 입력 $0.14/M, 출력 $0.28/M이며, 캐시 히트 입력은 $0.0028/M으로 반복 컨텍스트에는 사실상 무료 수준이다.
GLM-5.2와 같은 1M 토큰 컨텍스트를 제공하는 대안은 무엇인가요?
DeepSeek V4 Pro와 V4 Flash, Kimi K3, MiniMax M3, Qwen3.8 Max는 모두 1M 토큰 윈도를 제공한다. Kimi K2.7 Code는 256K, Grok 4.6은 500K로 이에 해당하지 않는다.
모델을 바꾸지 않고 GLM-5.2를 로컬에서 실행할 수 있나요?
기술적으로는 가능하다(MIT 가중치가 존재한다). 하지만 4비트 빌드에도 372–475 GB RAM이 필요하고 llama.cpp 지원은 2026년 7월 24일에야 병합됐다. 대부분의 팀에는 호스팅 API 접근이 유일하게 현실적인 경로다.
GLM-5.2 대안의 월 구독 비용은 얼마인가요?
MiniMax 토큰 플랜은 월 $20–$120이다. Digital Applied의 가격 정보에 따르면 Kimi Code CLI는 월 $19부터, Z.ai Coding Plan은 월 $18부터 시작하며, Z.ai Pro 등급은 6월 인상 이후 $65다.