 AIREITER
노트북에서 1,450억 개 파라미터 모델을 초당 80토큰으로 돌린다는 Edge0-145B. 가중치는 실제로 내려받을 수 있지만, 세부 조건을 보면 CUDA 13을 지원하는 NVIDIA 데스크톱과 약 105GB의 SSD 공간이 필요합니다.
이번 Edge0-145B 리뷰에서는 출시 블로그, 모델 문서, Q3_K 카드의 발표 내용을 초기 커뮤니티 실행 결과와 함께 비교했습니다. 다운로드하기 전에 직접 구동할지, API를 이용할지 판단하는 데 필요한 내용입니다.
11월 12일 공개된 것: 가중치와 실행 엔진, 그리고 제한 사항
Edge0는 2026년 11월 12일 Edge0-145B와 Edge0-120B를 공개했습니다. 가중치는 Edge0-145B-q3k와 Edge0-145B-NVFP4에서 받을 수 있고, 실행 엔진인 edge0-strata는 Edge0-AI/Edge0 저장소에 포함돼 있습니다. Edge0-145B는 텍스트 전용 잠재 Mixture-of-Experts 모델로, 컨텍스트 길이는 256K입니다. Qwen3.8-Flash-Next를 기반으로 하며 4비트로 네이티브 학습됐습니다. 토큰마다 실제로 활성화되는 파라미터는 약 10.12B이므로, 전체 145B 파라미터를 전부 VRAM에 올릴 필요는 없습니다.
구성은 약 84.6B의 전문가 파라미터, SSD에서 메모리 매핑해 사용하는 51.2B 규모의 PLE n-그램 테이블, 추론 가속을 위한 1.26B 드래프트 헤드, 그리고 6GB 스켈레톤으로 나뉩니다. Q3_K는 105.4GB 저장소 안에 40.81GiB의 가중치를 제공하고, NVFP4는 112.9GB 저장소 안에 47.79GiB의 가중치를 담고 있습니다. 라우팅되는 전문가 가중치는 범용 GGUF가 아니라 전용 experts.bin 패키지에 들어 있습니다.
29GB라는 설명만 보고 설치하면 안 되는 이유
출시 블로그는 한 곳에서 최대 메모리를 29GB, 다른 곳에서는 28GB로 표기합니다. 함께 제시된 수치는 프리필 초당 1,100토큰 이상, 디코드 80토큰 이상, 전력 120W입니다. 하지만 Q3_K 카드의 RTX 5090 D 측정값은 VRAM 23.14GiB와 호스트 RAM 31.28GiB이며, NVFP4는 각각 23.25GiB와 38.27GiB입니다. 전문가 라이브러리만 해도 RAM에서 약 40GB를 사용하고, 약 48GB의 어휘 데이터는 SSD에서 스트리밍됩니다.
자주 쓰이는 전문가는 VRAM에, 그보다 덜 자주 쓰이는 전문가는 RAM에 머뭅니다. 51.2GB PLE 테이블은 필요할 때 SSD에서 읽어옵니다. 좁은 의미의 활성 상주 메모리만 보면 29GB에 가까울 수 있지만, 실제 설치와 스트리밍에는 저장소 전체가 필요합니다.
| 수치가 의미하는 것 | 크기 | 저장 위치 |
|---|---|---|
| 블로그의 최대 메모리 주장 | 28-29GB | 활성 상주 메모리, 측정 방법은 공개되지 않음 |
| Q3_K 저장소 다운로드 | 105.4GB | NVMe SSD, 51.2GB PLE + 40.1GB experts.bin |
| NVFP4 저장소 다운로드 | 112.9GB | NVMe SSD, 51.2GB PLE + 47.6GB experts.bin |
| 5090 D에서 측정한 Q3_K 상주 메모리 | 23.14GiB VRAM + 31.28GiB RAM | 추론 중 VRAM + 시스템 RAM |
| 5090 D에서 측정한 NVFP4 상주 메모리 | 23.25GiB VRAM + 38.27GiB RAM | 추론 중 VRAM + 시스템 RAM |
Edge0-145B를 실제로 실행하려면
Edge0-145B는 edge0-infer를 통해 NVIDIA GPU와 CUDA 13을 사용하는 Linux 또는 Windows에서 실행됩니다. 공개된 파일에는 기본 llama.cpp, Ollama, LM Studio용 로딩 경로가 없습니다. 스켈레톤 GGUF에는 라우팅된 전문가 가중치가 빠져 있고, Edge0가 문서화한 실행 방법도 edge0-infer뿐입니다(저장소 안내 참조). 따라서 llama.cpp v1.0 가이드의 방식은 여기에 적용되지 않습니다. 출시 블로그는 첫날부터 macOS와 MacBook Pro를 지원한다고 설명하지만, 플랫폼 표에는 145B와 120B 모두 Linux와 CUDA 13 기반 Windows만 기재돼 있습니다.
테스트된 최소 사양은 VRAM 16GiB와 RAM 20GiB이며, Q3_K에서 에이전트 디코드 속도는 초당 44.9토큰입니다. 권장 사양은 24GB NVIDIA 그래픽카드, 시스템 RAM 32GB이며 48GB면 더 여유롭습니다. 여기에 여유 공간 120GB의 NVMe, CUDA 13, CMake, Ninja, uv가 필요합니다. 빌드와 서버 실행은 저장소 안내에 따라 진행합니다.
git clone https://github.com/Edge0-AI/Edge0.git edge0
hf download Edge0/Edge0-145B-q3k --local-dir ./Edge0-145B-q3k   # ~105 GB
export EDGE0_145B=$PWD/Edge0-145B-q3k
build/cpu/bin/edge0-infer serve --model "$EDGE0_145B"  # :8000
Windows 사용자는 GitHub Releases에서 Edge0 Chat 앱 v0.2.0을 내려받아 사용할 수도 있습니다. AMD 환경은 수동 수정이 필요합니다. u/UghrUghr는 이 r/LocalLLaMA 스레드에서 Windows 11의 RX 7900 XTX를 구동하기 위해 빌드 및 런타임 코드 약 35줄을 수정했다고 전했습니다. CUDA 융합 커널을 사용했을 때보다 느린 폴백 경로로 실행됩니다.
Q3_K와 NVFP4 중 어떤 파일을 받을까
105.4GB인 Q3_K가 기본 선택지이며, Edge0 표에서 5090 D의 에이전트 디코드 속도는 초당 121.2토큰입니다. 112.9GB인 NVFP4는 Blackwell 가속을 겨냥하며 같은 그래픽카드에서 98.3을 기록합니다. Blackwell 하드웨어가 없다면 Q3_K부터 시작하는 편이 좋습니다.
실제 그래픽카드에서의 속도는 어느 정도인가
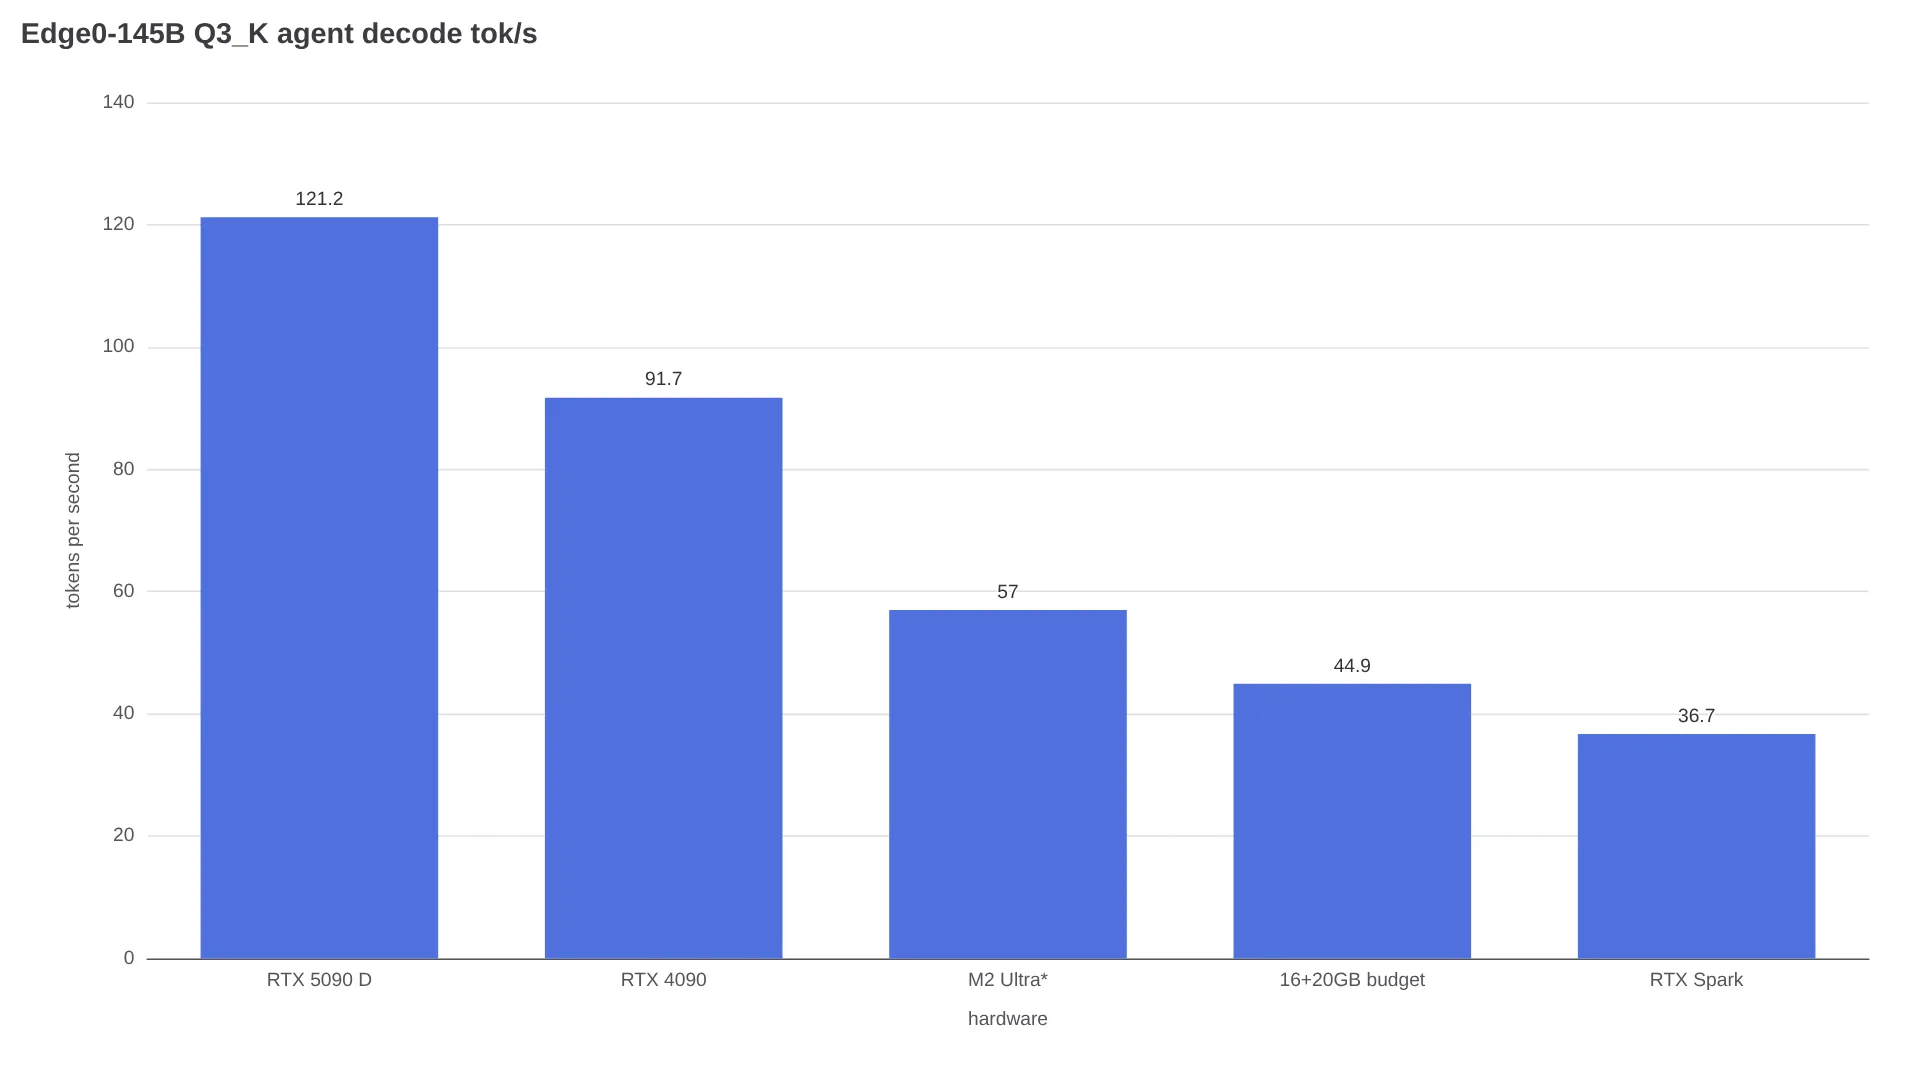
아래 수치는 별도 표기가 없는 한 16K 프리필 기준의 Edge0 발표 Q3_K 측정값입니다. M2 Ultra 항목은 Metal 측정 결과이며, 이것만으로 macOS 출시를 의미하지는 않습니다.
| 하드웨어 | 채팅 디코드 | 에이전트 디코드 | 16K 프리필 |
|---|---|---|---|
| RTX 5090 D 24GB Q3_K | 99.7 | 121.2 | 3,554.9 |
| RTX 4090 24GB Q3_K | 69.9 | 91.7 | 3,179.4 |
| Apple M2 Ultra Metal Q3_K | 60.9 | 57.0 | 800.3 |
| VRAM 16GiB + RAM 20GiB 구성 Q3_K | 36.8 | 44.9 | 335.0 |
| RTX Spark 60GiB Q3_K | 37.7 | 36.7 | 770.3 |
RTX 3090 사용자는 Q3_K에서 첫 토큰까지 20.1초, 프리필 1,583, 디코드 56.2를 기록했다고 전했습니다. 플래그십 그래픽카드보다는 느린 수준으로 보입니다.
방금 3090 시스템에서 실행해봤습니다. Edge0-145B Q3_K에서 TTFT 20.1초, 프리필 1,583토큰/초, 디코드 56.2토큰/초가 나왔습니다.
— u/LightBrightLeftRight, r/LocalLLM 스레드
앞서 언급한 AMD 시스템에서는 u/UghrUghr가 디코드 약 40, ROUTE_TAIL_SKIP=7과 ROUTE_PRIOR=1.5를 적용했을 때 약 54, 프롬프트 처리 약 320을 보고했습니다. 통제된 재현 테스트가 아닌 단일 사용자 측정치이며, 5090 D 속도의 대략 절반에서 3분의 2 수준입니다.
벤치마크: 두 가지 강점과 네 가지 주의점
모델 문서에 따르면 Edge0의 표에는 Edge0, Qwen, DeepSeek, Claude의 내부 측정과 다른 모델의 서드파티 수치가 함께 섞여 있습니다. Edge0-145B는 두 가지 코딩 에이전트 테스트에서 앞섰지만, 지식 및 지시 수행 테스트에서는 기반 모델인 Qwen보다 낮았습니다. 2026년 11월 13일 기준으로 연결된 독립 재현 결과는 확인하지 못했으며, 표의 점수는 양자화된 다운로드 파일이 아니라 전체 모델을 대상으로 합니다.
| 벤치마크 | Edge0-145B | Qwen3.8-Flash-Next | DeepSeek V4 Flash | Claude Opus 4.6 Max |
|---|---|---|---|---|
| DeepSWE 1.1 | 64.6 | 58.7 | 54.4 | — |
| Terminal-Bench 2.1 | 86.52 | 83.3 | 82.7 | 78.2 |
| HLE | 35.4 | 35.9 | 33.8 | 40.0 |
| GPQA-Diamond | 90.4 | 91.7 | 90.8 | 91.3 |
| IFBench | 80.6 | 81.3 | 79.2 | 62.5 |
| AA-LCR | 79.3 | 79.1 | 79.7 | 78.0 |
Edge0의 계산 방식에서 평균 점수는 Edge0-145B가 72.8, Qwen3.8-Flash-Next가 71.7, DeepSeek-V4-Flash가 70.1이며 120B는 68.9입니다. 제 판단은 이렇습니다. 두 모델 크기가 비슷한 최대 성능을 내세우고 있으므로 디스크 공간이 빠듯하지 않다면 145B를 선택하는 편이 낫습니다.
라이선스: 오픈 가중치가 곧 오픈 소스는 아니다
프레임워크는 Apache 2.0, Strata 기반은 MIT 라이선스입니다. 하지만 가중치에는 Edge0 Community Model License 1.0이 적용되며 Qwen의 조건도 함께 적용됩니다. 개인적 사용, 연구, 사내 업무, 출력물의 상업적 이용은 허용됩니다. 반면 모델을 판매하거나 번들로 제공하는 행위, 유료 서비스를 운영하는 행위, 상업용 코딩 또는 오피스 어시스턴트를 출시하는 행위에는 별도의 서면 허가가 필요합니다.
다운로드할까, API를 사용할까
하드웨어를 갖추고 코드가 기기 밖으로 나가면 안 된다면 다운로드할 만합니다. 일회성 테스트라면 하드웨어를 구매하기 전에 호스팅 API 가격부터 비교해보는 편이 좋습니다. 호스팅 추론 서비스를 비교 중인 개발자라면 105GB의 디스크를 할당하기 전에 DeepSeek V4.1 Flash API 페이지도 확인해볼 수 있습니다.
| 사용자 상황 | 추천 선택 |
|---|---|
| 24GB NVIDIA + RAM 32-48GB + NVMe 120GB, Linux/Windows | Q3_K를 내려받고 edge0-infer로 실행 |
| Blackwell 그래픽카드를 사용하며 NVFP4 경로를 선호함 | NVFP4 빌드 다운로드 |
| Mac만 사용하거나, 노트북이 8-16GB이거나, Ollama/LM Studio가 필요함 | 아직 다운로드하지 말고 호스팅 API 사용 |
| 가중치 기반 유료 API 또는 어시스턴트를 출시할 예정 | 서면 라이선스 확인 전까지 보류하고 API 사용 |
| 운영 작업 없이 벤치마크 점수만 원함 | Qwen 계열 또는 프런티어 API 사용, 재현 결과가 나온 뒤 재검토 |
핵심은 출처의 투명성과 실제 사용성 사이의 절충입니다. 전문가 스트리밍 덕분에 100B 이상 모델의 VRAM 진입 장벽은 낮아졌지만, 노트북과 macOS 지원, 29GB라는 설명은 공개된 코드보다 앞서 있습니다. 또한 Edge0가 공개한 표에는 Q3_K의 별도 품질 수치가 없습니다.
FAQ
Edge0-145B를 노트북에서 실행할 수 있나요?
CUDA 13을 사용하는 Linux 또는 Windows 환경에서 VRAM 약 24GB, RAM 32GB 이상, NVMe 120GB를 갖춘 고사양 NVIDIA 노트북이라면 가능합니다. 8GB 또는 16GB 울트라북에서는 145B 빌드를 실행할 수 없습니다. 다운로드에 105.4GB가 필요하고 VRAM 상주에도 23GiB 이상이 필요합니다.
Edge0-145B는 Mac에서 작동하나요?
2026년 11월 13일 기준 플랫폼 표에는 지원되는 macOS 출시 버전이 없습니다. M2 Ultra 수치는 Metal 측정 결과일 뿐입니다.
Ollama, llama.cpp, LM Studio에서 사용할 수 있나요?
아니요. 기본 빌드는 전용 experts.bin 패키지를 불러올 수 없고, 스켈레톤 GGUF에도 라우팅된 전문가 가중치가 없습니다. edge0-infer serve 또는 Windows Chat 앱을 사용해야 합니다.
Edge0-145B가 Qwen3.8-Flash-Next보다 좋은가요?
Edge0 테스트에서 DeepSWE는 64.6 대 58.7, Terminal-Bench는 86.52 대 83.3으로 앞섰습니다. 반면 HLE는 35.4 대 35.9, GPQA-Diamond는 90.4 대 91.7로 뒤졌습니다. 독립 테스트 결과는 아직 나오지 않았습니다.
Edge0-145B를 상업적으로 사용할 수 있나요?
출력물의 상업적 이용은 가능합니다. 하지만 커뮤니티 라이선스에 따라 모델 판매, 유료 서비스 운영, 상업용 코딩 또는 오피스 어시스턴트 출시는 별도의 서면 허가가 필요하며 Qwen 조건도 함께 적용됩니다.