 AIREITER
DeepSeek가 2026년 11월 13일, 앱에서 제공하던 기능을 API 파라미터로 확장했습니다. 내장 검색은 모델이 호출 여부를 결정하고 검색 결과가 반환된 쿼리 단위로 과금됩니다. 반면 독립형 Search/Fetch는 코드가 실행을 제어하며 성공한 요청 기준으로 과금되고, 파일 업로드는 별도 Files API에서 file_id로 관리합니다.
추론을 활성화하면 한 번의 요청에서 약 20회의 도구 호출이 이어질 수 있습니다. 이 호출은 검색과 페이지 조회 건수로 각각 과금됩니다. 이 글에서는 기능 활성화 방법, 파일 업로드, 작업별 비용 계산, 상황에 따른 선택 기준을 정리합니다.
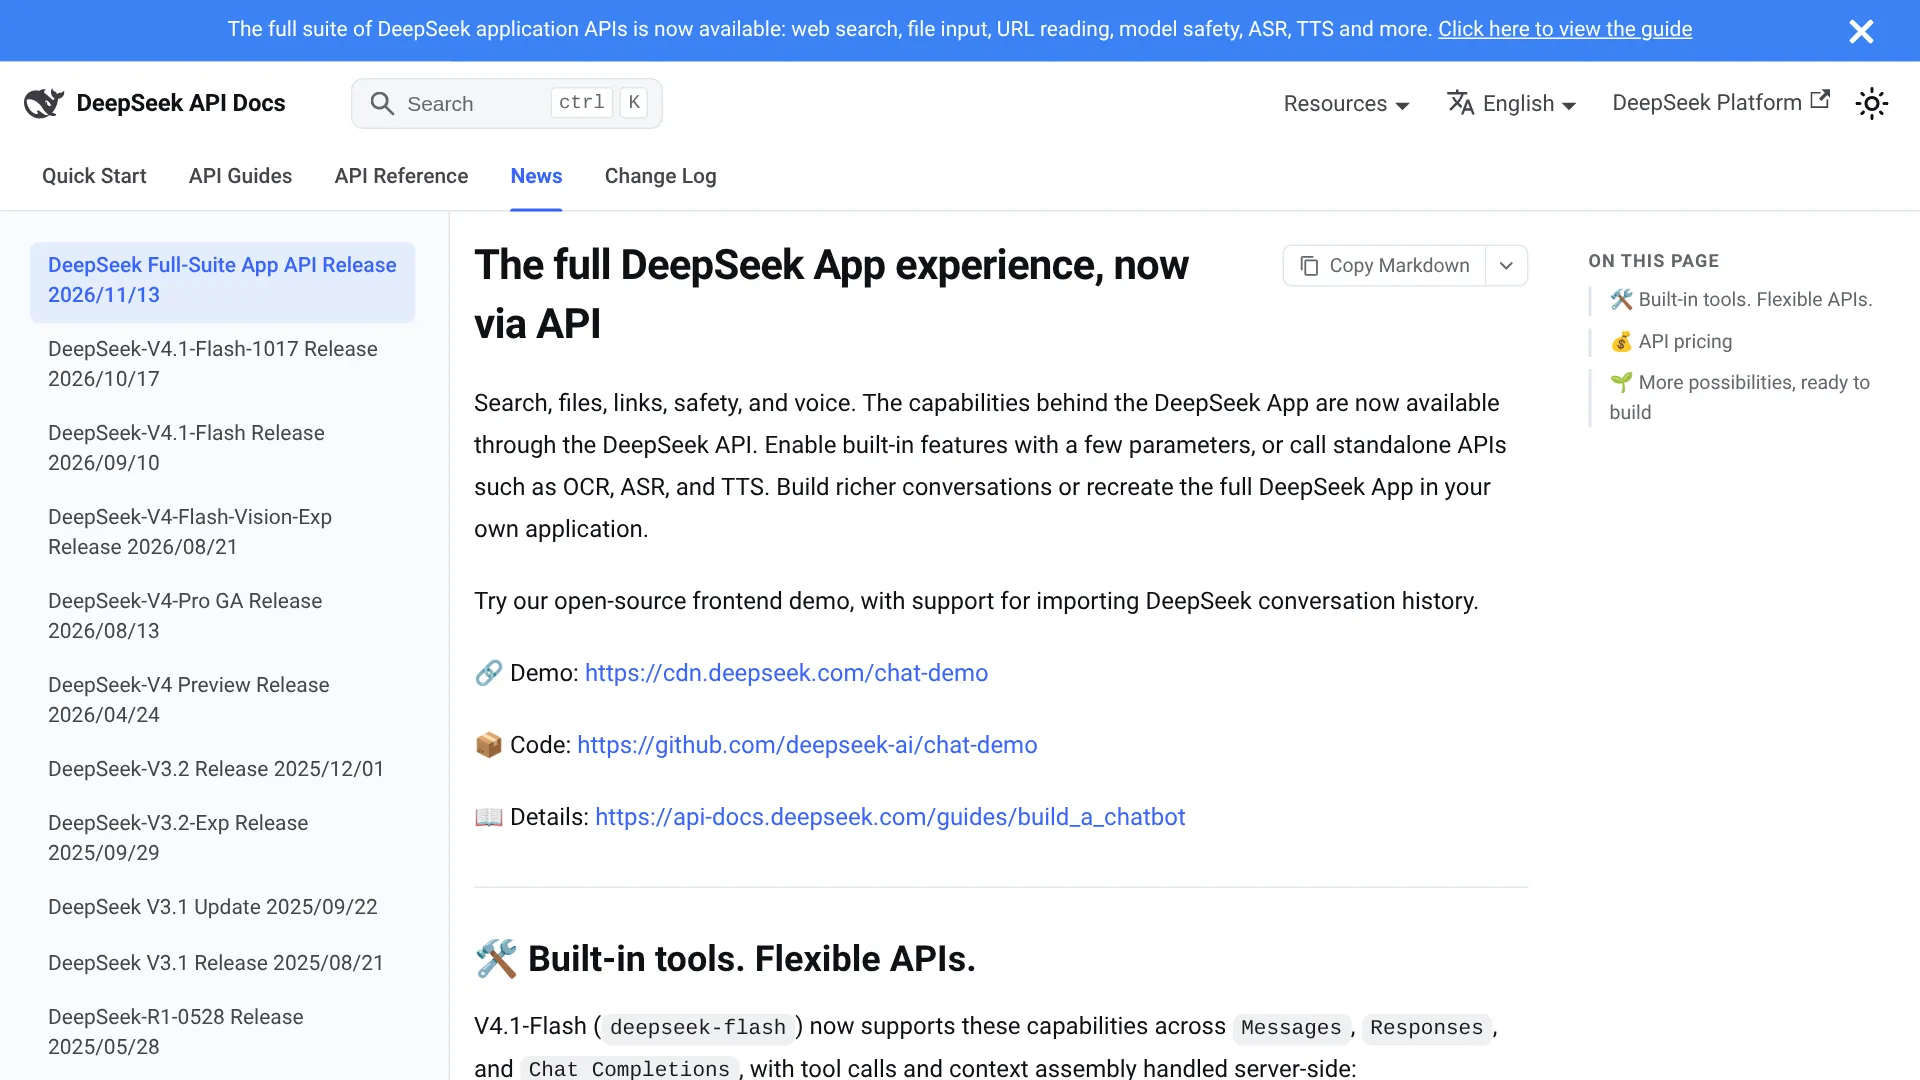
11월 13일 DeepSeek App API에 추가된 기능
DeepSeek는 The full DeepSeek App experience, now via API라는 공지를 통해 deepseek-flash(DeepSeek-V4.1-Flash) 모델에서 웹 검색, 파일 입력, URL 읽기를 API로 사용할 수 있다고 밝혔습니다.
Build a Chatbot guide에 따르면 같은 기능은 Messages API, Responses API, Chat Completions API에서 모두 사용할 수 있습니다. 도구 호출과 컨텍스트 조합은 서버에서 처리되므로 클라이언트는 구조화된 블록을 그대로 렌더링하고 다시 전달하면 됩니다. 오픈소스 브라우저 데모에서 연결 방식을 확인할 수 있지만, 문서에도 적혀 있듯 시연용 예제입니다.
웹 검색과 URL 읽기 활성화하기
Web Tools guide에 설명된 대로 deepseek-flash 요청의 tools 배열에 다음 두 도구를 선언합니다.
"tools": [{"type": "deepseek_web_search"}, {"type": "deepseek_read_url"}]추론을 끄면 deepseek_web_search는 채팅 검색처럼 동작합니다. 검색이 필요한지 모델이 판단하고, 한 번의 호출에 여러 쿼리를 담을 수 있으며, 답변에는 인용이 포함됩니다. 추론을 켜면 검색, open_page, find_in_page가 추론 단계 사이에 섞여 실행되는 심층 검색으로 바뀝니다. 답변이 나오기 전까지 도구 호출은 약 20회까지 이어질 수 있습니다.
같은 Web Tools guide에 정리된 주요 제한은 다음과 같습니다.
- 가장 최근 사용자 메시지에 포함된 URL만 처리 대상입니다. 서로 다른 URL은 처음 10개까지만 인식하며, 실제로 읽을 URL은 모델이 선택합니다.
tool_choice로 특정 도구를 강제할 수 없습니다. 도구 이름을 지정하면 HTTP 400이 반환되고,"none"을 사용하면 URL 읽기도 함께 비활성화됩니다.- 웹 도구, 높은 안전성 설정, 제목 생성 기능이 켜져 있으면
temperature,top_p와 일부 도구 제어 필드는 조용히 무시됩니다. - 웹 도구를 사용한 응답은 이어서 계속할 수 없습니다. 새 요청으로 다시 보내야 합니다.
"요청 1,000건당 0.75달러라면 에이전트가 백그라운드에서 몇 번 호출하는지 알고 싶습니다. 일반적인 리서치 작업의 비용을 계산해 본 사람이 있나요?" — r/DeepSeek의 u/Glum-Guitar-5083
경로에 따라 과금 방식도 다릅니다. 내장 웹 검색은 결과가 반환된 쿼리마다 과금되므로 한 번의 호출에 쿼리 3개가 들어가면 3건으로 계산됩니다. 내장 Fetch는 가져온 페이지마다 과금되며, 안전성 검토 과정에서 나중에 url_not_allowed 또는 unavailable로 바뀐 페이지도 포함됩니다. 가져오지 못한 링크에는 요금이 부과되지 않습니다. 독립형 Search/Fetch는 HTTP 200 응답과 비어 있지 않은 결과 또는 반환된 콘텐츠가 모두 있을 때만 과금됩니다. 두 경로 모두 실패하거나 빈 결과를 반환한 검색은 과금하지 않습니다.
직접 파서를 만들지 않고 파일 업로드하기
Files API를 사용하면 파일을 한 번 업로드한 뒤 file_id로 여러 번 참조할 수 있습니다. 기본 흐름은 다음과 같습니다.
curl https://api.deepseek.com/files \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -F purpose="rich_layout_recognition" \
  -F file="@report.pdf"
# -> {"id": "file-api-xxxxxxxxxxxxxxxx", ...}

# then reference it in chat (Chat Completions shape):
# {"model": "deepseek-flash", "messages": [{"role": "user",
#   "content": [{"type": "text", "text": "Compare this with today's numbers"},
#   {"type": "file", "file_id": "file-api-xxxxxxxxxxxxxxxx"}]}]}
purpose 값이 처리 방식을 결정하며, 문서 파일은 file 필드보다 먼저 전송해야 합니다. user_data는 이미지(JPEG, PNG, GIF, WebP), 일반 텍스트, 스프레드시트, 전자책을 지원합니다. text_recognition은 PDF, Word, PowerPoint와 이미지를 텍스트로만 변환합니다. rich_layout_recognition은 텍스트뿐 아니라 표와 열에 포함된 도형 정보도 반환합니다. PDF를 user_data로 업로드하면 HTTP 400이 반환되며, 파싱된 문서는 이미지로 재사용하거나 나중에 다운로드할 수 없습니다.
| 구분 | 제한 |
|---|---|
file_id를 통한 이미지 | 64 MiB (인라인 Base64는 32 MiB) |
| PDF / Word / PowerPoint | 100 MiB, 업로드 파싱 120초 |
| 텍스트 / 스프레드시트 / 전자책 | 32 MiB, 업로드 가능 시간 10분 |
| 계정 할당량 | 25 GiB, 파일 10,000개; 만료 1시간~30일 또는 영구 보관 |
파일은 API 키가 아니라 계정에 귀속됩니다. 동일한 ID를 OpenAI 호환 및 Anthropic 호환 제품군에서 모두 사용할 수 있으며, 후자에서는 anthropic-beta: files-api-2025-04-14 헤더가 필요합니다. 파일 파싱은 업로드 중 진행되므로 성공적으로 처리된 뒤에야 file_id가 반환됩니다.
내장 도구와 독립형 Search·Fetch 비교
대화 흐름 안에서 검색이나 URL 읽기 여부를 모델이 판단하게 하려면 내장 도구를 사용하면 됩니다. 반대로 코드가 실행 시점을 직접 결정해야 한다면 Search & Fetch guide의 독립형 API가 적합합니다. POST https://api.deepseek.com/v1/tools/search는 순위가 매겨진 검색 결과를 최대 50개까지 반환하며, rerank_score는 0~3 범위에서 제공되고 1.5 이상이면 높은 품질로 볼 수 있습니다. authority는 0~4 범위입니다. POST https://api.deepseek.com/v1/tools/fetch는 지정한 URL 하나를 Markdown으로 가져옵니다. 독립형 검색은 아직 이미지 검색을 지원하지 않지만 웹 도구에서는 가능합니다.
| 경로 | 제어 방식 | 과금 단위 | 적합한 용도 |
|---|---|---|---|
내장 deepseek_web_search / deepseek_read_url | 모델이 서버에서 결정 | 결과가 있는 쿼리별 / 가져온 페이지별 | 인용이 포함된 채팅, 심층 리서치 |
| 독립형 Search + Fetch | 코드가 결정 | 각 성공 요청 1,000건당 $0.75 | 에이전트, RAG 파이프라인 |
속도 제한은 계정 단위로 적용되며 서로 독립적입니다. Search는 100 QPS, Fetch는 25 QPS이고 도메인별 Fetch 제한도 별도로 있습니다. 할당량을 넘으면 HTTP 429가 반환됩니다. 408, 429, 5xx는 재시도하고, 그 외 4xx는 요청 자체를 수정해야 합니다. 독립형 Search에서는 site:, -site:, "exact phrase", lang:, after:/before: 같은 쿼리 연산자를 사용할 수 있습니다.
실제 비용은 얼마나 들까
도구 비용은 토큰 비용에 추가됩니다. Search와 Fetch는 각각 성공한 요청 1,000건당 $0.75이며, OCR·ASR·TTS에는 별도 도구 요금이 적용됩니다. 기간이 제한된 프로모션은 공지에서 확인할 수 있습니다. count는 결과 수만 바꿀 뿐 가격에는 영향을 주지 않습니다.
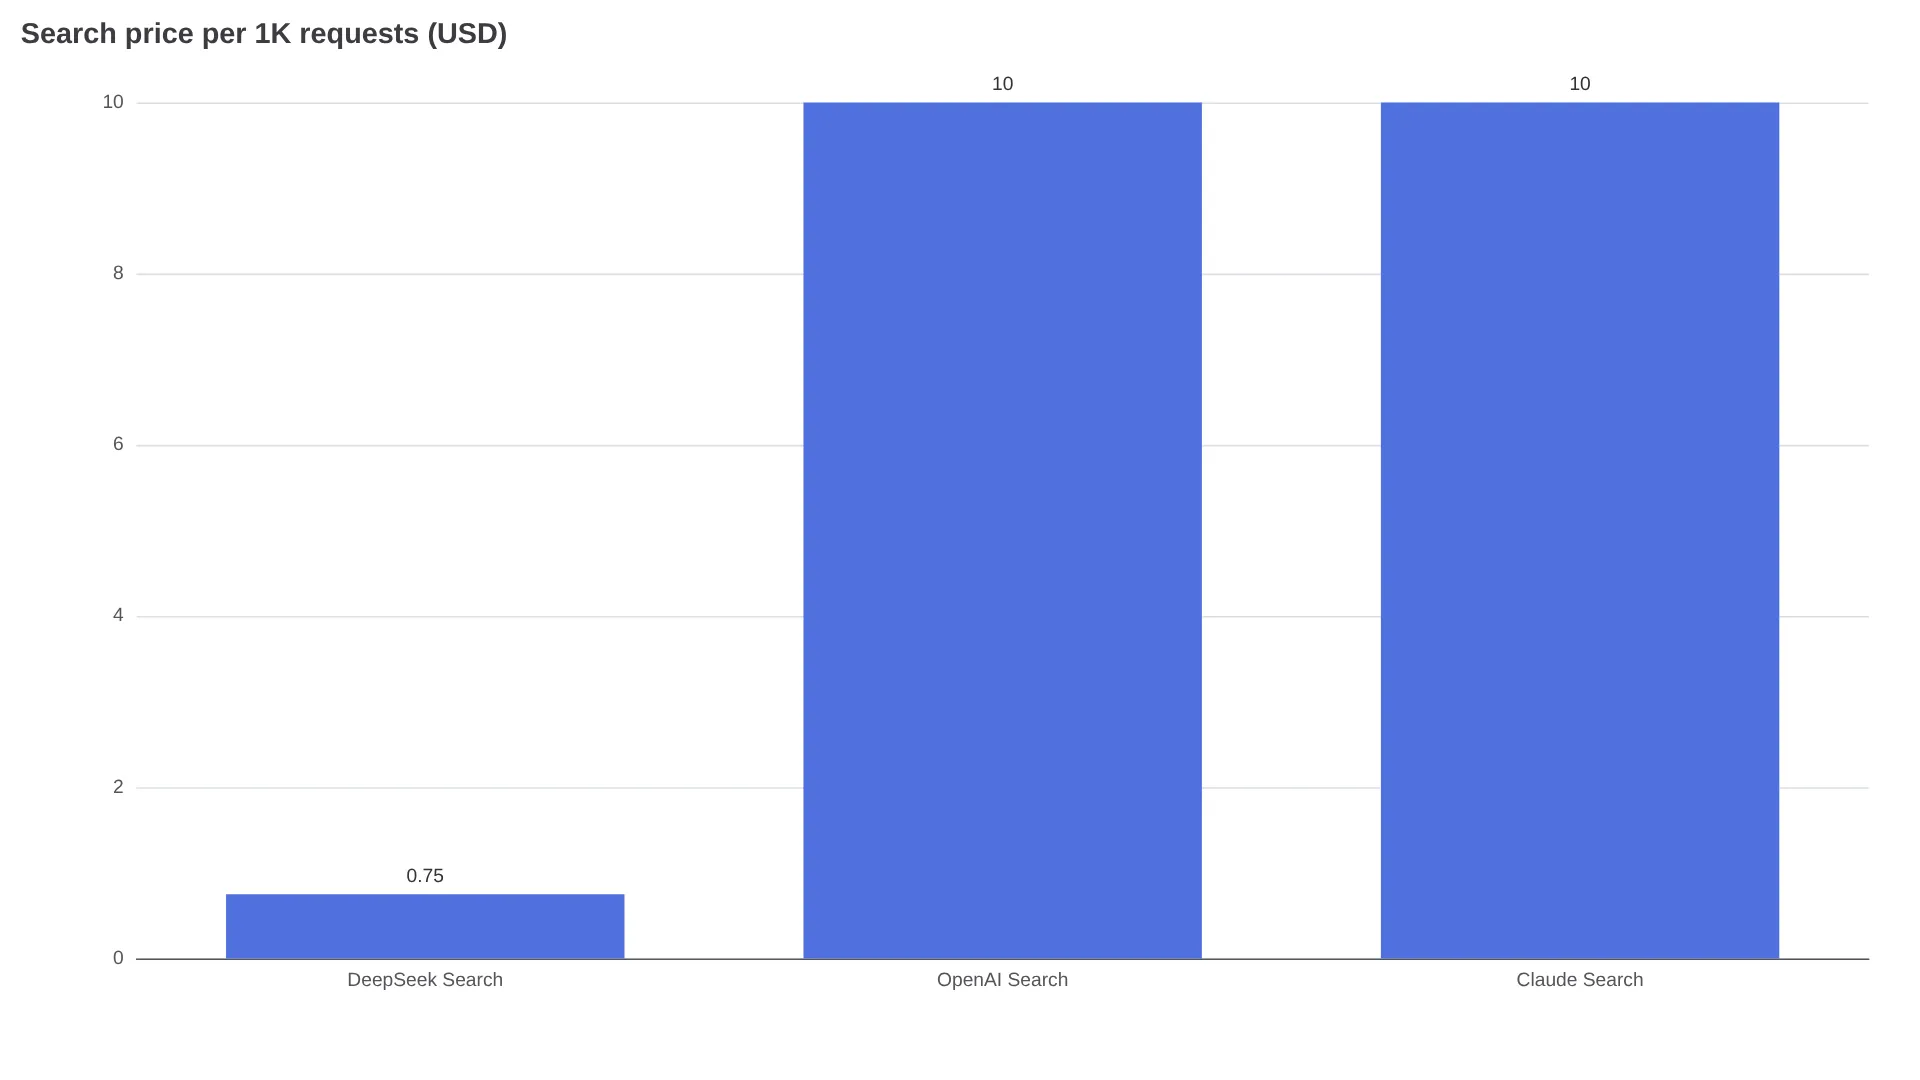
개발자들의 가격 비교에 따르면 DeepSeek 검색은 1,000건당 약 $0.75로, OpenAI와 Claude 검색의 1,000건당 약 $10보다 훨씬 저렴합니다(@berryxia). 도구 요금만 놓고 보면 약 13배 차이입니다.
쿼리 하나로 답을 얻는 요청은 도구 비용이 1센트의 10분의 1보다 적습니다. 추론을 활성화한 작업에서 검색 8회와 페이지 열기 6회가 발생하면 검색 8건과 Fetch 6건으로 계산되며, 토큰 비용을 제외해도 2센트 미만입니다. 다만 에이전트가 검색을 수십 번 반복하면 $0.75 단위가 빠르게 누적됩니다. 성공한 호출 수를 기준으로 예산을 잡고, 심층 검색 깊이를 제한하세요. 마지막 usage object에서 tool_search와 tool_fetch를 기록하는 것도 중요합니다. 여기의 web_search_requests는 화면 표시용일 뿐 실제 과금 건수가 아닙니다.
출시 전 점검: 인용, 안전성, 데모
Web Tools guide에 따르면 인용은 URL, 제목, 인용된 텍스트를 담은 web_search_result_location 블록으로 전달됩니다. 스트리밍에서는 citations_delta 이벤트로 도착하며, 텍스트 블록 하나당 URL은 최대 하나입니다. 이후 요청에 인용 블록을 그대로 다시 넣어도 무시됩니다. 여러 턴에 걸쳐 signature 필드와 도구 블록은 반드시 원문 그대로 보존해야 합니다. 페이지 읽기 결과는 signature를 통해 복원되며, signature가 잘못됐거나 빠져도 요청 자체는 성공하지만 페이지 정보는 제외됩니다. 챗봇 가이드의 예시 추적에서는 도구 사용 전 40개였던 입력 토큰이 도구 실행 후 9,078개로 늘고, 이 중 4,096개는 캐시에서 제공됩니다. 검색으로 불어난 대화 기록까지 고려해 컨텍스트를 설계해야 합니다.
공개 앱을 운영한다면 DeepSeek는 안전성 검사를 요구하지만, 조정 정책과 모델 등록, AI 콘텐츠 표시 책임은 개발자에게 둡니다. 내장 검토 기능은 1차 필터로 활용하고, refusal 중단 사유를 명시적으로 처리해야 합니다. 페이지가 검토를 통과하지 못하면 url_not_allowed가 반환될 수 있으며, 이처럼 차단된 Fetch도 과금됩니다. 채팅 데모는 연결 구조를 보여주지만 모든 처리가 브라우저 안에서 이뤄지므로, 실제 서비스에 적용하기 전에는 자체 백엔드를 구축해야 합니다.
FAQ
모든 요청에서 모델이 반드시 검색하도록 만들 수 있나요?
아니요. 도구를 호출할지는 모델이 결정하며, tool_choice에 웹 도구를 지정하면 400 오류가 반환됩니다.
웹 검색과 파일 업로드를 지원하는 모델과 엔드포인트는 무엇인가요?
Messages, Responses, Chat Completions에서 모두 deepseek-flash를 사용합니다. 파일 file_id 참조는 OpenAI 호환 제품군과 Anthropic 호환 제품군 모두에서 작동합니다.
업로드한 파일과 웹 검색을 함께 사용할 수 있나요?
가능합니다. 문서에 소개된 챗봇 패턴도 파일 컨텍스트와 인용을 포함한 서버 측 검색을 결합하는 방식입니다.
일반적인 에이전트 작업에서는 검색이 몇 번 발생하나요?
간단한 답변이라면 몇 개의 쿼리를 포함한 호출 한 번으로 끝날 수 있습니다. 추론을 활성화한 리서치 작업에서는 도구 호출이 약 20회까지 늘어날 수 있습니다. 작업별로 tool_search와 tool_fetch를 측정하세요. 내장 도구는 쿼리 또는 페이지 단위로, 독립형 API는 성공한 요청 단위로 과금되며 두 방식 모두 1,000건당 $0.75입니다.
먼저 데모에서 내장 검색 요청 한 번과 파일 업로드 한 번을 실행해 보세요. 마지막 usage object의 tool_search와 tool_fetch 카운터를 확인한 뒤, 작업별 도구 비용이 자체 Tavily 또는 SearXNG 계층을 운영하는 것보다 유리한지 판단하면 됩니다.