 AIREITER
27B 파라미터 모델을 스마트폰에서 돌린다는 말은 과장처럼 들리지만, Bonsai 27B는 실제로 iPhone 17 Pro에서 초당 약 11토큰으로 구동된다. PrismML이 Qwen3.6 27B를 삼진 양자화한 이 모델은 최소 3.9GB에 담겼고, 가중치는 Apache 2.0 라이선스로 무료 공개됐다. 삼진 버전은 풀 프리시전 벤치마크 점수의 95% 이상을 유지한다. 다만 성능 보존이 모든 작업에서 고르게 나타나지는 않는다. 수학과 코딩은 원본에 가깝지만, 툴 호출과 비전 성능은 눈에 띄게 떨어진다. 즉, Bonsai 27B는 기기 내 추론과 코드 작업에는 유용하지만 에이전트형 툴 중심 워크플로에는 아직 불안한 모델이다. 이 글에서는 압축 원리와 벤치마크 수치, 네 가지 실행 방법, 그리고 어떤 사용자에게 적합한지 정리한다.
27B 모델을 스마트폰에 넣은 압축 방식
일반적인 FP16 27B 모델은 약 54GB의 메모리를 필요로 한다. 어떤 스마트폰에도 들어갈 수 없는 크기다. Bonsai 27B는 풀 프리시전 가중치를 매우 작은 이산값으로 바꿔 용량을 6GB 아래로 낮췄다.
삼진 버전에서는 모든 가중치가 -1, 0, +1 세 값 중 하나만 갖는다. 이론상 가중치 하나당 약 1.58비트의 정보만 쓰는 셈이다. PrismML은 여기에 그룹별 FP16 스케일링을 더했다. 각 가중치 그룹마다 풀 프리시전 스케일 계수를 저장해, 값이 축소된 뒤에도 적절한 크기를 유지하도록 하는 방식이다. 이 때문에 실제 비용은 가중치당 약 1.71 유효 비트가 된다. 더 공격적인 1비트 바이너리 버전은 0을 없애고 -1과 +1만 사용하며, 약 1.125 유효 비트 수준까지 내려간다.
핵심은 두 가지다. 먼저 임베딩, 어텐션, MLP 블록, 언어 모델 헤드까지 전 구간을 양자화했다. 성능을 떠받치는 풀 프리시전 구성 요소는 남겨두지 않았다. 또 기반 모델은 하이브리드 어텐션 인과 모델인 Qwen3.6 27B(27.8B 파라미터)다. 따라서 Bonsai도 이 모델의 262K 토큰 컨텍스트 윈도와 멀티모달 입력 기능을 물려받는다.
삼진 버전과 1비트 버전, 무엇을 받아야 할까
PrismML은 두 가지 빌드를 제공한다. 선택을 잘못하면 메모리를 불필요하게 쓰거나 품질을 과도하게 포기하게 된다. 기준은 단순하다. 파일이 작을수록 정확도는 낮아진다.
| 빌드 | 가중치당 유효 비트 | 크기 | 유지되는 품질 | 적합한 용도 |
|---|---|---|---|---|
| 삼진 (-1, 0, +1) | ~1.71 | 5.9GB | FP16의 >95% | 데스크톱, 품질이 중요한 작업 |
| 1비트 바이너리 (-1, +1) | ~1.125 | 3.9GB | FP16의 >90% | 스마트폰, 빠듯한 메모리 환경 |
스마트폰에서 실행할 계획이라면 iPhone 17 Pro의 가용 메모리 안에 들어가는 1비트 빌드가 맞다. 여유 있는 노트북이나 데스크톱이라면 2GB를 더 써서 정확도를 몇 포인트 회복하는 삼진 빌드가 낫다. 저장 공간보다 결과 품질이 중요하다면 그 차이는 충분히 감수할 만하다.
벤치마크가 보여주는 강점과 약점
공식 수치는 삼진 빌드 기준이다. 사고 모드 벤치마크 15종에서 평균 80.49를 기록했다. 특히 눈에 띄는 항목은 다음과 같다.
| 벤치마크 | 점수 | 평가 항목 |
|---|---|---|
| MATH-500 | 99.20 | 학교 수준부터 경시대회 수준까지의 수학 |
| AIME 2025 | 90.84 | 고난도 경시 수학 |
| HumanEval+ | 93.90 | 코드 생성 |
| BFCL v3 | 74.41 | 함수/툴 호출 |
수치를 나란히 보면 Bonsai 27B의 성격이 분명해진다. 수학과 코드는 90점대지만 툴 호출은 70점대다. 실제 사용 전에 반드시 이해해야 할 차이이기도 하다. 이 양자화 방식은 추론과 코드 성능은 비교적 잘 지키지만, 에이전트 워크플로가 의존하는 구조화된 다단계 동작은 훨씬 더 크게 손상시킨다.
이 수치는 PrismML이 직접 공개한 결과이므로, 독립 벤치마크가 충분히 쌓이기 전까지는 출발점으로 보는 편이 좋다. 헤드라인용 평균 80.49보다 과제별 점수와 실제 실패 패턴을 확인해야 한다. 초기 테스터들은 삼진 빌드가 간혹 추론 루프에 빠진다고 보고했고, 극단적인 양자화는 단일 과제 점수가 보여주는 것보다 긴 컨텍스트에서의 안정성을 더 약화시키는 경향이 있다. 의존하기 전에는 자신의 프롬프트로 빠르게 검증해 볼 가치가 있다.
실행 속도와 지원 하드웨어
이 정도의 강한 압축은 추론 속도가 실사용 수준이어야 의미가 있다. 성능이 되는 하드웨어에서는 실제로 그렇다. 아래는 PrismML이 공개한 수치다.
| 기기 | 1비트 | 삼진 |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
스마트폰의 초당 11토큰은 폭발적으로 빠른 수준은 아니지만, 채팅과 짧은 추론에는 쓸 만하다. M5 Max에서 87토큰/초라면 네트워크 왕복 시간까지 고려했을 때 짧은 프롬프트에서는 로컬 추론이 클라우드 API 호출보다 빨라질 수 있다. PrismML은 이를 지능 밀도, 즉 GB당 벤치마크 점수로도 설명한다. Bonsai는 약 0.53을 기록하며, 풀 프리시전 기준 모델의 약 10배 수준이다.
Bonsai 27B를 지금 실행하는 네 가지 방법
가중치가 공개돼 있어 단 하나의 설치 경로만 있는 것은 아니다. 설치 없이 바로 써보는 방법부터 세밀하게 제어하는 방법까지, 현재 가능한 네 가지 선택지를 정리했다.
iPhone에서 실행하기
Locally AI iOS 앱에서는 3.9GB 1비트 빌드를 기기에서 직접 실행할 수 있다. 계정도 서버도 필요 없다. 다운로드가 끝나면 완전히 오프라인으로 작동하므로, 이것이야말로 ‘스마트폰에서 27B’라는 약속을 가장 직접적으로 구현하는 경로다.
브라우저에서 체험하기
PrismML은 브라우저 탭 안에서 1비트 모델을 구동하는 WebGPU 커널도 공개했다. 설치 없이 Bonsai 27B를 가장 빠르게 시험해 볼 수 있는 방법이다. 다만 WebGPU를 지원하는 GPU가 탑재된 머신이 필요하다.
내 컴퓨터에서 직접 구동하기
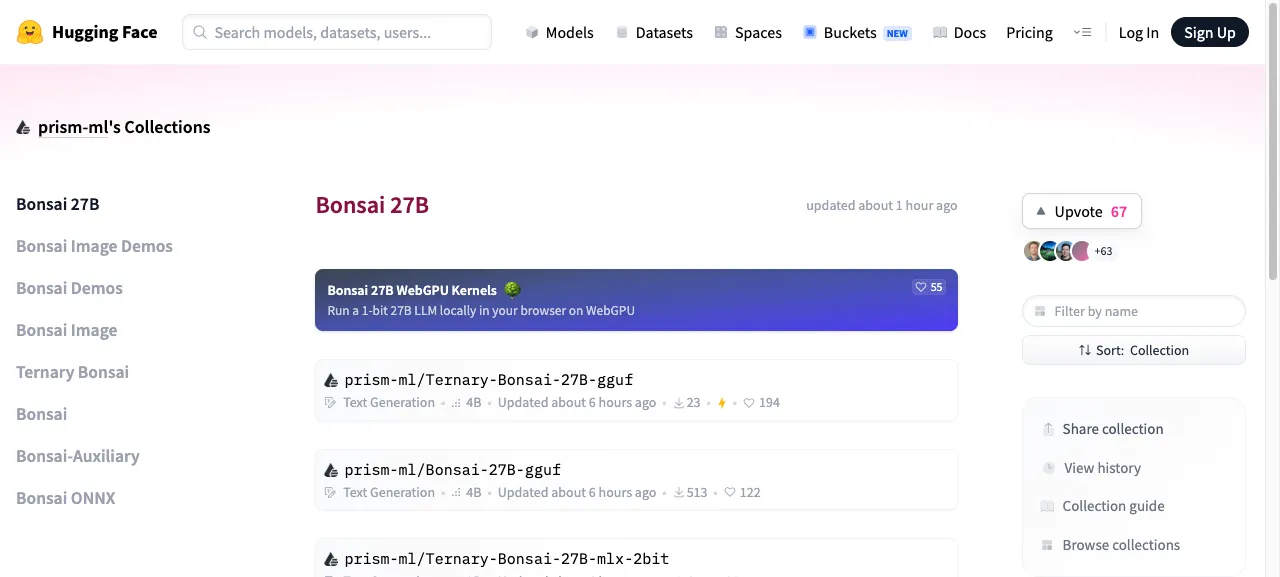
GGUF, MLX, ONNX 가중치는 모두 Hugging Face와 GitHub에서 Apache 2.0 라이선스로 제공된다. 주요 리포지터리는 1비트용 prism-ml/Bonsai-27B-gguf, 삼진용 prism-ml/Ternary-Bonsai-27B-gguf이며, MLX 2비트와 ONNX 빌드도 함께 있다. 1비트 빌드에는 여유 저장 공간과 RAM을 약 4GB, 삼진 빌드에는 약 6GB로 잡으면 된다. 단, 도구 지원은 출시 속도를 아직 따라가지 못하고 있다. 여러 런타임에서 가중치는 불러올 수 있지만, 출시 시점에는 LM Studio 같은 인기 로컬 앱의 완전한 지원이 마련되지 않았다. 일부 수동 설정은 예상하는 편이 좋다.
호스팅 API로 사용하기
가중치를 직접 관리하고 싶지 않다면 Together.ai에서 표준 API로 삼진 빌드를 제공한다. 전체 262K 컨텍스트 윈도, 비전 입력, JSON 모드를 지원한다. 출시 프로모션 기간에는 입력 100만 토큰당 가격이 $0.00로 표시됐지만, 프로모션 가격은 변동될 수 있으므로 예산을 세우기 전에 현재 요금을 확인해야 한다.
Bonsai 27B와 Gemma 4 12B QAT 비교
가장 자주 비교되는 모델은 Google의 양자화 인식 학습 모델인 Gemma 4 12B QAT다. 용량은 약 7GB로 Bonsai의 삼진 빌드보다 조금 클 뿐이다.
두 모델은 서로 다른 축에서 강점을 보인다. 27B 기반 모델인 Bonsai 27B는 수학과 코딩 벤치마크에서 Gemma를 확실히 앞선다. 반면 Gemma는 비전과 툴 호출에서 더 안정적인 경향이 있으며, 조금 더 크고 덜 공격적으로 압축된 가중치 덕분에 스마트폰에서 범용 모델로 쓰기에도 더 무난하다. 기기 내 작업이 추론과 코드 중심이라면 Bonsai가 더 강력한 선택이고, 이미지나 함수 호출 비중이 높다면 Gemma 4 12B QAT가 더 안전하다.
Bonsai 27B가 맞는 사용자
iPhone 17 Pro급 기기나 성능 좋은 노트북에서 오프라인, 프라이빗 환경의 추론 또는 코딩 보조 모델을 원한다면 Bonsai 27B를 고려할 만하다. 극단적 양자화에 관심 있는 사람에게도 흥미로운 연구 대상이다. 27B 모델이 브라우저 탭에서 실행된다는 사실 자체가 중요한 이정표이며, 공개된 Apache 2.0 라이선스 덕분에 실험도 쉽다. 로컬 옵션이 필요할 때는 프로그래밍용으로 실행해 볼 만한 오픈·무료 모델과 함께 자연스럽게 활용할 수 있다.
반대로 신뢰도 높은 툴 호출이 필요한 프로덕션 에이전트 시스템, 비전 품질이 중요한 작업, 추론 루프 실패가 큰 비용으로 이어질 수 있는 용도에는 아직 쓰지 않는 편이 좋다. 이런 경우에는 압축 강도가 낮은 모델이나 API로 제공되는 풀 프리시전 모델이 더 안전한 선택이다.
자주 묻는 질문
Bonsai 27B는 무료로 쓸 수 있나요?
가중치는 Apache 2.0 라이선스로 무료 제공되므로 비용 없이 다운로드하고 실행할 수 있다. Together.ai를 통한 호스팅 접근은 별도 API 요금이 적용된다. 출시 당시 입력 100만 토큰당 $0.00로 표시됐으므로, 현재 요금은 확인하는 것이 좋다.
Bonsai 27B가 정말 스마트폰에서 실행되나요?
그렇다. 1비트 빌드는 3.9GB이며, Locally AI 앱을 통해 iPhone 17 Pro에서 초당 약 11토큰으로 작동한다. 다운로드 후에는 완전한 오프라인 실행도 가능하다.
Bonsai 27B는 풀 프리시전 Qwen3.6 27B와 같은 수준인가요?
가깝지만 동일하지는 않다. 삼진 빌드는 풀 프리시전 벤치마크 성능의 95% 이상, 1비트 빌드는 90% 이상을 유지한다. 성능 보존은 수학과 코드에서 가장 강하고 툴 호출에서 가장 약하다.
어떤 Bonsai 27B 파일을 내려받아야 하나요?
스마트폰이나 메모리가 빠듯한 기기에서는 1비트 빌드(prism-ml/Bonsai-27B-gguf, 약 3.9GB)를 선택하면 된다. 여유 있는 데스크톱이나 GPU 환경에서는 정확도를 몇 포인트 더 얻기 위해 삼진 빌드(prism-ml/Ternary-Bonsai-27B-gguf, 약 5.9GB)를 선택하는 편이 낫다. Apple Silicon과 크로스플랫폼 런타임용으로는 MLX 2비트 및 ONNX 변형도 제공된다.
삼진 양자화란 무엇인가요?
모델 가중치를 풀 프리시전 숫자 대신 -1, 0, +1 세 값 중 하나로 저장하는 방식이다. 모델 크기가 크게 줄어드는 이유가 여기에 있다. FP16 스케일 계수는 이렇게 축소된 가중치가 대체로 적절한 크기를 유지하도록 돕는다.
Bonsai 27B는 이미지를 지원하나요?
그렇다. Qwen3.6 27B 기반 모델의 멀티모달 기능을 이어받아 텍스트와 함께 이미지 입력을 받고 텍스트를 출력한다. 다만 이 압축 방식에서는 비전 품질이 수학이나 코드만큼 잘 유지되지는 않는다.