 AIREITER
TencentのHyra 2.0は、1回限りの問題を解いて終わるのではなく、科学モデルやツールを再利用できる形で作るための研究エージェントシステムです。ただし公開範囲には明確な線引きがあります。エージェント本体はTencent内部にとどまり、外部へ出ているのは成果物の一部です。
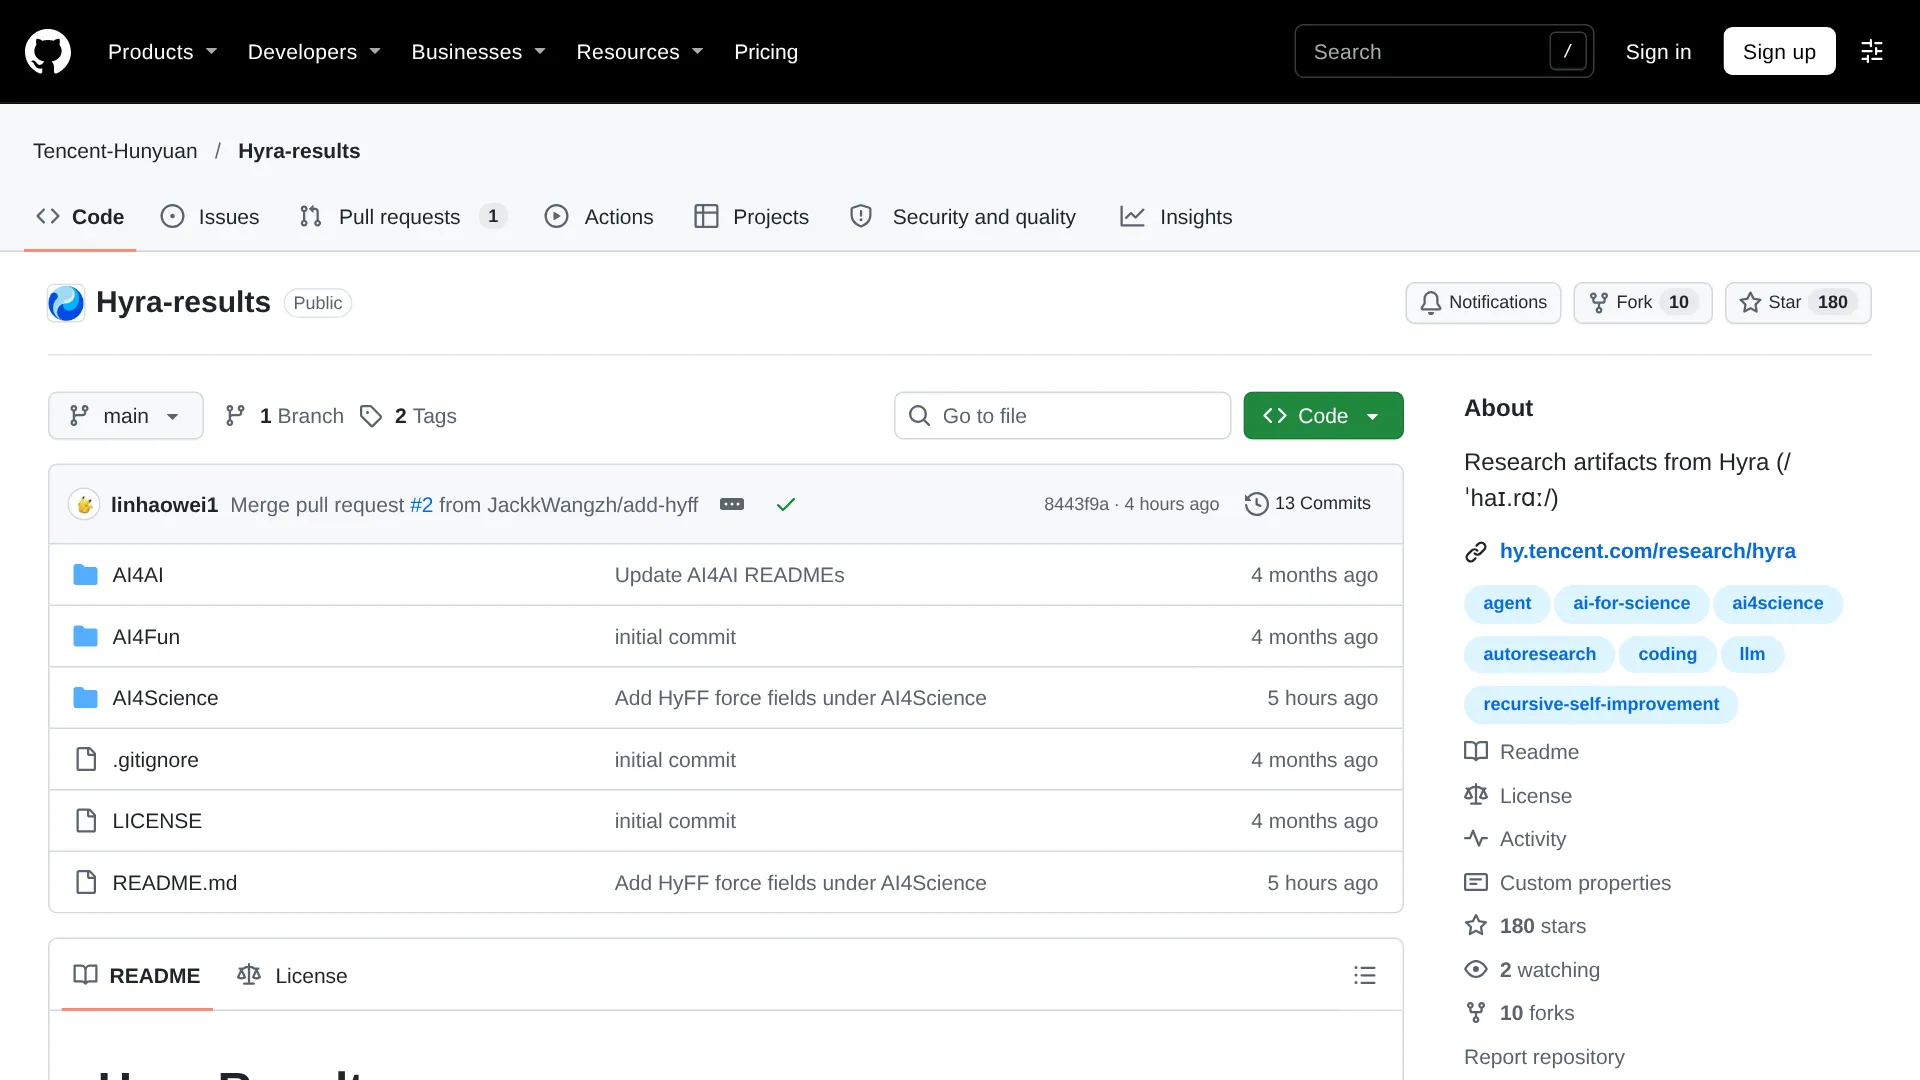
Hyra-results repositoryを見ると、ダウンロードして検証できる成果物と、発表のみで終わっている主張が分けられています。この違いを押さえることが、Hyra 2.0を理解するうえで重要です。
Hyra 2.0は何をするシステムなのか
Hyra 2.0はHunyuan Research Agent 2.0の略称で、Tencent Hunyuanが開発した、科学研究とエンジニアリングを自動化する階層型システムです。一般的なHunyuanチャットモデルとは異なり、再利用できる科学モデル、検証パイプライン、複数ステップのワークフローを生み出すための基盤として位置付けられています。
Tencentの公式X投稿は、2026年11月2日にHyra 2.0を「Hunyuan Research Agentの次なる進化」と紹介し、「問題を解く」段階から「再利用可能なツール、モデル、ワークフローを構築する」段階への移行だと説明しました。公開されているHyra-results repositoryには、完全なオーケストレーションシステムではなく、出力成果物と一部の学習済みモデルが置かれています。発表やリポジトリには、公開デモ、インストールパッケージ、API、価格、利用枠も記載されていません。Hyra 2.0を研究室そのもの、公開済みのHyInvやHyPLM-Flashのタンパク質モデルを、そこから生まれた標本だと考えると分かりやすいでしょう。
数日から数週間の研究を継続させるエージェント構成
Hyra 2.0は、3層のエージェント、永続ストレージ、独立したレビュー工程を組み合わせ、長期の研究プロジェクトを管理します。IT之家のローンチ記事はTencent Hunyuanの公式WeChatアカウントを引用し、実験を数日から数週間続けても文脈を失わないOverall・Mission・Workerの役割分担を伝えています。
Overallエージェントは人間の研究者と対話し、目標をすり合わせ、計算予算を配分します。Missionエージェントは研究テーマごとに責任を持ち、実験方針を選び、結論に対して説明責任を負います。Workerエージェントはコードを読み、実際に実験を走らせ、失敗を分析します。Missionエージェントの判断に異議を唱えることもでき、異なるベースモデルを使う複数のWorkerが並列で動作します。
その下支えとなる永続化の仕組みは3つです。
- プロジェクト状態:研究プログラムの進行地点を記録し、永続キューによって中断後もタスクを継続できるようにします。
- 階層型エージェントメモリ:短期的な観察と長期的な知見を分け、すべてを単一のコンテキストウィンドウへ詰め込む方法を避けます。
- Shared Books:単発実行での観察、再現済みの発見、人間が確認した慣行といった証拠の強さを区別して知識を保存します。別の案件にも転用できると分かった手法は、小さな再利用可能なskillsとして切り出され、後続の実行で使われます。
設計を締めるガードレールも2つあります。すべての結論には具体的なログとコードバージョンが紐付けられ、人間へ渡る前に、別のレビューWorkerが新しい出発点から主張を再検討します。Eyerysの技術解説によると、大規模な計算ジョブには引き続き人間の承認が必要で、システムは企業向けメッセージング、ジョブ投入プラットフォーム、コードリポジトリなど一般的な研究インフラとも接続します。
この検証にはコストが伴います。ある実務家は、Worker同士が互いのセッションを確認する仕組みにより、トークンコストが大幅に上がる可能性を指摘しています(@d6355v)。Tencentはトークン予算、計算コスト、失敗率、独立レビューがエラーを見つける頻度を公表していません。したがって、このアーキテクチャは長期的な信頼性を目指す設計として見るべきであり、運用コストはなお不明です。
Hyra 2.0が実際に公開した成果物
Hyra 2.0の公開根拠は、大きく2種類に分かれます。重みやコードをダウンロードできる成果物と、Tencentが報告したものの外部再現を待つ結果です。表内のリンクはいずれも確認可能なソースに接続しています。
| 成果物 | 内容 | 主な数値 | 証拠の状態 |
|---|---|---|---|
| HyInv | 196万パラメータのタンパク質逆フォールディングモデル。重みは7.8 MB、CLIとPython APIを提供 | TSNのレビューによると、ProteinMPNNより生成が約57倍高速。148残基のタンパク質で25 ms対約1秒、1x H20 GPU | 成果物は検査可能(MIT)。ベンチマークは実行可能。ただし主張される結果の独立再現は未実施 |
| HyPLM-Flash | 6億5000万パラメータのマスク型タンパク質言語モデル。重みは2.6 GB、INT8エンジンを搭載 | TSNのレビューによると、1x H20で毎秒約130,000残基。Tencentの12モデル・35タスク試験で推論速度最速、平均順位は3位。ProteinGym Spearmanは0.409で、ESM-2 650Mクラスと同率 | 成果物は検査可能(MIT)。CUDA GPUが必要。2つの評価はモデル数とタスク数が異なる |
| HyFF | 5つのML力場(Presto、Vivace、Moderato、Andante、Largo)。230万~12億パラメータ、83元素に対応 | Largoのエネルギー誤差は0.364 meV/atomで、DPA4-Proの0.380に対し9.7倍高速。Andanteは2,586原子のMDでUMA-S-1.2の29倍の速度、1x H20 | hyffパッケージ付きで成果物を検査可能(Apache-2.0)。速度は1台のH20による特定ワークロードにひも付く |
| Petty conjecture dim-5 | 5次元の実ノルム空間すべてに6個の等距離点が存在することを示した証明成果物。従来の最良結果は4次元、Makeev 2005。repository indexより | 5次元の場合を解決 | 論文は検査可能。ジャーナル査読は報告されていない |
| Yau circle-action | 閉7次元多様体で、正の断面曲率を持ち、有効な円周作用を持たない反例を主張。repository indexより | 制限なしのケースを解決。単連結の場合は未解決 | 論文は検査可能。ジャーナル査読は報告されていない |
| HyQEC | Prompt Blueprintsによると、qLDPC Challengeの系譜から生まれた量子誤り訂正コード | 従来の首位モデルより符号化効率が約48%高い | 発表済み。完全な成果物はGitHubで公開待ち |
| XiangShan RISC-V | Prompt Blueprintsによるオープンソースプロセッサの最適化 | GHzあたりのスコアが+5.79%、面積増加は最小限。マルチコアのバグも修正 | 発表済み。ベンチマーク名と比較ベースラインは非公開 |
| Robotic hand | Eyerysによると、指の長さに段階差を持たせた5指ロボットハンド | 固定予算のシミュレーションで物体回転速度が+28.6% | 発表済み。現時点ではシミュレーションのみ |
Hyra 1.0と比べた際の変化は、「答え」から「資産」への移行です。Hyra 1.0は反復ループの有効性を示しました。sums_diffsエントリーでは組合せ論の定数を1.14489から1.21079へ改善し、Tencentは50年来の加法的組合せ論の問題に前進をもたらしたとしています。Prompt Blueprintsのローンチ分析によれば、Hyra 2.0はこの反復エンジンを維持しつつ、成功を再利用可能にするための階層構造、永続プロジェクト、skills抽出を追加しました。
今すぐ動かせるものと、Tencent内部に残るもの
Hyra 2.0が生んだ成果物は実行できますが、オーケストレーター本体を一般ユーザーがインストールすることはできません。Hyra-results repositoryはApache-2.0ライセンスで公開されており、各結果フォルダには最終成果物と再現スクリプトを含めることが目標とされています。まずは以下から始めます。
git clone https://github.com/Tencent-Hunyuan/Hyra-results.git
ls AI4Science/hyinv
次に、用途に応じて1つ選びます。
- HyInv(最も試しやすい):
AI4Science/hyinvを開くと、重み、推論コード、技術レポートを確認できます。リファレンス実行はCPUとGPUの両方に対応しますが、高速なBF16パスはHopper世代GPUでのみ検証されています。 - HyPLM-Flash(CUDAが必要):
AI4Science/hyplm_flashを開き、weights/download.shを実行して2.6 GBの重みを取得、結合、検証します。H20/H100クラスのGPUを見込んでください。表現抽出にはINT8、細かな変異体回帰にはBF16を使います。 - HyFF(公称速度にはH20が必要):HyFFセクションでは、5つの力場モデル(各9 MB~4.8 GB)と、単一構造、バッチ処理、NVE/NVT/NPT分子動力学をサポートする
hyffパッケージを利用できます。
非公開のままなのは、Overall/Mission/Workerオーケストレーター、プロンプト、スケジューラー、評価器、Books/skillsストアです。大規模計算ジョブには人間の承認ゲートがあるため、リソース配分まで含めて完全自律しているわけでもありません。要するに、エージェント自体はインストールできず、最も試しやすい成果物は7.8 MBのダウンロードで済むHyInvです。TSNも、同一バックボーン上でHyInvとProteinMPNNを直接比較するセットアップは低コストだと述べています。
注目の性能値はどこまで信頼できるか
TSNの報道によると、2026年11月2日時点で、性能値はすべてTencentまたはモデル文書に由来し、独立した再現結果は公開されていません。数値を見る際は、必ず比較条件とセットで読む必要があります。
まず、速度は品質ではありません。HyInvの57倍は、1台のNvidia H20上での生成スループット比較です。148残基で約25 ms対約1秒、402残基で54 ms対2.6秒という値であり、ウェットラボでの成功率を示すものではありません。構造類似性も予測構造に対して採点されており、ウェットラボ検証は報告されていません。
ProteinMPNNの57倍、毎秒約2,500デザインはスループットであって、デザイン品質ではない。次に見たいのは自己整合性RMSDと配列回復率だ。逆フォールディングがボトルネックになることは、そもそもほとんどない。その後のリフォールド工程こそが重要だ。
次に、効率の主張にはハードウェアと対象範囲が必要です。HyPLM-Flashの「12モデル中で最速」は、Tencentブログにある12モデル・35タスクの評価を指します。一方、リポジトリの条件をそろえた評価は28チェックポイント・32タスクを対象としており、ProteinGymのゼロショットSpearmanは0.409です。これはESM-2 650M、ESM C 600M、E1-600Mと統計的に同等とされています。HyFFの29倍と9.7倍も、1台のH20上における2,586原子システムの値です。またAndanteの力誤差は7.65 meV/Åで、UMA-S-1.2の7.55 meV/Åよりわずかに悪い結果です。精度がほぼ同等の条件で速度を伸ばしたのであって、全面的な優位を示す結果ではありません。
3つ目に、2.0の中核である再利用は、まだ証明されていません。ローンチ資料では、生成されたskillを再利用前にどう検証するのか、誰が承認するのか、プロジェクト横断で再利用を測定したのかが明かされていません。
一回限りの回答ではなく、再利用可能なツールを作る方向性は正しい。多くのエージェント実行では、タスクが終わった時点で得た知見がすべて捨てられてしまう。Hyraがどのようにして、ツールを保持・再利用するに足るものだと判断するのかが気になる。
別の実務家も、人間参加型の観点から同じ検証上の疑問を投げかけています(@ModelPlaneHQ)。Tencentのローンチ資料や上記の第三者レビューには、GoogleのAI Co-ScientistやSakana AI Scientistなどの競合と直接比較したベンチマークは掲載されていません。現時点での順位付けは、Tencent自身の数値に依存することになります。エージェントが構築したモデルを評価するなら、少なくとも4点を確認すべきです。どのハードウェアで動かしたのか、どの品質設定なのか、誰が再現したのか、どこで再利用されたのかです。
FAQ
Hyra 2.0はオープンソースですか? 試せますか?
フレームワークは非公開ですが、成果物は公開されています。エージェントの公開デモ、API、インストール手段はありません。HyInvとHyPLM-FlashのモデルパッケージはMITライセンスで、HyFFはリポジトリのApache-2.0条件に従います。各フォルダのREADMEとライセンスを確認してください。
Hyra 2.0はHyra 1.0と何が違いますか?
Hyra 1.0は、長く未解決だった組合せ論の結果を含む、反復的な問題解決に重点を置いていました。Hyra 2.0ではOverall/Mission/Workerの階層、永続的なプロジェクト状態、Booksによる知識管理、skills抽出が加わり、再利用可能なモデルやワークフローを作ることが明確な目標になっています。
数学の結果は査読されていますか?
ジャーナル論文としての査読はまだ報告されていません。Pettyの5次元結果とYau反例の論文は公開され、内容を検査できます。また、repository indexには、先行する有限コアの3つの結果(Beurling-Ahlfors、partial Hadamard、commutator)についてLean 4による形式化が記録されています。いずれも専門家によるレビューを待つ主張として扱うべきです。
タンパク質モデルを再現するには、どのようなハードウェアが必要ですか?
HyInvのリファレンスパスはCPUとGPUで動作し、ダウンロード容量は7.8 MBです。HyPLM-Flashの2.6 GB INT8エンジンにはCUDA GPUが必要で、H20/H100クラスが推奨されています。HyFFの速度値は1台のH20を前提としています。
Hyra 2.0を過大評価せずに見るポイント
Hyra 2.0は、科学的進歩の単位を「答え」ではなく「ツール」に置く考え方に賭けています。Tencentが智能复利と表現するように、再利用可能なskillsを積み重ねて知能の複利を生む構想です。ローンチ時点で、システムに由来するとされるモデルやツールは公開されました。しかし、それらが後続の研究を繰り返し加速できるかどうかは、再利用率、検証コスト、独立再現の結果が速度記録と並んで公開されるまで測定されていません。