 AIREITER
30Bの密モデルを自宅のGPUでどこまで使えるのか。2026年8月10日にMetaが公開したMuse Glimmerを、ローカルAIコミュニティはすぐさま検証し始めた。結論から言うと、フル262KコンテキストでもRTX 3090 1枚に収まり、DFlash使用時のRTX 5090では236 tok/sに達する。ただしTerminalBench 2.1ではQwen 3.6 27Bより9ポイント低く、OSレベルの自動化タスクを拒否しやすい傾向もある。
Muse Glimmer 30Bとは何か
Muse Glimmerは、Meta Superintelligence LabsがApache 2.0ライセンスで公開した、パラメータ数30Bの密なマルチモーダルモデルだ。コーディングベンチマークの首位を狙うためではなく、ローカル常駐型のエージェントワークフロー向けに設計されている。27.9Bのテキストデコーダー、1.9BのViTビジョンエンコーダー、GELUベースのマルチモーダルプロジェクターを組み合わせ、テキストと画像の両方を扱える。以下のアーキテクチャ情報はSGLangのDay-0サポートブログに基づく。
アーキテクチャの要点
| 仕様 | 詳細 |
|---|---|
| 総パラメータ数 | 30B |
| テキストデコーダー | 27.9B dense |
| ビジョンエンコーダー | 1.9B ViT |
| Transformerレイヤー | 52 |
| Attention | Grouped-query(32クエリヘッド、2 KVヘッド - 16:1 GQA) |
| フィードフォワード | SwiGLU |
| コンテキストウィンドウ | 128K+(262Kまでテスト済み) |
| ライセンス | Apache 2.0 |
アテンションにはハイブリッド構成を採用している。2,048トークンのスライディングウィンドウアテンションを3層重ね、4層目ごとにフルシーケンスアテンションを置く設計だ。ローカルウィンドウ層ではRoPE、フルアテンション層ではNoPEを使い分け、学習時の上限を超えるコンテキスト拡張を可能にしている。16:1のGrouped-query attentionによりKVキャッシュも小さい。コミュニティによる計測では、F16で131Kトークンあたり約1.8 GiBだった。同じF16構成ではQwen 3.6 27Bが70Kトークンで頭打ちになる24 GB GPUでも、Muse Glimmerがフルレングスのコンテキストを保持できる理由はここにある。
手元のハードウェアで動かせる?
必要なVRAMは量子化形式によって大きく変わる。SGLangはBF16、NVFP4+MXFP8、GGUF Q4_K_M、GGUF Q4K-Dynamic、MLX 4-bitの公式チェックポイントを提供している。VRAMを極力抑えたい用途では、コミュニティが2-bit GGUFまで圧縮した例もある。
構成別のVRAM目安
| 構成 | VRAMの目安 | 想定ハードウェア |
|---|---|---|
| BF16 | ~60 GB | H100 1枚 |
| NVFP4 + MXFP8 | ~19.5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + 262K context | ~22-23 GB | RTX 3090(24 GB) |
| 2-bit GGUF | ~14 GB | RTX 4060 Ti / エントリー向け |
| MLX Q4(Apple Silicon) | ユニファイドメモリ | Mac mini / MacBook Pro |
あるRedditユーザーは検証で、Q4_K_XL版Muse GlimmerにDFlash投機デコーディング、マルチモーダル用projectionファイル、F16 KVキャッシュを組み合わせても、RTX 3090 1枚の22〜23 GBに余裕を持って収まることを示した。262,144トークンのフルコンテキストを有効にした状態で、約150Kトークンのヘイスタックから2本のneedleを初回で取得している。
比較すると、同じRTX 3090でF16 KVキャッシュを使ったQwen 3.6 27Bは70Kトークンまで、Q8 KVキャッシュなら125Kまでとなる。Gemma 4 31BはF16で52K、Q8で81Kだ。Muse Glimmerが同一ハードウェアでより長いコンテキストを保持できる主因は、16:1 GQAによるKVキャッシュ効率にある。
導入ルート:NVIDIAではSGLangまたはllama.cppを使い、NVFP4またはGGUFのチェックポイントを選んで--speculative-algorithm DFLASHを有効にする。Apple SiliconではMLXバックエンドを利用する。DFlashは利用できない。96 GBユニファイドメモリ搭載のM3 Maxユーザーは17 tokens/sを報告しており、この環境ではQwenとGemmaのどちらよりもMuse Glimmerが速かったとしている。
Muse Glimmerの実行速度
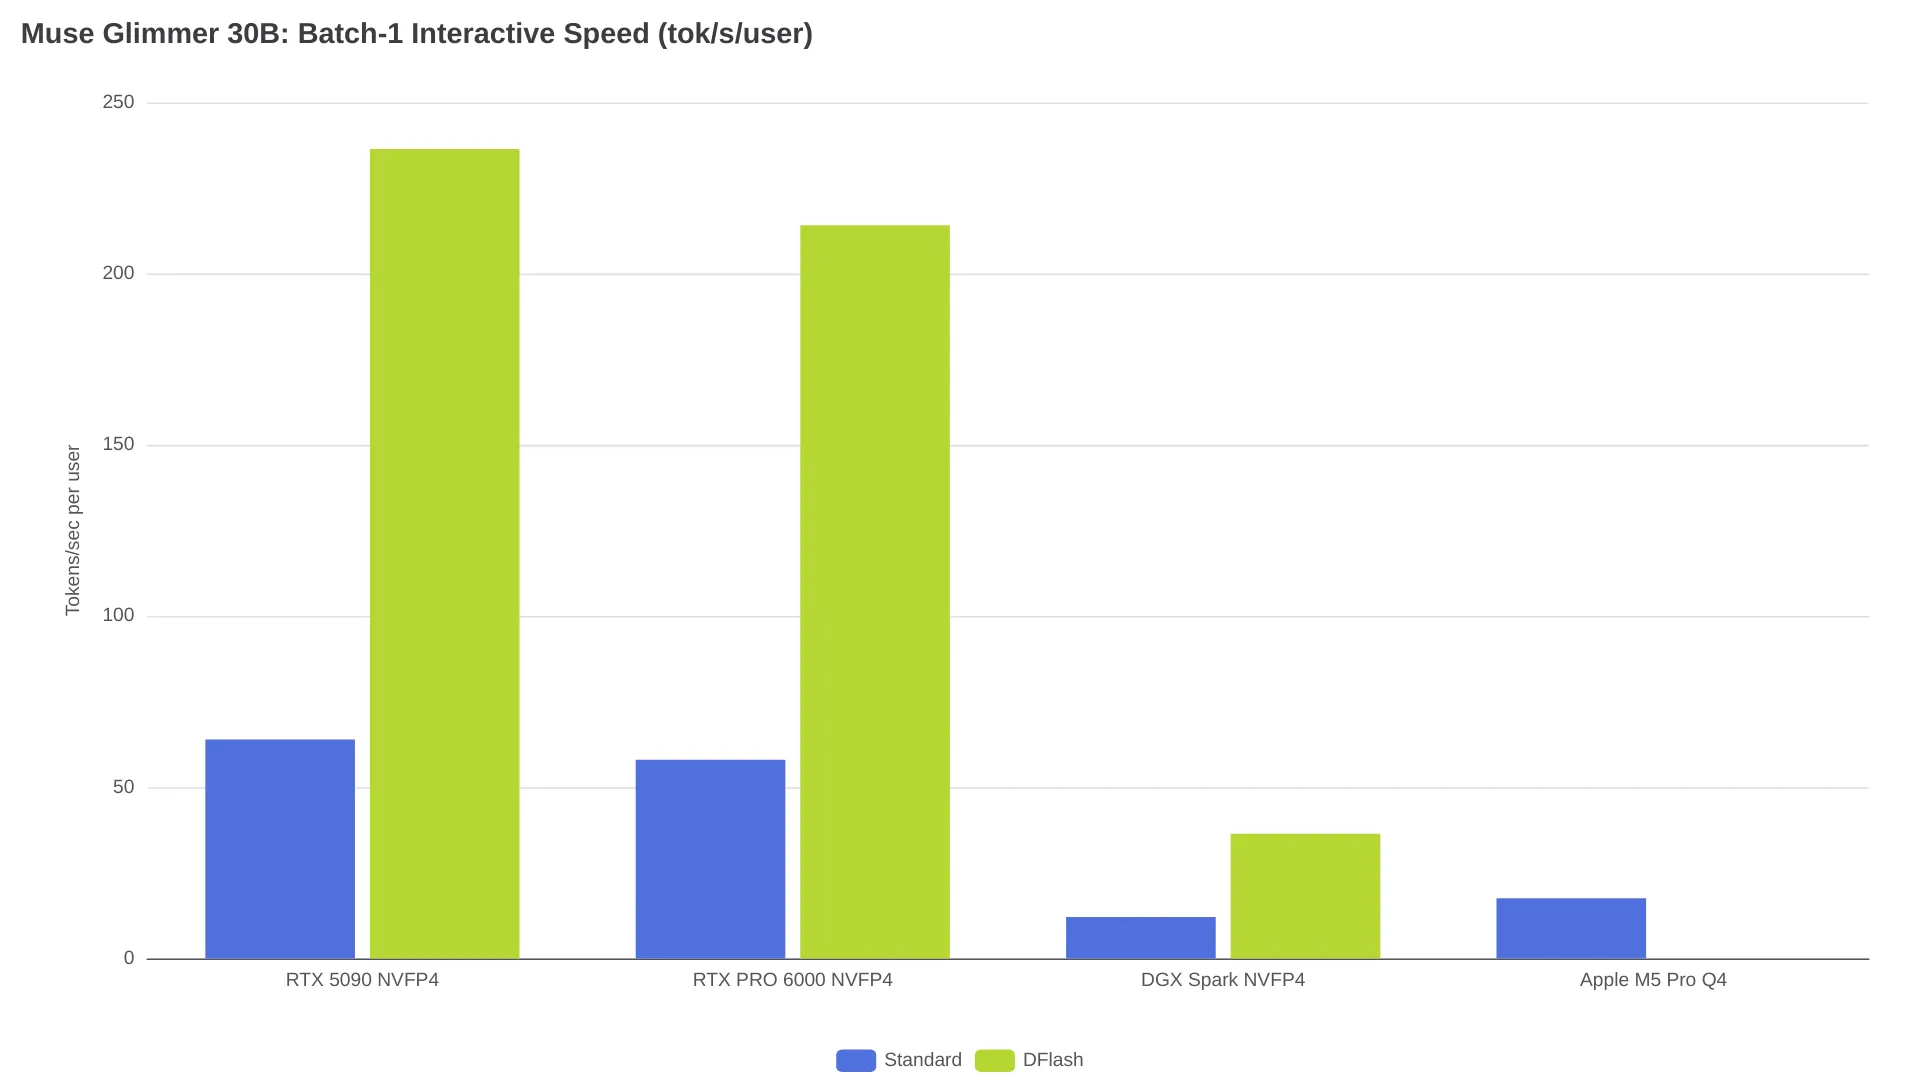
SGLangは、7種類のハードウェア構成でバッチサイズ1〜8を測定したベンチマークを公開している。--speculative-algorithm DFLASHで有効にするDFlash投機デコーディングは、NVIDIA環境におけるバッチ1の対話型スループットを1.9〜4.3倍に引き上げる。
SGLangベンチマークの主要数値
| プラットフォーム | 精度 | デコーディング | バッチ1 tok/s/user | バッチ8 tok/s |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Standard | 17.6 | 56.9 |
RTX 5090でバッチ8時に出る1,452 output tokens/sは合計スループットだ。単一ユーザーのローカル推論で見るべき数値は、NVFP4+DFlashにおける236 tok/sになる。DFlashを使わない場合、同じ構成は63.9 tok/sまで下がる。コミュニティ報告もおおむね一致しており、UnslothのQ5_K_M量子化を使ったRTX 5090ユーザーは220〜253 tokens/sを記録している。
DFlashの性能はドラフト受理率に左右される。Vulkan/RX 7900 XTXおよびSYCL/B70のユーザーは、どちらもドラフト受理率が低く、トータルのスループットも遅かったと報告している。
Muse GlimmerとQwen 3.6 27B、選ぶべきなのはどちらか
TerminalBench 2.1のスコア比較
| モデル | TerminalBench 2.1 | RTX 3090でのコンテキスト(F16 KV) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K tokens |
| Muse Glimmer 30B | 51.7 | ~262K tokens |
| Gemma 4 31B | 43.4 | ~52K tokens |
TerminalBench 2.1のスコアはコミュニティの議論から引用。コンテキスト値はRTX 3090でのテストに基づく。
長いタスクにわたり信頼できるターミナルコマンドを実行できるかを測るうえで、多くのコミュニティメンバーが重視するTerminalBench 2.1では、Qwen 3.6 27Bが9ポイント先行する。直接的なコーディングテストでも差は一貫している。あるユーザーの非公開評価スイートではQwenが12/13、Glimmerが11/13だった。またQwenは953行の東京観光ページを初回で正しく生成した一方、Glimmerの出力は200行未満だった(全スレッド)。
「Qwen 3.6 27Bにはまったく及ばない」 - Glimmerが21,000トークンを消費して8ボールプールゲーム用HTMLを220行しか生成できなかった後のRedditユーザーBarberIcy366のコメント(r/LocalLLaMA)。同じスレッドには、MTP有効時のQwen 3.6 27BがTetris実装を1.7倍速く完了したという報告もある。
ただし、Glimmerには明確な強みもある。
- コンテキスト容量:同じF16 KV設定なら、RTX 3090 1枚で262K tokens。Qwenの70Kに対して、大規模コードベースの作業では3.7倍の余裕がある。
- KVキャッシュ効率:16:1 GQAによりKVキャッシュが大幅に小さく、コンテキストに回せるVRAMを多く確保できる。
- 画像対応:Glimmerは最初からマルチモーダルモデル。Qwen 3.6 27Bのベースモデルはテキスト専用だ。
- MCPとツールQ&A:あるユーザーは、ターミナルでのコーディングではGlimmerがQwenに劣る一方、MCPを使ったコードベース検索や質問応答のワークフローでは有望だと報告している。
- 文章品質:自然言語の出力はQwenよりGlimmerのほうが好みだとするユーザーが複数いる。
あるコメントは、このトレードオフを「Qwen 3.6 27Bに文章スタイルを5%足し、エージェント能力を5%引いたもの」と要約している。
結論
主な用途が一発で完結するコーディング、または自律型ターミナルエージェントなら、Qwen 3.6 27Bが依然として有力だ。TerminalBench 2.1で9ポイント高く、Glimmerに見られるOSレベル自動化への安全上の拒否も起こさない。コンシューマーGPU 1枚で長文コンテキスト検索、マルチモーダル入力、MCP支援ワークフローを必要とするなら、Muse Glimmerを試す価値がある。信頼性の高いターミナル自動化が必要なら、コミュニティ製ファインチューンを待ちたい。
既知の問題と注意点
max_tokens不足に注意
Muse Glimmerは出力を始める前の内部推論に、トークン予算のかなりの部分を使う。max_tokensを低く設定しすぎると、思考途中で予算を使い切り、空のレスポンスを返す場合がある。あるユーザーは当初、自身の評価スイートでGlimmerを6/13と評価していたが、出力トークン予算を増やすと11/13まで上がった(元スレッド)。推論のオーバーヘッドを見込んでmax_tokensを十分高く設定しないと、応答が思考途中で終わるおそれがある。
OSレベル自動化への安全拒否
マウス操作、キーボード自動化、その他のOSレベルのツール呼び出しを伴うタスクを、Muse Glimmerが拒否するという報告が複数ある。一般的なPythonライブラリを使う依頼であっても、潜在的なセキュリティリスクとして扱うようだ。
「マウスをプログラムで動かす行為は、自動化、クリックジャッキング、セキュリティプロンプトの回避に悪用される可能性があります。」 - RedditユーザーCold_Tree190が報告したMuse Glimmerの拒否応答(r/LocalLLaMA)
想定用途についてより多くの文脈を与えた新しいセッションなら、拒否を解消できる場合がある。ただし、いったん拒否したセッション内では、その立場を維持しがちなようだ。
ツール呼び出しの安定性にばらつき
ツール呼び出しの信頼性に関するコミュニティ報告は、Cコードベースで「一度も失敗していない」というものから、無限ループや空のAPIレスポンスに陥るというものまで幅がある。一部構成では、Unsloth Q4およびQ5量子化版がツール呼び出し中に頻繁にループしたと報告された。一方、24 GBおよび32 GB VRAM向けの公式GGUFは、より安定して動く可能性がある(元スレッド)。
地域によるダウンロード制限
公式Hugging Faceページでは、香港、マカオ、中国からのダウンロードが無効化されていると報告されている。代替手段として、UnslothによるサードパーティのGGUF配布は引き続き利用できる。
関連記事:Muse Spark 1.2 API料金ガイド | 2026年版:プログラミング向け無料OpenRouterモデル