 AIREITER
2026年8月19日、Liquid AIはLFM2.5-2.6Bのリポジトリに、従来版と並ぶもう1つの1.59 GB版Q4_0ファイルを追加した。サイズは同じ、名前もほぼ同じだが、中身は大きく異なる。新しい方はQAD(quantization-aware distillation)版で、4ビット量子化で失われがちな性能を学習段階で補う。保持率の数値も良好だ。ただし、この2ファイルを取り違えると、補正されていない従来版を動かすことになる。
QADは4ビット量子化のどこを補うのか
QADはquantization-aware distillation、つまり量子化を意識した蒸留のことだ。Liquid AIはLFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct、LFM2.5-2.6Bの4モデルについて、Q4_0への丸め込みを前提に学習を実施した。学習中は高精度の教師モデルが量子化済みの生徒モデルを蒸留し、重みが量子化誤差を見越して適応する。
同じリポジトリに残っている旧Q4_0ファイルは、学習済みBF16モデルを後から丸めるだけのPTQ(post-training quantization)だ。量子化による誤差を補正する工程はない。Liquid AIのリリース記事によれば、4つのQADチェックポイントはいずれも、推論、指示追従、ツール利用、エージェント的な挙動を含むベンチマーク群において、「BF16平均値のおよそ97%に到達」したという。数値は5回実行の平均だ。QADは新しいファイル形式ではなく、学習側の改善である。出力は従来どおり、llama.cppで実行できる標準GGUF Q4_0だ。
同名に近いファイルを避ける:正しい指定方法
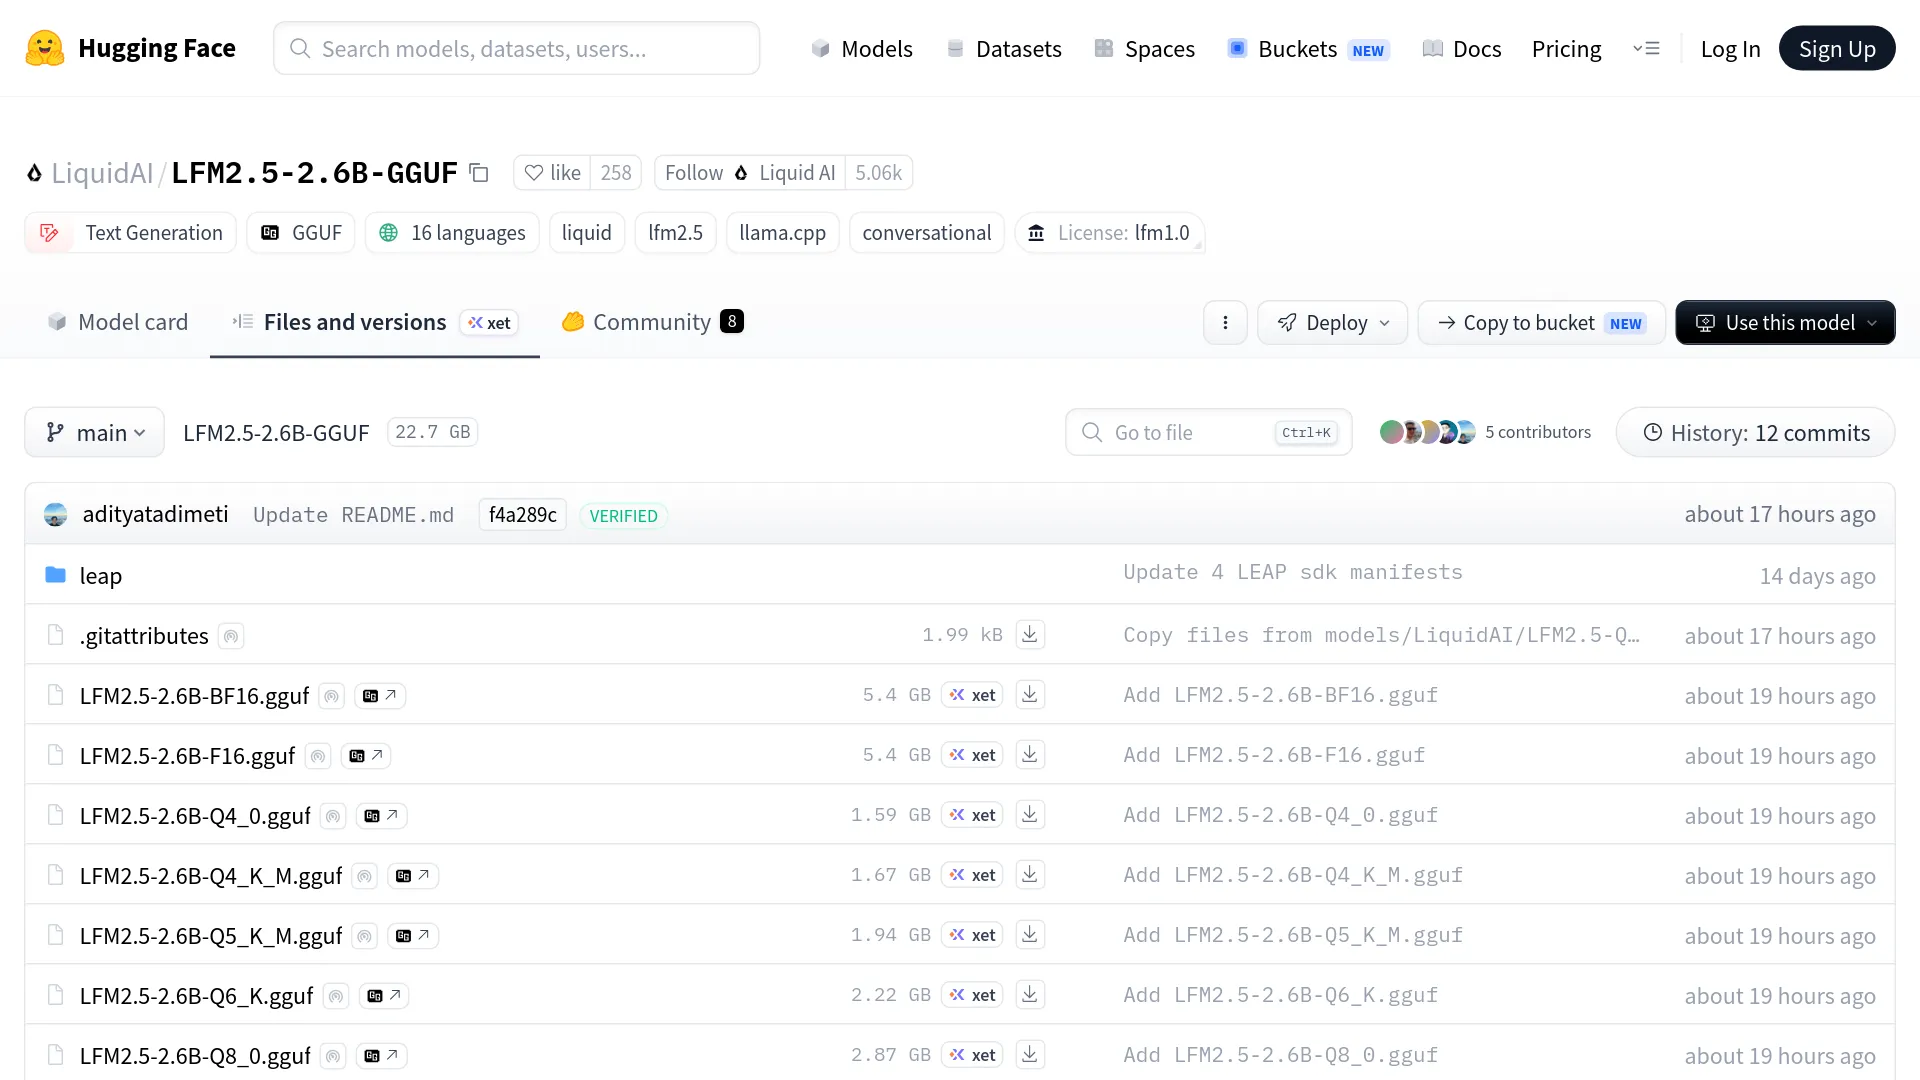
LFM2.5-2.6Bのリポジトリには、LFM2.5-2.6B-Q4_0.ggufとLFM2.5-2.6B-QAD-Q4_0.ggufの両方があり、どちらも表示サイズは1.59 GBだ。さらに、リポジトリのデフォルト例はQADではなくQ4_K_Mを参照している。そのままコピー&ペーストしても、QAD版は取得されない。ファイル名を明示する必要がある。
リリースから数時間以内に、この分かりにくさは話題になった。
「どこからダウンロードすればいいですか? Hugging Faceには見えていますが、通常版なのかQADなのか分かりません。教えてもらえますか?」 - Xの@Chitacc72
初期ユーザーの1人である@MarMarLabsはリポジトリ内のファイルを比較し、旧版と新版のQ4_0は約4 KBしか違わないと報告した。ファイルブラウザ上では見分けがつかない。対策は、--hf-fileでQADの正確なファイル名を指定することだ。
# Liquid AIのリリース記事にある公式例
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"

# 2.6B向け。サンプリング設定は公式モデルカードに準拠
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
-c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1230Mおよび1.2B-Instructのリポジトリでも、使うべき指定パターンは同じだ。サーバー用途では、HFが自動生成するコマンドが不完全だったことを受け、@nicolasembletonが動作する短縮記法を投稿している。llama serve -hf LiquidAI/LFM2.5-2.6B-GGUF:QAD-Q4_0だ。コロンの後ろに付く修飾子がQADビルドを選択する。
公式ベンチマークが示すこと、示していないこと
Liquid AIのベンチマーク表では、各QADチェックポイントがBF16ベースラインの96.5〜97.4%を維持している。評価スイートはGPQA Diamond、MMLU-Pro、IFEval、IFBench、Multi-IF、BFCLv4で、2つの小型モデルにはGSM8K、2つの大型モデルにはAIME25も加わる。いずれも5回実行の平均値だ。
| チェックポイント | BF16品質の保持率 | 品質に関する主張 | デコードスループット |
|---|---|---|---|
| LFM2.5-230M | 97.1% | ばらつきの範囲内でQ5_K_Mに一致 | Q5_K_M比で+4〜33% |
| LFM2.5-350M | 96.5% | ばらつきの範囲内でQ5_K_Mに一致 | Q5_K_M比で+4〜33% |
| LFM2.5-1.2B-Instruct | 97.4% | Q4_K_Mに一致 | Q4_K_M比で+3〜14% |
| LFM2.5-2.6B | 96.6% | Q4_K_Mに一致 | Q4_K_M比で+3〜14% |
スループットは4つの環境で測定された。MacBook ProとNucBox EVO-X2はGPU、Samsung Galaxy S26 UltraとRaspberry Pi 5はArm CPUでの測定だ。230Mと1.2Bについては、Liquid AIはQAD Q4_0がUnslothのUD-Q4_K_XLにも匹敵すると報告している。リリース記事では、UD-Q4_K_XLを強力な外部PTQチェックポイントと位置付けている。
一方で、記事にはベンチマークごとのスコア、デバイス別の実測tokens/s、ファイルサイズ、RAM使用量、誤差範囲のグラフはない。提示されているのは割合のレンジと同等性の主張だけだ。サイズに関する計算は、コミュニティがすぐに補った。
「つまり、ローカルのLFM2.5-2.6BをF16からQAD Q4_0に入れ替えれば、5.4 GB -> 1.6 GB、21 -> 64 tok/sになりつつ、BF16性能の約97%を維持できるということ?」 - Liquidのローンチチャートを読んだ@firedUp_Neyu
この計算のうちファイルサイズについては、公式リポジトリでF16が5.4 GB、QAD Q4_0が1.59 GBとなっており、整合している。ただしtok/sの値はLiquid AIが本文で明記したものではなく、投稿者がチャートから読み取った数値だ。
ローンチ記事だけでは分からない3つの点
これらのファイルへ切り替えるか判断するなら、次の3点は見逃せない。
対象は4チェックポイントだけ。 リリース時点で、LFM2.5-VL-450MおよびLFM2.5-8B-A1BにはQADビルドがない。Xのリリーススレッドでは、Liquid AIに8B版を求める声も出ている。対象がこれらのモデルなら、現時点でQADによる変更はない。
imatrixの扱いは未解決。 QADファイルはQ4_0向けに学習されている一方、importance matrixなしで生成されている。この点は量子化を追っているユーザーがすぐに指摘した。
「QAD Q4_0 GGUFはimatrixなしで作られています。imatrixがあれば、QAD学習済みモデルの品質もさらに改善できたはずです。」 - r/LocalLLaMAのu/Chromix_
3B未満のモデルであることは変わらない。 量子化による性能回復は、モデルそのものの能力上限を引き上げるものではない。LocalLLaMAのスレッドにも実例がある。NPUで使うユーザーはこう書いている。
「会議要約用にNPUでLFM2.5 2.6Bを実装しました。サイズを考えれば印象的ですが、要約はより大きなモデルと比べるとはるかに劣ります。」 - u/DerDave
この上限は量子化の問題ではなく、モデル側の問題だ。KikoCisの量子化レポートでは、Q8_0でもSWE-bench Verifiedの解決数は6件中0件だった。また1.2Bでは、ランタイムによる品質の振れも報告されている。あるOllama環境では10プロンプト中9件で意味不明な出力が出た一方、別の環境ではシングルボードコンピュータ上で5W未満の実用的な動作が報告された。特定タスクで最前線級の品質が必要なら、低コストなLLM APIを通じてローカル出力を大規模モデルと照合しても、テストセット全体でかかる費用は数セント程度だ。
QAD Q4_0とQ4_K_M、どちらを選ぶべきか
この4チェックポイントをRAMが限られたllama.cpp環境で使うなら、まず試すべきベンダー推奨の4ビット版はQAD Q4_0だ。通常のQ4_0と同じ1.59 GBで、1.2Bと2.6BではQ4_K_M、230Mと350MではQ5_K_M相当の品質を目指して学習されている。デコード速度はそれぞれ3〜14%、4〜33%高速とされる。すでにQ4_K_Mを動かしていてRAMに余裕があるなら、無理に替える必要はない。80 MBは、そこで解決したい問題ではないはずだ。
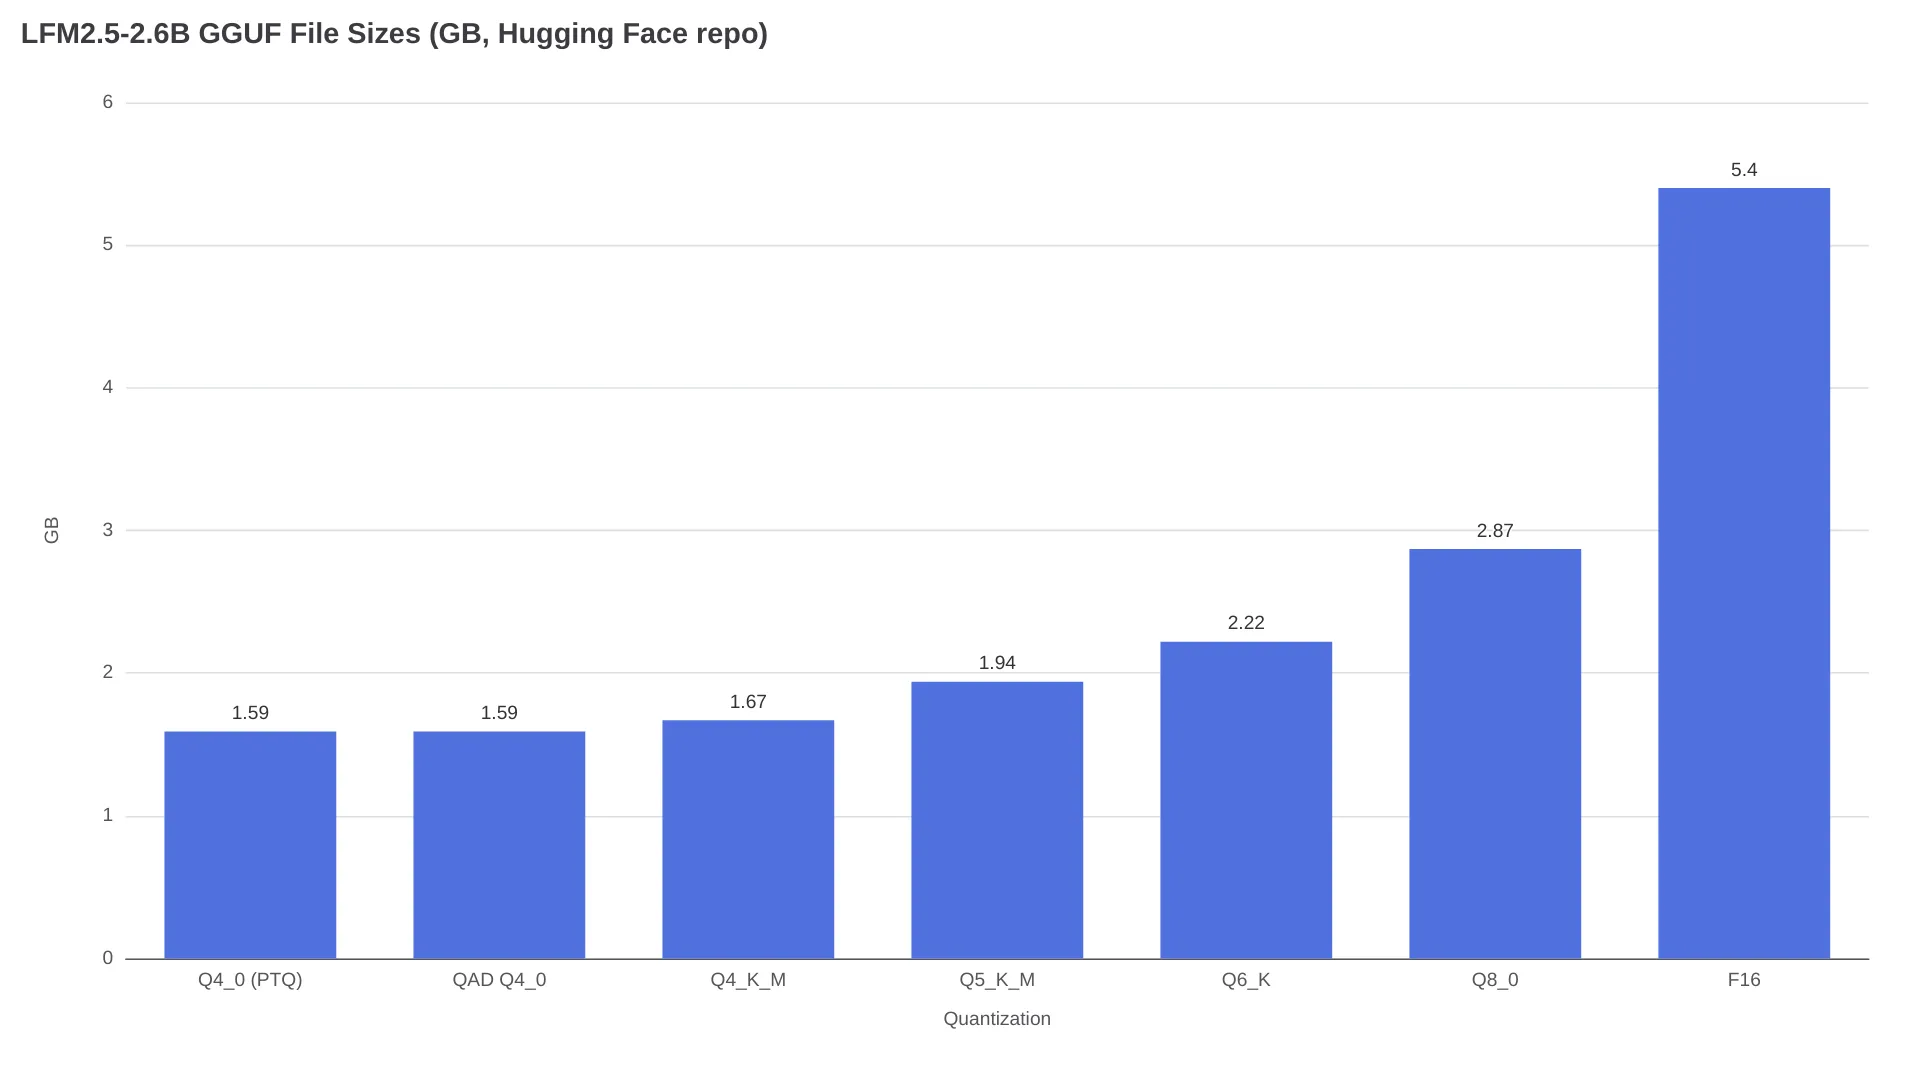
| ファイル(2.6B) | サイズ | 位置付け | 選ぶ場面 |
|---|---|---|---|
| Q4_0(旧PTQ) | 1.59 GB | 補正なしのベースライン | QADがあるため選ばなくてよい |
| QAD Q4_0 | 1.59 GB | BF16の96.6%、Q4_K_M相当 | RAM予算3〜4 GB、CPUデコード、スマートフォン、Pi |
| Q4_K_M | 1.67 GB | Liquidのドキュメントでのデフォルト選択 | ランタイムがQADファイルを選択できない場合 |
| Q5_K_M | 1.94 GB | KikoCisによればF16比トップ1一致率91.4% | RAM 6 GB以上 |
| Q6_K / Q8_0 | 2.22 / 2.87 GB | ほぼ無損失 | RAM 8 GB以上、品質優先 |
同等性の主張を読む際の参考として、KikoCisのPTQ比較では、このモデルのF16に対するトップ1トークン一致率はQ4_K_Mで84.36%、Q6_Kで95.07%、Q8_0で98.23%だった。Liquid AIの主張は、QADにより同じバイト数の4ビットでこの忠実度の差を埋められるというものだ。ただし、その数値はLiquid AIによる5回実行の結果であり、独立した再現検証はまだない。リリース当日の議論で、的確な整理があった。
「これは『Q4_0がK量子化に勝つ』という話ではありません。この4チェックポイントがQ4_0向けに学習された、ということです。」 - @MarMarLabs
この優位性を他モデルに一般化してはいけない。他のモデルのQ4_0ファイルは、依然として通常のPTQだ。
メモリについては、ローンチ記事にRAM使用量の記載がない。そこでKikoCisのリポジトリの計算を使うと、2.6BのKVキャッシュはf16で約16 KB/token、32Kコンテキストでは約0.54 GB、ネイティブの128Kウィンドウでは約2.15 GBとなる。--cache-type-k q8_0 --cache-type-v q8_0を使えば半分になる。QAD Q4_0の重み1.59 GBに32Kウィンドウを足すと、ランタイムのオーバーヘッド前で約2.13 GB。128Kでは3.7 GBを超える。4 GBは余裕がないと考え、対象ランタイムで実際の割り当てを確認したい。
FAQ
QAD Q4_0はQ4_K_Mより優れている?
この4チェックポイントに限れば、Liquid AIの数値では、QAD Q4_0はより小さなファイルでより高いデコード速度を出しながら、Q4_K_M相当の品質を維持する。最小の2モデルではQ5_K_M相当とされる。RAMに制約があるなら、答えはyesだ。ただし数値はベンダー自身による5回実行の結果であり、独立した再現検証はまだない。
OllamaやLM StudioはQADファイルを自動で選ぶ?
選ばない。公式リポジトリページに記載されたOllamaの手順は、ollama run hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_Mであり、公式リポジトリページでもHugging Faceのデフォルト例でもQ4_K_Mが対象だ。GGUF対応ランタイムならQADファイルは読み込めるが、ファイル名または:QAD-Q4_0修飾子を明示して選択する必要がある。
LFM2.5-2.6B QAD Q4_0にはどれだけのRAMが必要?
重みは1.59 GB。KikoCisの計算では、f16 KVキャッシュは32Kコンテキストで約0.54 GB、128Kで約2.15 GBとなる。重みとキャッシュの合計は、ランタイムのオーバーヘッド前で32K時に約2.13 GB、128K時に3.74 GB近い。Q8_0のKVキャッシュ量子化を使えば、キャッシュのコストは半減する。
QADチェックポイントがあるLFM2.5モデルは?
2026年8月19日時点では、LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct、LFM2.5-2.6Bだけだ。VL-450Mと8B-A1Bにはない。ただしリリーススレッドでは、Liquid AIに8B QADビルドを求めるユーザーがいる。
LFM2.5 QADチェックポイントは商用利用できる?
リポジトリにはLFM Open License v1.0が付与されている。コミュニティリポジトリの要約では、年間売上が1,000万USD未満の組織には商用利用を認め、この基準額以上ではLiquid AIとの別途商用ライセンスが必要とされている(KikoCisの要約)。公開前にはライセンス本文そのものを確認してほしい。
97%という主張は独立検証されている?
まだされていない。96.5〜97.4%という保持率は、Liquid AIがリリース時に公開した5回実行の平均値だ。執筆時点でQADファイルを対象とする第三者ベンチマークは出ておらず、imatrixの問題もr/LocalLLaMAで未解決のままだ。
今夜できるA/Bテスト
重要なのはベンチマーク平均ではなく、自分のタスクでどれだけ失敗するかだ。ツール呼び出し用JSON、独自の抽出スキーマ、利用言語など、実際に使うプロンプトを10件選び、同一設定で両ファイルを実行して比較しよう。
llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-QAD-Q4_0.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"

llama-cli -hf LiquidAI/LFM2.5-2.6B-GGUF \
  --hf-file LFM2.5-2.6B-Q4_K_M.gguf \
  -c 4096 --temp 0.1 --top-k 50 --repeat-penalty 1.1 \
  -p "<your prompt>"
見るべきなのは印象ではない。各ファイルについて、パース失敗と誤ったツール選択を数えることだ。未解決のトレードオフは確かにある。品質/GBの平均値だけを見れば、QAD Q4_0が有利に見える。しかし、推論でトークン予算を使い切ったときの空応答や、温度設定によるフォーマット崩れなど、実運用での失敗パターンはランタイムとタスクに依存する。その値段を決められるのは、手元の10プロンプトによる検証だけだ。