 AIREITER
日常的なコーディングなら、速さとコストの面でGPT-5.6 Terraが有利だ。実測では、回答完了までの時間はおよそ半分、出力トークンも大幅に少なく、ターミナルエージェント系の評価ではClaude Sonnet 5をわずかに上回る。一方、実リポジトリのバグ修正ではSonnet 5とほぼ互角で、複合的な推論ではSonnet 5がほんの少し優勢だ。そして導入初日という観点では、すでに広く利用できるSonnet 5に分がある。Terraは現在もプレビューアクセス経由で段階的に提供されている。本稿では、ライブテスト、公開ベンチマーク、速度と価格の差をもとに、用途ごとの選び方を整理する。
| 用途 | おすすめ |
|---|---|
| 対話的な編集・実行型コーディング | Terra |
| ターミナル / CLIエージェント | Terra |
| 実リポジトリのバグ修正 | ほぼ互角 |
| コンピュータ操作 / デスクトップエージェント | Sonnet 5 |
| 最難関の多段階推論 | Sonnet 5 |
| タスクあたりの実効コスト | Terra |
GPT-5.6 Terraを実測:小さなテストで見えたこと
2026年7月、temperature 0のチャットエンドポイント経由でGPT-5.6 Terraに、小規模ながら落とし穴の多い課題を与えた。実装対象はLeetCode #8の文字列から整数への変換関数my_atoi。先頭の空白、任意の符号、最初の非数字での打ち切り、32ビット整数のオーバーフロー時のクランプを扱う必要がある。その後、空文字列、"words and 987"、"-91283472332"(INT_MIN未満)、"+-12"、両境界でのクランプを含む20ケースで出力を検証した。
結果は20件中20件成功。クライアント側で観測した所要時間は5.5秒、出力は193トークンだった。オーバーフロー対策もきれいに書かれている。乗算の前にvalue > (2**31 - ... - digit) // 10を判定するため、後からクランプするのではなく、内部的なオーバーフローそのものを避けている。
while i < n and "0" <= s[i] <= "9":
    digit = ord(s[i]) - ord("0")
    if value > (2**31 - (1 if sign == 1 else 0) - digit) // 10:
        return 2**31 - 1 if sign == 1 else -2**31
    value = value * 10 + digit
    i += 1
ただし、ここは明確にしておきたい。これは小さな単一タスクであり、ベンチマークではない。しかも比較は片側だけだ。実際のClaude Sonnet 5エンドポイントにはAPIアクセスできなかったため、以降で扱うSonnet 5の数値はすべて出所が明示された公開情報であり、私自身の実行結果ではない。Terraの結果は、あくまでトークン効率を示す具体的な1データポイントとして読むべきで、単独で優劣を決める材料ではない。
ベンチマークでは用途ごとに勝者が変わる
ベンチマークを並べると、総合王者がいるというより、タスクの種類ごとに得意分野が分かれている。
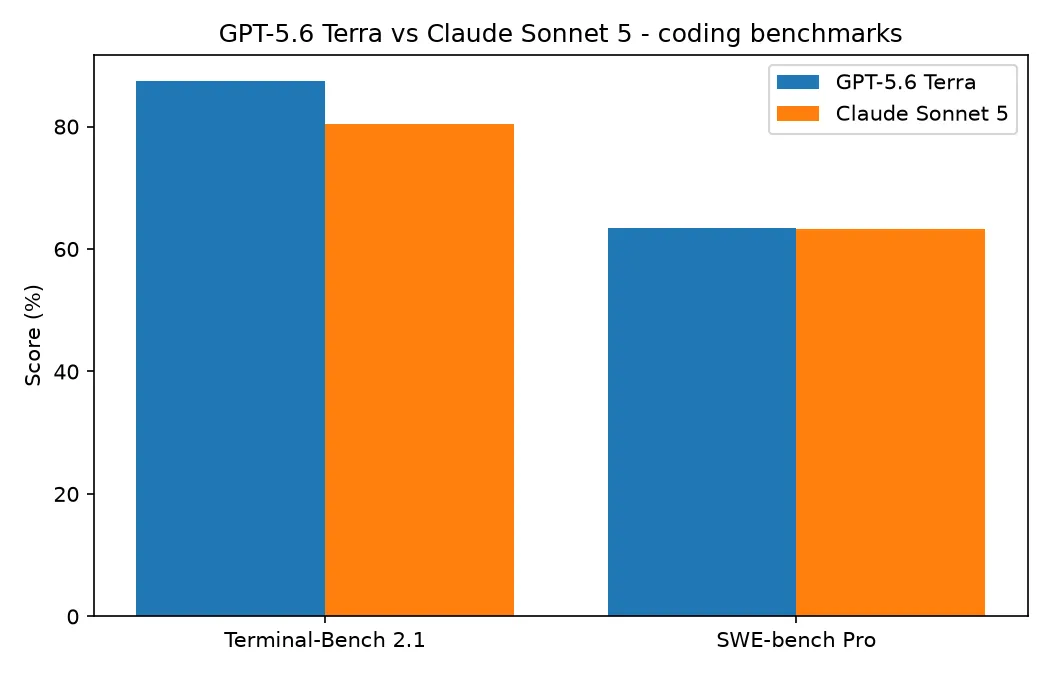
ターミナル主導のエージェント型コーディングを測るTerminal-Bench 2.1では、Terraが87.4%、Sonnet 5が80.4%だった。CLIエージェントやシェル中心の自動化を使うなら、これは無視できない差だ。実在リポジトリのバグを修正するSWE-bench Proでは、Terraが63.4%、Sonnet 5が63.2%。複数ファイルにまたがる現実的で雑多な修正作業では、両者は事実上互角と見てよい。
複合推論まで視野を広げると、Sonnet 5がわずかに前に出る。Artificial AnalysisによるIntelligence IndexはSonnet 5が53、Terraが52だ。比較条件はTerraがxhigh effort、Sonnet 5がmax effortで、時点は2026年7月。またSonnet 5は、コンピュータ操作エージェントのベンチマークであるOSWorld-Verifiedで81.2%を記録している。この領域ではTerraの公開数値は少ない。結論として、ターミナルエージェントならTerra、リポジトリのバグ修正なら五分、最難関の推論やデスクトップ操作エージェントならSonnet 5という構図だ。
体感差が出るのは速度とレイテンシ
ベンチマークでは見えにくいが、実際に最初に気になるのはローディング表示を眺める時間だ。Artificial Analysisの計測では、Terraは毎秒118出力トークン、Sonnet 5は71。最初のトークンが返るまでの時間は、Terraが16.3秒、Sonnet 5が198.7秒となっている。後者は通常値ではなく最悪ケースだ。Sonnet 5をmax reasoning effortで動かした結果であり、出力前に長い思考処理が走る。effortを下げればTTFTは大きく短縮するが、順序自体は変わらない。Terraのほうが出力開始も完了も早い。
Mergeによる実装テストも同じ傾向を示している。マーケティング用ホームページの構築では、Terraが60.2秒で完了したのに対し、Sonnet 5は136.6秒。出力トークン数もTerraが10,677、Sonnet 5が17,870だった。今回のatoiテストもこれに近い。Terraは193トークンで、正しく境界処理された実装を返した。公開データと実地テストはいずれも、Terraは短く速く出力し、Sonnet 5はより多くのトークンと時間を使うことを示している。その一部は、必要な場合もあれば不要な場合もある推論に費やされている。
編集、実行、再編集を繰り返す開発フローでは、このレイテンシ差はすぐに積み上がる。反対に、難しいエージェントタスクを1件投げて席を離れる使い方なら、影響はずっと小さい。
API価格だけでは決め手になりにくい
標準API価格は近く、価格表だけで選択が決まるケースは多くない。
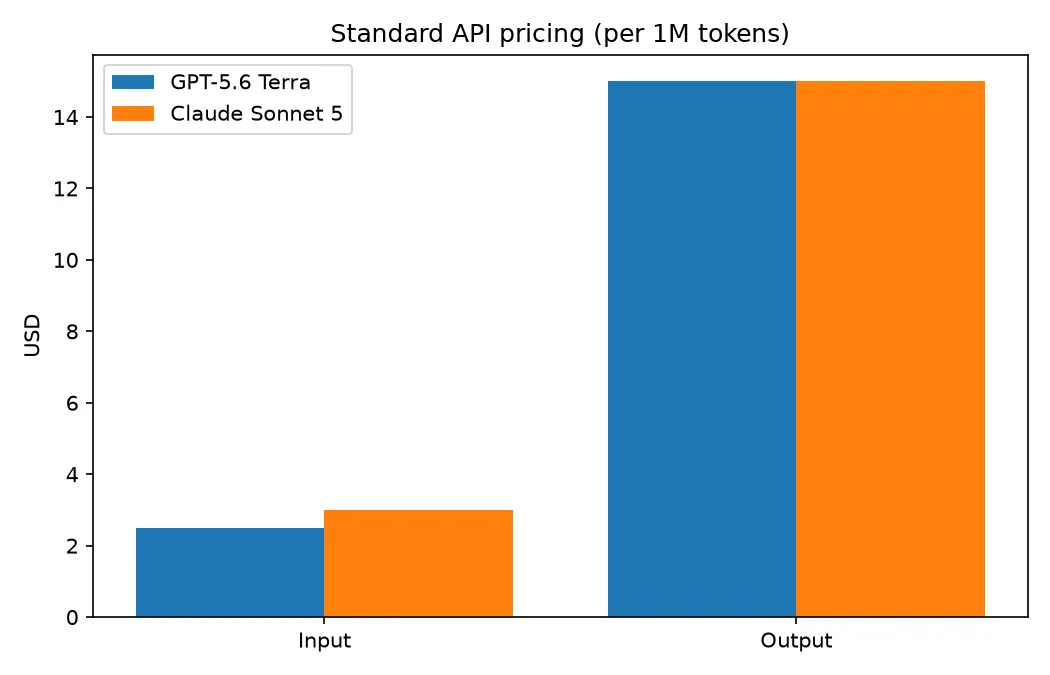
Terraの価格は入力100万トークンあたり$2.50、出力$15。Sonnet 5の標準価格は入力$3、出力$15だが、Anthropicは2026年8月31日まで導入価格として$2 / $10を提供している。その期間中は、表示上の価格ではSonnet 5のほうが安い。両モデルともコンテキストウィンドウは100万トークン、最大出力は128Kだ。Terraは、同等の日常的な品質を前提にすれば従来のGPT-5.5 tierのおよそ半額でもあり、価値の比較対象はSonnet 5だけではない。
この2モデルのコストを語る際には、性質の異なる3つの数字が混在しがちだ。
- トークンあたりの定価:Terraは入力が安く、出力は同額。Sonnet 5の導入価格は一時的にその両方を下回る。
- 混合インデックス価格:Artificial AnalysisではTerraが$2.17、Sonnet 5が$1.54となっている。ただしこれはテスト時のeffort設定で、入力と出力を3:1で混合した指標であり、タスクごとの実支払額ではない。
- 完了タスクあたりの実効コスト:同じ成果に対する出力トークン数がTerraのほうが少ないため、通常はこちらでTerraが有利になる。Mergeの構築テストでは、Terraが$0.120、Sonnet 5が$0.179。Sonnet 5は出力価格が割引中にもかかわらず、Terraのほうがおよそ3分の1安かった。
大半のワークロードで請求額に効くのは、タスクあたりの実効コストであり、その点ではTerraが有利だ。どちらもAnthropic互換・OpenAI互換API経由で利用でき、定価が制約になる場合は、割引価格でアクセスを再販するサードパーティーゲートウェイもある。
開発者は実際に何を選んでいるか
ベンチマークとコミュニティでの選択は必ずしも一致しないため、現場の声にも目を通す価値がある。2026年7月のXでは、コスト面を理由にGPT-5.6系へ寄る意見が目立った。ある開発者は、エージェント統合パイプライン全体を入れ替え、Opus 4.8をTerraへ、Sonnet 5をLunaへ置き換えたと説明している。新モデルについては「blazing fast, very capable and cheaper」と評した。別の開発者も、「ほとんどClaudeを使わなくなった」と述べ、CursorではGrok、CodexではTerra/Solを主力のエージェント型コーディング環境として維持しているという。
Terraは、Claudeでは解けなかった問題を解決したモデルとしても名前が挙がる。あるビルダーは、Sonnet 5が解けなかったバグをTerraが修正し、単一のプロンプトからサイトUI全体を生成したと報告した。とはいえ評価は一様ではない。別の開発者は、Terraについて「バグを探し回る積極性はSolほどではないが、仕事はこなす」と指摘している。これは、最大限にバグを追うモデルというより、安定して安価な主力モデルとしてTerraを見る評価と一致する。
もちろん、Sonnet 5を選ぶ理由も消えない。現時点で全プランtierから利用でき、Claudeの成熟したツール群やadaptive-thinking workflowと自然に統合できる。長大なコンテキストを扱うエージェント型タスクにも強い。すでにClaudeに標準化しているチームにとっては、タスクあたり数セントの差より、既存環境を維持できることのほうが重要な場合も多い。
結局、どちらを選ぶべきか
答えは総合的な「どちらが上か」ではなく、ワークロードの形で決まる。私が最も多く行う、高速な反復開発、ターミナルエージェント、タスクあたりのコストを重視する作業ではTerraを標準にし、推論負荷の高い仕事にはSonnet 5を控えとして使う。
- GPT-5.6 Terraを選ぶべきケース:高頻度の対話的コーディング、編集・実行ループにおけるレイテンシ重視、ターミナルまたはCLIエージェントの運用、タスクあたりの実効コストを最小化したい場合。魅力は、速さとトークン効率にある。
- Claude Sonnet 5を選ぶべきケース:最難関の多段階推論、長大なコンテキストを使うエージェント実行、コンピュータ操作タスクが中心の場合。また、すでにClaudeエコシステムを使っており、今日すぐ全tierで使えるモデルが必要な場合にも向く。8月31日までの導入価格$2 / $10なら、試しやすい選択肢でもある。
日々の機能開発を進める多くのビルダーにとっては、Terraの速度とコストのバランスが勝る。本当に難しい推論タスク、あるいはスタックの移行コストに見合わない場合は、Sonnet 5のほうが安全な選択だ。両者の差は十分に小さく、最後の決め手はリーダーボードではなく、自分の開発フローになる。
FAQ
GPT-5.6 TerraはClaude Sonnet 5より優れている?
速度とコスト効率を重視したコーディングでは、そう言える。Terraは高速で、タスクあたりのコストが低く、ターミナルエージェントのベンチマークでも先行している。一方、最難関の推論やコンピュータ操作ではSonnet 5が少なくとも互角、しばしば優勢だ。単一の勝者はいない。タスク次第である。
Claude Sonnet 5はコーディングに向いている?
向いている。実リポジトリのバグ修正を測るSWE-bench ProではTerraと並ぶ成績で、63.2%対63.4%だった。OSWorld-Verifiedのエージェント型タスクでも優位に立つ。Terraに対する弱点はコード品質ではなく、速度と最初のトークンが出るまでの時間だ。
TerraはSonnet 5よりどれだけ安い?
定価ではTerraが$2.50/$15、Sonnet 5が$3/$15。ただしSonnet 5は2026年8月31日まで$2/$10の導入価格で、期間中は一時的に安い。タスクあたりの実効コストでは、出力トークンが少ないため、通常はTerraのほうが有利になる。
TerraとSonnet 5のコンテキストウィンドウは同じ?
実質的には同じだ。両者とも100万トークンのコンテキストウィンドウと128Kの最大出力を提供しているため、コンテキストサイズが選択の決め手になることはない。
GPT-5.6 Terraはすでにどこでも利用できる?
まだ完全には利用できない。Sonnet 5は現在すべてのプランtierで利用可能だが、GPT-5.6は一部でプレビューおよび選定APIパートナー経由のアクセスに限定されている。本番環境ですぐ必要なら、これは実務上重要な点だ。