 AIREITER
Gemini 3.5 FlashはGemini 3.1 Proの2.6倍の出力速度を持ち、トークン単価は25%低く、Artificial AnalysisのIntelligence Indexでも50対46で上回ります。ただし、抽象的推論を測るARC-AGI-2ではGemini 3.1 Proが77.1%で、Flashの72.1%を5ポイント上回りました。またFlashは、コンテキストが128kトークンを超えると長文検索のスコアが84.9%から77.3%へ低下します。結論から言えば、スループットとツール呼び出しの応答性を重視するならFlash、複数段階にわたる深い推論を重視するならProです。総合ベンチマークの単一スコアだけでは、実際のワークロードに必要な違いは見えてきません。
ベンチマーク比較:それぞれが優位な領域
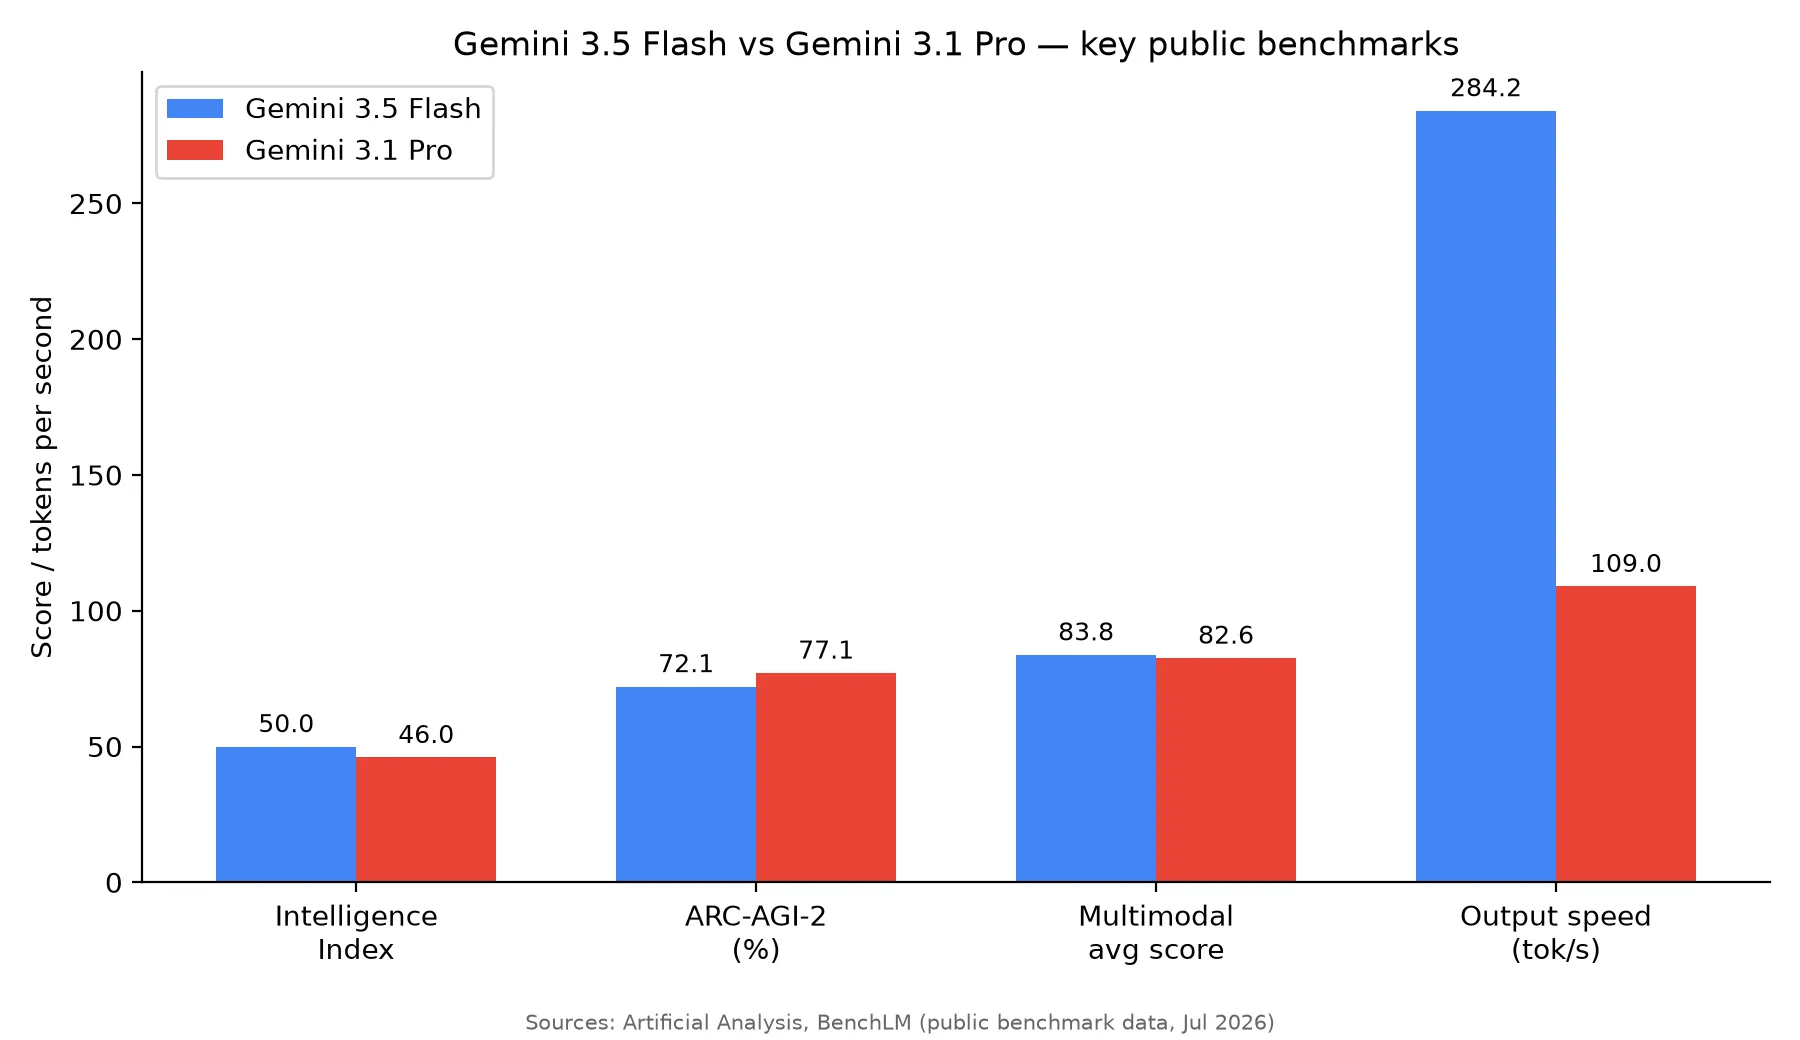
| 指標 | Gemini 3.5 Flash | Gemini 3.1 Pro | 優位なモデル |
|---|---|---|---|
| Intelligence Index(Artificial Analysis) | 50 | 46 | Flash |
| ARC-AGI-2:抽象的推論(BenchLM) | 72.1% | 77.1% | Pro |
| 128kコンテキストでのMRCR v2(nxcode) | 77.3%(短いコンテキストでは84.9%) | 同じ長さでの公開スコアなし | データ不足 |
| マルチモーダル平均スコア(BenchLM) | 83.8 | 82.6 | Flash |
| 出力速度(BenchLM) | 284.2 tok/s | 109 tok/s | Flash(2.6倍) |
| GDPval-AA Elo:実務エージェントタスク(apiyi) | 1656 | 1314 | Flash |
スループットや汎用タスク処理を測る指標ではFlashが優勢です。一方、ARC-AGI-2ではProが推論の深さで明確な優位性を示しています。長文検索については、Flashに128kトークン超でのスコア低下が確認されているものの、同条件におけるProの結果は公開されていません。ここはProの勝ちと断定するのではなく、結論保留と見るべきでしょう。この分かれ方は、総合的なIntelligence Indexよりも、実行したいタスクの性質にそのまま対応しています。
BenchLM自身の比較には、方法論上の注意点もあります。両モデルで結果が公開されているおよそ34のベンチマークのうち、直接比較できるカテゴリはわずか3つです。Proだけが結果を持つベンチマークは14、Flashだけのものは17あり、thinking budgetの設定も両者で常に一致しているわけではありません。上の表は大まかな傾向を示すものとして読むのが適切です。ARC-AGI-2とMRCR v2の差は判断材料になりますが、共通指標での1〜2ポイント差を決定的な優劣と解釈すべきではありません。
Flashが苦手とする場面
ARC-AGI-2の5ポイント差は、BenchLMの比較において両モデル間で確認された単一カテゴリとして最大の差です。ARC-AGI-2は、パターン照合による近道が通用しにくいよう設計されています。そのため、一般的なベンチマークで同程度の差が出るよりも、ここでの5ポイント差は推論の深さを示す強いシグナルです。nxcodeのMRCR v2も同じ方向のデータを示しています。Flashの検索精度は、コンテキストが128kトークンに近づくにつれ84.9%から77.3%へ下がります。同じ長さでのProのスコアは未公開なので、Proに対する直接対決での敗北が示されたわけではありません。ただし、Proのベンチマーク表には現れないFlash側の明確な性能低下ではあります。
これはベンチマークではなく、あくまでユーザーの所感:難しいタスクではどちらを好むかを尋ねたReddit r/GeminiAIのスレッドでは、Flashは「長文コンテキストと抽象的推論以外では、すべてでProを上回る」とするコメントが見られました。少数の意見であり、データではありません。ただ、ベンチマークで見えている2つの例外と一致している点では、証明にはならないものの軽い妥当性確認にはなります。
料金とキャッシュ費用:実際に効くコスト差
基本料金だけを見ると、価格差は一見するほど大きくありません。
- Gemini 3.5 Flash:入力100万トークンあたり$1.50、出力100万トークンあたり$9
- Gemini 3.1 Pro:入力100万トークンあたり$2、出力100万トークンあたり$12
つまり、基本単価の差は25%です。Flashが旧世代のProモデルに対して持っていた4〜8倍の価格差ではありません。より大きく効くのはキャッシュです。
- Flashはキャッシュ書き込みが無料で、キャッシュ済み入力は100万トークンあたり$0.15
- Proはキャッシュ書き込みに100万トークンあたり$0.38かかり、キャッシュ済み入力は100万トークンあたり$0.50。Flashのキャッシュ済み入力料金の3倍超です
同じシステムプロンプトやドキュメントのコンテキストを複数ターンで繰り返し送るワークフローでは、この差がすぐに積み上がります。たとえばチャットエージェント、コードベースのコンテキストを維持するコーディング支援、多ターンのサポートボットです。単発リクエストなら差は小さくても、1,000ターンのエージェントセッションでは無視できません。
もっとも、価格差は常に一定ではありません。apiyiの料金分析によれば、コンテキストが約200kトークンを超えると、両モデルのトークン単価はその規模で近づくため、価格差は25〜50%まで縮まります。短い繰り返し呼び出しではなく、非常に長い文書を一度だけ処理するケースが中心なら、Flashを選ぶ価格面の根拠は弱まります。
具体例:1日にキャッシュ済み入力100万トークンを送り、50万出力トークンを生成するサポートボットを考えます。Flashでは、キャッシュ書き込みは$0、キャッシュ済み入力が$0.15 × 1、出力が$9 × 0.5で、合計は1日$4.65です。Proでは、同じワークロードで$0.38(初回のみのキャッシュ書き込み)+$0.50 × 1(キャッシュ済み入力)+$12 × 0.5(出力)となり、初日は約$6.88、その後は1日$6.50です。1か月では、およそ$140と$195の差になります。ただし、実際に深い推論を必要とするリクエストで得られるProの価値は、この計算には含まれていません。
エージェントループではFlashが速い。ただし信頼性は別問題
nxcodeのエージェントループ・ベンチマークでは、8ステップのループをFlashは約25秒、Proは100秒で完了しました。4倍の差であり、ステップ数が増えるほど影響は大きくなります。実務のナレッジワークを想定したエージェントタスクのベンチマークGDPval-AAでも、FlashのEloは1656、Proは1314です。342ポイントの差は、ベンチマーク表全体で最大の開きです。
ただし、この速度とスコアの優位性は、エージェントループが問題なく進むことを前提にしています。推論や長文コンテキストで見られたARC-AGI-2とMRCR v2の差からは、ループ途中のツール呼び出しが予想外の結果を返し、エージェントが計画を立て直す必要が出た場合には、Flashのほうが余裕が小さいと考えるのが妥当です。これは上記の推論深度データに基づく推測であり、別途ベンチマークで実証された主張ではありません。各ステップの出力を人が確認する監督付きの運用なら、Flashの速度優位はほぼそのままメリットになります。一方、人の介在なしに多数ステップを実行するなら、両モデルの失敗率データが公開されるまでは、Proの推論面の余裕を選ぶほうが安全です。
用途別:Gemini 3.5 FlashとGemini 3.1 Proの選び方
| タスクの種類 | 推奨モデル | 理由 |
|---|---|---|
| 日常的なコーディング(テスト、PRレビュー、言語間の変換) | Flash | 速度とコストで有利。推論の深さが主なボトルネックではない |
| 大規模なリファクタリング、新規アルゴリズムの設計 | Pro | ARC-AGI-2の差が、複数段階の論理的推論に直接表れる |
| 長文ドキュメントの検索(128kトークン超の契約書、研究コーパス) | Pro | この長さでFlashにはMRCR v2の性能低下が確認されている。Proのスコアは未公開だが、既知の弱点がないモデルを選ぶほうが安全 |
| 大量のバッチ生成 | Flash | 規模が大きいほど、無料のキャッシュ書き込みと2.6倍のスループットが効く |
| 人が出力を確認する監督付きエージェント運用 | Flash | 非監督運用の信頼性リスクを避けつつ、速度面の利点を得られる |
| 高リスクな非監督エージェントチェーン | Pro | ループ途中のエラーを人が拾えないため、推論の余裕がより安全な選択になる |
| 同一コンテキストを再利用する頻繁な多ターン呼び出し | Flash | キャッシュ済み入力の料金はProの約3分の1 |
判断の目安はシンプルです。次の3条件のいずれかに当てはまらない限り、基本的にはFlashへ送ればよいでしょう。コンテキストが128kトークンを超え、検索精度が重要な場合。新規アルゴリズム、法務・研究の統合のように、抽象的または複数段階の推論が必要な場合。そして、エージェントを人の確認なしで数ステップ以上動かす場合です。このうち1つでも該当すればPro寄りです。該当しなければ、Flashは速度とキャッシュ料金の面でより安価な標準選択になります。
FAQ
Gemini 3.5 Flashは3.1 Proより優れていますか?
速度、コスト、汎用ベンチマークでは優れています。一方、抽象的推論を測るARC-AGI-2ではGemini 3.1 Proが5ポイント上です。128kトークンを超える長文検索ではFlashに性能低下が確認されており、Proの同条件のスコアは公開されていません。そのため、ここはProの明確な勝利ではなく、未解決の比較として扱うべきです。どちらが優れているかは、タスクがどのカテゴリに属するかで決まります。
Gemini 3.5 Flashは3.1 Proよりどれくらい安いですか?
基本の入力・出力料金では約25%安価です。100万トークンあたり、Flashは$1.50/$9、Proは$2/$12です。より大きな差が出るのはキャッシュで、Flashはキャッシュ書き込みが無料、キャッシュ済み入力もProのおよそ3分の1です。このため、多ターンまたは大規模なワークロードほど節約効果が大きくなります。
Gemini 3.5 Flashはコーディングに向いていますか?
はい。テスト生成、PRレビュー、コードの言語間変換といった日常的な作業には適しています。ただし、大規模なリファクタリングや新規アルゴリズムの設計では、抽象的推論ベンチマークにおけるProの優位性が出力品質に表れやすいでしょう。
Gemini 3.5 Flashは長文コンテキストを適切に扱えますか?
短いコンテキストでは問題ありません。MRCR v2の検索精度は84.9%です。ただし128kトークンを超えると77.3%まで下がり、複数文書の契約レビューのようなタスクでは意味のある差になります。同じ長さでのGemini 3.1 Proのスコアは公開されていないため、これはProの優位性が確定した話ではなく、Flashで判明している制約と捉えるべきです。
結論
Gemini 3.5 Flashは、多くの日常業務や大量処理における優れた標準選択です。高速で、キャッシュ利用時のコストも低く、汎用ベンチマークの差も多くの場面では実用上の問題になりにくいためです。Gemini 3.1 Proは、抽象的推論や非監督のエージェントチェーンで追加コストを正当化できます。128kトークンを超える長文では、Flash自身の数値が弱点を示していますが、Proの優位性を裏付けも否定もしていません。どちらかに決める前に、自身のデータで検証する価値がある領域です。
本比較は、実際のAPIテストではなく、Artificial Analysis、BenchLM、nxcode、apiyiの公開ベンチマークデータに基づいています。Gemini 3.1 Proは、Flashの速度重視とは異なる、推論を重視する位置付けで登場しました。本稿執筆時点でGemini 3.5 Proはまだ提供されておらず、報道では2026年7月のリリースが示されています。Proの次期バージョンが登場すれば、両モデルの状況とこの比較は改めて見直す必要があります。