 AIREITER
27Bパラメータ級のモデルをスマートフォンで動かす――Bonsai 27Bは、その主張を単なるデモで終わらせていない。PrismMLがQwen3.6 27Bを3値量子化したこのモデルは、最小の1ビット版なら3.9GBに収まり、iPhone 17 Proでおよそ毎秒11トークンを生成できる。重みはApache 2.0で公開され、3値版はフル精度時のベンチマーク性能を95%以上維持するという。ただし性能の残り方は一様ではない。数学とコード生成はほぼ同等の水準を保つ一方、ツール呼び出しや画像理解では落ち込みが見られる。ローカルで推論やコーディングをしたいなら有力だが、ツールを多用するエージェント用途には慎重さが必要だ。本記事では圧縮の仕組み、数値の見方、4つの実行方法、向くユーザーを確認する。
27Bモデルをスマホ級の容量へ圧縮した仕組み
一般的な27BモデルをFP16で保持するには、およそ54GBのメモリが必要になる。スマートフォンには到底収まらない容量だ。Bonsai 27Bは、フル精度の重みを小さな離散値へ置き換えることで、必要容量を6GB未満まで削減している。
3値版では、すべての重みを-1、0、+1の3値に制限する。理論上、重み1つあたりの情報量は約1.58ビットとなる。さらにPrismMLはグループ単位のFP16スケーリングを加えている。これは重みのグループごとにフル精度のスケール係数を保存し、値を絞り込んだ後も適切な大きさを保てるようにする仕組みだ。実際のコストは重みあたり約1.71有効ビットとなる。より攻めた1ビットのバイナリ版では0を省き、-1と+1だけを使うため、約1.125有効ビットまで下がる。
重要なのは2点ある。1つ目は、埋め込み、Attention、MLPブロック、言語モデルヘッドまで、すべてを量子化していることだ。フル精度のコンポーネントを補助として残してはいない。2つ目はベースモデルがQwen3.6 27Bであること。これは27.8BパラメータのハイブリッドAttention型因果モデルであり、Bonsaiも262Kトークンのコンテキストウィンドウとマルチモーダル入力を引き継いでいる。
3値版と1ビット版、どちらを選ぶべきか
PrismMLは2種類のビルドを提供している。選択を誤ると、必要以上にメモリを使うか、品質を無駄に落とすことになる。基本的なトレードオフは明快で、ファイルが小さいほど精度は下がる。
| ビルド | 重みあたりの有効ビット数 | サイズ | 維持する品質 | 向く用途 |
|---|---|---|---|---|
| 3値(-1、0、+1) | 約1.71 | 5.9GB | FP16の95%超 | デスクトップ、品質重視の作業 |
| 1ビット・バイナリ(-1、+1) | 約1.125 | 3.9GB | FP16の90%超 | スマートフォン、厳しいメモリ制約下 |
スマートフォンで使うなら、iPhone 17 Proのメモリ余裕に収まる1ビット版が選択肢になる。余裕のあるノートPCやデスクトップなら、2GB増える代わりに精度を数ポイント取り戻せる3値版がよい。容量より出力品質を優先する場面では、その差に意味がある。
ベンチマークで見える得意分野と弱点
公式ベンチマークは3値版の数値で、thinking modeの15ベンチマーク平均は80.49だ。特に目立つ結果は以下の通り。
| ベンチマーク | スコア | 測定内容 |
|---|---|---|
| MATH-500 | 99.20 | 学年レベルから競技レベルまでの数学 |
| AIME 2025 | 90.84 | 難度の高い数学コンテスト問題 |
| HumanEval+ | 93.90 | コード生成 |
| BFCL v3 | 74.41 | 関数・ツール呼び出し |
並べて見ると、Bonsai 27Bの性格ははっきりする。数学とコードは90点台だが、ツール呼び出しは70点台にとどまる。この差こそ、導入前に押さえておくべき最重要ポイントだ。量子化は推論やコード生成をかなり良好に保つ一方、エージェント型ワークフローで求められる構造化された複数ステップの挙動は、より大きく損なわれている。
これらはPrismML自身が公表した数値であるため、独立したベンチマークが十分に出そろうまでは、最終評価ではなく出発点として見るべきだろう。80.49という平均値だけで判断せず、タスクごとのスコアと実際の失敗パターンを確認したい。初期テスターからは、3値版がときどき推論ループに陥るという報告がある。極端な量子化では、単一タスクのスコアから想像される以上に長文コンテキストの安定性が落ちやすい。依存する前に、自分のプロンプトで軽く試す価値がある。
実行速度と対応ハードウェア
ここまで大胆に圧縮しても、実用的な速度で推論できなければ意味がない。その点、十分な性能を持つハードウェアでは問題ない。以下はPrismMLが公表している数値だ。
| デバイス | 1ビット | 3値 |
|---|---|---|
| iPhone 17 Pro | 11 tok/s | — |
| Apple M5 Max | 87 tok/s | 58 tok/s |
| NVIDIA RTX 5090 | 163 tok/s | 134 tok/s |
スマートフォンで毎秒11トークンなら、飛び抜けて速いわけではないものの、チャットや短い推論には使える。M5 Maxでの毎秒87トークンは、ネットワーク往復の時間まで含めると、短いプロンプトではクラウドAPIよりローカル推論のほうが速くなる水準だ。PrismMLは成果を示す指標の1つとして、GBあたりのベンチマークスコアであるintelligence densityも挙げている。Bonsaiは約0.53で、フル精度ベースラインのおよそ10倍とされる。
Bonsai 27Bを今すぐ動かす4つの方法
重みがオープンに公開されているため、単一の「インストール方法」があるわけではない。セットアップ不要の方法から細かな制御ができる方法まで、現時点で使える4つを紹介する。
iPhoneで使う
Locally AIのiOSアプリでは、3.9GBの1ビット版を端末上で直接動かせる。アカウントもサーバーも不要だ。ダウンロード後は完全オフラインで利用でき、「27Bをスマートフォンで動かす」という約束をもっとも素直に実現する方法でもある。
ブラウザで試す
PrismMLは、ブラウザタブ内で1ビットモデルを動かすWebGPUカーネルも公開している。インストールなしで試せるため、ディスク容量を使う前にBonsai 27Bを確認する最短ルートだ。ただしWebGPU対応GPUを備えたマシンが必要になる。
自分のマシンで動かす
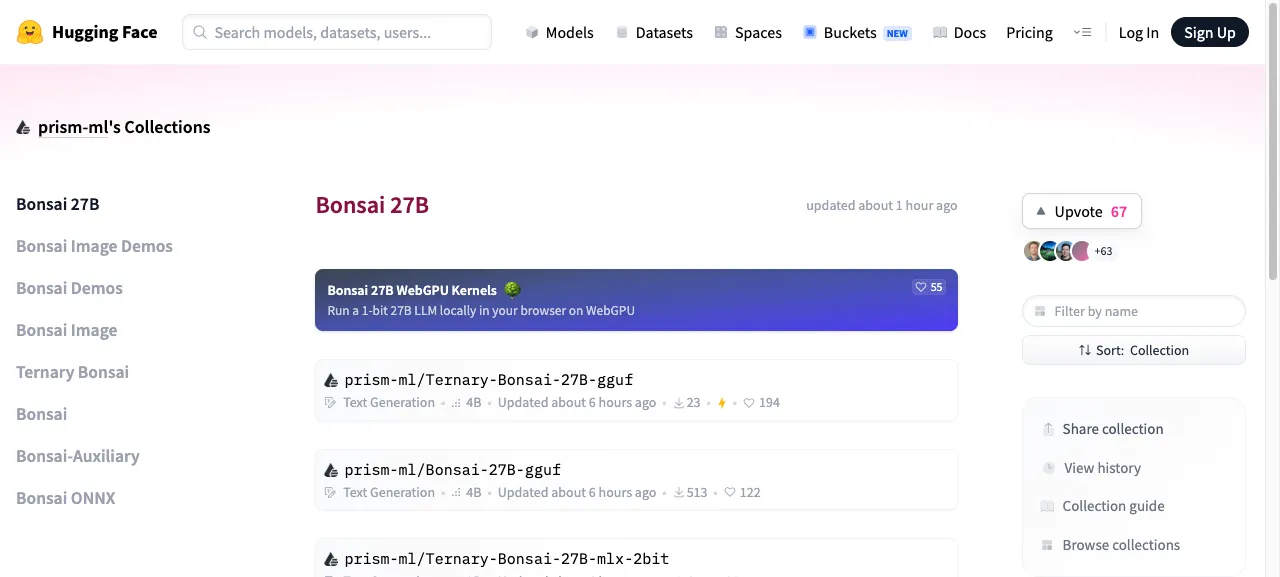
GGUF、MLX、ONNXの重みはすべてHugging FaceとGitHubでApache 2.0の下に公開されている。主要リポジトリは、1ビット版のprism-ml/Bonsai-27B-ggufと、3値版のprism-ml/Ternary-Bonsai-27B-ggufだ。MLXの2ビット版とONNX版も用意されている。必要な空きストレージとRAMの目安は、1ビット版で約4GB、3値版で約6GB。注意点として、ツールの対応状況はリリースに追いついていない。複数のランタイムで重みは読み込めるものの、LM Studioのような人気ローカルアプリでの完全対応はローンチ時点では整っておらず、手動セットアップを見込んでおく必要がある。
ホステッドAPI経由で使う
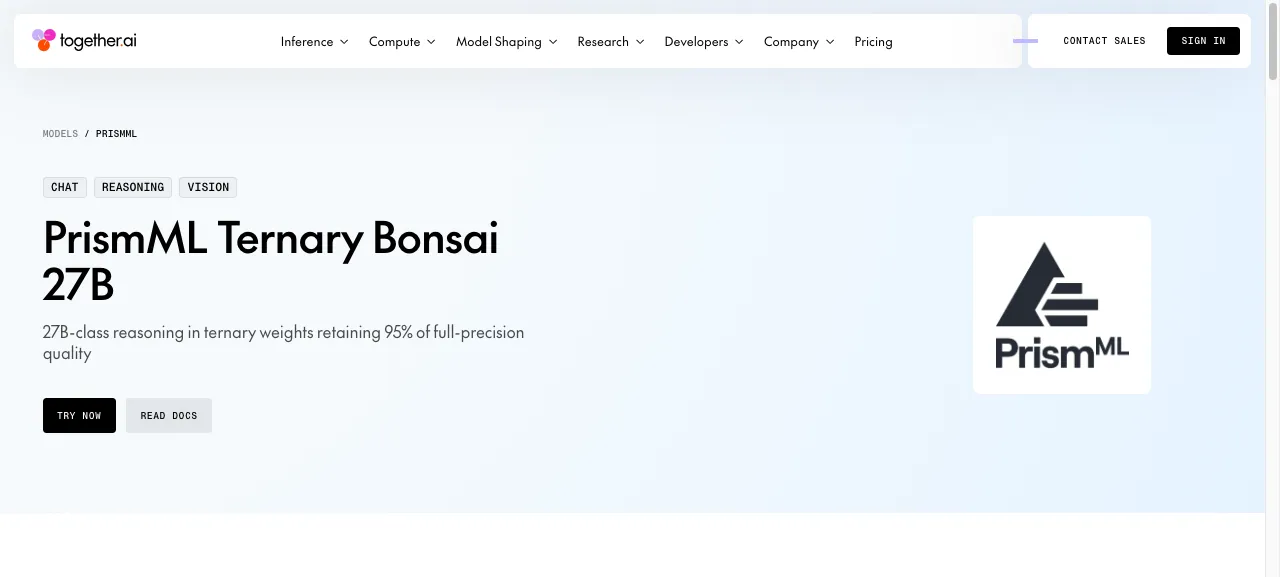
重みを管理したくなければ、Together.aiが3値版を標準API経由で提供している。262Kのコンテキストウィンドウ、画像入力、JSON modeに対応する。ローンチプロモーション期間中の入力料金は100万トークンあたり$0.00と掲載されていたが、プロモーション価格は変動するため、予算を組む前に現行料金を確認してほしい。
Bonsai 27BとGemma 4 12B QATの違い
比較対象としてよく名前が挙がるのが、Googleの量子化対応学習モデルGemma 4 12B QATだ。サイズは約7GBで、Bonsaiの3値版よりわずかに大きい。
両者は異なる軸で強みを持つ。27BベースであるBonsai 27Bは、数学とコーディングのベンチマークでGemmaを明確に上回る。一方のGemmaは、画像理解とツール呼び出しでより安定しやすく、少し大きく量子化も控えめな重みにより、スマートフォン向けの汎用モデルとしては堅実な選択肢になる。端末上の主用途が推論やコードならBonsaiが有力で、画像や関数呼び出しへの依存度が高いならGemma 4 12B QATのほうが安全だ。
Bonsai 27Bを使うべき人、避けるべき用途
オフラインかつプライベートな環境で、端末上の推論支援やコーディング支援を求めるならBonsai 27Bは向いている。iPhone 17 Pro級の端末、あるいは十分な性能のノートPCがあればよい。極端な量子化に関心がある人にとっても、27Bモデルがブラウザタブで動作する事実は格好の研究対象だ。Apache 2.0のオープンライセンスにより実験しやすい点も大きい。ローカル実行の選択肢を加えたい場合、プログラミング向けの無料で使えるオープンモデルとも自然に組み合わせられる。
反対に、信頼性の高いツール呼び出しに依存する本番エージェントシステム、画像理解が重要なタスク、推論ループが大きな損失につながる用途には、現時点では使わないほうがよい。そのようなケースでは、圧縮を抑えたモデル、あるいはAPI経由のフル精度モデルがより安全な選択となる。
よくある質問
Bonsai 27Bは無料で使えますか?
重みはApache 2.0ライセンスで無料公開されており、ダウンロードして無料で実行できる。Together.ai経由のホステッド利用には別途API料金がかかる。ローンチ時には入力100万トークンあたり$0.00と掲載されていたため、現在の料金を確認してほしい。
Bonsai 27Bは本当にスマートフォンで動きますか?
はい。1ビット版は3.9GBで、Locally AIアプリを通じてiPhone 17 Pro上でおよそ毎秒11トークンで動作する。ダウンロード後は完全オフラインで利用可能だ。
Bonsai 27Bはフル版のQwen3.6 27Bと同等ですか?
近い性能ではあるが、完全に同じではない。3値版はフル精度のベンチマーク性能を95%以上、1ビット版は90%以上維持する。維持率が最も高いのは数学とコードで、最も低いのはツール呼び出しだ。
どのBonsai 27Bファイルをダウンロードすべきですか?
スマートフォンやメモリに余裕のないマシンでは、1ビット版のprism-ml/Bonsai-27B-gguf(約3.9GB)を選ぶ。余裕のあるデスクトップやGPU環境では、精度を数ポイント上げられる3値版のprism-ml/Ternary-Bonsai-27B-gguf(約5.9GB)がよい。Apple Silicon向けにはMLX 2ビット版があり、クロスプラットフォームのランタイム向けにはONNX版も存在する。
3値量子化とは何ですか?
モデルの各重みをフル精度の数値ではなく、-1、0、+1の3つの値のいずれかとして保存する方式だ。これによってモデルを大幅に小さくできる。FP16のスケーリング係数により、値を絞り込んだ重みもおおむね適切な大きさに保たれる。
Bonsai 27Bは画像に対応していますか?
はい。Qwen3.6 27Bベースのマルチモーダル機能を引き継いでおり、テキストと画像を入力してテキストを出力できる。ただし圧縮後の画像理解性能は、数学やコードほど良好には維持されていない。