 AIREITER
結論から言うと、自然な文体やトーンを最優先するならClaude Sonnet 5、大量処理なら1,000件あたり約$0.10のDeepSeek V4 Flash、速度も含めてバランスよく選ぶならGPT-5.6 Terraが有力だ。2026年7月17日に6モデルをテストした結果、この3つがそれぞれの用途で頭ひとつ抜けた。
各モデルのAPIへ、同じ翻訳プロンプトを3本ずつ送信し、出力をそのまま比較した。意外だったのは翻訳品質ではない。技術的な英独翻訳は6モデルすべて正確で、日本語の主語省略を含む会話も6モデル中5つは一切ミスなく処理した。差が開いたのはコストだ。「安価」に見える2モデルは、リクエストごとに大量の推論トークンを消費し、翻訳1件あたりではClaudeの8〜10倍に達した。DeepLの文字単価にもかなり近づいている。
2026年に翻訳用LLMを選ぶ際、問うべきは「翻訳できるか」ではない。どのモデルも翻訳自体はできる。重要なのは、コンテンツの種類と処理量に合い、知らないうちにコストが膨らまないモデルを選べるかどうかだ。
用途別:翻訳に選ぶべきモデル
| 用途 | おすすめ | 選ぶ理由 | 実測:1,000件あたりのコスト |
|---|---|---|---|
| マーケティングコピー、ブランドトーン | Claude Sonnet 5 | 翻訳文ではなく、翻訳先の言語で書き下ろした文章として読める | 約$1.06 |
| 商品フィード、文書、字幕などの大量処理 | DeepSeek V4 Flash | 3テストすべてで正確、圧倒的に低コスト | 約$0.10 |
| 混在ワークロード、低レイテンシー重視 | GPT-5.6 Terra | 応答は3.0〜4.3秒、書式処理も最もきれい | 約$0.88 |
| 用語集の強制、CATツール中心の運用 | DeepL | LLM APIにはない用語ベースと統合機能を備える | 100万文字あたり$27.50 |
コストは3つのテスト課題における平均値で、出力トークン数に2026年7月時点の公式料金を掛け、短い翻訳1,000件に換算したものだ。詳細な測定値は後述する。なお、ライブ音声会話は今回の対象外である。Googleには用途特化型のGemini 3.5 Live Translateがあり、料金は100万トークンあたり入力$3.50/出力$21だが、今回は参照のみでテストしていない。
テスト方法
2026年7月17日、まったく同じ文面のプロンプトを各モデルに1回ずつ送った。課題は、英語→日本語のマーケティングコピー(トーンの評価)、英語→ドイツ語のAPIドキュメント(専門用語の評価)、日本語→英語のカジュアルな会話(主語省略と文脈理解の評価)の3種類。最後の課題は、中国語・日本語・韓国語を指すCJK言語ペアで起きやすい翻訳ミスを確認するためのものだ。
対象モデルはGPT-5.6 Terra、Claude Sonnet 5、DeepSeek V4 Flash、DeepSeek V4 Pro、GLM-5.2、Kimi K2.6。すべて同じゲートウェイアカウントからデフォルト設定で呼び出した。そのためレイテンシーはモデル間で比較できる一方、実際の数値は利用地域やプロバイダーの負荷によって変動する。
再実行できるよう、使用した原文をそのまま掲載しておく。
EN→JA(マーケティング): "Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters." EN→DE(技術文書): "If a request exceeds the rate limit, the API returns a 429 status code. Retry with exponential backoff and honor the Retry-After header. Idempotency keys prevent duplicate charges when a retry succeeds." JA→EN(会話): 「昨日の件、もう部長に話した?」「いや、まだ。タイミング見て言うつもりだけど、たぶん怒られるだろうな。」「先に根回ししといたほうがいいって。うちの部長、後から聞かされるの一番嫌がるから。」
モデル・課題別の全測定値は以下の通り。表記はレイテンシー(実時間の秒数)/usageオブジェクトに含まれる出力トークン数。
| モデル | EN→JA | EN→DE | JA→EN | 1タスクあたりの平均コスト |
|---|---|---|---|---|
| GPT-5.6 Terra | 3.0秒 / 46 | 4.3秒 / 67 | 3.2秒 / 63 | $0.00088 |
| Claude Sonnet 5 | 3.5秒 / 60 | 4.0秒 / 146 | 3.5秒 / 111 | $0.00106 |
| DeepSeek V4 Flash | 5.2秒 / 421 | 4.3秒 / 371 | 4.7秒 / 323 | $0.00010 |
| DeepSeek V4 Pro | 16.5秒 / 769 | 18.0秒 / 989 | 19.6秒 / 946 | $0.00078 |
| GLM-5.2 | 30.8秒 / 1,906 | 29.0秒 / 1,590 | 35.2秒 / 1,985 | $0.00804 |
| Kimi K2.6 | 19.6秒 / 2,849 | 48.5秒 / 2,235 | 23.6秒 / 2,413 | $0.01000 |
タスク単価は、出力トークン数×各社の公式出力料金で算出した。入力はタスクあたり60〜110トークンで、GPT-5.6 Terraの料金で計算しても追加コストは$0.0003未満となる。後半の100万文字あたりの比較には入力分も含めた。料金はすべて2026年7月17日時点の公式リスト価格であり、今回のアカウントに実際に適用された割引料金ではない。
3課題だけのスポットチェックで、100の言語ペアにまたがる優劣を決められるとは考えていない。ただし、小さなサンプルでも一貫して現れる差を捉えることはできる。今回見えた差は、かなり大きかった。
テスト1:英語→日本語のマーケティングコピー
プロンプトでは、SaaSのランディングページにある「Ship your ideas faster. Our platform handles the busywork so your team can focus on what matters.」を、自然で丁寧な日本語に訳すよう求めた。
Claude Sonnet 5の出力は次の通り。
アイデアを、もっとスピーディーにカタチへ。面倒な作業はプラットフォームにお任せください。
日本語のコピーライターが使うレジスターに近い。あえて「カタチ」と表記する感覚や、読点で刻むリズムは、教科書的な文法ではなくランディングページの表現だ。GPT-5.6 TerraとDeepSeek V4 Proも、「アイデアを、より迅速に形に。」のような、端正でビジネス向きの訳文で僅差に続いた。
6モデルで最も直訳寄りだったのはDeepSeek V4 Flashで、「アイデアをより速く実現しましょう。当社のプラットフォームが雑務を代行するため…」という出力だった。文法的な問題はないが、翻訳文らしさは残る。プロダクトページに使うなら人の手で仕上げたい。一方、サポート記事や社内文書なら十分実用的だ。
ここには確かに差があるものの、差は小さい。6モデルすべてが使える日本語を出した。Claudeに1,000件あたり約$1を追加で払う価値が最も出るのは、ブランドの声を守る仕事だ。今回のテストでは、ほかの用途でここまで差が重要になる場面はなかった。
テスト2:英語→ドイツ語の技術文書
APIドキュメントから、レート制限、HTTP 429、指数バックオフ、冪等性キーを含む2文を翻訳した。専門用語は6モデルすべて正確で、ドイツ語の技術文書として自然な表現、すなわちRatenlimit、Statuscode 429、exponentielles Backoff、Idempotenzschlüsselを用いていた。
目に見える違いはひとつだけ。GPT-5.6 TerraはRetry-Afterをコード書式で囲んだ。実際のドイツ語APIドキュメントでヘッダー名を組む際の流儀に合っている。細かな気配りではあるが、品質差と呼ぶほどではない。
リソースが豊富な欧州言語間で、一般的なドキュメント文章を訳す限り、今回のサンプルではどのモデルにも誤りがなかった。この世代では品質差が小さすぎて観測できない。ワークロードのすべてがこの種の文書なら、品質ではなく価格と速度で選ぶべきだ。そうなると、100万トークンあたり入力$0.14/出力$0.28のDeepSeek V4 Flashが標準的な回答になる。
テスト3:主語省略を含む日本語会話の英訳
日本語では主語が日常的に省略されるため、翻訳者は誰が何をするのかを文脈から補わなければならない。今回の会話には、正式な意思決定の前に水面下で合意を作る「根回し」という、直接対応する英単語のない文化依存の表現も含めた。
6モデル中5つは問題なく処理した。主語の割り当ては正確で、根回しも「lay the groundwork」「sound him out beforehand」「give him a heads-up」など、どれも成立する表現に訳された。Claudeの訳は最もネイティブの会話らしく、「he's probably gonna chew me out」と表現していた。
全18出力のうち、明確な誤りはDeepSeek V4 Proの1件だけだった。「先に根回ししといたほうがいい」という、これから何をすべきかという助言を、「You should've laid the groundwork first」と訳した。これは、すでに機会を逃したことへの過去形の後悔を表す。小さな語の違いだが、意味は逆になる。同僚が一方を言って、もう一方として受け取れば、取る行動も変わる。
1回の実行で1つの時制ミスがあったからといって、モデル全体の結論にはならない。2つのDeepSeekティアについては、DeepSeek V4 Flash vs Pro比較で詳しく検証している。それでも、流暢さと忠実さは別の性質だという好例にはなる。文としては完璧に読めても、意味が違うことはある。契約書、医療コンテンツ、あるいは時制の読み違いが金銭的な損失につながる用途では、どのモデルを選ぶにしても人によるレビューの予算を確保したい。
料金表だけでは見えない「トークン消費」の罠
購入判断を変える重要な発見がここにある。出力100万トークンあたりでは、GLM-5.2は$4.40、Kimi K2.6は$4.00で、Claude Sonnet 5の$10の半額以下だ。ところが実際の翻訳1件あたりでは、両者とも8〜10倍高くついた。
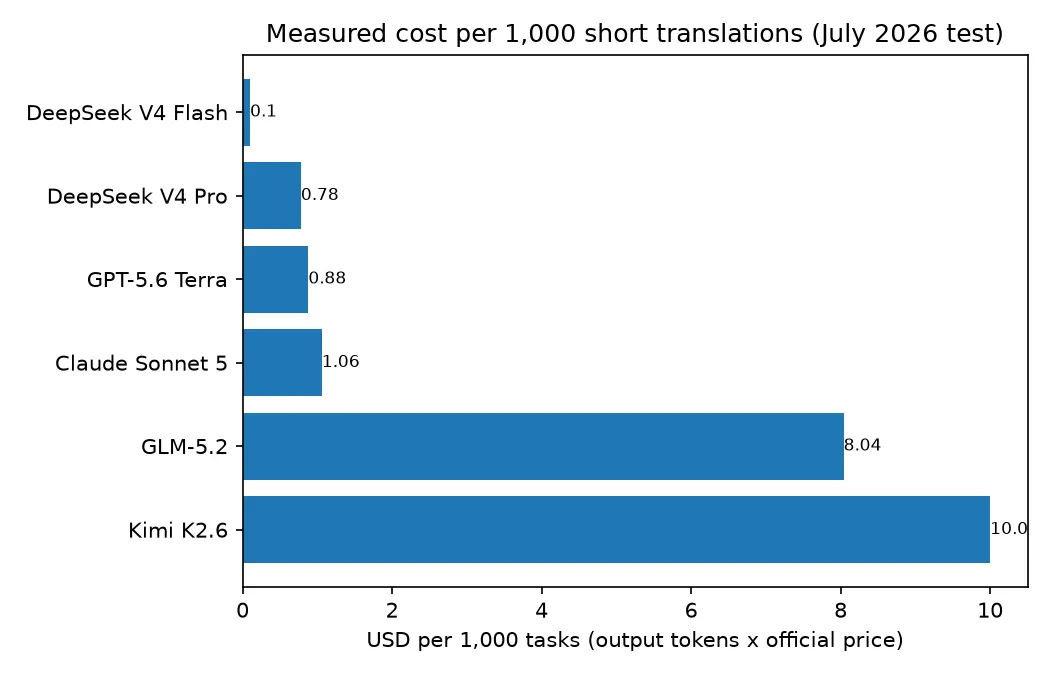
理由は、どちらのモデルも回答前に可視化された推論チェーンを走らせ、その推論トークンが出力として課金されるためだ。マーケティング文1文の翻訳で、Kimi K2.6は2,849出力トークン、GLM-5.2は1,906出力トークンを出した。完成した翻訳自体は40〜60トークンである。同じ課題でClaude Sonnet 5は60トークン、GPT-5.6 Terraは46トークンだった。
レイテンシーも同じ傾向を示した。GPT-5.6 TerraとClaude Sonnet 5は、3課題すべてで3〜4秒以内に回答。DeepSeek V4 Flashは4〜5秒、DeepSeek V4 Proは16〜20秒、GLM-5.2とKimi K2.6はリクエストあたり20〜48秒を要した。
ここから実務上のルールが2つ導ける。第一に、翻訳のような短く大量のタスクでは、モデルをリスト価格で比べず、タスクあたりの実測コストで比較すること。20件ほど実行し、usageフィールドを確認すればよい。第二に、翻訳では推論をオフ、または弱くすること。DeepSeekにはthinkingとnon-thinkingのエンドポイントが分かれており、GLMとKimiはリクエストボディでthinkingパラメータを指定できる。今回の3課題では、推論チェーンによる出力品質の改善は確認できなかった。
大量翻訳ではいくらかかるのか
実測したトークン消費量を、英語原文100万文字、すなわち約250,000トークンに換算すると、差はさらに大きくなる。
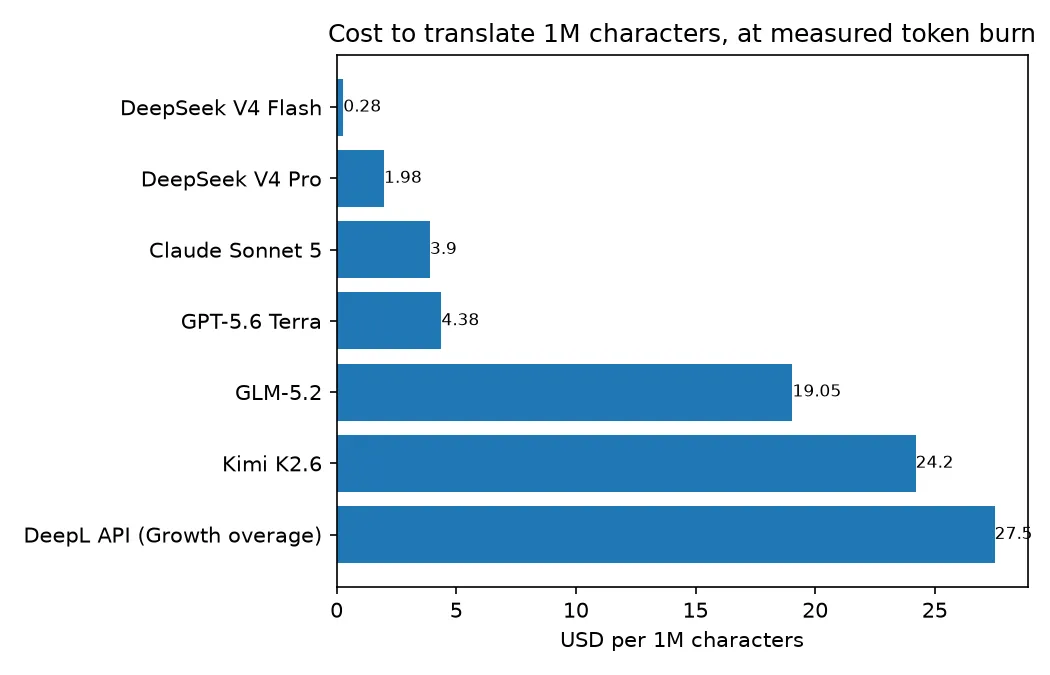
DeepSeek V4 Flashなら、小説1冊分に相当するテキストも約$0.28で翻訳できる。同じ量をDeepLのAPIで処理すると、Growthプランの超過料金では$27.50。98倍の差だ。この傾向は、「LLMs are 800x cheaper for translation than DeepL」という広く共有されたr/LocalLLaMAの分析とも一致する。そちらで倍率がさらに大きいのは、より小規模なセルフホストモデルを使っているためだ。
ただしグラフ上位にも注目したい。実測のトークン消費量で計算すると、推論を多用するオープンウェイトモデルはDeepLとの差をかなり縮めてしまう。トークン数を測らずに単価だけ見ても、コスト見積もりにはならない。
契約前に知っておきたい料金面のポイントを3つ挙げる。いずれも2026年7月17日に確認した。
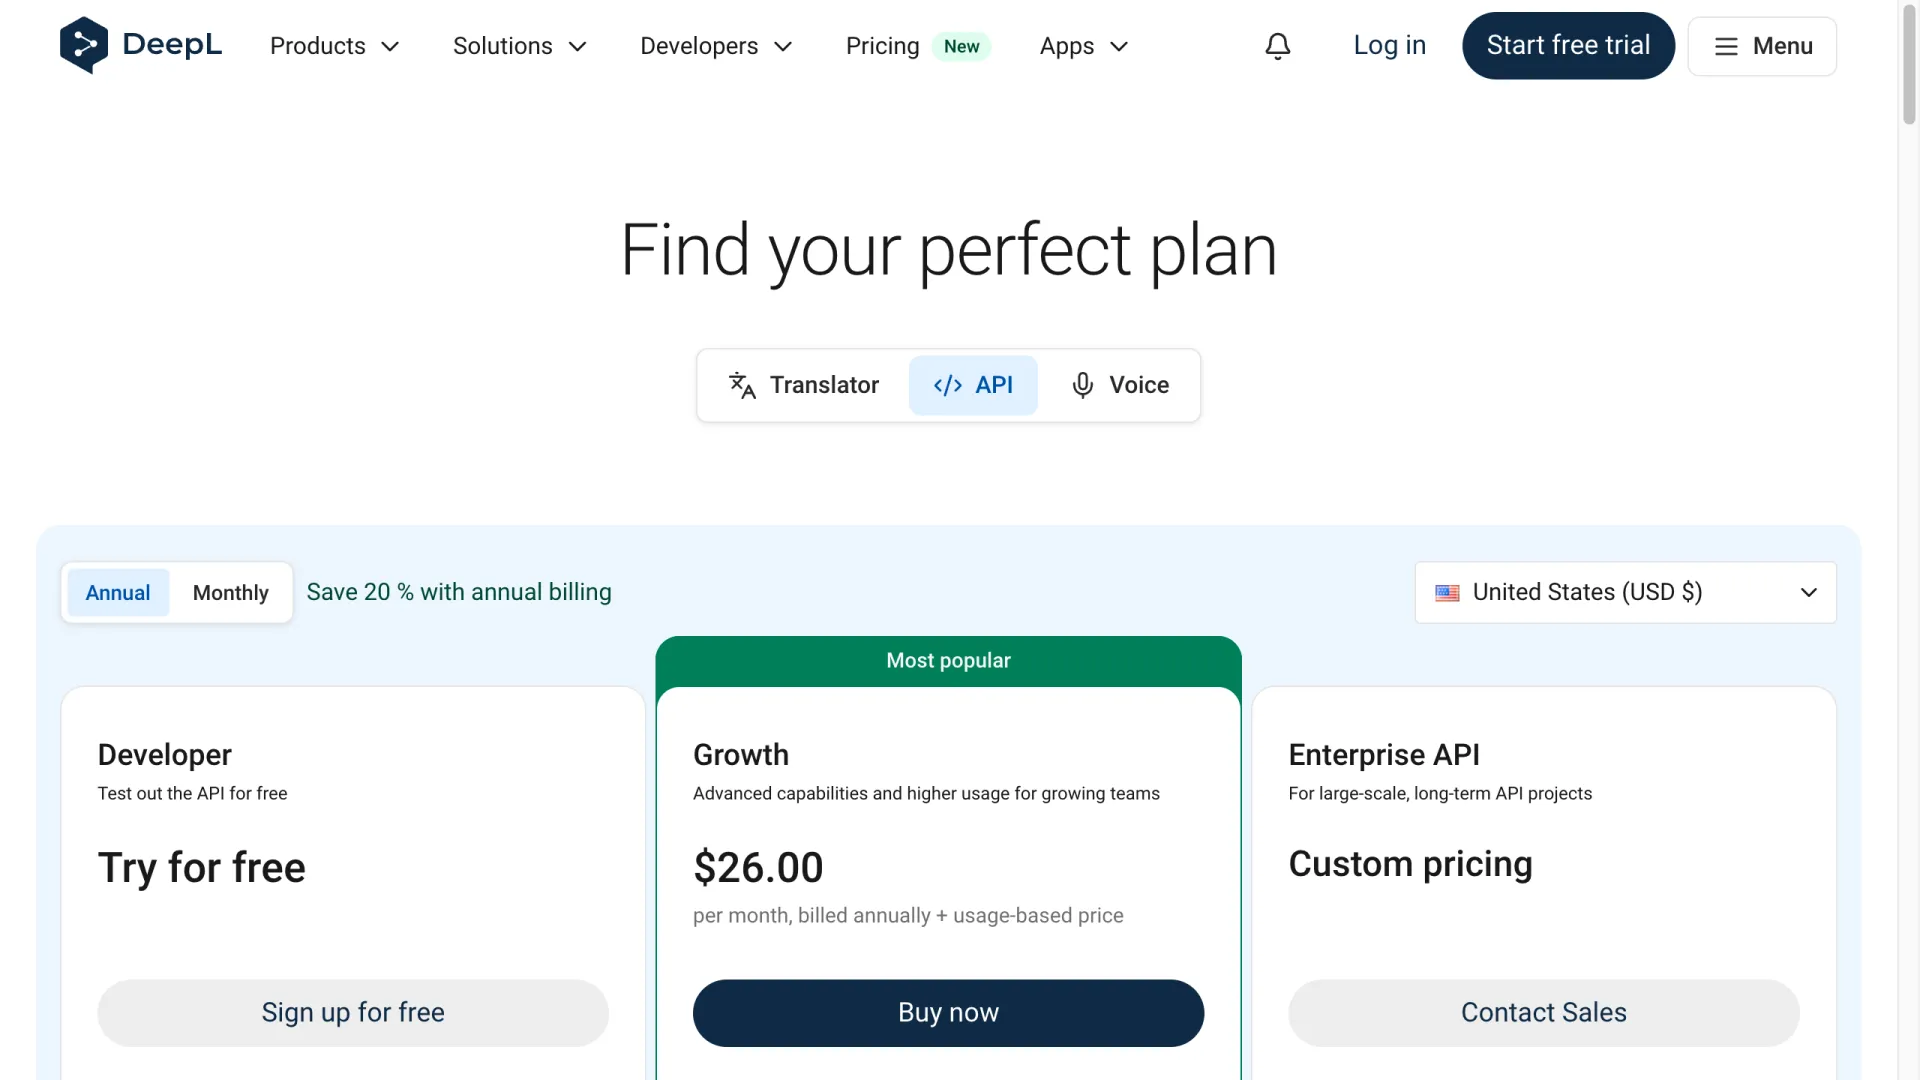
- DeepLの無料枠は変わった。 API Developerプランで付与されるのは、現在は1,000,000文字の一度きりのクレジットだ。古いドキュメントやフォーラム回答で見かける、月間500,000文字の無料枠ではない。Growthは年払いで月額$26、年間12M文字を含み、超過分は100万文字ごとに$27.50となる。
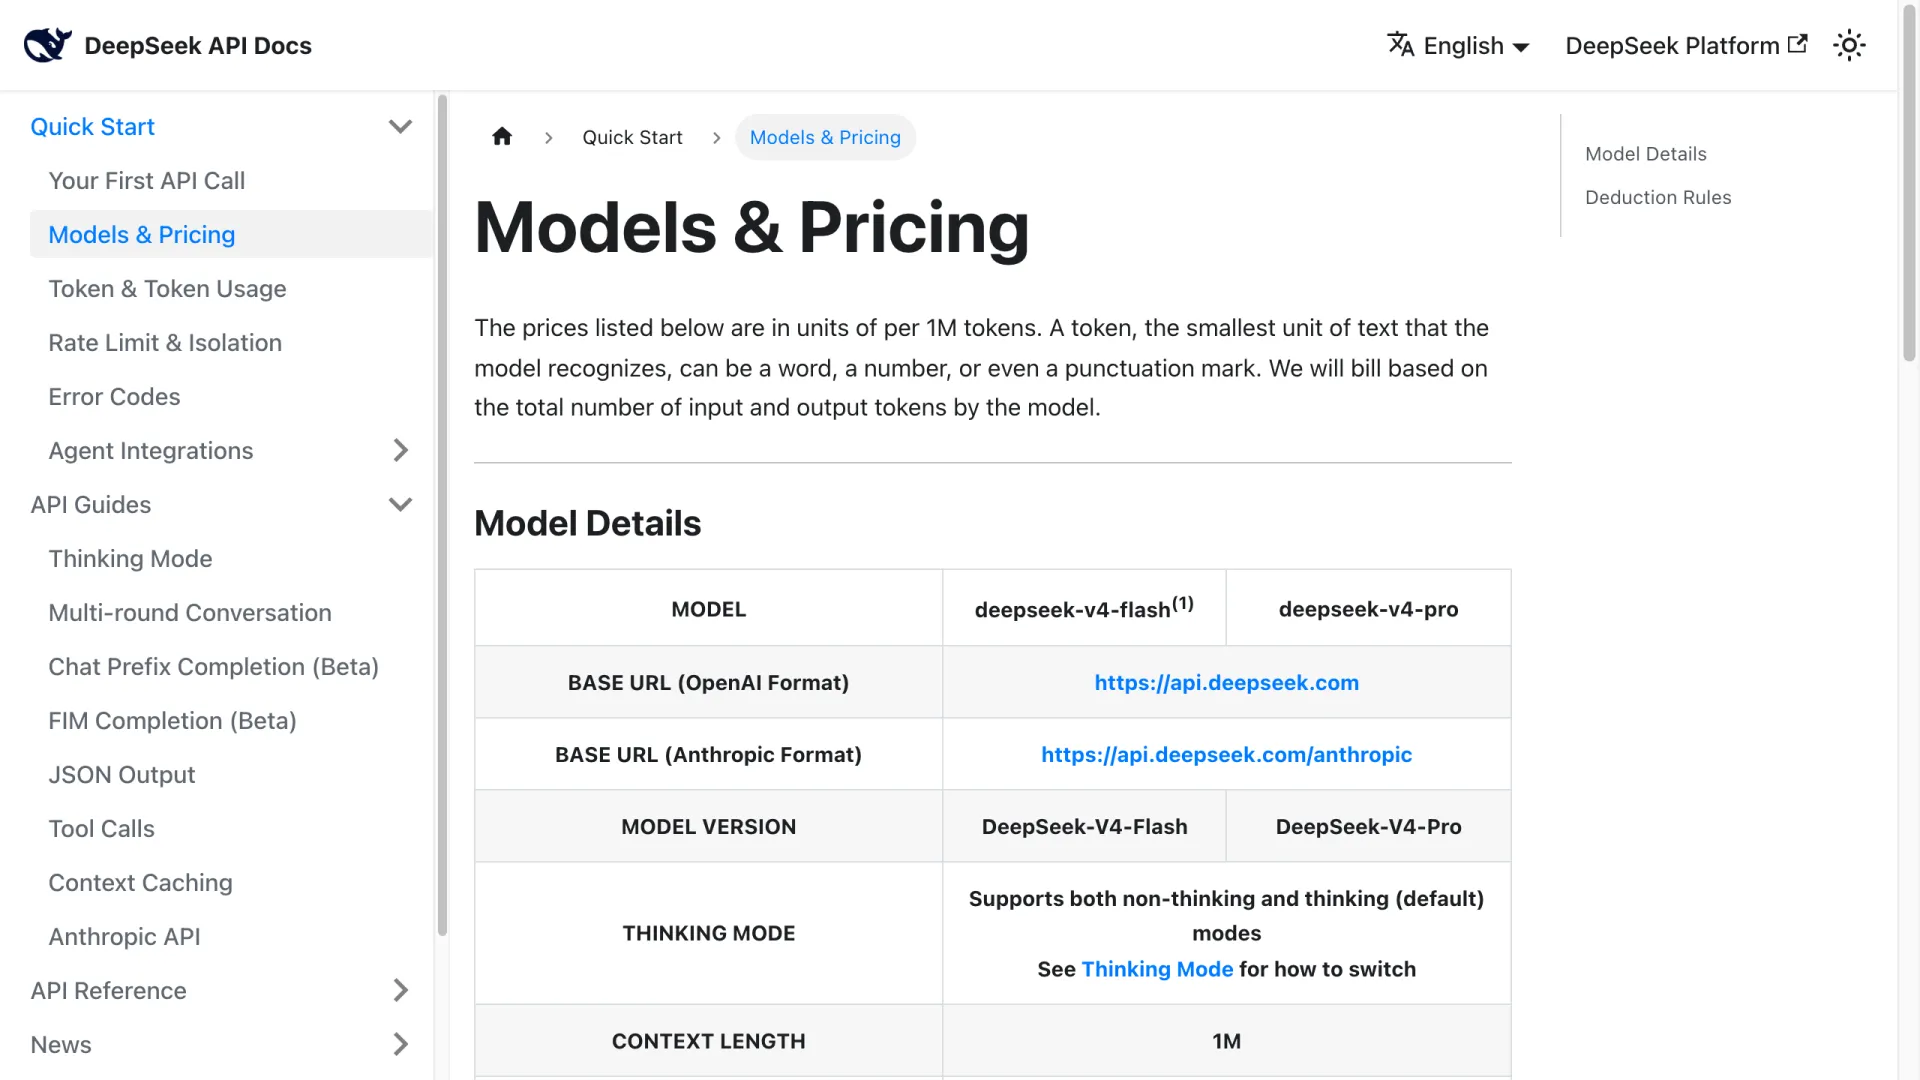
- DeepSeekの料金は他社の一部にとどまる。 V4 Flashは100万トークンあたり入力$0.14/出力$0.28で、キャッシュヒット時の入力は$0.0028まで下がる。旧モデル名のdeepseek-chatは2026年7月24日に廃止される。
- Claude Sonnet 5は導入価格で提供されている。 100万トークンあたり入力$2/出力$10は2026年8月31日までで、その後は$3/$15になる。新しいトークナイザーは同じテキストでもトークン数が約30%多くなるため、本記事のコスト計算にもそれを含めている。9月以降を見据えるなら、両方を予算に織り込む必要がある。
- Batch APIなら請求額を半分にできる。 OpenAI、Anthropic、Googleはいずれも非同期バッチ処理に約50%の割引を提供している。翻訳は通常レイテンシーに敏感ではないため、これは実質的に取り逃がす理由のない節約だ。バッチ料金ならGPT-5.6 Terraは100万文字あたり約$2.19、Claude Sonnet 5は約$1.95になる。
それでもDeepLやGoogle Translateが有利なケース
文字単価ではLLMが有利だが、次の3つの要件では従来型の翻訳サービスに分がある。
- 用語を確実に統一したい。 DeepLは、指定用語を毎回同じように訳すことを保証する用語集とタームベースを提供する。LLMでもプロンプトで指示し、確認することはできるが、それは確率的な挙動であって強制ではない。
- CATツールや既存パイプラインとの統合。 翻訳メモリをCAT(computer-assisted translation)ツールで運用しているなら、DeepLのコネクターを直接利用できる。
- 大規模処理で1秒未満の応答が必要。 従来のニューラル機械翻訳エンジンは、一般的なLLMより高速に応答することが多い。UI内のインライン翻訳では、この差が重要になる。
ライブ音声には、従来のNMTもチャットLLMも最適な形ではない。Googleは音声専用のGemini 3.5 Live Translateを、100万トークンあたり入力$3.50/出力$21に加え、音声の分単位料金で提供している。詳細はGemini 3.5 Live Translateの解説で扱った。
希少言語や低リソース言語では、品質ランキングより対応言語の有無が先だ。比較を始める前に、対象の言語ペアがサポートされているか確認したい。DeepLの対応は約30言語で、大規模LLMは100以上の言語を扱えるものの、対応範囲の端に行くほど品質は低下する。
オープンソースとローカル運用の選択肢
GLM-5.2とKimiのKシリーズはいずれもオープンウェイトを公開している。そのためセルフホストするなら、前述したトークン消費の問題は解決可能だ。サンプリング設定を自分で管理し、推論チェーンを完全に抑制できる。
単一GPUでローカル翻訳を行うモデルとしては、英語と欧州言語の組み合わせでQwen3-30B-A3Bを推す声が、ローカル翻訳モデルを扱うr/LocalLLaMAのスレッドで繰り返し見られる。言語ペアがより特殊になるほど、より大きなモデルが勧められる。動機は品質よりも、契約書や未発表製品を扱う際のプライバシー、あるいは限界費用ゼロであることが多い。同じスレッドでも、翻訳品質ではホスト型の最先端モデルのほうが優れているとされている。
注目しておきたいのは、今週オープンウェイトとして公開されたKimi K3だ。ホスト型の料金は100万トークンあたり入力$3/出力$15。K3のAPIアクセスはまだ段階的な提供中だったため、今回はK2.6をテストした。K3がKシリーズの大きなトークン消費傾向を引き継ぐなら、同じく実測コストに注意が必要になる。
自分のコンテンツで比較する方法
ここまでの比較は、APIコール約20回で再現できる。自社コンテンツから2文を選び、候補モデルそれぞれへ送信し、レスポンスのusageオブジェクトで実際のトークン数を確認すればよい。今回の18リクエストのテスト総額は$0.15未満だった。
面倒なのは、5社分で6モデルのAPIキーを管理することだ。今回の6モデルはすべて、主要モデルのAPIアクセスを単一のAnthropic互換エンドポイントで再販するAIReiterの1アカウント経由で実行した。キーは1つで、上記すべてのモデルに同じワイヤーフォーマットを使える。Claude系のキーはリスト価格のおよそ5分の1だった。
翻訳量が実際に多いなら、自分のコンテンツで1時間スポットチェックする価値は、この記事を含むどんなランキングより大きい。品質差はかなり小さいため、最終判断は言語ペア、必要なトーン、そして実測したトークン量で決めるべきだ。
FAQ
翻訳にはChatGPTとGeminiのどちらがよい?
今回のテストでは、GPT-5.6 Terraは3課題すべてで高速、正確、かつ書式もきれいだった。Geminiはゲートウェイに含まれていなかったため直接比較していない。ただし3.5 Flashの公表料金は100万トークンあたり入力$1.50/出力$9と競争力があり、音声ライブ翻訳専用モデルを提供する唯一の事業者でもある。
現在もっとも正確なAI翻訳ツールは?
リソースが豊富な言語ペアでは、最先端モデル間の精度差は小さい。今回テストした6モデルはいずれも、技術的なドイツ語を誤りなく翻訳した。差が出やすいのはトーンで、Claudeは日本語のマーケティングコピーで優位だった。また、主語省略や時制のようなエッジケースでは、DeepSeek V4 Proが今回唯一の明確なミスを出した。
翻訳に最適なオープンソースLLMは?
GLM-5.2とKimi K2.6はいずれもウェイトを公開しており、今回のテストでも正しく翻訳した。セルフホストすれば、ホスト型APIではタスク単価を押し上げる推論チェーンを無効化できる。コンシューマー向けハードウェアでは、Qwen3-30B-A3Bがコミュニティでよく推奨される。
LLMは人間の翻訳者を置き換えられる?
社内文書、サポートコンテンツ、大量の商品テキストなら、おおむね可能だ。モデルによってDeepLの文字単価の1〜16%で済む。DeepSeek V4 Flashは約1%、Claude Sonnet 5は約14%、GPT-5.6 Terraは約16%である。ただし契約書、医療文書、ブランドキャンペーンでは、テスト3の時制ミスが示す通り注意が必要だ。流暢な出力でも意味が反転していることがあるため、読み違いのコストが高い領域では人によるレビューを残すべきだ。
2026年でもDeepLを使う価値はある?
ある。用語集の強制、CATツール統合、1秒未満の低レイテンシーが必要な3つのケースでは有力だ。それ以外では、文字単価の面で擁護しにくい。無料枠も月次ではなく、一度きりの100万文字クレジットに変わっている点には注意したい。