 AIREITER
Generare 38,5 secondi di audio in 2,81 secondi, in locale e senza costi cloud: è quanto è stato osservato su un Mac mini con ZONOS3-Mini di Zyphra. Il modello TTS mixture-of-experts, pubblicato il 9 novembre 2026, conta 800 milioni di parametri complessivi ma ne attiva circa 100 milioni a ogni passaggio. I primi test, però, invitano alla cautela: la demo è in inglese e gira su hardware potente. Risultati simili dipenderanno dal testo, dalla lingua e dalla GPU disponibili.
ZONOS3-Mini: cos'è e come si può eseguire
ZONOS3-Mini è un modello TTS di Zyphra per la clonazione vocale zero-shot: basta fornire un testo e una breve registrazione di riferimento perché il modello parli con quella voce. In alternativa, si possono scegliere 27 voci predefinite e modificarne età, accento e timbro. I pesi sono distribuiti con licenza Apache 2.0 e il codice di runtime con licenza MIT, quindi è consentito l'uso locale e commerciale. Naturalmente, vanno clonate solo voci proprie o per cui si dispone di autorizzazione.
La struttura è una MoE sparsa con 64 esperti e routing top-2, 11 layer che combinano Gated DeltaNet e attenzione globale in rapporto 3:1. Usa inoltre il nuovo Zyphra Audio Codec 1 (ZAC-1), a 15 frame al secondo anziché gli 86 Hz del DAC impiegato da ZONOS2. Secondo Zyphra, il passaggio riduce i token vocali da 774 a 150 al secondo e, a parità di dati, porta a un word error rate circa 10 volte inferiore rispetto a DAC.
Le specifiche principali includono output a 44,1 kHz, generazioni fino a 10 minuti, clip di riferimento fino a 60 secondi per la clonazione raw e fino a 120 secondi per la clonazione tramite embedding. L'addestramento è stato svolto su 112 GPU NVIDIA H100 per 2,5 giorni.
Le modalità di esecuzione sono cinque:
- Playground WebGPU nel browser, senza installazione
- C++/ggml nativo su CPU, CUDA, Metal o Vulkan
- Server Apple MLX
- SGLang o vLLM su server NVIDIA
- API hosted di Zyphra con
zyphra/zonos3-mini, tramite endpoint OpenAI-compatible/v1/audio/speech
I dati di latenza del fornitore parlano di time-to-first-audio sotto i 570 ms nel browser di un Pixel 9 e sotto i 150 ms su un M3 MacBook Air; su una H100 via SGLang, la mediana sarebbe fra 57 e 80 ms, con un throughput di picco fino a 457 secondi audio al secondo. I numeri per smartphone e laptop vanno letti come casi ideali. Nel proprio thread di lancio, Zyphra indicava valori più prudenti, sotto gli 800 ms e sotto i 450 ms sugli stessi dispositivi: prima di fare promesse, conviene misurare sul proprio hardware.
Nei materiali di lancio restano due punti poco chiari: il post tecnico parla di 800M parametri totali, mentre la pagina del modello riporta 886M. Inoltre, nessuna delle due fonti descrive watermarking, misure antiabuso o conservazione dei dati per le voci di riferimento caricate.
Prima prova: il playground nel browser
Il playground esegue l'inferenza sulla GPU dell'utente via WebGPU, senza server né installazione. C'è però un dettaglio poco pubblicizzato: alla prima visita, un primo tester ha rilevato il download di circa 920 MB tra modello e codec prima di poter generare qualsiasi cosa. In seguito, il browser mantiene i file in cache.
Il playground è un buon test iniziale gratuito: prova la clonazione e i controlli per segmento di testo, poi confronta la latenza sul dispositivo meno potente che prevedi di supportare. Il comportamento di WebGPU cambia infatti in base a browser, driver e GPU.
"Non festeggiate dicendo che il TTS cloud è morto ogni volta che un piccolo modello gira nel browser. La compatibilità WebGPU fra browser e driver è piena di insidie. Una demo in inglese che suona bene non dice nulla sulla tenuta del vostro testo di produzione." — @GKev1n, utente reale che sconsiglia di sostituire il TTS hosted basandosi solo sulle demo
Con telefoni datati, grafica integrata o browser non Chromium, non bisogna estrapolare il dato del Pixel 9 senza una verifica diretta.
Clonazione senza trascrizione e controllo parola per parola
- Clonazione zero-shot: fino a 60 secondi di audio di riferimento, senza trascrizione. La modalità con clip raw punta al risultato più naturale; l'embedding del parlante può invece essere riutilizzato e modificato in seguito.
- Progettazione della voce: controllo dell'età, presentazione da maschile a femminile, accenti americano, britannico e australiano, oltre a caratteristiche combinabili come morbida, roca, brillante e profonda.
- Controllo dell'interpretazione: velocità, emozione, proiezione, vivacità, attivazione e sussurro, anche su singoli intervalli di parole. Si può sussurrare solo "I didn't say" e lasciare neutro il resto della frase.
- Modifica dopo la generazione: un modello in stile VoiceCraft sostituisce parole dopo la generazione mantenendo voce e impostazioni, così un nome pronunciato male non obbliga a rigenerare tutto.
Vale la precisazione di Zyphra: i valori relativi a emozione e interpretazione sono obiettivi, non garanzie. Il controllo della velocità può modificare anche volume e altezza, mentre quello della vivacità può influire su altezza e durata.
Test hardware pubblicati: velocità, VRAM e due ostacoli su Windows
| Configurazione | Risultato misurato | Fonte |
|---|---|---|
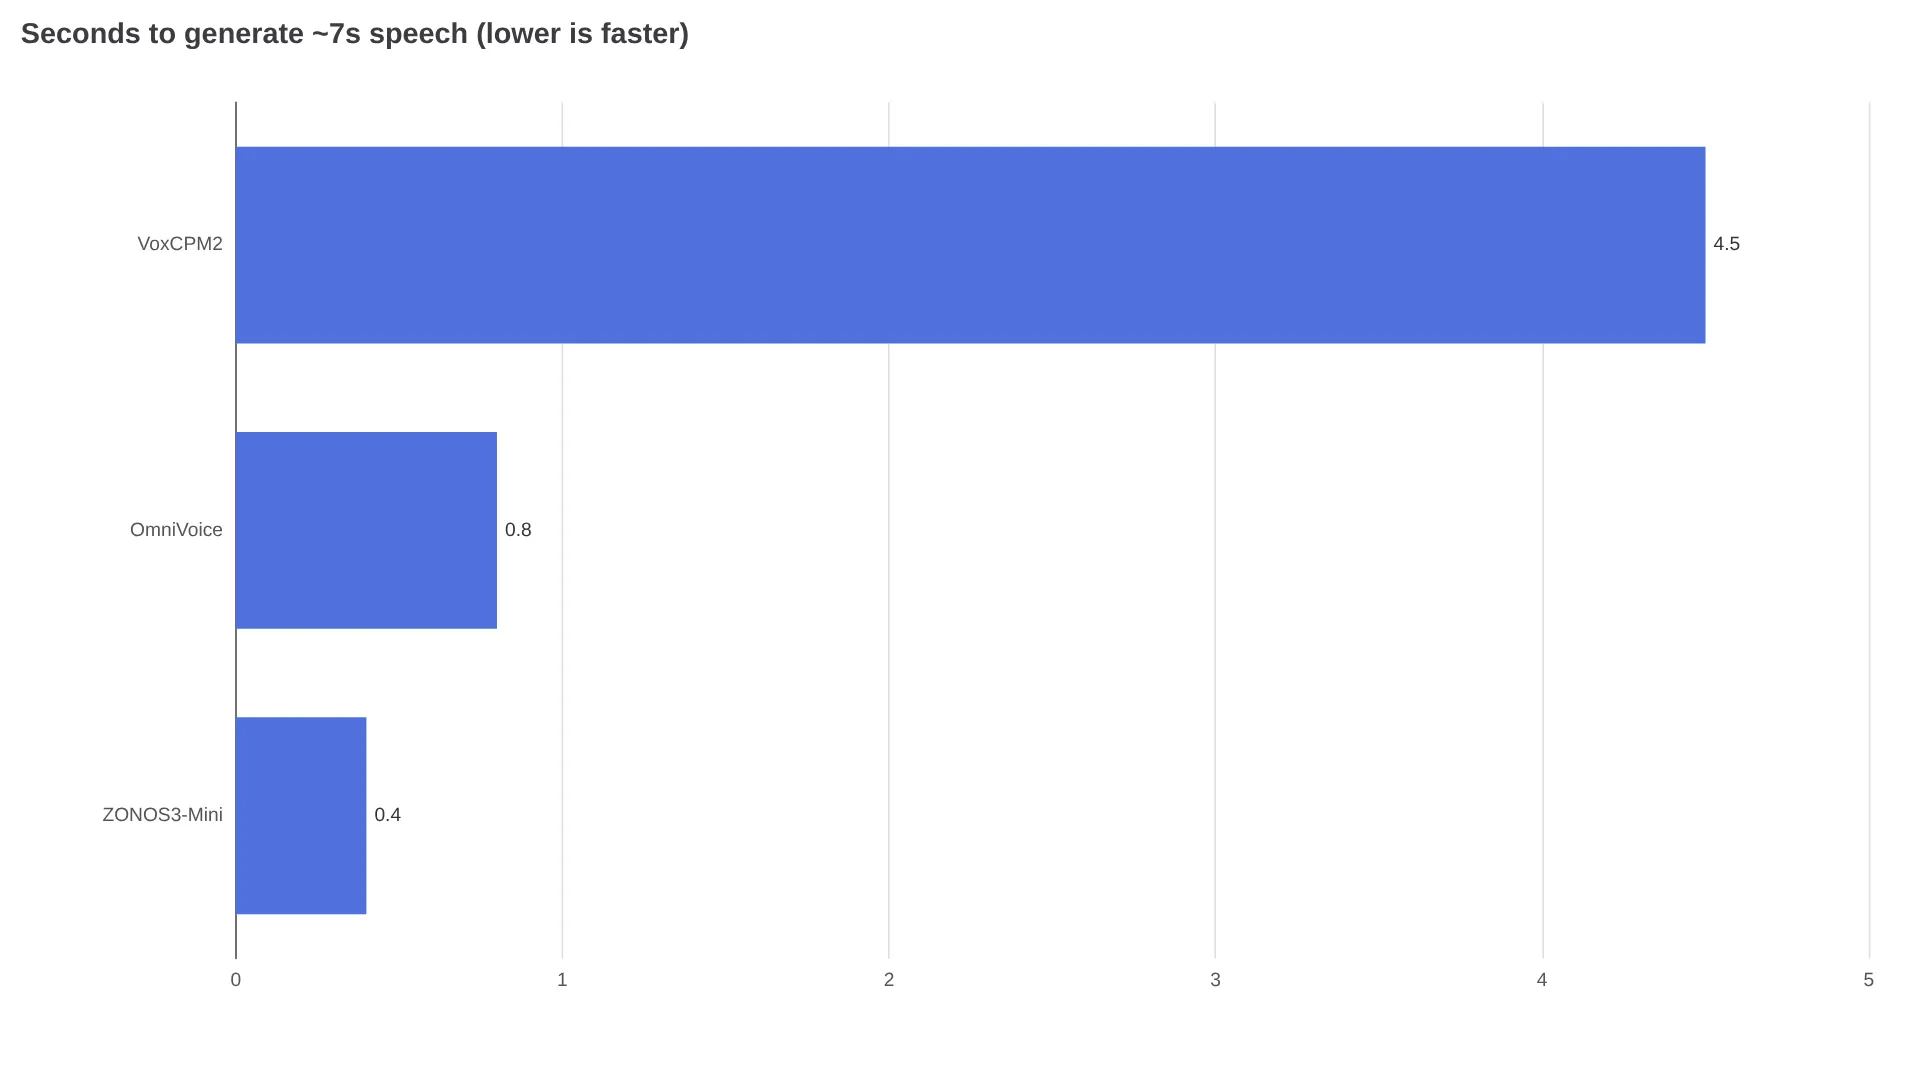
| RTX 5080, ggml quantizzato (backbone da 0,66 GB + decoder da 0,45 GB) | ~7,1 s di parlato giapponese in 0,40 s; 2,4 GB di VRAM totale — real-time factor di 0,056, circa 18 volte più veloce del tempo reale | Benchmark VRAM16 |
| Stessa configurazione: passaggio di 31 s; clip di 7,2 s solo CPU | 1,50 s a 2,5 GB su GPU; la CPU ha richiesto 1,45 s di calcolo, 2,38 s dall'avvio alla fine | Benchmark VRAM16 |
| Mac mini M5 Pro da 64 GB, server MLX | 38,5 s di audio in 2,81 s; 75–100 ms di time-to-first-audio; picco di ~16 GB durante la prima clonazione | @pratikg |
Il risultato su GPU è circa due volte più rapido della precedente misurazione di OmniVoice nello stesso benchmark, e nettamente davanti allo 0,63x rilevato per VoxCPM2.
Il decoder completo da 2,2 GB ha portato l'uso a 4,2 GB, senza che il tester potesse confermare una differenza udibile. Le trascrizioni con Whisper large-v3 coincidevano con il testo giapponese e inglese previsto: una verifica dell'intelligibilità, non della naturalezza o della somiglianza con la voce di riferimento.
La segnalazione locale più veloce arriva da un tester Apple Silicon, con un Mac mini M5 Pro da 64 GB e server MLX:
"BENCHMARKED: ... gira fino a 13,7X più veloce del tempo reale. Questo sul mio Mac mini M5 Pro da 64GB, interamente in locale con il loro server MLX: ~75-100 ms di Time-to-First-Audio (TTFA) usando le voci stock. Ha generato una clip audio di 38,5 s in 2,81 s. Ha clonato una nuova voce da una clip audio di 11-13 s, che ha poi parlato dopo ~1,3 s. ... WER dello 0-4%. Ha usato solo pochi GB di memoria (~16 GB di picco per la clonazione vocale iniziale)." — @pratikg, utente reale con dataset e note pubblicati
Va notata una condizione nascosta in quel risultato: la clonazione iniziale ha toccato circa 16 GB di memoria, mentre le voci clonate in cache andavano veloci quanto quelle stock. Se prevedi di clonare in batch molti parlanti, occorre dimensionare l'infrastruttura sul picco e non sul consumo a regime.
Chi compila dai sorgenti su Windows incontra due problemi documentati dal tester VRAM16, con relative patch. Il compilatore Microsoft rifiutava una struct con un membro chiamato anch'esso head, accettata invece da GCC e Clang: con la patch di rinomina fornita, bisogna quindi compilare soltanto zonos3-cli, zonos3-server e spk-encoder-cli. Inoltre, Windows in giapponese passa il testo della CLI in CP932 anziché UTF-8, producendo audio corrotto finché il programma non rilegge la riga di comando tramite GetCommandLineW. Le richieste JSON a zonos3-server dovrebbero già essere UTF-8, ma questo non è stato verificato.
Per un'installazione pratica, usa un percorso senza spazi né caratteri non ASCII, ad esempio C:\zonos3; installa Visual Studio 2022 con gli strumenti C++, Git e FFmpeg. Una configurazione CUDA pulita richiede circa cinque minuti, con circa 1,2 GB di pesi predefiniti e circa 2 GB di CUDA locale (note di installazione).
API hosted: cosa significano $10 per un milione di byte UTF-8
L'opzione hosted è un endpoint vocale OpenAI-compatible all'indirizzo https://api.zyphracloud.com/api/v1/audio/speech, da chiamare con il modello zyphra/zonos3-mini e un bearer ZYPHRA_API_KEY. Lo snippet seguente avvia un server SGLang-Omni locale, secondo il cookbook SGLang, e usa la stessa forma di richiesta dell'API cloud. È questo il vantaggio: si può prototipare su localhost e poi sostituire l'URL base con Zyphra Cloud.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
Il prezzo è calcolato sui byte, non sui caratteri né sui minuti audio: $10.00 per 1 milione di byte UTF-8, con 1 richiesta concorrente, 100 generazioni al giorno, caratteri di input illimitati e i limiti di clonazione di 60/120 secondi indicati sopra. Per l'inglese semplice, circa un byte per carattere, e ipotizzando 800–900 caratteri per minuto di parlato, $10 equivalgono a circa 1.100–1.250 minuti, meno di un centesimo al minuto. Il calcolo è meno favorevole per i testi CJK: ogni carattere costa circa tre byte, ovvero circa 3 volte di più per carattere. Per input in cinese, giapponese o coreano, conviene quindi calcolare il costo al minuto sui propri script.
L'inferenza locale o nel browser ha un costo marginale vicino allo zero dopo l'acquisto dell'hardware. Il piano hosted è adatto alla prototipazione e ai picchi, ma non alla scala produttiva con una sola richiesta concorrente e 100 generazioni al giorno. I team che necessitano di throughput dovrebbero stimare un deployment self-hosted con SGLang o vLLM, anziché estrapolare dal prezzo di $10.
Confronto con ElevenLabs, Fish, Qwen e il primato dichiarato
Le pagine Zyphra confrontano ZONOS3-Mini con Fish Audio, Qwen, Cartesia, ElevenLabs e OmniVoice su tre copioni: un monologo drammatico da trailer, un lungo brano comico "straight to jail" per testare la coerenza e un passaggio conversazionale in stile podcast. È disponibile anche un grafico Pareto su latenza e throughput. Vale la pena ascoltare direttamente i campioni: le pagine offrono i player, ma non un vincitore scritto, né le versioni dei modelli concorrenti, i seed o una dichiarazione di impostazioni equivalenti.
Anche il ranking numerico richiede prudenza. Lo ZTTS2-Eval di Zyphra copre 35 lingue pulite e 20 lingue in-the-wild, per un totale di 420 elementi metrica-per-set-per-lingua. Il suo Capability Index colloca ZONOS3-Mini al primo posto fra i modelli open, davanti a Fish S2 Pro e MOSS TTS v1.5. Si tratta però di un test nuovo progettato e valutato dal fornitore stesso. Il metodo è pubblico, ma al momento della pubblicazione di questa recensione non sono emerse riproduzioni indipendenti; i confronti con modelli chiusi sono inoltre solo audio, senza punteggio condiviso.
In assenza di risultati per lingua e di vittorie in ascolti indipendenti, restano da dimostrare l'accuratezza dei toni in mandarino, l'accento tonale del giapponese, i caratteri polifonici e l'emozione su testi lunghi. Vanno testati prima di impegnarsi. La lettura più onesta è questa: ZONOS3-Mini spicca per efficienza e flessibilità di deployment, ma la leadership qualitativa non è ancora provata.
Chi dovrebbe passare a ZONOS3-Mini oggi
| Team | Verdetto | Motivo |
|---|---|---|
| Offline, on-device o sensibile alla privacy, come giochi, lettori e chioschi | Da testare subito | Apache 2.0, download predefinito da 1,2 GB, 2,4 GB di VRAM, utilizzabile su CPU, nessun costo al minuto |
| Pipeline per audiolibri o NPC con molte voci | Progetto pilota | Il controllo parola per parola e l'editing post-generazione riducono il costo delle rigenerazioni, ma la somiglianza della clonazione va verificata per ciascun parlante |
| Produzione non in inglese, soprattutto in cinese | Attendere la propria valutazione | Mancano punteggi del fornitore per lingua; le affermazioni su word error rate e prosodia restano orientate all'inglese finché non si testano polifoni e toni |
| TTS hosted ad alta concorrenza | Self-hosting o restare dove si è | Il piano cloud limita a 1 richiesta concorrente e 100 generazioni/giorno; SGLang/vLLM è la vera strada per la produzione |
| Team che richiedono watermarking o audit trail | Attendere | I materiali di rilascio non descrivono watermarking né una policy di retention per le clip di riferimento |
L'ordine di prova consigliato è: playground nel browser, build locale sul dispositivo meno potente, poi API hosted. Il passaggio ha senso soltanto se l'hardware supera le soglie di 2,4 GB di VRAM e WebGPU e se la lingua supera un ascolto alla cieca. In caso contrario, meglio mantenere l'API chiusa in uso e rivalutare quando arriveranno benchmark multilingue indipendenti.
FAQ
Quanta VRAM richiede ZONOS3-Mini?
Circa 2,4–2,5 GB totali sulla RTX 5080 testata; 4,2 GB con decoder completo e un picco iniziale di ~16 GB per la clonazione su Mac.
Può girare nel browser o su CPU?
Sì: via WebGPU, con un download iniziale di ~920 MB, e in uno dei test pubblicati la sintesi solo CPU ha richiesto circa un terzo del tempo reale incluso l'avvio.
Quanto è valida la clonazione vocale?
È zero-shot con fino a 60 secondi di riferimento e senza trascrizione. Un test indipendente ha riportato un word error rate dello 0–4%, ma la somiglianza per ogni parlante va valutata con un proprio test d'ascolto.
È utilizzabile commercialmente?
I pesi sono Apache 2.0 e il codice è MIT, ma occorrono diritti o consenso per qualsiasi voce clonata.
Quali sono endpoint e costo dell'API?
POST https://api.zyphracloud.com/api/v1/audio/speech, OpenAI-compatible, con modello zyphra/zonos3-mini, a $10 per milione di byte UTF-8, con 1 richiesta concorrente e 100 generazioni al giorno.
Approfondimenti correlati: Best Text-to-Speech API, Best Voice Cloning API 2026, Kokoro 82M TTS Local Guide