 AIREITER
Muse Spark 1.2 in sintesi
Pubblicato da Meta il 5 agosto 2026, Muse Spark 1.2 migliora i risultati di coding rispetto alla versione 1.1 e arriva insieme a un nuovo agente da terminale progettato per sfruttarlo. Non basta però a conquistare la vetta: Claude Opus 5 rimane davanti in tutte e tre le classifiche di coding. È questo il punto centrale dell'aggiornamento. Meta ha aumentato il compute dedicato all'addestramento sul codice, co-addestrato il modello con l'agente Muse Code e ottenuto miglioramenti misurabili. Tuttavia, una parte del salto tra versioni dipende dal nuovo harness, non soltanto dal modello; su Terminal-Bench, DeepSWE e la valutazione interna di Meta, il modello Anthropic conserva un vantaggio da 4 a 9 punti.
Il prezzo resta il motivo per cui vale la pena prenderlo in considerazione. Il listino standard è invariato a $1.25/$4.25 per milione di token, mentre il piano contributor lo riduce di circa 12 volte. In cambio, il percorso predefinito autorizza Meta a usare il vostro codice per l'addestramento; inoltre, al massimo livello di reasoning, il tempo al primo token è peggiorato di circa nove volte. Per chi sta valutando Muse Spark 1.2 in produzione, questi due aspetti contano più della posizione in classifica.
Cosa cambia davvero rispetto a 1.1
Muse Spark 1.2 è un aggiornamento focalizzato sul coding del modello di reasoning frontier di Meta, rilasciato il 5 agosto insieme a Muse Code, un agente di coding da terminale ora in beta. Meta stessa lo definisce un «miglioramento moderato» rispetto a Muse Spark 1.1. Una formulazione prudente, per un update che concentra i progressi nei casi più impegnativi per gli agenti di coding: refactoring su più file, lunghe sessioni di debug e attività che vanno ben oltre un singolo prompt.
Il miglioramento deriva da due elementi dell'addestramento. Il primo è che Muse Code è entrato nel loop fin dall'inizio. Meta ha co-addestrato il modello su traiettorie dell'harness campionate per rifiuto, ottimizzandolo per le prestazioni all'interno del proprio agente. L'azienda afferma di avere usato più harness, quindi il modello dovrebbe generalizzare anche ad altri strumenti di coding. Il secondo è un ciclo di auto-miglioramento: Muse Spark 1.1 ha generato ambienti di coding complessi e template per il rispetto delle istruzioni, quindi ha valutato le soluzioni candidate rispetto a tali compiti, creando il dataset di addestramento per la 1.2. Secondo Meta, questo ciclo ha reso 1.2 sensibilmente più capace di seguire istruzioni complesse.
L'aggiornamento interviene sul principale punto debole della famiglia Muse. Al debutto di Muse Spark, nell'aprile 2026, il modello era indietro nel coding agentico: 77.4 su SWE-Bench Verified, contro gli 80.8 di Claude Opus 4.6. Un checkpoint specializzato per il coding, abbinato a un harness costruito appositamente, è la risposta diretta di Meta, senza rinunciare alle capacità agentiche generali.
Come leggere i benchmark senza farsi ingannare
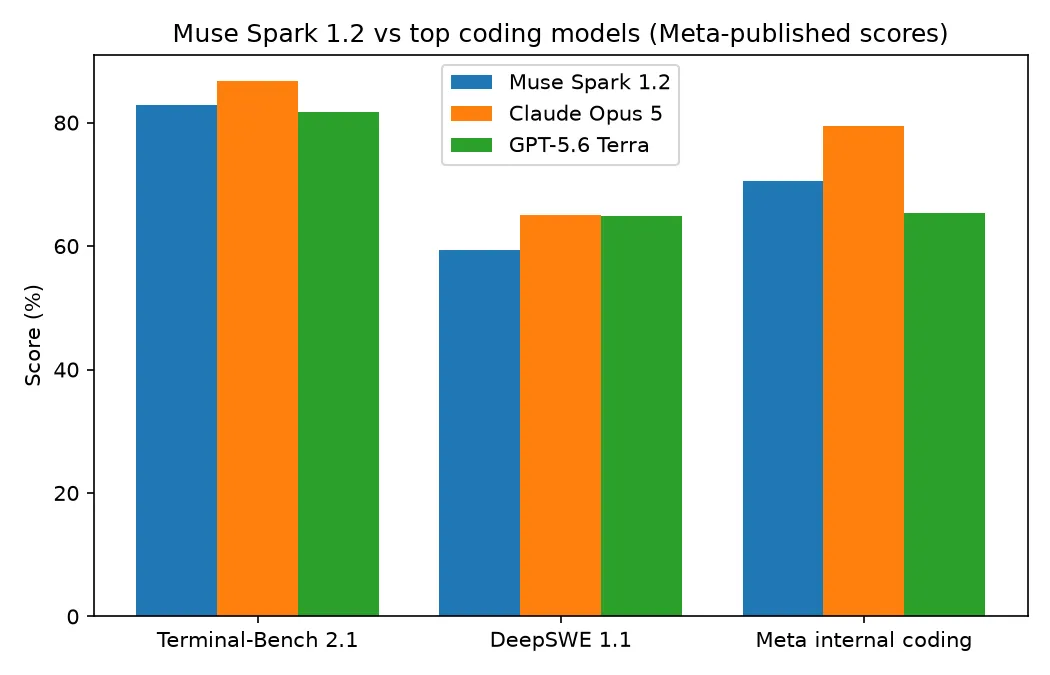
Su Terminal-Bench 2.1, Muse Spark 1.2 eseguito in Muse Code ha ottenuto l'82.9%, superando di poco GPT-5.6 Terra in Codex, fermo all'81.8%, e Grok 4.5 in Grok Build, all'81.6%. Claude Opus 5, però, guida con l'86.7% al massimo effort in Claude Code. Su DeepSWE 1.1, Muse Spark 1.2 arriva al 59.3%, terzo dietro Opus 5 al 65.0% e GPT-5.6 Terra al 64.8%. Il benchmark interno di Meta è il più diretto: il 70.6% di Muse Spark 1.2 batte GPT-5.6 Terra, al 65.4%, e Gemini 3.6 Flash, al 63.9%, ma resta quasi nove punti sotto il 79.4% di Opus 5. Claude è primo in tutte e tre le classifiche.
I miglioramenti generazionali sono concreti: Muse Spark 1.2 guadagna 6.7 punti su Terminal-Bench e 6.3 su DeepSWE rispetto a 1.1. C'è però un dettaglio importante nelle etichette del grafico, soprattutto per chi confronta le due versioni. I risultati di 1.1 sono stati rilevati con un harness mini-swe-agent generico, mentre 1.2 ha girato in Muse Code. Una parte del progresso va quindi attribuita al nuovo harness, non solo al nuovo modello. Nell'Intelligence Index composito di Artificial Analysis, 1.2 ottiene 54 punti e il 14° posto su 186 modelli, contro una mediana di categoria pari a 32. Muse Spark 1.1 era a 51: un avanzamento più contenuto di quanto suggeriscano le classifiche di coding.
Il confronto diretto con Claude e GPT è esattamente ciò che gli acquirenti continuano a chiedere. Su Reddit, uno sviluppatore lo aveva espresso chiaramente prima che esistessero dati su 1.2:
"Qualcuno ha usato MUSE Spark 1.1 di Meta? Vorrei capire come si confronta con Claude e GPT per reasoning, coding, velocità, accuratezza e gestione del contesto."
I benchmark di 1.2 offrono la prima risposta rigorosa: è competitivo, chiaramente secondo nel coding e davanti alle alternative GPT-5.6 e Gemini nella maggior parte dei grafici.
I due limiti che contano in produzione
Due dettagli pratici determinano se Muse Spark 1.2 si adatta a un flusso di lavoro reale, e nessuno dei due emerge dalla posizione in una leaderboard.
Con xhigh il primo token arriva molto più tardi
Muse Spark è un modello di reasoning: riflette prima di rispondere e non è possibile disattivare questo comportamento. Il controllo /effort offre cinque livelli, da minimal a xhigh, e i token di ragionamento vengono fatturati come output. Al livello più alto il costo cresce sotto due aspetti. Le misurazioni indipendenti pubblicate da OrcaRouter mostrano che il tempo al primo token passa dai 2.90 secondi di 1.1 ai 26.12 secondi di xhigh in 1.2, circa nove volte tanto; la velocità di output scende invece da 213.5 a 165.0 token al secondo. L'esecuzione della valutazione Artificial Analysis Intelligence Index su 1.2 è costata $637.85, il 16% in più dei $548.07 di 1.1, esclusivamente perché il modello delibera più a lungo. Nel coding interattivo, dove lo sviluppatore attende una risposta, l'effort massimo spesso scambia troppa latenza con un guadagno di accuratezza non sufficiente a giustificarla.
Il piano contributor sconta il prezzo, non il valore dei dati
Meta propone Muse Spark 1.2 in due fasce di prezzo, e quella suggerita ai nuovi utenti prevede una condizione precisa. Il piano contributor ($0.10/$0.20 per milione di token input/output, contro $1.25/$4.25 dello standard) costa circa 12 volte meno sull'input e 21 volte meno sull'output, con input in cache quasi gratuito a $0.002. La contropartita è l'autorizzazione esplicita per Meta a usare prompt e completamenti nell'addestramento di futuri modelli. È la tariffa più bassa nel confronto qui sopra, ma viene pagata con i dati.
Il percorso iniziale predefinito di Muse Code porta gli sviluppatori proprio su questo piano. Nei test riportati da VentureBeat, l'installer in una riga ha funzionato su un Mac mini, con download da 97 MB e accesso all'account, ma l'agente si è fermato prima di eseguire qualunque attività: non vedeva modelli disponibili e richiedeva un metodo di pagamento anche sul piano scontato. Economico è corretto; gratuito no. Anche i limiti di richiesta sono più stretti, 60 al minuto contro 3,000 nello standard, un chiaro segnale che il piano è pensato per singoli e prototipazione, non per la produzione. I team con codebase proprietarie dovrebbero passare consapevolmente al listino standard o richiedere la zero data retention tramite il team commerciale di Meta.
Prezzi a confronto: la posizione di Muse Spark
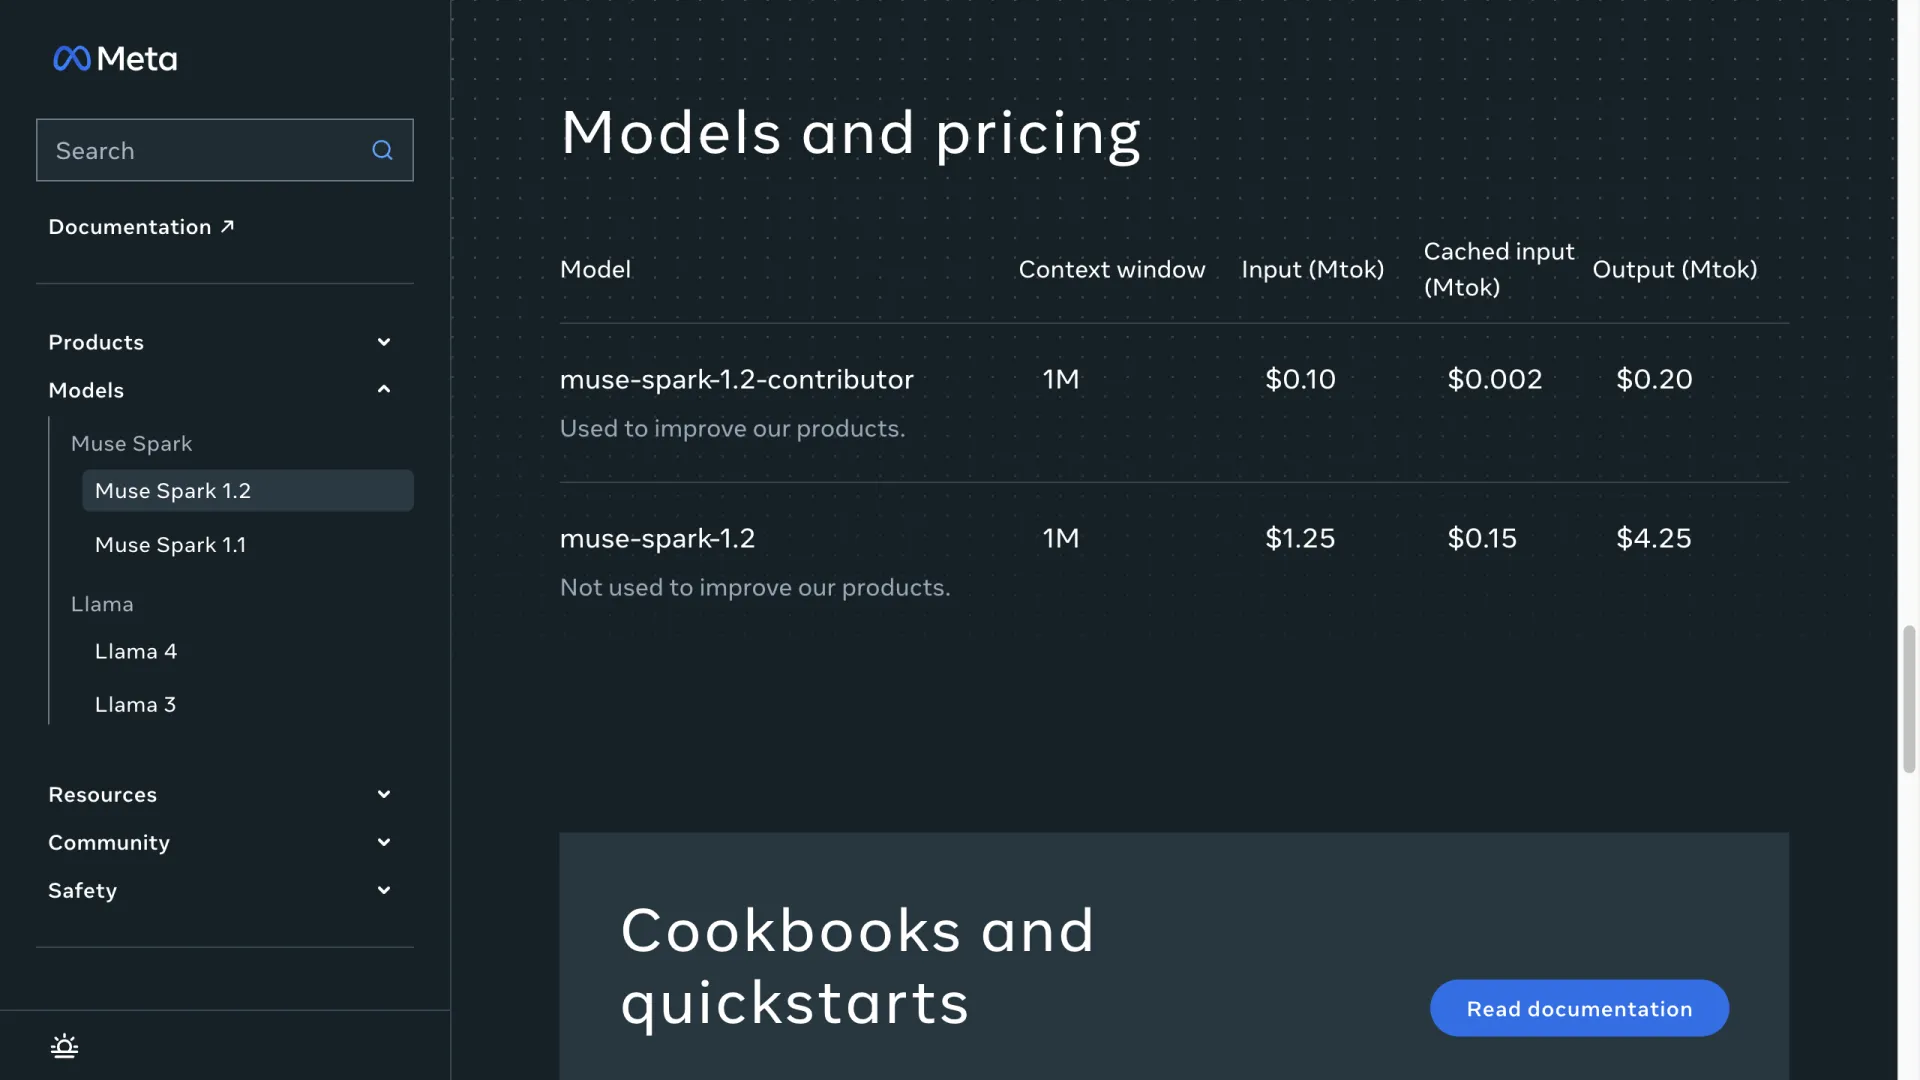
Il piano standard di Muse Spark 1.2 ($1.25 per milione di token input, $0.15 in cache, $4.25 output, finestra di contesto da 1M token e nessun sovrapprezzo per il contesto lungo) si colloca nella fascia medio-bassa del mercato dei modelli per coding. Costa sensibilmente meno dei leader frontier: Claude Opus 5, a $5/$25, e GPT-5.5, a $5/$30, hanno un prezzo di output circa 4-7 volte superiore. È quasi sovrapponibile a Z.ai GLM-5.2, a $1.40/$4.40, e un gradino sotto Grok 4.5, a $2/$6. All'estremo economico del mercato, DeepSeek V4 Pro a $0.435/$0.87 costa diverse volte meno, così come lo stesso piano contributor di Muse Spark.
| Modello | Input $/M | Output $/M | Cache $/M | Contesto |
|---|---|---|---|---|
| Muse Spark 1.2 (standard) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2 (contributor)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*il piano contributor concede a Meta il diritto di addestrarsi sui vostri dati; limite di 60 richieste/min.
Dove trovarlo oggi e quali alternative usare
Muse Spark 1.2 è disponibile in tre canali: Meta Model API, l'agente da terminale Muse Code e OpenRouter. Non è ancora presente su tutti gli aggregatori: il catalogo di AIReiter, controllato il 6 agosto 2026, non lo include. Se il vostro stack dipende da un'API unificata e vi serve subito un modello per coding, la scelta si restringe ai modelli già instradati dalla piattaforma.
L'alternativa disponibile più vicina per fascia di prezzo è GLM-5.2, a $1.40/$4.40. Il 6 agosto 2026 ho eseguito un singolo compito di coding-reasoning con glm-5.2, instradato attraverso l'API della piattaforma, per capire cosa offre un modello «disponibile oggi»: una funzione Python per prelievi a cui mancava il controllo dello scoperto. GLM-5.2 ha risposto in 3.2 secondi, con 85 token di prompt e 128 di completamento, individuando correttamente l'assenza del controllo sul saldo, proponendo la correzione (if amount > 0 and account_balance >= amount:) e scrivendo un test che fallisce prima della modifica e passa dopo. È un solo compito, non un benchmark, ma dimostra che esiste già un modello di coding funzionante e richiamabile allo stesso livello di prezzo. DeepSeek V4 Pro, Kimi K3, Claude Sonnet 5 e la famiglia GPT-5.6 completano le opzioni per coding già presenti nel catalogo AIReiter.
Conviene usare Muse Spark 1.2?
La scelta si divide in tre casi, a seconda di ciò che si vuole ottimizzare.
Scegliete Muse Spark 1.2 se dovete gestire coding su larga scala con forte sensibilità al prezzo, come refactoring estesi su più file, lunghe sessioni di debug o attività agentiche di lunga durata, e siete disposti a passare direttamente da Meta, Muse Code o OpenRouter. A $1.25/$4.25 offre capacità di coding di classe frontier a prezzi di fascia media; la finestra di contesto da 1M, con compattazione del contesto, è adatta a lavori che superano il singolo prompt. Tenete l'effort sotto xhigh, salvo che il task possa tollerare 26 secondi prima del primo token.
Scegliete Claude Opus 5 se vi serve il massimo nei benchmark di coding. È primo in tutte e tre le prove in cui compare Muse Spark 1.2. Per quel vantaggio di accuratezza, il costo per token è da 4 a 6 volte superiore.
Scegliete un modello già presente nel vostro aggregatore se dovete rilasciare oggi e Muse Spark non è disponibile sulla vostra piattaforma. GLM-5.2 offre la stessa fascia di prezzo senza attese; DeepSeek V4 Pro costa ancora meno quando la priorità assoluta è il costo.
FAQ
Muse Spark 1.2 è migliore di Claude Opus 5 nel coding?
No. Claude Opus 5 è davanti in tutti e tre i benchmark di coding pubblicati da Meta, ossia Terminal-Bench 2.1, DeepSWE 1.1 e la valutazione interna di coding di Meta, con margini da 3.8 a 9 punti. Muse Spark 1.2 è chiaramente secondo e supera GPT-5.6 Terra e Gemini 3.6 Flash nella maggior parte dei grafici.
Muse Spark 1.2 è open source?
No. A differenza della famiglia Llama di Meta, Muse Spark è proprietario: è disponibile solo nel cloud, senza pesi scaricabili né possibilità di self-hosting. Mark Zuckerberg ha dichiarato che avrà «altro da condividere» su possibili rilasci open source, ma 1.2 viene distribuito senza pesi e senza licenza.