 AIREITER
MuseTalk gira anche su una GPU da laptop con 4 GB di VRAM: nel README ufficiale, una RTX 3050 Ti Laptop impiega circa cinque minuti per elaborare una clip di otto secondi in FP16. È proprio la distanza tra "si avvia" e "è abbastanza veloce per il mio caso d'uso" a determinare la convenienza di MuseTalk lipsync. E la stessa differenza torna quando si parla di risoluzione, configurazione e costi.
Cosa modifica MuseTalk nei video e cosa lascia invariato
MuseTalk ridisegna la bocca e la parte inferiore del volto in un video già esistente, sincronizzando le labbra con una traccia audio fornita dall'utente. Posizione della testa, movimento degli occhi, espressioni, sfondo e movimenti della camera restano quelli del filmato originale: il modello non li rigenera. È quindi un intervento locale, non un generatore di talking head. Serve già un video con un volto ben visibile.
La velocità dipende dall'architettura. Il repository, pubblicato dal Lyra Lab di Tencent Music, codifica il volto mascherato con una VAE sd-vae-ft-mse congelata, estrae le caratteristiche audio con un modello Whisper-tiny anch'esso congelato e combina i due flussi tramite cross-attention in una UNet derivata da Stable Diffusion v1.4. L'inpainting avviene nello spazio latente in un solo passaggio, anziché attraverso un ciclo iterativo di denoising: è così che gli autori dichiarano di raggiungere almeno 30 fps su una NVIDIA Tesla V100.
Cosa comporta la regione del volto a 256x256 su un video sorgente in 1080p
Il valore 256x256 indica la dimensione della regione del volto che viene modificata, non la risoluzione del video finale. Una clip in 1080p resta in 1080p e mantiene il frame rate originale; MuseTalk rigenera una patch 256x256 intorno alla bocca e la fonde nuovamente nel fotogramma. Di conseguenza, il risultato tende a reggere meglio quando il volto occupa una porzione ampia dell'inquadratura. Nei primi piani stretti, invece, la morbidezza della zona elaborata può risaltare contro il resto del volto, più nitido.
Esistono due contromisure, entrambe con qualche compromesso. Rimuovere --use_float16 migliora la qualità, ma richiede più VRAM e tempi di elaborazione più lunghi. Passare il video finito da GFPGAN o CodeFormer per il face restoration rende più nitida la bocca, aggiungendo però un ulteriore passaggio e modificando leggermente l'aspetto del soggetto.
La qualità misurata: dove MuseTalk supera gli altri e dove Wav2Lip resta avanti
Il vantaggio dichiarato di MuseTalk riguarda soprattutto la qualità dell'immagine, non la precisione assoluta della sincronizzazione. Sul dataset HDTF, il report tecnico di MuseTalk riporta un FID di 6.43, contro 7.27 per DI-Net, 10.93 per VideoRetalking e 11.21 per Wav2Lip.
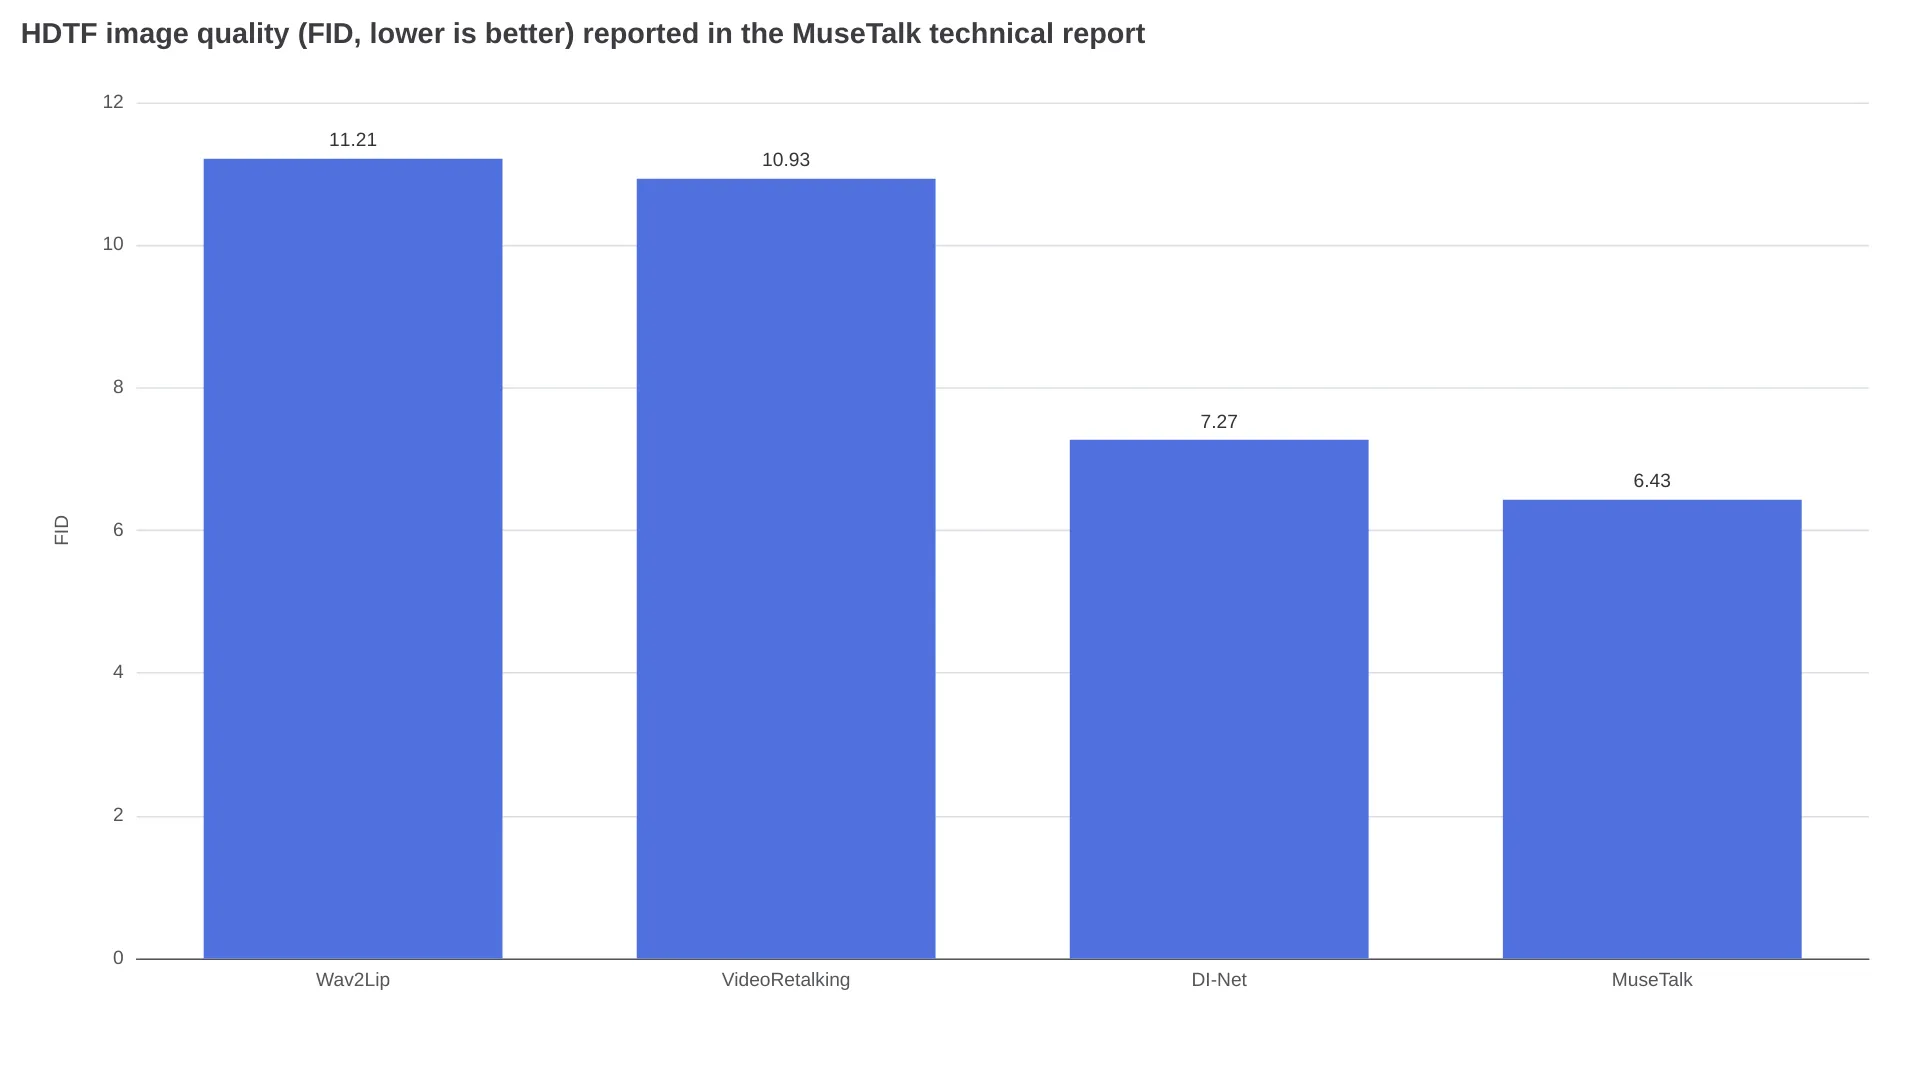
Se si guarda invece alla metrica di sincronizzazione, la graduatoria cambia. Lo stesso report assegna a Wav2Lip un LSE-C di 7.46, contro 6.53 per MuseTalk. MuseTalk recupera però sulla similarità dell'identità, con un CSIM di 0.8225 rispetto a 0.8184: il vecchio modello GAN segue meglio il movimento delle labbra, mentre MuseTalk restituisce immagini più fedeli. Anche lo studio con valutatori umani resta su valori moderati: 3.62 su 5 per la qualità visiva, 3.55 per l'identità e 3.41 per la sincronizzazione labiale.
Letti insieme al limite dei 256x256, questi risultati descrivono un modello adatto a mezzi busti convincenti, non a primi piani in 4K capaci di nascondere ogni difetto.
Quanto costa un minuto di lip sync
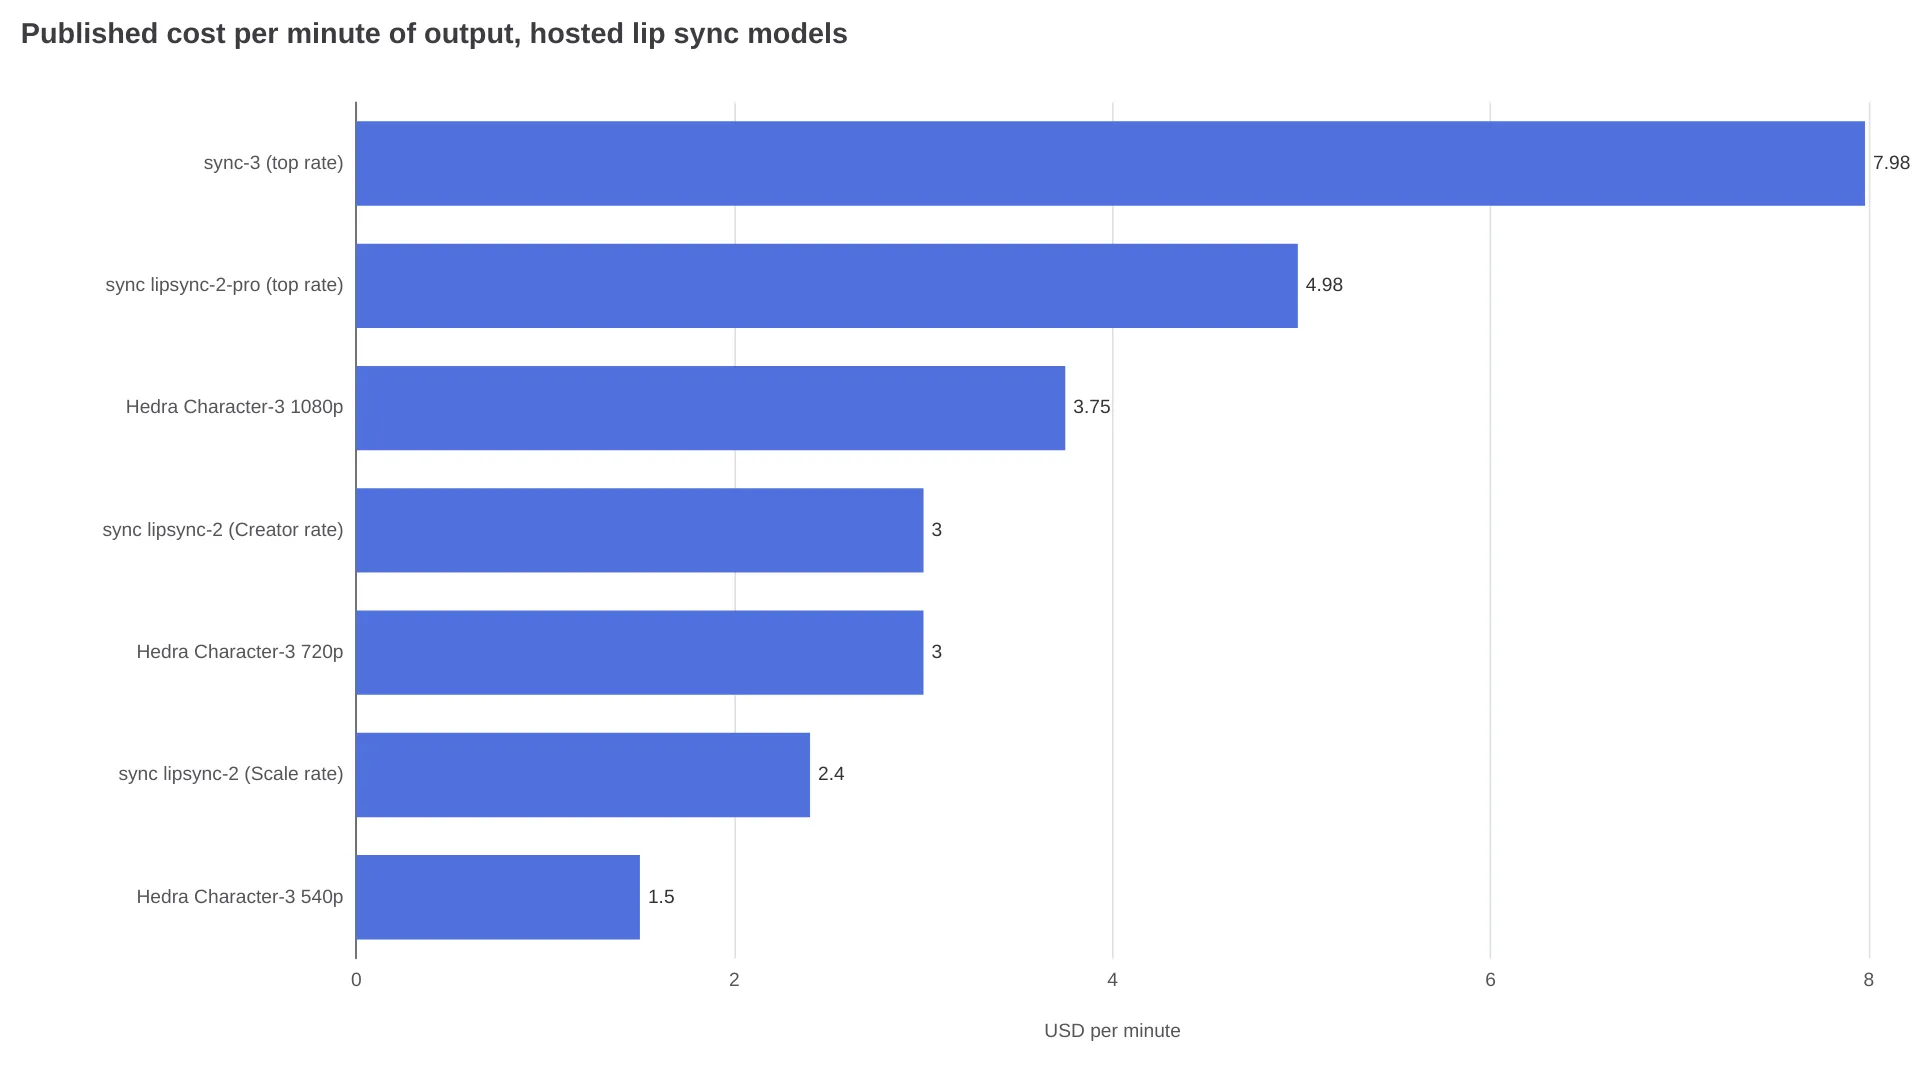
È qui che la strada open source diventa davvero interessante. I prezzi pubblicati per i modelli di lip sync in hosting vanno da $1.50 a quasi $8.00 per minuto di output.
| Opzione | Prezzo pubblicato (le unità di fatturazione variano) | Per minuto di output | Risoluzione del volto |
|---|---|---|---|
| MuseTalk self-hosted, noleggio Tesla V100 | $0.188 / GPU-ora | ~$0.006 con 2 minuti GPU per ogni minuto di clip | 256x256 |
| MuseTalk su Replicate | ~$0.052 / esecuzione, 54 s di durata tipica secondo la pagina del modello | Fatturato per esecuzione, non al minuto | 256x256 |
| MuseTalk su fal.ai | Fatturato al secondo di calcolo | Non pubblicato nella pagina del modello | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — image-to-video, non un sostituto diretto per filmati esistenti | 2.5¢ / 5¢ / 6.25¢ al secondo | $1.50 / $3.00 / $3.75 | n/a |
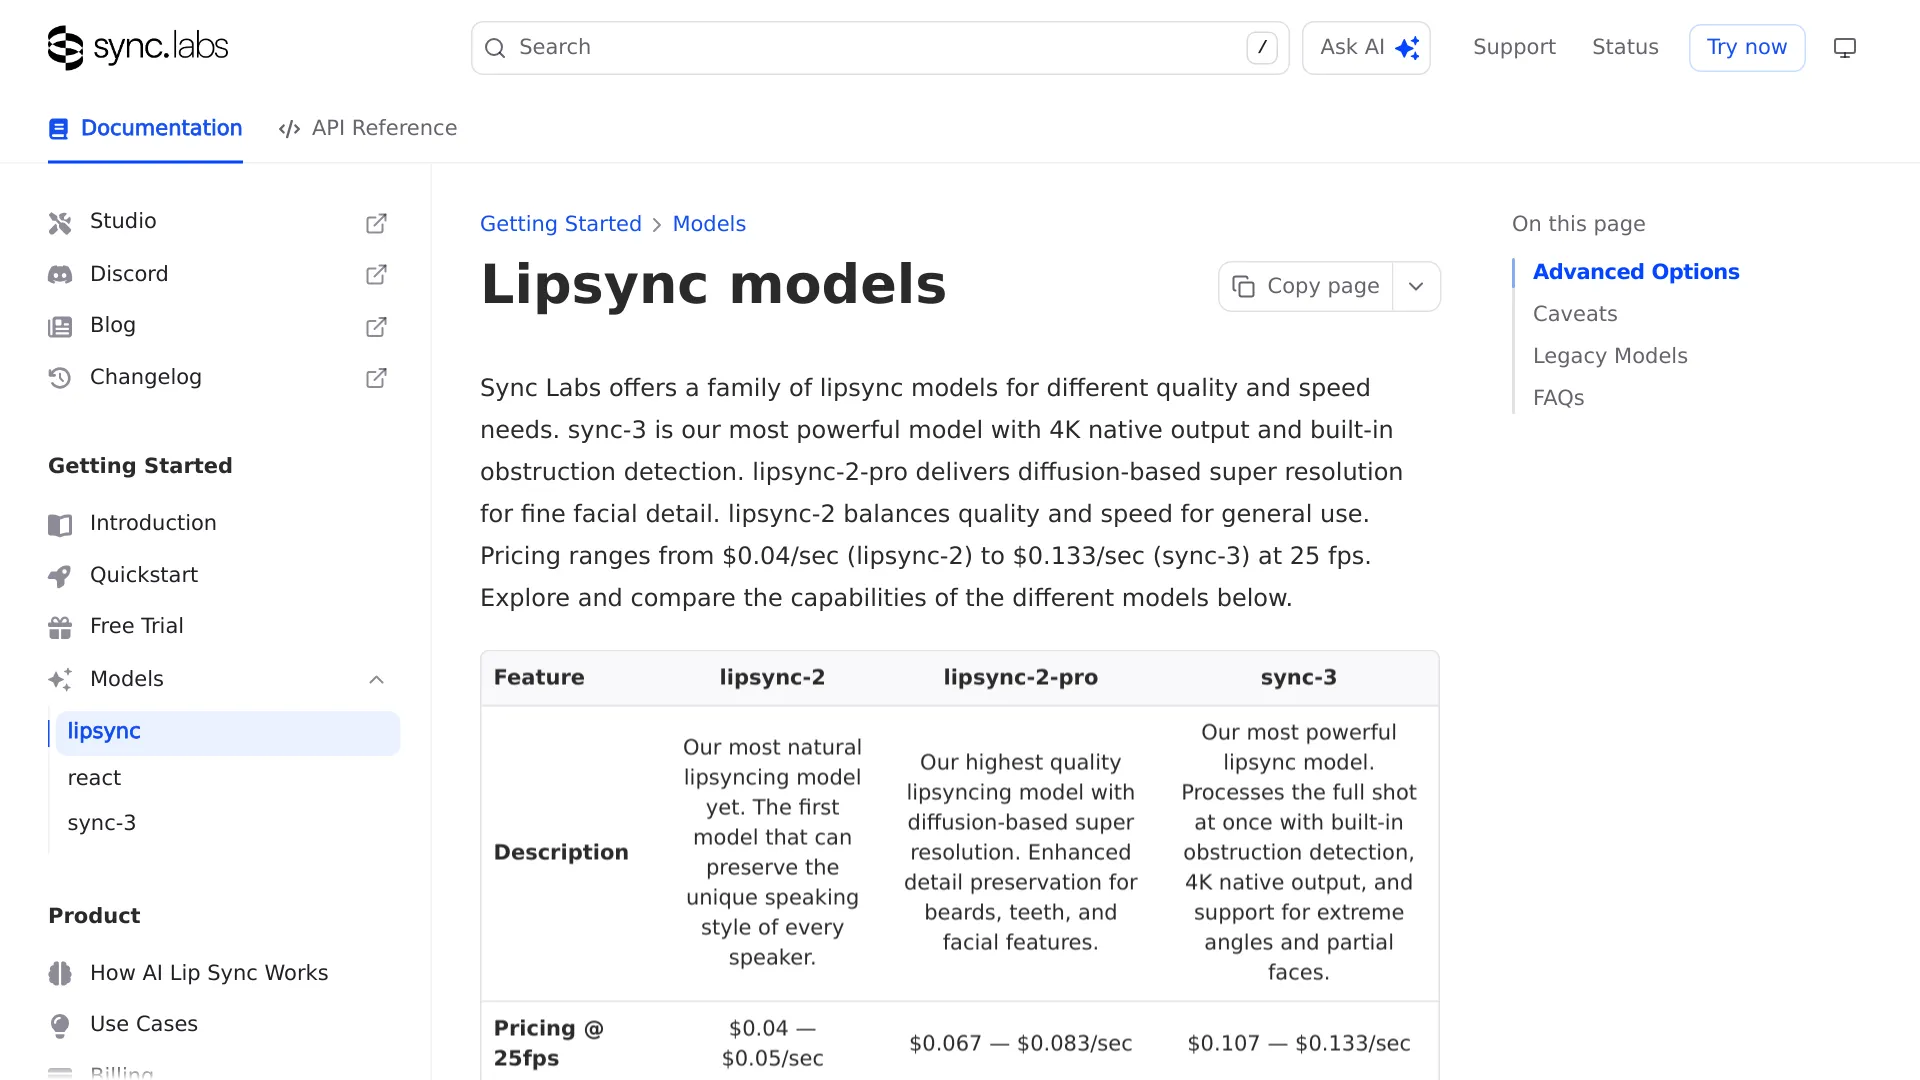
| sync lipsync-2 | $0.04–0.05 / sec a 25 fps | $2.40–$3.00 | 512x512 |
| sync lipsync-2-pro | $0.067–0.083 / sec | $4.02–$4.98 | 512x512 + passaggio di dettaglio |
| sync-3 | $0.107–0.133 / sec | $6.42–$7.98 | 4K nativo |
La stima per il self-hosting arriva dalla guida ai costi di NexGPU, che considera due minuti di tempo GPU end-to-end per ogni minuto di clip: inferenza, rilevamento DWPose, codifica e decodifica VAE e muxing con FFmpeg. Cento clip da un minuto richiedono quindi circa $0.63 di calcolo su una V100 a $0.188 l'ora, più circa $0.09 per il tempo di configurazione. Sono solo costi di noleggio GPU: non includono il lavoro di engineering, lo storage né le spese operative.
Su un archivio di localizzazione, la differenza diventa immediatamente evidente. Cinquecento minuti di video doppiato costano circa $3 di noleggio GPU con MuseTalk self-hosted, contro $1,200 con sync lipsync-2 al prezzo Creator.
Dove il percorso gratuito smette di esserlo
Il sovrapprezzo al minuto compra vantaggi molto concreti:
- Risoluzione del volto. Secondo la documentazione dei modelli sync, lipsync-2 e lipsync-2-pro generano volti a 512x512, il doppio rispetto alla regione di MuseTalk; sync-3 produce invece output 4K nativo con super resolution integrata.
- Inquadrature difficili. La stessa documentazione indica che sync-3 gestisce nativamente profili, inquadrature da dietro la spalla e volti parzialmente visibili, rilevando automaticamente le ostruzioni. MuseTalk esegue il face detection fotogramma per fotogramma: un volto ruotato o una mano davanti alla bocca sono quindi punti di possibile errore documentati.
- Video con più persone. Il rilevamento del parlante attivo è disponibile come opzione in tutti e tre i modelli sync attuali; MuseTalk non espone un flag equivalente.
- Tempo di configurazione. Nel self-hosting lo paghi una volta, ma non è un costo trascurabile.
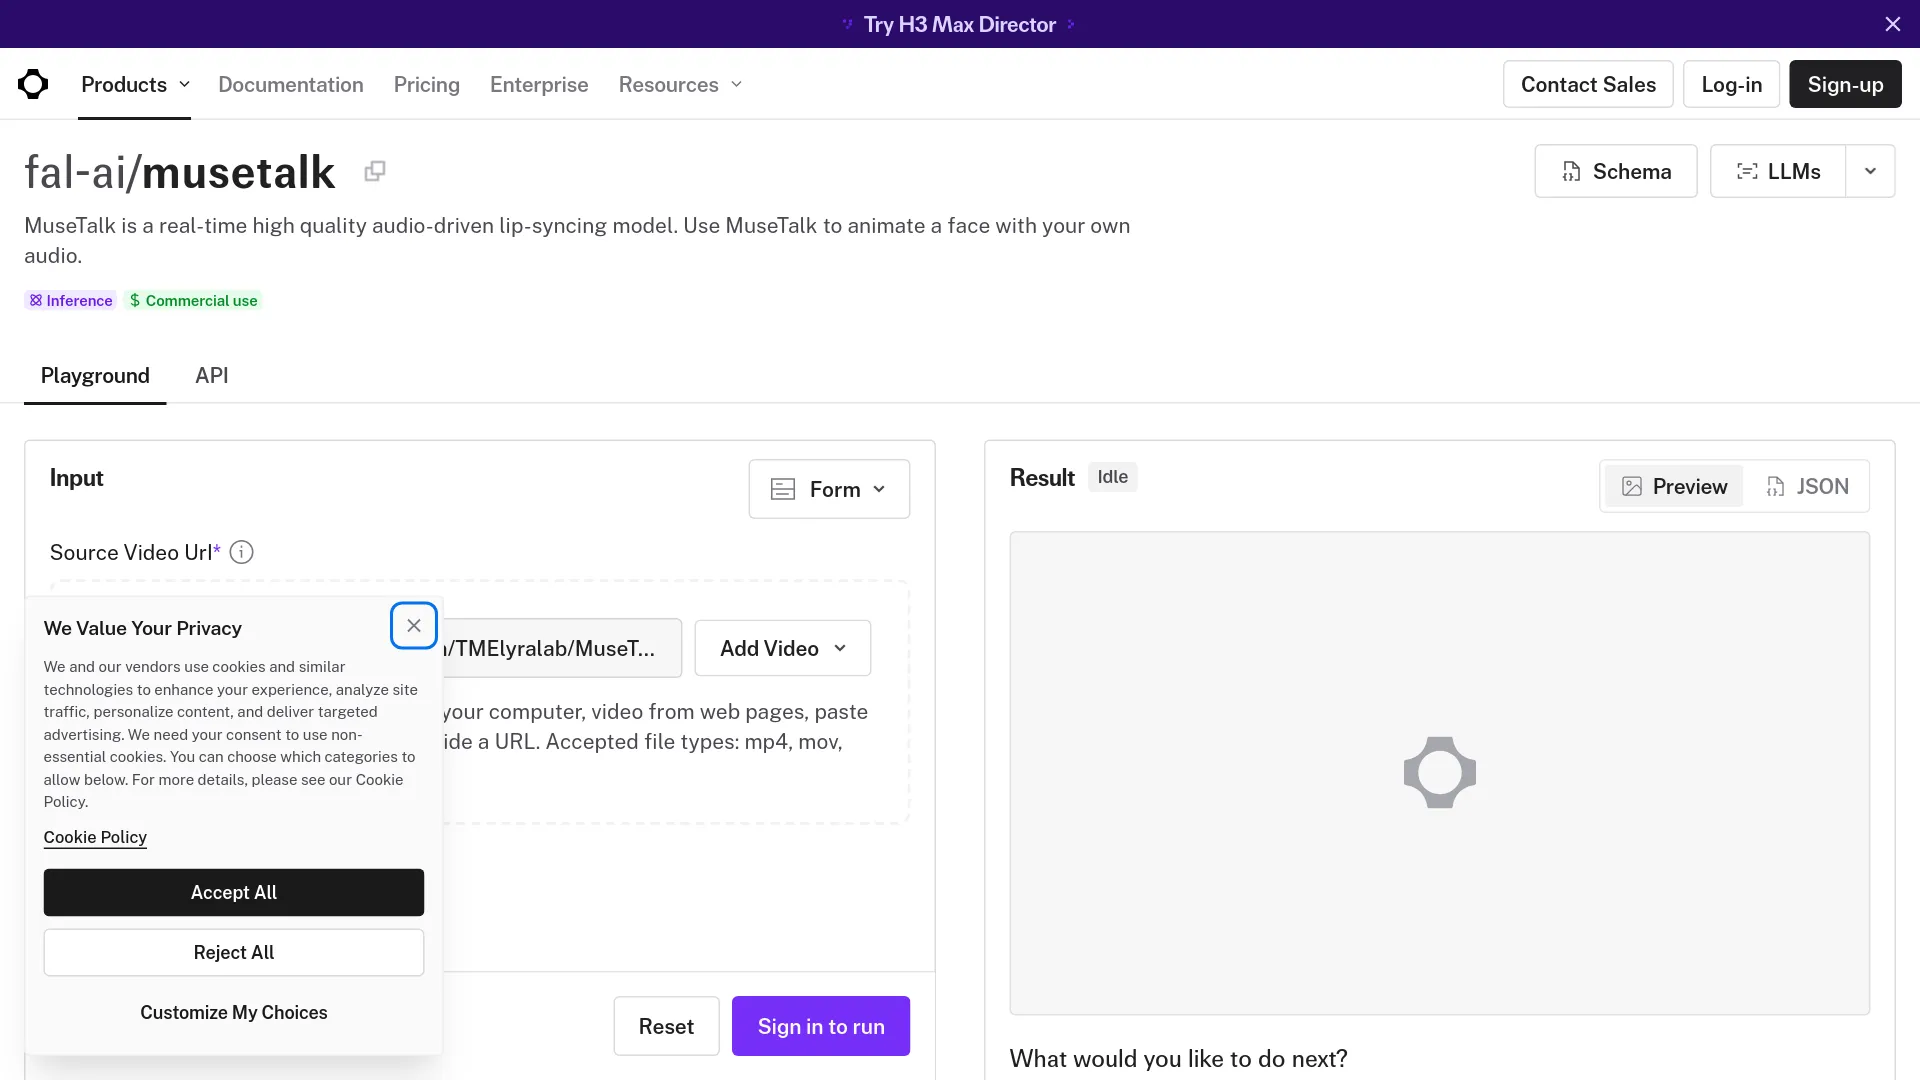
La pagina di MuseTalk su fal.ai mostra con chiarezza cosa si ottiene pagando per l'ultimo punto: un URL per il video sorgente, un URL per l'audio e nient'altro. Nessun ambiente conda, nessun vincolo CUDA, nessun albero di pesi da preparare.
Come avviare MuseTalk senza perdersi tra le dipendenze
Molte delle lamentele di chi ha provato il modello non riguardano la qualità dell'output. Il problema è lo stack OpenMMLab. Su r/StableDiffusion, un utente che ha confrontato diversi modelli di lip sync lo ha riassunto così dopo aver testato MuseTalk e LatentSync:
"LatentSync e Musetalk funzionano e hanno prestazioni simili... Musetalk è complicato da configurare perché dipende dalle librerie OpenMMLab." — u/Traditional_Tap1708, r/StableDiffusion
Le versioni indicate nel README vanno installate tramite mim, non con un semplice pip:
- Python 3.10 in un ambiente conda nuovo, con PyTorch 2.0.1, torchvision 0.15.2 e torchaudio 2.0.2.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0". Una versione più recente di mmcv è la causa più comune degli errori di importazione di mmdet.- FFmpeg nel
PATH, verificando conffmpeg -version, oppure indicato esplicitamente tramite--ffmpeg_pathsu Windows. sh download_weights.shper scaricare l'intero albero. La sola UNet non basta: lo script scarica anche sd-vae-ft-mse, Whisper,dw-ll_ucoco_384.pthdi DWPose e i pesi di face parsing BiSeNet. Se manca un file, l'errore tende a manifestarsi come problema di rilevamento del volto o di blending, invece di produrre un messaggio chiaro.- Converti la sorgente a 25 fps con
ffmpeg -i input.mp4 -r 25 output.mp4. Il repository consiglia input a 25 fps perché è il frame rate usato per addestrare il modello; una frequenza diversa è la causa più comune dei problemi di deriva temporale. - Indica video e audio in
configs/inference/test.yaml, poi eseguipython -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15.
Se devi generare molte clip usando lo stesso volto, imposta una volta preparation: true in configs/inference/realtime.yaml e lascia che il sistema memorizzi nella cache coords.pkl, latents.pt e le maschere in results/v15/avatars/. Poi riportalo a false. Anche aggiungere --skip_save_images è più importante di quanto sembri: la scrittura dei PNG su disco può diventare il collo di bottiglia, al posto del modello.
MuseTalk 1.5 o 1.0: quali pesi scaricare
La scelta consigliata è la 1.5. Il repository la indica come release più recente, datata 28 March 2025, e attribuisce la maggiore nitidezza, coerenza dell'identità e allineamento tra labbra e parlato alle loss percettiva, GAN e di sincronizzazione, oltre che all'addestramento in due fasi.
L'unico motivo per conservare anche la 1.0 è bbox_shift, disponibile soltanto in quella versione. Il parametro sposta verticalmente il bordo della maschera: valori positivi aprono maggiormente la bocca, quelli negativi la chiudono.
Esegui una prima elaborazione con i valori predefiniti: lo script stamperà l'intervallo regolabile per la tua clip. Nell'esempio del README si ottiene un intervallo [-9, 9] e si sceglie -7. Ripeti il rendering restando nell'intervallo indicato, andando verso valori negativi se la bocca appare troppo aperta e verso quelli positivi se si apre appena.
I problemi che incontrerai e quelli che puoi correggere con il tuning
| Sintomo | Causa | Si può correggere? |
|---|---|---|
| L'elaborazione si interrompe, nessun volto rilevato | Un fotogramma contiene un volto ruotato, coperto o assente | Sì. Ritaglia o elimina il segmento problematico |
| La bocca si muove appena | La voce è coperta dalla musica oppure il bordo della maschera è troppo alto | Sì. Isola le voci; usa un bbox_shift positivo su v1.0 |
| Le labbra perdono la sincronizzazione a metà clip | La sorgente non è a 25 fps | Sì. Converti il video prima dell'elaborazione |
| La bocca è sfocata rispetto al volto nitido | Il volto è troppo piccolo nell'inquadratura per la regione 256x256 | In parte. Ritaglia più vicino, disattiva fp16, aggiungi il face restoration |
| Si vede una giunzione, i baffi non vengono preservati | La sintesi della parte inferiore del volto sostituisce i dettagli dell'identità | No. È un limite dichiarato del modello |
| Tremolio tra un fotogramma e l'altro | I fotogrammi vengono generati singolarmente | In parte. Il repository attribuisce all'addestramento in due fasi di v1.5 una maggiore coerenza |
| Il volto cartoon o stilizzato non funziona | La distribuzione di addestramento contiene volti reali | No |
| Audio energico su un parlante immobile | MuseTalk non modifica i movimenti della testa né le espressioni | No. Serve rigirare o sostituire la clip sorgente |
Un utente che ha eseguito test con poca VRAM ha riportato per MuseTalk "171s for 7 seconds of audio" e ha aggiunto che "only works with realistic images" (u/Bartholomheow, r/StableDiffusion). L'indicazione dei "30 fps in tempo reale", invece, descrive il throughput sostenuto dopo la preparazione dell'avatar, non la latenza end-to-end. Uno sviluppatore che costruisce talking head su r/LocalLLaMA ha riferito che con MuseTalk "the preparation time is too long" (u/lonyPorgrammer) per il proprio caso d'uso interattivo.
Quale percorso di lip sync scegliere in base al lavoro
| Opzione | Sceglila quando | Compromesso principale |
|---|---|---|
| MuseTalk self-hosted | Hai grandi volumi e filmati facili da gestire: bozze di localizzazione, avatar interattivi che riutilizzano lo stesso volto per migliaia di clip audio, video formativi interni | La configurazione richiede ore, non minuti; il throughput dipende dalla GPU noleggiata |
| MuseTalk in hosting (Replicate, fal.ai) | Devi elaborare poche clip oppure vuoi testare la qualità sui tuoi filmati prima di impegnarti in un deployment | Resta il limite dei 256x256, nessuno dei due endpoint espone un flag per la cache dell'avatar e la fatturazione è per esecuzione |
| Modello di lip sync a pagamento (sync-3, lipsync-2-pro) | Ti servono output destinati ai clienti, primi piani ampi, profili, ostruzioni, più parlanti o consegne in 4K | $4–$8 al minuto e i filmati escono dalla tua infrastruttura |
Noleggia una V100 se vuoi riprodurre il throughput ufficiale, oppure una 4090 se devi trasmettere in diretta. Per il percorso basato sugli endpoint in hosting, abbiamo analizzato più a fondo entrambe le piattaforme nella nostra recensione di Replicate e nella recensione di fal.ai.
FAQ su MuseTalk lipsync
MuseTalk funziona su una GPU da 6 o 8 GB?
Sì. Il README documenta un test con una RTX 3050 Ti Laptop da 4 GB in FP16, quindi l'inferenza di base rientra in una VRAM limitata. Il vincolo pratico più importante è la velocità.
256x256 è la risoluzione dell'output?
No. È la regione del volto che viene modificata e poi reinserita in un video che conserva la risoluzione e il frame rate della sorgente.
MuseTalk funziona con volti cartoon o anime?
Non in modo affidabile. Il modello è stato addestrato su filmati realistici di persone che parlano e gli utenti che hanno provato input stilizzati riportano risultati incostanti.
La dicitura "30 fps real time" include il preprocessing?
No. Indica il throughput di generazione su una Tesla V100 dopo la preparazione dell'avatar. Rilevamento del volto, codifica latente e prima fase di caching avvengono prima.
MuseTalk o LatentSync?
Scegli MuseTalk quando latenza e volume sono i fattori decisivi, perché l'inferenza in un solo passaggio e gli avatar memorizzati nella cache riducono gran parte del costo per clip. L'utente di r/StableDiffusion citato sopra, che ha provato entrambi, ha descritto prestazioni simili: a fare la differenza diventa quindi il throughput, più che la fedeltà dell'immagine.
MuseTalk può essere usato per scopi commerciali?
Il repository rilascia il codice con licenza MIT, ma la catena di dipendenze non è uniforme. Whisper, la VAE, DWPose, il face parsing BiSeNet e SyncNet hanno condizioni d'uso proprie; inoltre il repository segnala restrizioni separate per i dati di esempio. Verifica ogni licenza prima della pubblicazione.
Il compromesso che questo prezzo non ha ancora risolto
MuseTalk porta a casa gran parte del risultato praticamente a costo zero. Quello che non riesce a garantire è la conservazione dell'identità nei casi più difficili: baffi, forma precisa delle labbra, un volto che riempie l'inquadratura o un parlante che gira la testa a metà frase.
Per la maggior parte dei team la soluzione non consiste nello scegliere un solo strumento. MuseTalk copre i grandi volumi, mentre un modello a pagamento gestisce le inquadrature che finiranno a tutto schermo.
Articoli correlati
- Recensione e prezzi di Higgsfield AI a confronto con l'accesso via API
- Guida alla configurazione locale di Kokoro 82M TTS, per generare la traccia audio usata da MuseTalk
- Guida a Wan 2.2 Animate