 AIREITER
Per MiniMax, il livello di preprocessing di H3 è «critico per la qualità del risultato finale». Per una discussione Reddit con 220 upvote, invece, H3 è soprattutto un problema di dialoghi incomprensibili. In questa recensione dei prompt MiniMax H3 mettiamo il formato ufficiale a confronto con test e segnalazioni documentate dai creator: camera e controllo dei riferimenti risultano più affidabili di dialoghi e audio, e in alcuni casi i risultati migliori arrivano proprio allontanandosi consapevolmente dalla sintassi prevista.
Come funziona davvero il formato prompt di MiniMax H3
Il prompt ufficiale di MiniMax H3 è un documento strutturato in tre campi — integrated_multimodal_description, overall_soundscape, non_diegetic_music — con inquadrature scandite da timestamp, ID persistenti dei parlanti e tag dialogo <d>. Il motivo è che H3 si aspetta una rappresentazione intermedia strutturata, normalmente prodotta dal preprocessor ospitato H3-Context-IR, che MiniMax non ha incluso nel rilascio open weights: l’API hosted riscrive automaticamente le richieste libere, mentre chi esegue localmente i pesi da 33B con SGLang, vLLM, Diffusers o ComfyUI deve costruire a mano quella struttura.
MiniMax distribuisce anche una skill portabile, h3-prompt-writing, nel repository GitHub ufficiale: due file guida, base-en.txt e ref-en.txt, leggibili da qualsiasi coding agent senza chiamate API esterne. I creator la usano in Claude o Cursor per trasformare brief in linguaggio naturale nel formato completo; @AI__TSUBAKI documenta proprio questo flusso per clip cinematografiche.
I limiti tecnici che definiscono il prompt
| Vincolo | Valore | Implicazione per il prompting |
|---|---|---|
| Durata clip | 4–15 secondi, 24 FPS | I timestamp devono essere strettamente crescenti e rientrare nella durata |
| Audio | Stereo a 32 kHz, generato congiuntamente | I campi soundscape e colonna sonora sono obbligatori; è ammesso N/A |
| Risoluzione | 768p predefinita; 2K tramite H3-Regenerate-2K, solo API | Test a 768p, poi passa al 2K quando il prompt è definitivo |
| Tipi di attività | T2VA (testo), I2VA (primo frame a 0.00 s), FL2VA (primo + ultimo frame), L2VA (ultimo frame), Ref2VA (riferimento omni) | Ogni tipo richiede una propria frase di allineamento |
| Limiti dei riferimenti | 9 immagini + 3 clip video + 3 clip audio, 12 file totali, ≤15 s complessivi per tipo di media | Più riferimenti significano più instradamento, non necessariamente risultati migliori |
| Dimensione del prompt | Gli esempi ufficiali sono di 300–700 parole; il puro text-to-video arriva a ~7.000 caratteri | I prompt brevi senza riferimenti sono una modalità di errore segnalata dal manuale ufficiale |
Un prompt minimo ma completo — tre campi, un’istruzione camera, un parlante visibile con dialogo tra virgolette e nessuna colonna sonora — può stare in dieci righe:
integrated_multimodal_description: Cinematic, live-action. [Shot 1] A woman in her
late twenties sits on a sunlit sofa, a matte-green skincare bottle in hand. The
camera pushes in, small amplitude, slow speed. She is visible on screen and says:
"This is the one product I repurchase every year." At 00:05.500 she sets the
bottle down.
overall_soundscape: Quiet room tone, faint traffic outside, soft fabric movement,
gentle contact of the bottle on the table.
non_diegetic_music: N/A
La sintassi completa campo per campo — tag, frasi di allineamento e template — è nella nostra guida ai prompt MiniMax H3. Qui valutiamo invece se tutta questa sintassi valga davvero il tempo richiesto.
Alla prova dei fatti: le tre promesse del formato
Le linee guida ufficiali fanno tre promesse implicite. Le segnalazioni citate danno ragione soprattutto alle prime due, molto meno alla fedeltà dell’audio.
Promessa 1: «La struttura restituisce ciò che hai chiesto»
Qui le prove sono le più solide. Il creator X @AIWarper ha pubblicato un confronto prima/dopo essere passato alla struttura ufficiale:
«Consiglio VIVAMENTE di attenervi alla guida di prompting pubblicata da Minimax. Aiuta davvero molto a ottenere esattamente ciò che ci si aspetta.... Il mio ultimo post non seguiva la struttura di prompt suggerita.» — @AIWarper, 306 like
Il registro di test di terze parti mostra lo stesso andamento sul piano dei dettagli: ha richiesto uno stacco esattamente a 00:05.000 e l’ha ottenuto, ha trascritto alla lettera una testimonianza scritta e ha mantenuto stabile la composizione del primo frame in una clip I2VA di 6 secondi. Anche le segnalazioni sugli storyboard coincidono: le board di @aimikoda vengono seguite come guida sequenziale alle inquadrature, mentre quella di @nanyuan0412 è stata rispettata senza improvvisazioni, a eccezione dei campi audio che non erano stati scritti e sono usciti quasi silenziosi.
Il limite ricorrente non è il rifiuto, ma il ritmo. «Il problema più grande è stato il pacing», scrive u/Relevant_One_2261: dialoghi che non entrano nella durata e timestamp troppo ravvicinati sono gli errori strutturali che tornano più spesso.
Promessa 2: «I comandi di camera funzionano meglio delle descrizioni del risultato»
Lo conferma un problema di inquadratura risolto traducendo il desiderio finale in istruzioni di camera. Un utente di r/StableDiffusion aveva chiesto a H3 di tenere sempre in quadro il corpo intero di un soggetto in cammino, con la semplice indicazione «entire subject remains visible throughout»: ha fallito più volte. La soluzione è stata usare la grammatica nativa della camera di H3:
«La camera arretra con ampiezza elevata alla stessa velocità con cui il soggetto cammina in avanti, mantenendo una composizione a figura intera.» — u/Powerful-Goal52, confermato funzionante dall’autore del post
È una formulazione che corrisponde direttamente alle tre dimensioni camera di H3 — tipo di movimento, ampiezza e velocità — e alla sua regola di una sola istruzione camera per inquadratura. Ecco una rapida tabella di conversione:
| Risultato desiderato | Comando che H3 segue |
|---|---|
| Il soggetto resta interamente visibile mentre cammina | Pull Out con ampiezza elevata alla velocità di cammino del soggetto |
| Enfasi delicata senza rompere l’inquadratura | Push In, ampiezza ridotta, velocità lenta |
| Mostrare l’ambiente attorno a un soggetto fermo | Truck Left o Truck Right, ampiezza media |
| Cambiare altezza senza inclinare la camera | Pedestal Up / Pedestal Down a velocità lenta |
Le linee guida ufficiali di prompting elencano 13 famiglie di movimento — Zoom, Push, Pull, Pan, Tilt, Truck, Pedestal, Arc, Tracking, Static, Shake, Roll e POV — ognuna modulata da ampiezza e velocità. La differenza tra zoom, cioè variazione della focale, e push, cioè movimento fisico della camera, conta nella pratica: i due termini non sono intercambiabili.
Promessa 3: «Separando i campi audio, il risultato resta pulito»
Questo è il livello più debole. Dividere il soundscape diegetico dalla colonna sonora non diegetica è una buona scelta progettuale, ma l’aderenza resta incostante:
«Lo uso, ma circa il 20% delle volte aggiunge comunque musica lol» — u/TheElectriking a proposito di
non_diegetic_music: N/A
La discussione da 220 upvote da cui proviene la citazione elenca il resto del problema: artefatti audio ai bordi della clip, personaggi che pronunciano frasi casuali incomprensibili e battute affidate alla persona sbagliata. u/krigeta1 riferisce di aver passato tre riferimenti audio personalizzati, ricevendo «una voce casuale o non l’audio che assegno ai personaggi». Un’altra discussione ha risolto dialoghi sullo schermo che venivano letti come fuori campo associando esplicitamente l’ID del parlante al personaggio visibile.
Il testo in scena è altrettanto fragile: la wiki della community avverte che il «testo esatto è fragile» e suggerisce di fornire lettering essenziale per il brand come riferimento immagine, oppure di comporlo in post-produzione. C’è anche un parere contrario: @web4miko sostiene che nei suoi test H3 «non riesce nemmeno a superare Seedance 2.0» nella comprensione di testo e contesto. Nelle segnalazioni citate, instradamento audio, testo esatto e contesto denso sono i punti deboli ricorrenti.
Quando conviene uscire dalla sintassi ufficiale
Dai confronti diretti e dalle testimonianze riportate emergono tre deviazioni dal formato ufficiale. Vale la pena conoscerle prima di investire nel prompt strutturato completo.
Le virgolette possono funzionare meglio dei tag <d>. In un confronto pubblicato su r/StableDiffusion, con circa 105 upvote e 81 commenti, l’autore del post ha scoperto che rimuovendo il tagging <d>[Language]...台词...</d> previsto dalla guida e usando dialoghi semplicemente tra virgolette otteneva parlato pulito, mentre la forma con tag aggiungeva audio non richiesto. Un commentatore che aveva eseguito test simili ha confermato:
«Il prompting ufficiale per i dialoghi è tremendamente buggato... l’approccio con le virgolette non è comunque lontanamente buggato quanto il tagging
<d></d>.» — u/networking_noob
In pratica: prova prima <d>, perché è il percorso su cui il modello è stato addestrato, ma se il parlato è confuso o eccessivo ripeti la stessa battuta tra virgolette invece di riscrivere l’intero prompt.
non_diegetic_music: N/A è un controllo utile anche da solo. Secondo u/Nextil, evita la musica «anche se ignori gran parte del resto della struttura». Se non vuoi strutturare altro, inserisci almeno questo campo: la colonna sonora indesiderata è una lamentela ricorrente nelle segnalazioni citate.
Con molti riferimenti serve meno testo, non di più. Quando le immagini portano l’identità e un video porta il movimento, il prompt deve soltanto instradare i riferimenti e definire la nuova azione. I template più condivisi di @aimikoda, uno dei quali ha superato 1.300 salvataggi, sono minimalisti proprio per questo motivo. Inoltre @CharaspowerAI ha mostrato il Design agent di MiniMax espandere una sola riga — «act as an expert FPV director and turn this into something viral» — in un prompt strutturato completo. Un blocco di instradamento dei riferimenti può essere così:
@Image 1 is the character reference: preserve the face, short black hair, red silk jacket.
@Video 1 supplies the sword-draw rhythm.
@Audio 1 sets the mood with quiet traditional strings.
Dopo di questo, il prompt deve descrivere soltanto la nuova inquadratura. Il flusso pratico emerso da queste segnalazioni è: definire prima gli still, lasciare che siano i riferimenti a fare il grosso del lavoro e spendere parole solo per ciò che cambia.
Triage degli errori: ciò che il manuale non aiuta a risolvere
Le linee guida ufficiali arrivano fino alla sintassi. Non spiegano cosa fare quando una generazione torna difettosa. Questa tabella riunisce i casi riportati sopra:
| Sintomo | Causa probabile | Correzione |
|---|---|---|
Musica aggiunta nonostante N/A | Un utente ha osservato perdite in circa il 20% delle generazioni | Rigenera; evita di richiedere un “mood” musicale in qualsiasi punto del prompt |
| La battuta viene detta dal personaggio sbagliato | Conflitto nell’instradamento tra parlante e audio | Associa esplicitamente l’ID del parlante al personaggio visibile sullo schermo |
| Una battuta in scena viene letta come voice-over | Manca l’associazione con il lip-sync | Specifica che il parlante è visibile; per un vero voice-over aggiungi “lips remain closed” |
| Il riferimento audio viene ignorato | Superamento dei limiti di 3 clip / 15 secondi, oppure riferimento non assegnato | Assegna un ruolo a ogni clip; riduci l’audio di riferimento totale |
| Il modello locale ignora i dialoghi in cinese | ComfyUI ha riutilizzato il tokenizer Qwen; l’encoding della shell ha corrotto il testo | Tokenizer del repository, richiesto ufficialmente, + invio Unicode-safe + <d>[Chinese] 台词</d> (correzione segnalata dalla community) |
| Piano sequenza lungo (>15 s) che si disgrega | Fuori dall’intervallo di progetto di 4–15 s; gli oggetti si appiattiscono e la continuità deriva | Dividi in segmenti da 15 secondi e pianifica la continuità tra uno e l’altro |
La riga sulle installazioni locali merita attenzione: nella segnalazione di @eternityspring, il fatto che «H3 non parla cinese» dipendeva dal riutilizzo del tokenizer e dall’encoding, non dal prompt.
Il costo della struttura: token, iterazioni e portabilità
La struttura ha un costo. Il repository ufficiale pubblica l’uso di token Context-IR per tre casi riproducibili, e i numeri crescono rapidamente all’aumentare dei riferimenti:
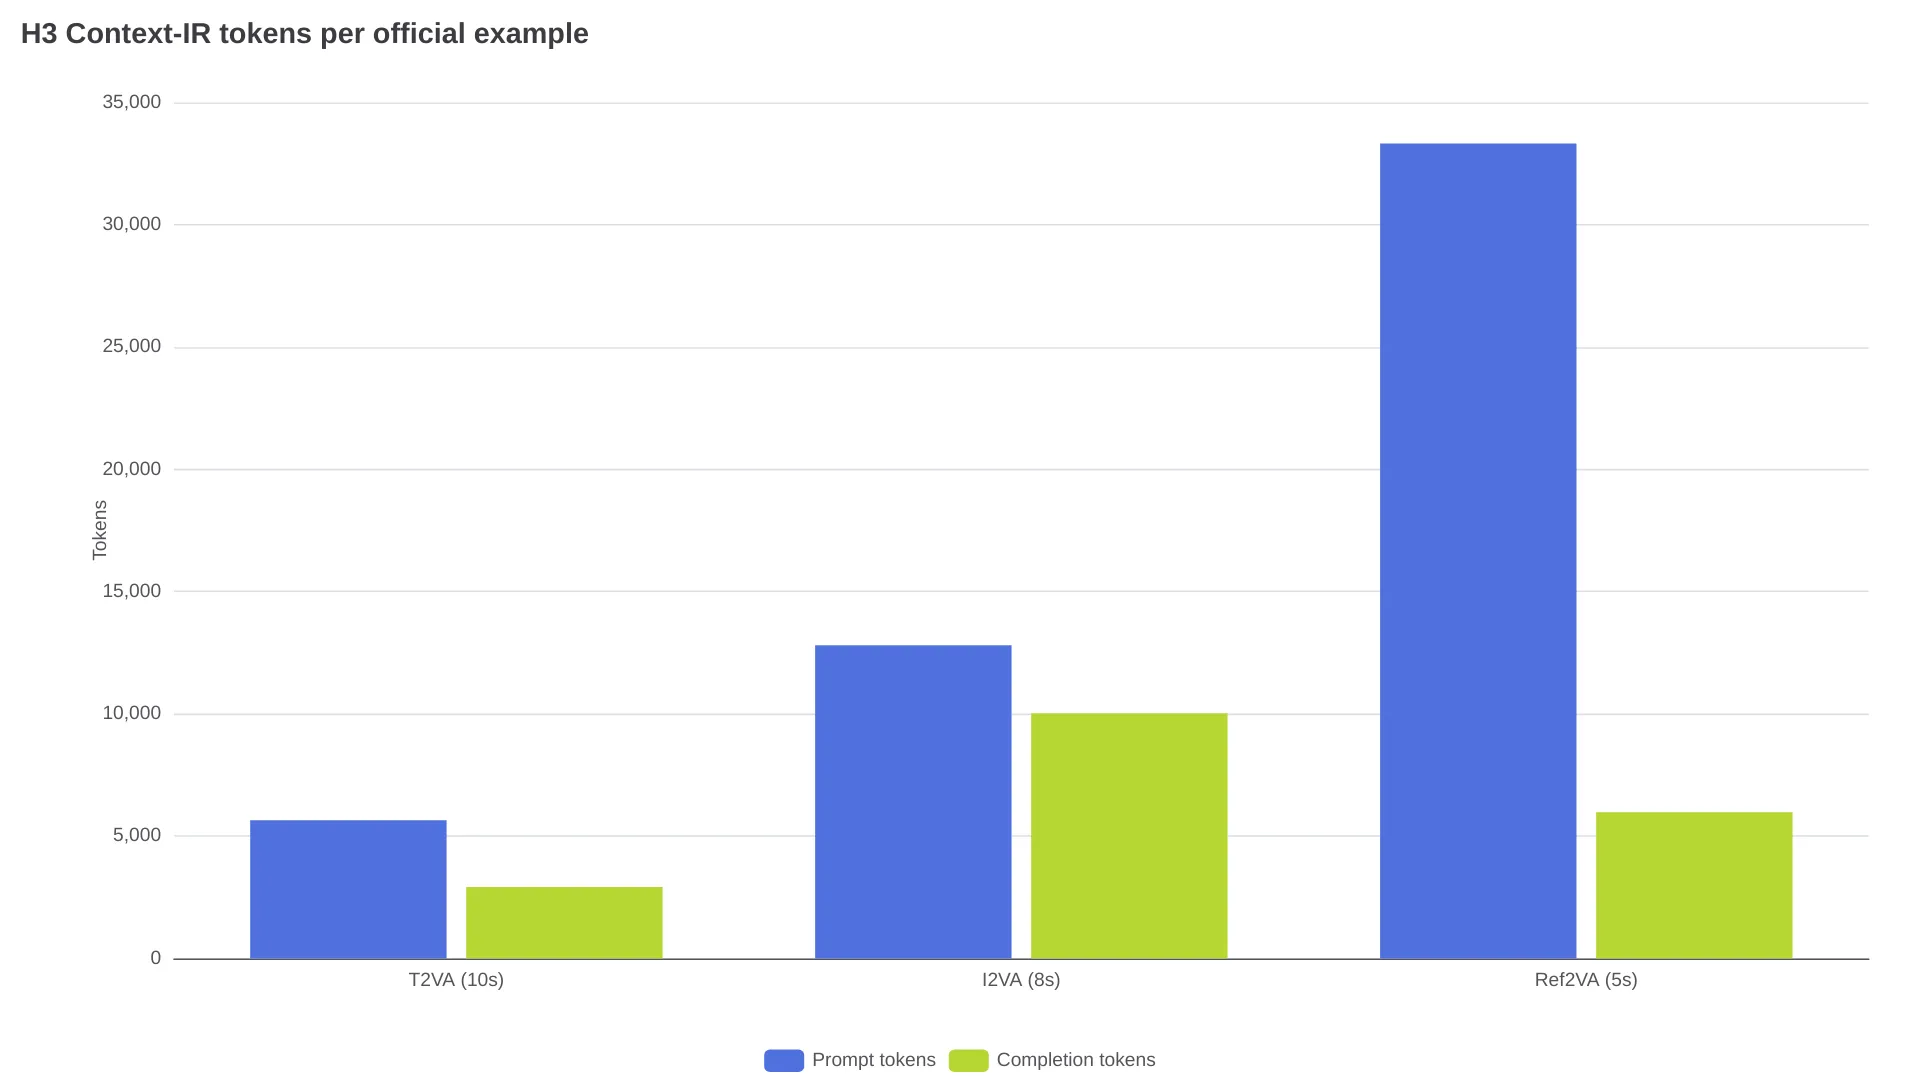
Una generazione solo testo consuma 8.565 token di preprocessing; un lavoro con riferimenti multimodali ne consuma 39.299, di cui 33.323 lato prompt. In locale, questi token aggiungono latenza al preprocessing; nei flussi hosted aumentano l’overhead di elaborazione anche quando il prezzo è espresso per secondo generato. Anche il tempo conta: un creator su X ha documentato 48 ore di lavoro per rifinire un singolo prompt con tre persone e camera orbitante prima di ottenere il risultato desiderato (@LoveUolanda). Il modo più economico di iterare è preparare le bozze a 768p, dove un test di 6 secondi costa circa $0.68, e inviare in 2K solo il prompt consolidato: la pagina del modello del relay elenca per MiniMax H3 le tariffe di $0.1125/s a 768p e $0.1825/s a 2K.
La portabilità è l’ultimo costo nascosto. Campi, ID dei parlanti e tag di H3 sono un dialetto, non uno standard: un confronto cross-model rileva che Veo 3.1 preferisce paragrafi normali con etichette SFX: in linea, mentre Seedance 2.0 utilizza una descrizione in sei slot; nessuno dei due accetta i campi, gli ID dei parlanti o i tag di H3. Una libreria di prompt costruita per H3 va riscritta, non semplicemente copiata e incollata, ovunque altrove.
FAQ sui prompt MiniMax H3
Il formato di prompt strutturato è obbligatorio per MiniMax H3?
No. Nell’API hosted, Context-IR converte le richieste libere in linguaggio naturale nella rappresentazione interna; la struttura conta soprattutto nelle esecuzioni locali degli open weights e per stacchi precisi, timestamp e instradamento dei parlanti.
Come impedire a MiniMax H3 di aggiungere musica di sottofondo?
Chiudi con non_diegetic_music: N/A e non richiedere altrove un mood musicale; le perdite possono comunque verificarsi, quindi rigenerare è normale.
Quanto deve essere lungo un prompt MiniMax H3?
Gli esempi MiniMax sono di 300–700 parole, mentre il puro text-to-video accetta fino a circa 7.000 caratteri; quando identità e movimento sono portati dai riferimenti, il prompt dovrebbe accorciarsi, non allungarsi.
Posso riutilizzare prompt H3 con Seedance o Veo?
No. I campi nominati, gli ID dei parlanti e i tag di H3 sono specifici del modello; Seedance usa un formato a sei slot e Veo accetta paragrafi normali, quindi ogni modello di destinazione richiede una propria riscrittura.
Perché la mia installazione locale di H3 ignora i dialoghi non inglesi?
Di solito è un problema della toolchain, non del modello: configurazioni che riutilizzano il tokenizer Qwen o shell che alterano Unicode rompono il dialogo prima della generazione. Usa il tokenizer ufficiale del repository e il formato dialogo <d>[Language].
Verdetto: chi dovrebbe imparare il formato
| Il tuo caso d’uso | Verdetto |
|---|---|
| Film multi-shot con dialoghi | Impara il formato completo; considera tentativi extra per l’audio e l’alternativa delle virgolette |
| Animazione di prodotto / immagine fissa (I2VA) | Impara la versione leggera: frase di allineamento + movimento + campi audio |
| Storyboard o serie con coerenza dei personaggi | Sì: i riferimenti fanno il grosso del lavoro; mantieni i prompt minimi e facilmente instradabili |
| Clip singole occasionali, uso casuale | Salta quasi tutto: descrizione semplice + non_diegetic_music: N/A sono sufficienti |
| Creare un’unica libreria di prompt cross-model | No: ogni dialetto di modello richiede la propria versione; scrivi per singolo modello |
Impara il formato per lavori multi-shot, con timestamp o guidati da riferimenti: è qui che l’aderenza risulta documentata e riproducibile. Per clip singole puoi farne a meno; nei lavori audio ricchi di dialoghi, aspettati ritentativi più che obbedienza perfetta.
La community stessa è divisa su questo compromesso: nello stesso mese sono comparsi sia 48 ore di lavoro su un prompt camera sia un post da 880 upvote in cui un commentatore ha scritto che «leggere il manuale è stato davvero entusiasmante». Finché l’aderenza ai campi audio non raggiungerà quella ai comandi camera, la strategia più pratica è questa: lascia a un agent la bozza della struttura, verifica personalmente i campi audio e fai test economici a 768p prima di impegnarti con il 2K.