 AIREITER
Portare DeepSeek dentro Codex non richiede più proxy né livelli di traduzione: Codex usa la Responses API e DeepSeek la supporta direttamente. C'è però un limite importante: al momento funziona un solo modello DeepSeek, che per di più non gestisce le immagini.
DeepSeek si può usare con Codex?
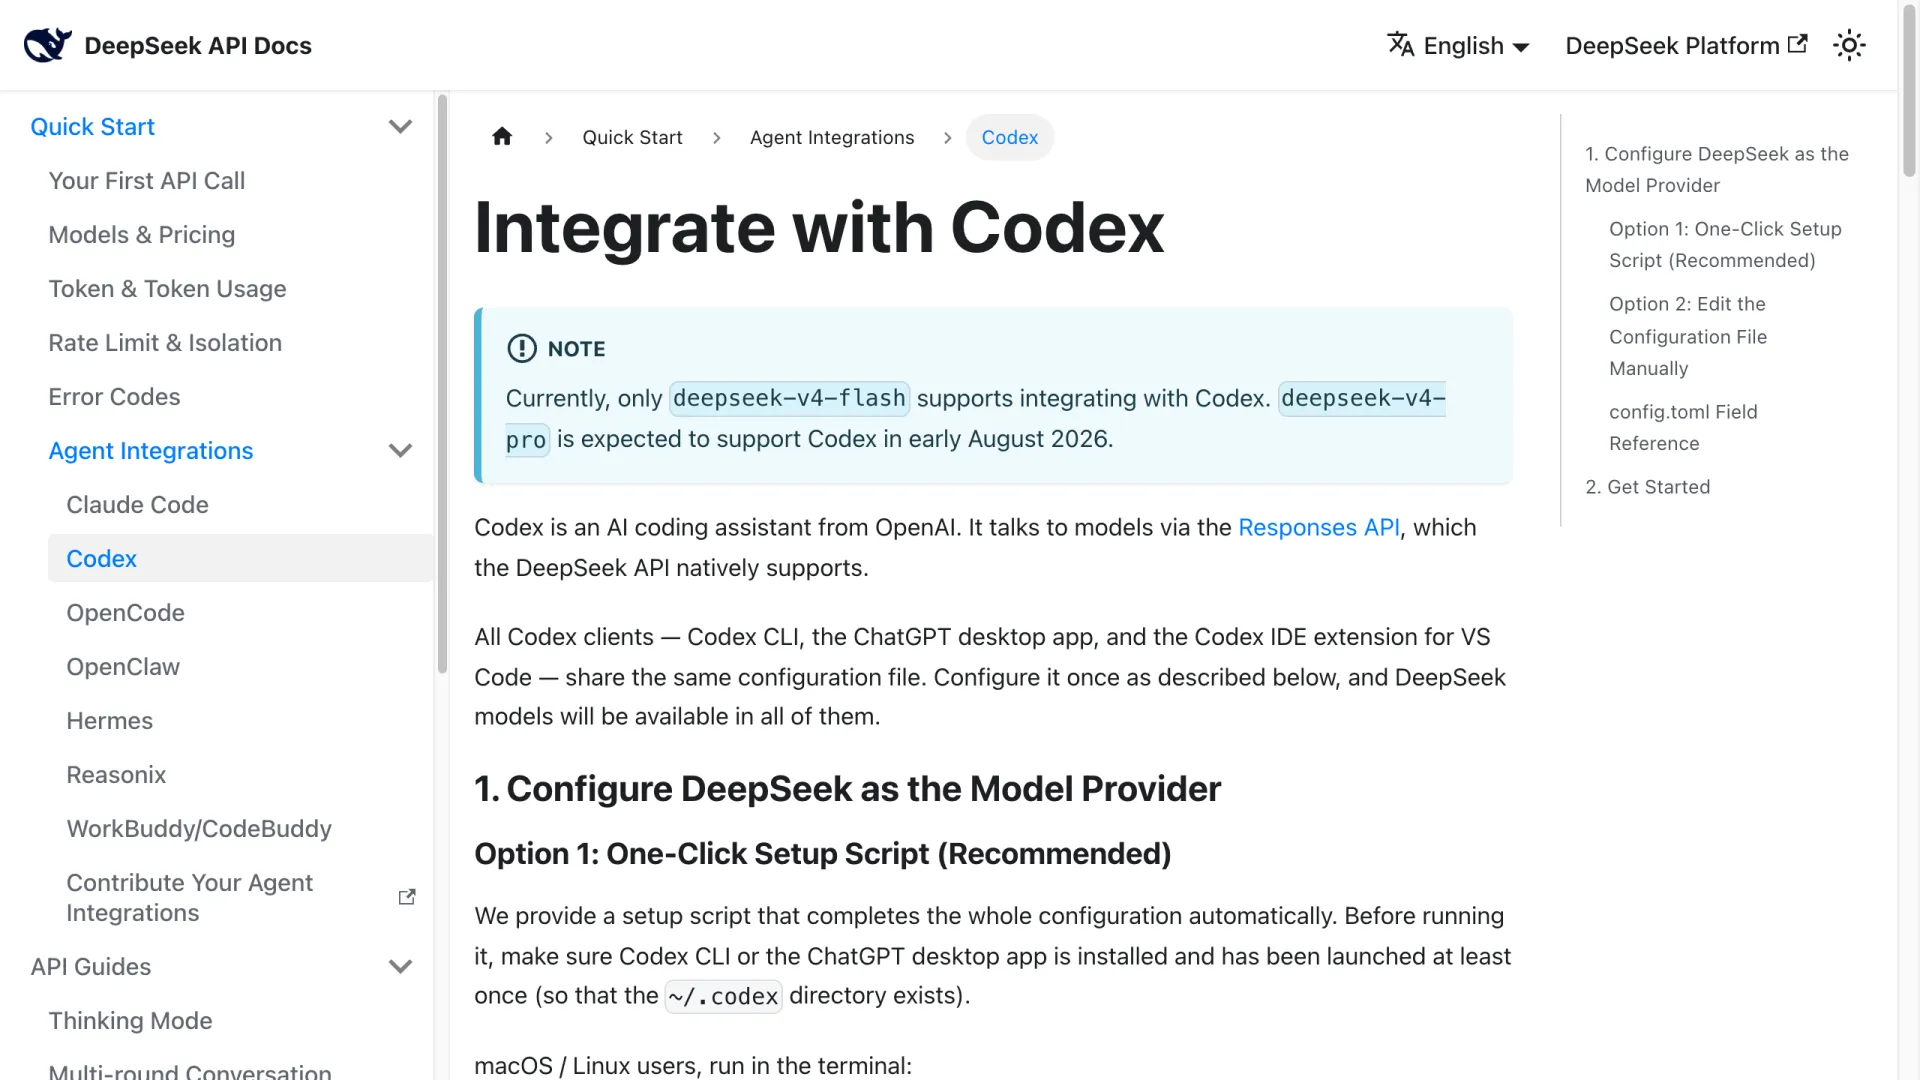
Sì. Codex comunica con i modelli attraverso la Responses API di OpenAI, un protocollo che l'API di DeepSeek supporta nativamente. DeepSeek può quindi essere dichiarato come provider nel file di configurazione di Codex. La procedura è pubblicata dalla stessa DeepSeek nella sezione Agent Integrations → Codex della documentazione API.
È cambiato soprattutto ciò che serve per l'installazione. Codex ha abbandonato il vecchio percorso wire_api = "chat" in favore della Responses API; per un periodo, questo rendeva DeepSeek accessibile solo passando da un layer di traduzione come LiteLLM, un router con una propria implementazione Responses, oppure un bridge scritto a mano. Queste soluzioni restano valide, ma non sono più necessarie per iniziare. La configurazione del provider è inoltre distinta dall'aggiunta a Codex di strumenti MCP legati a DeepSeek.
La stessa configurazione vale su tutte le versioni di Codex. Codex CLI, l'app desktop ChatGPT e l'estensione Codex per VS Code leggono tutte la directory ~/.codex: basta quindi configurare tutto una volta sola.
Quale modello DeepSeek funziona in Codex
Solo deepseek-v4-flash. Nella tabella dei prezzi, DeepSeek indica il supporto alla Responses API con ✓ per deepseek-v4-flash e con ✗ per deepseek-v4-pro; una nota promette il supporto per Pro all'inizio di agosto 2026. Al 3 agosto 2026 quella nota era ancora presente e Pro risultava ancora segnato con ✗.
Entrambi i modelli compaiono nel catalogo models.json creato dalla procedura, quindi nulla nel file di configurazione impedisce di selezionare Pro. L'errore però arriva a monte, al momento della richiesta. Anche il preset DeepSeek di CC Switch riporta lo stesso avviso nel codice sorgente del preset: passare a Pro prima che DeepSeek abiliti l'integrazione genera errori.
Chi vuole oggi il modello più potente può usare il suo endpoint in formato Anthropic. Ecco perché Pro compare nelle configurazioni di Claude Code ma non in quelle di Codex. Prezzi e concorrenza dei due modelli sono abbastanza diversi da rendere la scelta significativa; per il confronto, vedi deepseek-v4-flash vs deepseek-v4-pro.
Metodo 1: lo script ufficiale
DeepSeek fornisce uno script che scrive l'intera configurazione. È la strada più rapida se non state già gestendo diversi provider. Prima bisogna installare e avviare almeno una volta Codex CLI o l'app desktop ChatGPT, così da creare ~/.codex. Il client Codex deve inoltre essere almeno alla versione 0.144.0, indicata come requisito minimo dal catalogo dei modelli.
# macOS / Linux
bash <(curl -fsSL https://cdn.deepseek.com/api-docs/codex-deepseek-setup-en.sh)

# Windows, in PowerShell
irm https://cdn.deepseek.com/api-docs/codex-deepseek-setup-en.ps1 | iex
Lo script presenta un menu: 1 seleziona deepseek-v4-flash, 2 seleziona deepseek-v4-pro, 3 ripristina la configurazione precedente all'installazione. Va scelta l'opzione 1: la 2 scrive una configurazione formalmente valida per un modello che non può ancora servire richieste Codex. Al primo avvio chiede la chiave API, da creare su platform.deepseek.com.
Come interviene su una configurazione esistente
Il 3 agosto 2026 ho eseguito lo script ufficiale su un CODEX_HOME temporaneo, popolato con una configurazione volutamente conflittuale: un profile, un vecchio model_verbosity, un model_reasoning_summary, oltre a un server MCP e a un progetto attendibile. Per replicare il test: CODEX_HOME=/tmp/probe sh codex-deepseek-setup-en.sh, poi selezionate 1. Lo script ha segnalato quattro modifiche, spiegandole una per una:
• Rewrote model: "gpt-5.6-sol" → "deepseek-v4-flash"
• Removed profile = "myprofile"  ← a profile masks model / model_provider / model_catalog_json
• Removed model_verbosity = "high"  ← a stale value may be outside what the model supports
• Removed model_reasoning_summary = "detailed"  ← models.json declares default_reasoning_summary=none
Il blocco [mcp_servers.playwright], il livello di attendibilità in [projects."..."] e approval_policy sono rimasti invariati. Prima di scrivere alcunché, lo script ha copiato il file originale in ~/.codex/backup-deepseek/. Ha poi validato entrambi i file: models.json come JSON, config.toml cercando errori di parsing e chiavi duplicate. È un singolo test su una sola macchina: dimostra che i percorsi di backup e ripristino esistono, non garantisce il comportamento con qualsiasi forma di configurazione.
Metodo 2: modificare config.toml a mano
La modifica manuale è la scelta giusta se volete versionare la configurazione oppure capire il significato di ogni campo. Create ~/.codex/models.json usando il catalogo dei modelli pubblicato nella documentazione DeepSeek, quindi aggiungete quanto segue a ~/.codex/config.toml:
model = "deepseek-v4-flash"
model_provider = "deepseek"
preferred_auth_method = "apikey"
forced_login_method = "api"
model_reasoning_effort = "high"
model_catalog_json = "~/.codex/models.json"

[model_providers.deepseek]
name = "deepseek"
base_url = "https://api.deepseek.com/"
wire_api = "responses"
experimental_bearer_token = "<your DeepSeek API Key>"| Campo | A cosa serve |
|---|---|
wire_api = "responses" | Seleziona la Responses API invece di Chat Completions. È il campo che rende possibile l'integrazione |
model_catalog_json | Indica il file models.json, che definisce finestra di contesto, livelli di ragionamento e formati degli strumenti. Senza di esso Codex usa metadati generici |
preferred_auth_method, forced_login_method | Autenticazione tramite chiave API anziché login con un account ChatGPT |
model_reasoning_effort | low, high o max: i tre livelli dichiarati dal catalogo DeepSeek |
experimental_bearer_token | La vostra chiave API, memorizzata in chiaro nel file |
Metodo 3: CC Switch, per chi cambia spesso provider
CC Switch è un'app desktop che gestisce la configurazione dei provider per otto strumenti di coding, incluso Codex. Include un preset DeepSeek con endpoint https://api.deepseek.com, deepseek-v4-flash come modello predefinito e sia Flash sia Pro nel catalogo modelli. Scrive gli stessi campi della configurazione manuale, ma da un menu nella barra delle applicazioni invece che da un editor.
Prima di adottarlo, ci sono due aspetti da considerare. A differenza di Claude Code, Codex va riavviato dopo ogni cambio di provider perché la modifica abbia effetto. Inoltre un'unica app conserva le credenziali di tutti i provider registrati ed esegue un servizio locale per instradarle: un profilo di sicurezza diverso da quello di una singola chiave API in un singolo file.
Come verificare che la configurazione sia attiva
Avviate Codex CLI in un progetto e controllate il banner iniziale: le righe model e provider sono la conferma. Con la mia configurazione di test, il 3 agosto 2026 e codex-cli 0.146.0, l'output era questo:
OpenAI Codex v0.146.0
model: deepseek-v4-flash
provider: deepseek
reasoning effort: high
Un errore nella chiave ha una firma riconoscibile e riporta l'endpoint usato: è il modo più rapido per confermare che le richieste stanno effettivamente partendo verso DeepSeek.
ERROR: unexpected status 401 Unauthorized: Authentication Fails, Your api key: ****r000 is invalid,
       url: https://api.deepseek.com/responses
Prima di mostrare l'errore, Codex ha ritentato cinque volte: con una chiave digitata male ci sono quindi alcuni secondi di silenzio. Nell'app desktop ChatGPT, su macOS il selettore del modello mostra Custom anziché il nome del modello; è l'etichetta usata dall'app per qualsiasi modello configurato localmente. Viene comunque usato il modello DeepSeek selezionato. Se nei log di Codex compaiono fallback model metadata o Unknown model, models.json non è stato caricato e il percorso del catalogo è errato.
Cosa cambia usando DeepSeek dentro Codex
Rispetto a Codex con un modello OpenAI, ci sono quattro comportamenti diversi. Non sono problemi da risolvere.
Niente input di immagini. Le voci DeepSeek in models.json dichiarano input_modalities: ["text"]: con DeepSeek attivo non sono disponibili screenshot incollati né allegati immagine, in nessun client Codex. Uno sviluppatore su Hacker News ha incontrato lo stesso limite il 2 agosto 2026 e lo ha aggirato mantenendo un secondo provider per la visione:
Dato che DeepSeek V4 non ha capacità visive, ha fatto usare a OMP GPT 5.6 Luna tramite il sub di Codex.
La soluzione richiede un secondo blocco [model_providers.*] che punti a un modello capace di accettare immagini. La struttura wire_api = "responses" resta identica: un endpoint aggregatore che offre GPT-5.6 entra nella stessa configurazione e il passaggio avviene modificando una sola riga model.
Le sessioni precedenti sembrano scomparse. Codex raggruppa la cronologia delle sessioni in base al metodo di login. Passando da un abbonamento ChatGPT a una chiave API di terze parti, il gruppo precedente viene nascosto, non eliminato. Ripristinando la configurazione originale tornano visibili le vecchie sessioni, mentre quelle DeepSeek spariscono dalla vista.
La chiave rimane in chiaro nel file di configurazione. experimental_bearer_token contiene la chiave vera e propria, non un riferimento a una variabile d'ambiente. Di conseguenza ~/.codex/config.toml contiene un segreto: va controllato prima di sincronizzare la directory o di pubblicare un repository di dotfile.
Potrebbe definirsi ChatGPT. Il models.json installato dall'integrazione include il prompt di harness di Codex, che si apre con "You are Codex, an agent based on GPT-5." Non è una semplice etichetta: quel prompt definisce protocollo degli strumenti, regole di approvazione e formato dell'output dell'agente. Per questo il comportamento differisce da quello dello stesso modello in una chat essenziale, e la riga sull'identità arriva dall'harness, non da una pretesa di discendenza del modello.
Quanto costa
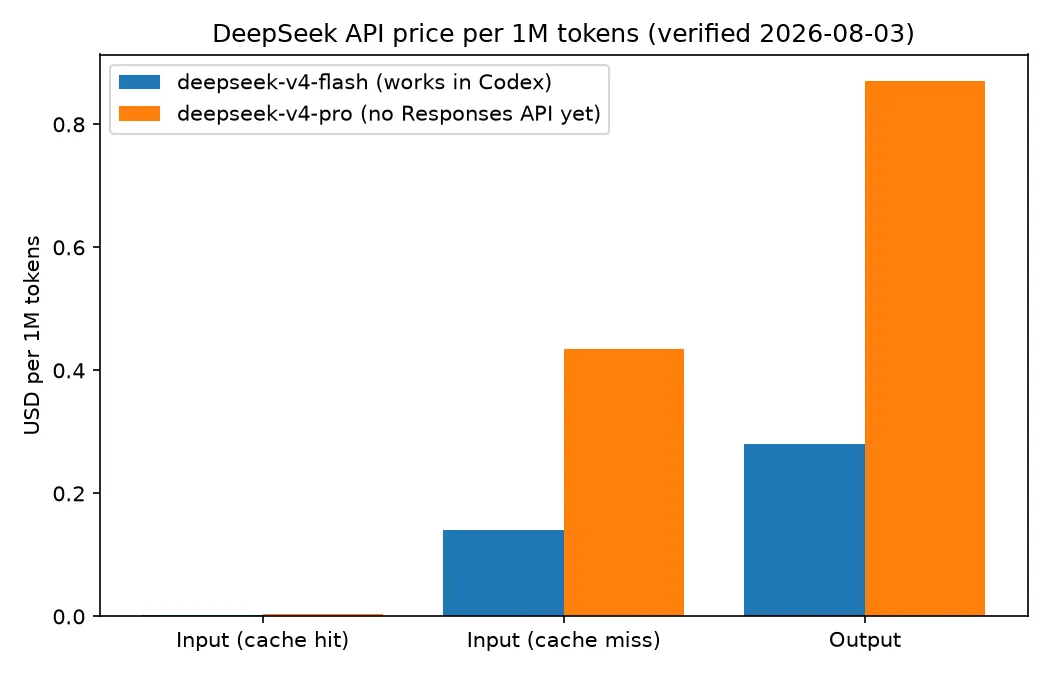
deepseek-v4-flash costa $0.14 per milione di token di input non presenti in cache e $0.28 per milione di token di output, valori verificati sulla pagina prezzi di DeepSeek il 3 agosto 2026. Un cache hit costa $0.0028 per milione di token di input, cinquanta volte meno di un cache miss. È questo divario a determinare il costo delle lunghe sessioni agentiche, perché un agente di coding rinvia un contesto sempre più ampio a ogni turno.
| deepseek-v4-flash | deepseek-v4-pro | |
|---|---|---|
| Funziona in Codex | Sì | Non ancora |
| Stringa della versione | DeepSeek-V4-Flash-0731 | DeepSeek-V4-Pro |
| Contesto / output massimo | 1M / 384K | 1M / 384K |
| Input, cache hit | $0.0028 | $0.003625 |
| Input, cache miss | $0.14 | $0.435 |
| Output | $0.28 | $0.87 |
| Limite di concorrenza | 2500 | 500 |
La tabella non mostra due dettagli. DeepSeek dichiara l'arrivo di prezzi differenziati tra fasce di punta e fuori punta: durante le ore di punta, ogni giorno dalle 09:00 alle 12:00 e dalle 14:00 alle 18:00 ora di Pechino (UTC+8), le tariffe saranno 2× quelle indicate. La data di avvio deve ancora essere annunciata. Inoltre, il catalogo dichiara una finestra di contesto da 1M efficace al 95%, con troncamento applicato secondo la policy definita in models.json.
FAQ
Posso usare DeepSeek in Codex senza un abbonamento ChatGPT?
Sì. preferred_auth_method = "apikey" e forced_login_method = "api" fanno autenticare Codex con la chiave DeepSeek, saltando completamente il login dell'account.
L'estensione VS Code e l'app desktop richiedono configurazioni separate?
No. Tutti e tre i client Codex leggono la stessa configurazione in ~/.codex. Dopo un cambio, riavviate il client desktop perché rilevi la modifica.
Come torno al modello ufficiale?
Rieseguite lo script di configurazione e scegliete l'opzione 3, che ripristina il config.toml salvato prima dell'installazione. Se avete configurato Codex manualmente, eliminate i campi DeepSeek e il blocco [model_providers.deepseek], quindi effettuate di nuovo l'accesso.
Posso già usare deepseek-v4-pro in Codex?
Non al 3 agosto 2026. Il supporto alla Responses API è ancora segnato con ✗ nella pagina prezzi di DeepSeek; l'obiettivo annunciato era l'inizio di agosto 2026. Conviene quindi ricontrollare quella pagina invece di fidarsi di una configurazione che consente comunque di selezionarlo.
Quale metodo scegliere
| Metodo | Sceglilo se | Contropartita |
|---|---|---|
| Script ufficiale | Volete farlo funzionare con un comando e avere una procedura di backup/ripristino | Riscrive campi di una configurazione che potreste non aver esaminato; la chiave finisce in chiaro |
config.toml manuale | Tenete i dotfile sotto controllo di versione o dovete conoscere ogni campo | Dovete mantenere in autonomia models.json; un percorso errato del catalogo degrada silenziosamente i metadati |
| CC Switch | Alternate DeepSeek, un abbonamento ufficiale e altri provider | Un'app conserva tutte le credenziali ed esegue un servizio locale; Codex richiede un riavvio a ogni cambio |
La vera incognita resta Pro. Flash è la parte economica, veloce e solo testuale della gamma; il modello che molti vorrebbero in un loop agentico è proprio quello che non parla ancora il protocollo richiesto da Codex. Finché quella nota non cambierà, scegliere DeepSeek per Codex significa scegliere deliberatamente Flash.
Approfondimenti correlati: Codex vs Claude Code · Come usare GLM-5.2 in Claude Code