 AIREITER
Il 29 luglio 2026 abbiamo sottoposto Claude Opus 5, GPT-5.6 Sol, Terra e Luna agli stessi quattro compiti. Il risultato: sedici risposte, tutte corrette. Con test così circoscritti, l'accuratezza non basta quindi a distinguere un modello dall'altro.
Le differenze emergono però su due voci che incidono direttamente sul costo: Opus 5 ha fatturato 1.642 token di output contro i 480 di Sol e, superati i 272.000 token in input, le richieste GPT-5.6 passano a un listino più alto, mentre Claude Opus 5 mantiene la stessa tariffa sull'intera finestra da 1M. Su una richiesta da 200K token in input e 20K in output, i due modelli di punta restano entro il 7% del prezzo di listino; con più output e oltre la soglia di 272K, il divario cresce. La scelta dipende quindi dalla forma delle richieste e dal comportamento del modello.
Quattro modelli, quattro prove identiche
Ogni modello ha ricevuto lo stesso prompt utente per quattro verifiche con risposte controllabili meccanicamente: correggere una funzione Python median difettosa, contare le occorrenze di lettere in una stringa fissa, calcolare l'angolo di 7,5 gradi segnato da un orologio alle 3:15 e rifattorizzare una funzione JavaScript volutamente disordinata senza modificarne il comportamento. Le risposte di codice sono state verificate eseguendole su casi limite, non valutate a occhio.
Tutti i modelli hanno superato ogni prova. Le correzioni Python gestivano correttamente le liste di lunghezza pari, tutti e quattro hanno risposto 9 e 7,5 alle domande con risultato 9 e 7,5, e tutti i refactoring hanno superato un diff comportamentale che includeva campi falsy e filtri di categoria null.
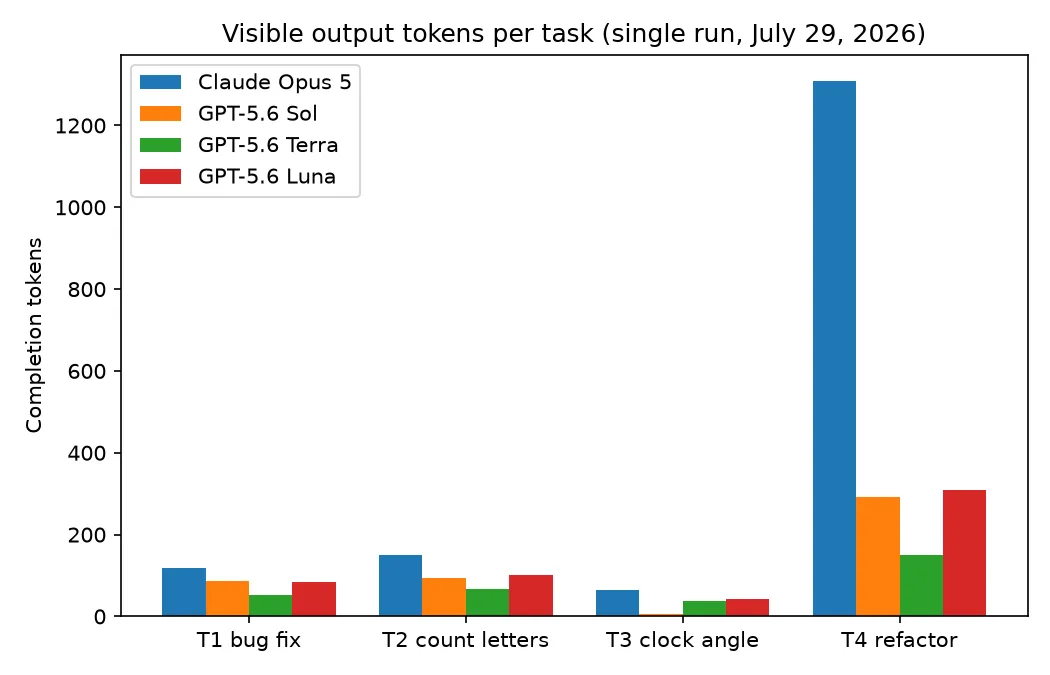
Tre precisazioni prima di citare questi dati. C'è stata una sola esecuzione per modello e per compito: uno smoke test, non un benchmark. Le chiamate passavano attraverso un gateway che inietta il proprio system prompt, perciò i token in input variavano tra 35 e 4.415 a seconda della richiesta e li abbiamo esclusi del tutto. Inoltre, entrambi i fornitori fatturano come output i token di ragionamento nascosti: qui per "token di output" si intende quindi ciò che viene addebitato, non soltanto ciò che si legge.
Dalla parità è emersa comunque una nota qualitativa: Opus 5 ha prodotto il refactoring migliore dei quattro. Ha condensato i due cicli dell'originale in un solo passaggio, ha estratto il moltiplicatore 1,2 in una costante con nome e ha lasciato un commento per spiegare che l'uguaglianza debole era mantenuta deliberatamente per non alterare il comportamento. Sol, Terra e Luna hanno restituito soluzioni corrette, ma più letterali e ancora basate su due cicli.
La vera differenza: token e tempi, non correttezza
Poiché la correttezza è stata identica in tutte e 16 le esecuzioni, il confronto pratico riguarda il costo di ciascuna risposta. Opus 5 ha completato i quattro compiti in 32,4 secondi complessivi, fatturando 1.642 token di completamento. Sol ha impiegato 19,7 secondi e 480 token, Terra 11,7 secondi e 308, Luna 15,3 secondi e 537.
| Esecuzione singola, 29 luglio 2026 | Corrette | Token di output | Tempo totale | Costo del solo output |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1.642 | 32,4s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19,7s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11,7s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15,3s | $0.0032 |
Il divario non dipende dalla lunghezza della risposta, ma dal volume di ragionamento. Il refactoring di Opus 5 ha fatturato 1.308 token a fronte di una risposta finale di 492 byte, e per rispondere "7.5" ha usato 64 token contro i 7 di Sol. La documentazione Anthropic specifica che Opus 5 usa per impostazione predefinita un effort elevato via API: una parte della differenza è dunque legata al default, non a una caratteristica immutabile. Abbiamo misurato il comportamento predefinito, non un minimo teorico.
I dati della community mostrano una tendenza analoga. Un post con grafico su r/Anthropic, primo risultato Google per questa query al nostro controllo del 29 luglio, mostra i due modelli quasi alla pari nei punteggi di coding, con Opus più lento e sensibilmente più affamato di token. Un utente di r/ClaudeCode ha riassunto la stessa conclusione in modo meno diplomatico:
GPT 5.6 Sol fa semplicemente ciò che gli chiedi. Opus 5 scrive "Guerra e pace" in 12 volumi, poi fa ciò che gli chiedi.
Le impostazioni di effort possono però ribaltare l'economia. Un commentatore di Hacker News che analizzava dati Artificial Analysis ha osservato che Opus 5 con effort high arrivava a circa $1.06 per esecuzione dell'indice di intelligence, contro $1.04 per Sol impostato su max: quasi parità quando entrambi i modelli ragionano intensamente.
GPT-5.6 non è un singolo modello: Sol, Terra e Luna
GPT-5.6 non identifica un solo modello. OpenAI offre tre SKU e la stringa senza suffisso gpt-5.6 è documentata come alias di gpt-5.6-sol, il più costoso dei tre. Una configurazione che indica gpt-5.6 viene quindi fatturata alla tariffa massima della famiglia: un dettaglio da controllare prima di qualunque confronto sui costi.
Nel riferimento ai modelli, OpenAI definisce Sol il suo "frontier model for complex professional work", Terra il livello che "balances intelligence and cost" e Luna quello "optimized for cost-sensitive workloads". Tutti e tre condividono una finestra di contesto da 1,05M token, 128K token di output massimi, knowledge cutoff al 16 febbraio 2026 e sei livelli selezionabili di ragionamento, da none a max.
| Specifiche, verificate il 29 luglio 2026 | Claude Opus 5 | GPT-5.6 (tutti e tre) |
|---|---|---|
| Finestra di contesto | 1M token | 1,05M token |
| Output massimo | 128K (300K tramite Batch API beta) | 128K |
| Knowledge cutoff affidabile | maggio 2026 | 16 febbraio 2026 |
| Controllo del ragionamento | Adaptive thinking, effort predefinito su high | none / low / medium / high / xhigh / max |
| ID API | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
Due di queste righe hanno un impatto concreto sulla scelta. Il knowledge cutoff di maggio 2026 di Opus 5 è più recente di tre mesi rispetto all'intera famiglia GPT-5.6, un vantaggio rilevante per contenuti che citano rilasci della primavera 2026. E i controlli sul ragionamento differiscono per natura, non solo per numero: GPT-5.6 consente di disattivarlo completamente con none, mentre Opus 5 gestisce in modo adattivo il proprio budget di pensiero ed espone livelli di effort aggiuntivi.
Prezzi: finestra piatta fino a 1M contro soglia a 272K
Entrambi i fornitori pubblicano tariffe chiare per token e, sotto i 272K token in input, le cifre sono vicine: $5 per milione di token in input per entrambi i modelli di punta, $25 per milione in output per Opus 5 contro $30 per Sol, identica tariffa di $0.50 per input in cache e sconto batch del 50% da entrambe le parti. A queste condizioni, una richiesta da 200K token in input e 20K in output costa $1.50 con Opus 5 e $1.60 con Sol.
| Per 1M token, prezzo di listino al 29 luglio 2026 | Input | Input in cache | Output | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
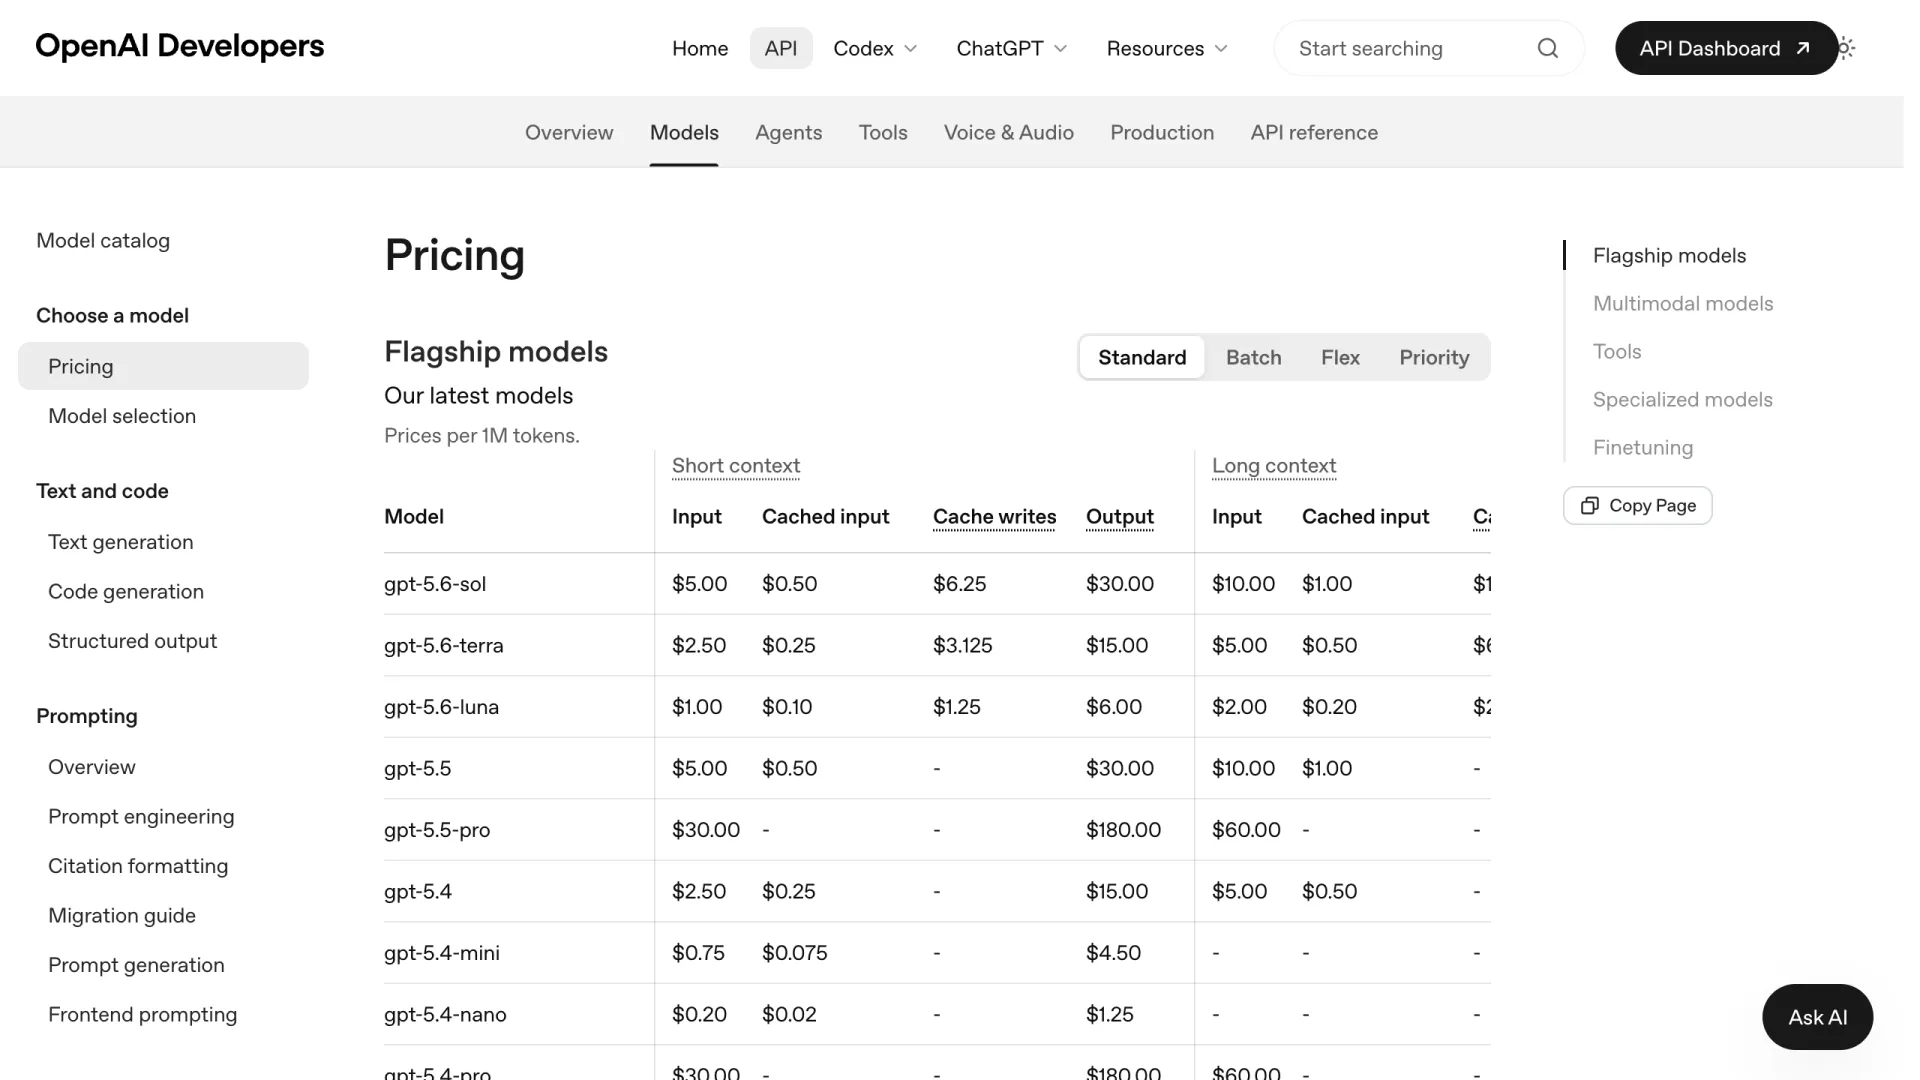
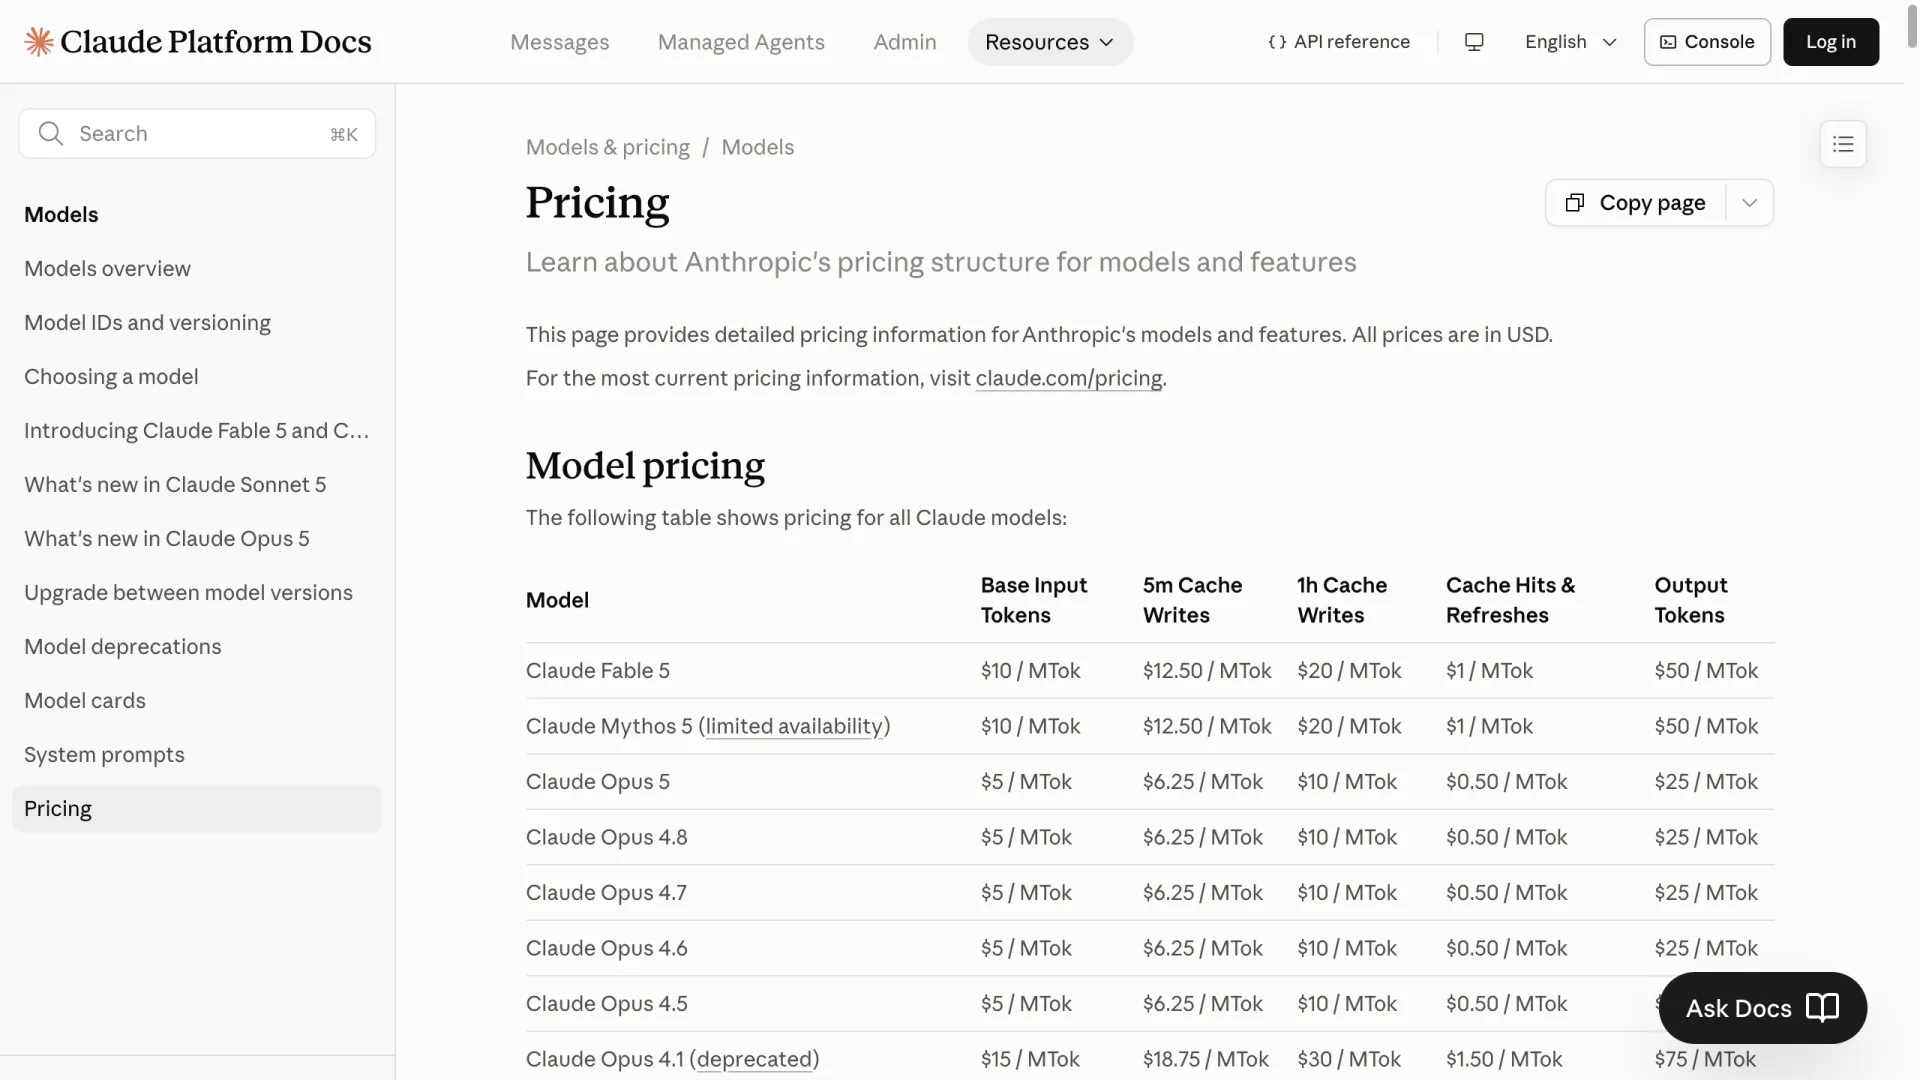
La differenza strutturale scatta a 272K token in input. La pagina dei prezzi di OpenAI separa ogni tariffa GPT-5.6 in colonne per contesto breve e lungo: oltre 272K input, l'input costa 2x e l'output 1,5x, portando Sol a $10 e $45. La documentazione sui prezzi di Anthropic descrive il modello opposto in una frase: "A 900k-token request is billed at the same per-token rate as a 9k-token request."
Tradotto in dollari, mantenendo 20K token in output: una richiesta da 300K token in input costa $2.00 con Opus 5 e $3.90 con Sol. A 500K, $3.00 contro $5.90; a 900K, $5.00 contro $9.90. Superata la soglia, Opus 5 costa circa la metà di Sol a parità di struttura della richiesta.
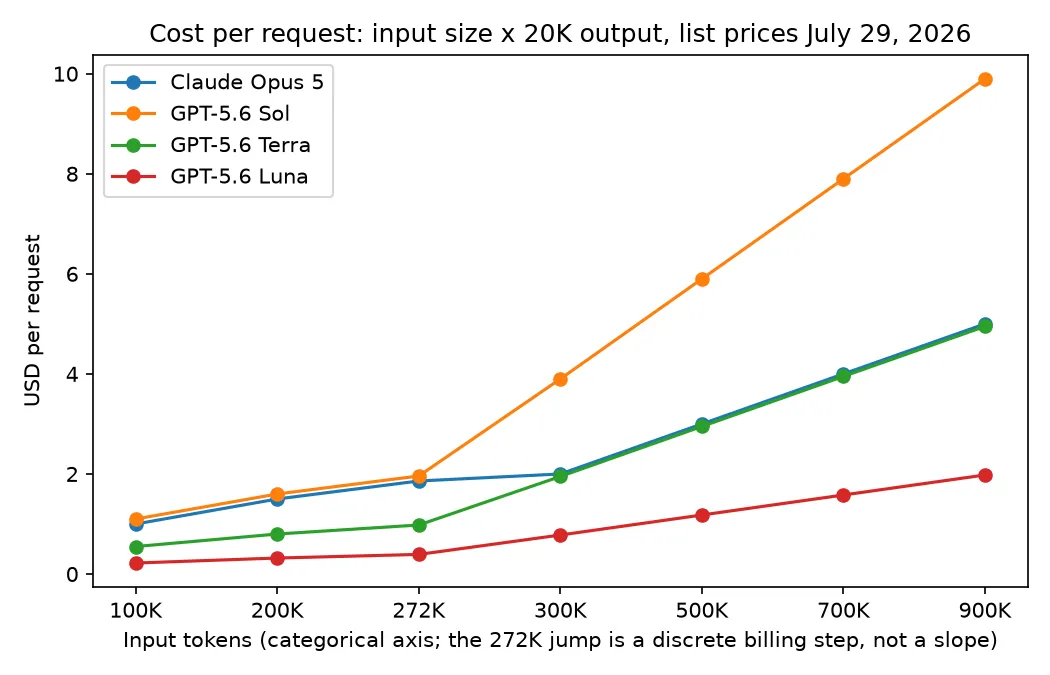
Il grafico riserva una sorpresa che non porta a una vittoria netta di Anthropic. Oltre 272K, la tariffa input raddoppiata di Terra è $5, la stessa di Opus 5, mentre l'output long-context di Terra costa $22.50 contro i $25 di Opus 5. Con 20K token in output, Terra risulta quindi stabilmente cinque centesimi meno cara per richiesta a 300K, 500K, 700K e 900K. Quei cinque centesimi scalano con il volume di output, non con l'ampiezza dell'input: la differenza è $2.50 per milione di token in output.
Tre note per la pianificazione del budget. Anthropic propone per Opus 5 una modalità fast, in research preview, a $10 per input e $50 per output; OpenAI offre un livello priority al doppio delle tariffe standard, solo per contesto breve. La data residency nella regione USA aggiunge circa il 10% con entrambi i fornitori. Inoltre, secondo una nota della stessa Anthropic, l'attuale tokenizer di Claude genera circa il 30% di token in più rispetto ai modelli pre-4.7 per lo stesso testo: prima di moltiplicare le tariffe, il controllo più onesto resta eseguire un prompt rappresentativo su entrambi i tokenizer.
Quale modello usare in base al carico di lavoro
Con la correttezza in parità, l'instradamento dipende dalla forma della richiesta e dallo stile di lavoro. Su r/ClaudeCode, alcuni sviluppatori usano Sol con effort high come revisore e agente QA, considerandolo accurato e valido con il browser; su r/codex, altri indirizzano la maggior parte del lavoro verso i tier GPT meno costosi con ragionamento medium, riportando il miglior rapporto costo-prestazioni.
| Profilo della richiesta | Modello consigliato | Motivo |
|---|---|---|
| Sotto 272K input, loop agentici ricchi di output | Claude Opus 5 | $25 contro $30 per l'output; miglior giudizio di refactoring nella nostra prova |
| Sotto 272K, priorità a latenza o alti volumi | GPT-5.6 Terra | Il modello che ha superato i test più veloce ed economico |
| Oltre 272K token in input | Claude Opus 5 o Terra | Le tariffe long-context di Sol raddoppiano; Terra resta cinque centesimi sotto Opus 5 |
| Review, QA e controlli guidati dal browser | GPT-5.6 Sol | Sei livelli di effort per regolare la profondità della review; da validare sul proprio set QA |
| Classificazione ed estrazione usa e getta | GPT-5.6 Luna | $1/$6 e ha superato tutte e quattro le verifiche |
Non tutti concordano sul fatto che Sol meriti il posto nel QA: una discussione su r/codex lo definisce una regressione rispetto a GPT-5.5, attribuendo però a Opus 5 la capacità di completare più attività per piano. Testare i default costa poco: tutti e quattro i modelli sono nel catalogo AIReiter (Opus 5, Sol), così potete ripetere i vostri compiti fianco a fianco.
Il numero da ricordare dopo questo confronto è uno: 272.000 token in input. Al di sotto, scegliete in base a comportamento, latenza e differenza di $5 nella tariffa di output. Al di sopra, l'argomento del prezzo favorisce Anthropic rispetto a Sol, con Terra cinque centesimi sotto Opus 5 e Luna molto più economico di entrambi.
FAQ
gpt-5.6 è lo stesso modello di GPT-5.6 Sol?
Sì. Nel riferimento ai modelli OpenAI, la stringa senza suffisso gpt-5.6 è indicata come alias risolto in gpt-5.6-sol; viene quindi fatturata alle tariffe di Sol: $5 per input e $30 per output per milione di token sotto 272K input, $10 e $45 oltre la soglia.
Claude Opus 5 costa di più per le richieste con contesto lungo?
No. Anthropic fattura l'intera finestra da 1M alle tariffe standard sulla normale API e afferma che una richiesta da 900K token costa per token quanto una da 9K. Solo la modalità fast opzionale prevede un sovrapprezzo: $10 per input e $50 per output.
È più economico Claude Opus 5 o GPT-5.6?
Dipende dal tier. Sotto 272K input, Opus 5 costa $5 in meno per milione di token in output rispetto a Sol e per il resto i due modelli hanno le stesse tariffe; Terra e Luna costano molto meno di entrambi. Oltre 272K, Opus 5 costa circa la metà di Sol per richiesta, mentre Terra rimane marginalmente meno costoso di Opus 5.
Claude Opus 5 è migliore di GPT-5.6 per il coding?
Nella nostra esecuzione del 29 luglio, entrambi hanno corretto, contato e rifattorizzato correttamente; inoltre, il post con grafico su r/Anthropic che il 29 luglio compariva per primo su Google per questa query li mostrava quasi alla pari nei punteggi di coding. Opus 5 ha evidenziato il miglior giudizio nel refactoring, ma con le impostazioni predefinite ha fatturato 3,4 volte i token di output di Sol: per il coding, la scelta è soprattutto una questione di economia e verbosità.
Quali sono i knowledge cutoff di Opus 5 e GPT-5.6?
Anthropic indica per Claude Opus 5 un knowledge cutoff affidabile a maggio 2026. Tutti e tre i modelli GPT-5.6 condividono il cutoff del 16 febbraio 2026, circa tre mesi precedente.