 AIREITER
Per chi usa i piani a pagamento di Claude, Anthropic indica ora Opus 5.5 come modello predefinito per il lavoro basato sulla conoscenza. I dati disponibili sostengono in gran parte questa scelta, ma nell’uso reale c’è un problema ricorrente: su Pro, Max e Team la quota tende a esaurirsi prima del previsto.
Presentato il 22 settembre 2026 come primo modello della famiglia Claude 5.5, Opus 5.5 prometteva prestazioni vicine a Claude Fable 5.1 nella maggior parte delle attività, con un costo operativo inferiore del 40% rispetto a Opus 5 (anthropic.com). Il 12 novembre 2026 Anthropic ha poi chiarito la propria linea guida per l’uso quotidiano: per ricerca, analisi, testi, report, fogli di calcolo e presentazioni si parte da Opus 5.5 con effort Medium, salendo solo quando necessario (claude.com). Questa recensione mette insieme le indicazioni ufficiali, benchmark indipendenti e segnalazioni sulla quota: non è un test di laboratorio condotto direttamente.
Verdetto rapido: sì come default, ma con effort Medium
Lasciate selezionato Opus 5.5 e usatelo con effort Medium per il normale lavoro intellettuale. Prima di cambiare modello, alzate l’effort; passate invece a Sonnet 5.5 o Haiku 5.5 quando contano più velocità e volume che capacità di giudizio.
Non è una questione di fedeltà al modello, ma di numeri. Nelle valutazioni di Anthropic su coding e knowledge work, Opus 5.5 a Medium ha eguagliato o superato Opus 5 a High. Factory, citata nella guida daily-driver di Anthropic, ha rilevato lo stesso risultato: Medium raggiunge Opus 5 a High usando il 20–25% in meno di token in output. Medium è inoltre l’impostazione predefinita nelle app Claude e in Claude Code, quindi per la maggior parte degli abbonati è già il comportamento standard.
Il limite vero, però, non è il listino API: è la quota dell’abbonamento. Il prezzo API è di $4 per milione di token in input e $20 per milione in output, contro i $5/$25 di Opus 5; le letture dalla cache costano $0.20 per milione. Tuttavia, come ricorda la guida daily-driver di Anthropic, i modelli più costosi consumano più rapidamente i limiti degli abbonamenti. Gli utenti riportano finestre di 5 ore esaurite in 15–30 minuti nelle sessioni pesanti e limiti settimanali consumati molto prima rispetto al periodo iniziale di settembre.
Cosa cambia per Pro, Max e Team con il nuovo modello predefinito
Per gli abbonati conta soprattutto come si comporta la quota con questo nuovo default. Al lancio Anthropic ha dichiarato di aver aumentato i limiti di utilizzo su cinque ore per i piani Pro, Max, Team ed Enterprise basati su seat, introducendo anche un reset del rate limit che gli abbonati possono salvare (anthropic.com), nonostante le segnalazioni di consumo più rapido arrivate dagli utenti a fine ottobre e descritte più avanti. La guida segnala inoltre che Pro, Team standard ed Enterprise con seat in genere non includono Fable 5.2 nei limiti ordinari, salvo promozioni di lancio: Fable attinge ai crediti di utilizzo. In pratica, Opus va considerato il modello di lavoro incluso; Fable, l’eccezione a consumo.
Dove funziona davvero come daily driver: ricerca, analisi e scrittura
Ricerca: report che reggono alla verifica di ogni cifra
Il banco di prova più severo è un report sulle performance aziendali corredato da fonti, in cui il comunicato sugli utili era volutamente difficile da trovare e bastava un numero o una citazione inventati per invalidare l’intero lavoro. Opus 5.5 ha superato 16 report su 18 a vari livelli di effort; secondo Anthropic, né Fable 5.1 né Opus 5 hanno raggiunto la stessa soglia in alcun tentativo (claude.com). A questo si aggiunge il controllo esterno di Walleye Capital, citato nel post di lancio di Anthropic: Opus 5.5 ha risolto in gran parte la suite al livello di effort più basso e, a livelli più alti, ha individuato un errore di indicizzazione off-by-one nelle istruzioni dello stesso valutatore. Secondo Walleye, nessun modello testato in precedenza lo aveva rilevato.
Nell’uso di tutti i giorni significa affidargli ricerche aperte con un output ben definito e le fonti allegate, per poi verificare i numeri anziché la sola qualità della prosa.
Analisi: fogli di calcolo, M&A e grafici densi
In una fusione fittizia fra due società di software HR, Opus 5 e Opus 5.5 hanno entrambi realizzato un modello Excel e una presentazione per il management, arrivando alla stessa conclusione sull’operazione. Opus 5.5 ha chiuso il lavoro in 63 minuti contro 93 minuti, con un costo di produzione dichiarato inferiore del 50%, un modello più completo e meno errori minori (claude.com). Più in generale, nei workflow finanziari Hebbia ha riportato una copertura dei criteri dell’86.6% per Opus 5.5 contro il 60.3% di Opus 5; Rogo ha invece segnalato risultati superiori a Opus 5 a High su BigFinance Bench con circa il 60% di token in output in meno, secondo il post di lancio di Anthropic.
Anche la visione rientra nello stesso quadro. Anthropic definisce Opus 5.5 il suo miglior modello Opus per la visione: documenti complessi, valori nei grafici, screenshot e diagrammi. Riporta inoltre che Opus 5.5, al minimo effort, ha letto grafici densi con maggiore accuratezza di Opus 5 al suo massimo (claude.com). Il punteggio Chartography pubblicato è 64.4% senza strumenti, alla più alta impostazione valutata (claude.com), e 89.0% con strumenti nella scorecard di lancio. L’Elo GDPval-AA per lavoro professionale è invece 1846, contro 1735 per Fable 5.1 e 1708 per Opus 5 (anthropic.com).
In pratica: chiedete direttamente il foglio di calcolo o il deck finale, allegate l’immagine del grafico invece di trascriverne i valori e indicate fin dal primo messaggio la condizione di conclusione del lavoro.
Scrittura: documenti e presentazioni pronti, non semplici scalette
Il vantaggio nella scrittura non riguarda genericamente uno “stile migliore”, ma l’esecuzione delle istruzioni e la verificabilità del risultato. Anthropic sostiene che Opus 5.5 resti nel perimetro richiesto, apra con le conclusioni, riduca il gergo, segua le regole di stile fornite e chiarisca cosa ha fatto, cosa ha trovato e quali input mancano ancora. Le classifiche indipendenti puntano nella stessa direzione: Hayz Labs assegna a Opus 5.5 100 nella scrittura e 100 nel coding, con 94 nella ricerca, e al suo controllo di ottobre lo colloca al primo posto per WebDev e agenti e al secondo per scrittura creativa su Arena.
Il limite da tenere presente è semplice: per replicare con precisione uno stile editoriale interno servono ancora iterazioni.
L’impostazione effort determina il costo
Opus 5.5 offre cinque livelli di effort — Low, Medium, High, Very High/Extra High e Max — secondo l’analisi dei livelli di effort di eesel; inoltre il thinking non può essere disattivato, secondo Hayz Labs. Ai fini della fattura, questa manopola conta molto più di piccole differenze nel prezzo per token.
I calcoli per task riportati nella sintesi di eesel sui dati Artificial Analysis stimano lo stesso task difficile a circa $0.55 con Low, $1.34 con Medium e $5.98 con Max; i rispettivi Intelligence Index sono approssimativamente 42, 51 e 58. Un’esecuzione Max può produrre nell’ordine di 119,000 token in output: a $20 per milione di token in output, è lì che si concentra la spesa. Anche la lettura Pareto di Hayz Labs arriva a valori vicini: circa $1.61 di mediana per task agente su 14 giorni ($1.76 nella mediana della tabella principale), con High attorno a $1.82.
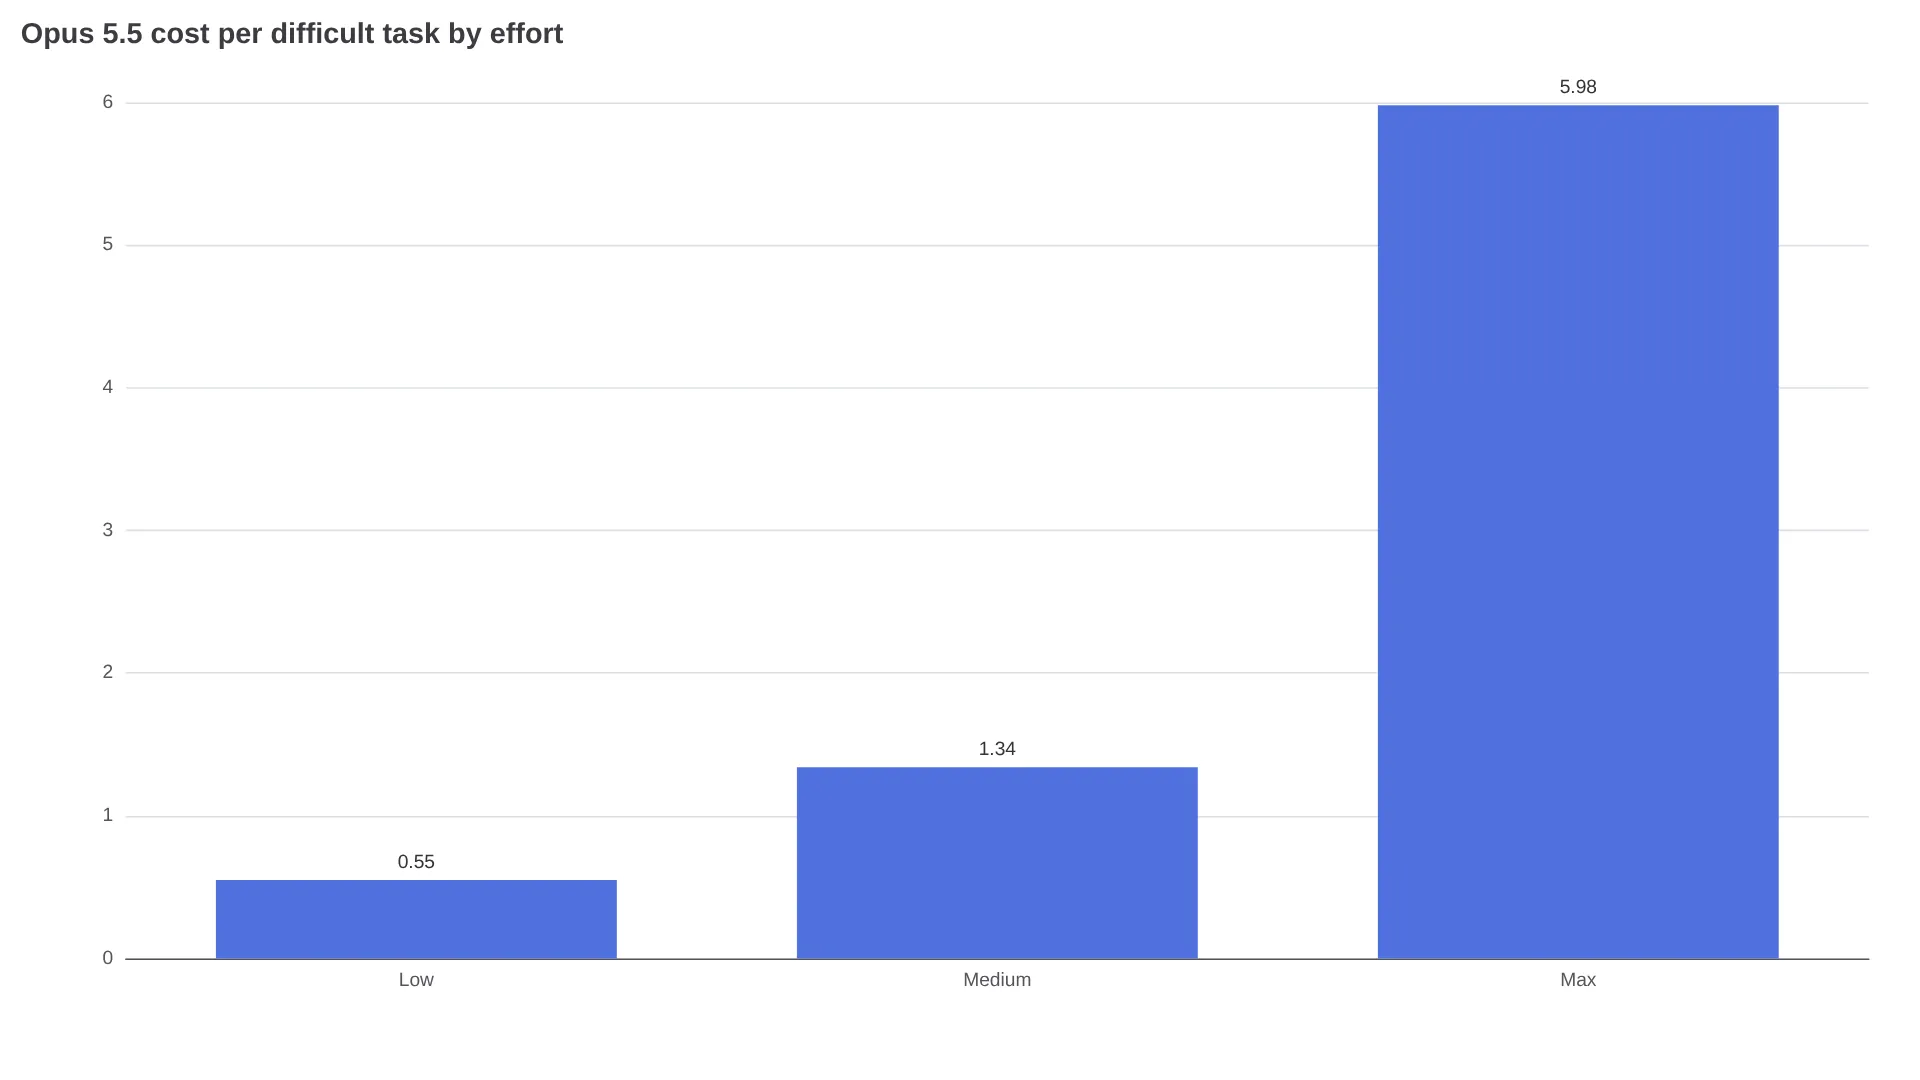
Un effort più elevato richiede più tempo e costa di più, senza migliorare sempre l’esito. Il consiglio di Anthropic è di eliminare formule come “think hard”: il ragionamento è già attivo e la profondità dipende dall’impostazione effort e dal compito. Conviene salire di livello solo quando Medium mostra concretamente di non bastare.
La finestra di contesto è di 1 milione di token, con fino a 128,000 token in output (300,000 in Batch) e visione nativa, secondo la scheda tecnica di eesel. Non è previsto un sovrapprezzo per il contesto lungo, secondo la recensione dei prezzi di eesel: un dettaglio importante per i workflow di verifica su documenti lunghi.
Come scegliere tra Opus 5.5, Sonnet 5.5, Haiku 5.5 e Fable 5.2
La guida di novembre di Anthropic e le analisi indipendenti sui costi convergono sulla stessa regola: prima si regola l’effort, poi eventualmente si cambia modello. I prezzi sotto riportati fanno riferimento alla tabella prezzi della guida daily-driver di Anthropic.
| Modello | Prezzo API per 1M (input/output) | Quando usarlo | Quando passare oltre |
|---|---|---|---|
| Haiku 5.5 | $0.10 / $0.50 fino a 100K token | Ricerche rapide, riassunti, classificazione, lavori circoscritti ad alto volume | L’analisi diventa lunga o richiede maggiore giudizio |
| Sonnet 5.5 | $2 / $10 | Task chiari e ben delimitati, rifinitura di documenti, slide da un brief definito | Si arriva abitualmente a Extra High o Max |
| Opus 5.5 | $4 / $20 | Gran parte della ricerca, analisi, lavoro finanziario e documenti finali | Medium si blocca dopo un effettivo nuovo tentativo a High |
| Fable 5.2 | $8 / $40 | Lavoro tecnico aperto, scienza, coding e finanza con team di subagenti a lunga esecuzione | Normale lavoro di knowledge work — di solito è eccessivo |
La soglia da ricordare è questa: Sonnet 5.5 spinto a Extra High o Max può costare quasi quanto Opus 5.5 per task, restando però inferiore nella capacità di giudizio. Gli utenti dei piani coding riportano la stessa dinamica dal lato abbonamento: meglio non lasciare Sonnet stabilmente oltre Medium e spostare il task su Opus 5.5 a Low (si veda ad esempio @cupid25157). È coerente con la scala ufficiale “effort prima del modello” e con i calcoli del costo per task.
Fable è il tetto massimo, non il concorrente diretto. Nel thread di novembre dedicato a Fable 5.2, Anthropic presenta Fable e Mythos per il lavoro tecnico aperto più ambizioso, mentre indica Opus 5.5 come il daily driver più solido per la maggior parte dei task di coding e knowledge work (@claudeai). Negli abbonamenti la differenza è ancora più netta: per i seat Pro/Team standard Fable viene spesso addebitato ai crediti, quindi l’impulso di scegliere il “modello migliore” può trasformarsi rapidamente in una spesa di crediti.
Come non bruciare la quota nella finestra di 5 ore
È il punto che i benchmark ufficiali non affrontano e che domina le discussioni degli utenti. La critica più concreta non riguarda le capacità del modello, ma la velocità con cui consuma la quota.
"I limiti di Opus 5.5 vengono LETTERALMENTE DISTRUTTI stanotte!! Più persone segnalano quote di 5 ore esaurite in SOLI 15-30 minuti durante sessioni normali. I limiti settimanali si stanno consumando MOLTO più rapidamente" — @TekonBurns, a proposito del consumo nelle sessioni Claude Code
Alcuni utenti descrivono il cambiamento come la fine improvvisa del periodo iniziale: @kgauravnm scrive che “la fase luna di miele di Claude Opus 5.5 è ufficialmente finita”, citando comportamenti pigri e un rapido consumo del limite settimanale. Segnalazioni da seat Team, come quella di @ps_ios_dev, parlano invece di utilizzo a Medium che “corre” anche dopo il reset settimanale gratuito. Va però mantenuta una cautela: un’analisi di 67,000 messaggi di log Claude Code di @sonuv_dev ha rilevato chiamate agli strumenti, tassi di fallimento e tassi di lamentele sostanzialmente stabili — “praticamente nessuna prova di un nerf”. Almeno una parte del problema potrebbe quindi dipendere dall’uso più intenso del default e da un reasoning più costoso, non da un declassamento nascosto. Conta anche scegliere il modello giusto per il limite superiore: @mohitsharmadl riporta un caso in cui Fable 5.2 a Medium ha risolto bug che Opus 5.5 a High non riusciva a chiudere; usare “Opus per tutto” può quindi sprecare quota quando serve un livello superiore diverso.
Un playbook per gestire la quota, basato sia sulle linee guida ufficiali sia su ciò che gli utenti indicano come efficace:
- Impostate Opus 5.5 Medium come default generale; considerate High un passaggio mirato dopo una diagnosi, non un tratto della vostra personalità.
- Dividete il lavoro per sottotask: Haiku per recupero e classificazione, Sonnet per bozze circoscritte e rifinitura, Opus per giudizio, verifica e approvazione finale.
- Non lasciate Sonnet sopra Medium per abitudine: valutate il punto di pareggio e spostate invece il task su Opus Low/Medium.
- Allegate file e collegate repository anziché incollare di continuo lo stesso contesto; reinviare contesti lunghi aggiunge token a ogni turno e aumenta l’utilizzo misurato.
- Conservate il reset del rate limit per una settimana con una scadenza reale, senza sprecarlo in sperimentazione.
- Riservate Fable alla categoria ristretta in cui vince — lavoro tecnico aperto, multi-agente e a lungo orizzonte — e verificate prima se il vostro seat lo addebita ai crediti.
FAQ: le domande che contano nell’uso quotidiano
Claude Opus 5.5 è abbastanza valido da usare ogni giorno?
Sì, per ricerca, analisi e scrittura dove capacità di giudizio e verificabilità sono importanti. Hayz Labs lo classifica al primo posto per agenti e WebDev con punteggi massimi nella scrittura, e le verifiche enterprise citate da Anthropic indicano la stessa direzione. Conviene comunque affiancargli un modello meno costoso per il lavoro ad alto volume.
Opus 5.5 è migliore di Sonnet 5.5 per il lavoro di tutti i giorni?
Sì, nei task ambigui o ad alta conseguenza. Per attività chiare, ben delimitate e ad alto volume, Sonnet a Low o Medium è più veloce — Anthropic valuta Sonnet come Fast e Opus come Moderate (claude.com) — e costa circa la metà per token. L’errore è usare Sonnet a Extra High o Max come impostazione predefinita: così il risparmio svanisce.
Quando usare Opus 5.5 invece di Fable 5.2?
Usate Opus per la maggior parte del lavoro basato sulla conoscenza e per il coding standard. Salite a Fable per progetti tecnici aperti, di lunga durata o fortemente agentici, quando Opus a High continua a bloccarsi; verificate prima la fatturazione del piano, perché i seat Pro/Team standard spesso addebitano Fable ai crediti.
Il contesto da 1 milione di token è affidabile per documenti lunghi?
Per il lavoro di verifica con file allegati è la configurazione Opus più potente mai distribuita da Anthropic, incluso il risultato di 16 report con fonti superati su 18. I task molto lunghi consumano comunque rapidamente la quota dell’abbonamento: meglio lasciare a Haiku il recupero delle informazioni e a Opus il giudizio, invece di affidare tutto al contesto più ampio.
Il compromesso da monitorare
Opus 5.5 è il default giusto per il knowledge work a effort Medium. Resta però da capire se la stretta sulla quota segnalata dagli utenti a fine ottobre rappresenti la nuova normalità: in quel caso, una porzione maggiore della settimana continuerà a girare su Sonnet rispetto a quanto lasciavano intendere i messaggi di lancio.
Approfondimenti correlati: recensione dei prezzi di Claude Opus 5.5, recensione di Claude Opus 5.5 High, Claude Opus 5.5 vs GPT-6.1 Sol.