 AIREITER
Per chi fa girare agenti di coding tutto il giorno, la scelta fra Gemini 4 Hydrogen e Claude Sonnet 5.5 non si risolve guardando solo il listino o una classifica. Con un mix 50/50 fra input e output, Hydrogen costa circa il 25% in meno ($4.50 contro $6.00 per milione di token), ma Sonnet 5.5 continua a chiudere più task da terminale e computer use senza richiedere interventi. Il dato che conta davvero è il costo per task completato.
Sia Gemini 4 Hydrogen sia Claude Sonnet 5.5 propongono una finestra di contesto da 1M token per coding rapido e loop agentici. Hydrogen aggiunge quattro livelli di thinking regolabili.
Cosa cambia passando da Sonnet 5.5 a Hydrogen
Un team che esegue 200 task agentici al giorno noterà la differenza su due fronti: fattura e frequenza degli interventi umani. Hydrogen abbassa il costo per token e, nel campione indipendente sulla velocità di LLM Leaderboard, genera circa 198 token al secondo contro circa 144 di Sonnet 5.5. È il profilo dell'esecutore ad alto volume: bozze veloci, letture parallele dei file, correzioni rapide.
Sonnet 5.5, invece, è più adatto a portare a termine il lavoro con cautela. Nella tabella di lancio di Google, Sonnet 5.5 supera Hydrogen nei tre benchmark più legati al terminale e al computer use: Terminal-Bench 4.1, OSWorld 2.1 e Terminal-Bench-Science. Sono proprio gli scenari in cui un agente deve riprendersi dopo un comando fallito, anziché bloccarsi.
La discussione su Reddit della settimana di lancio riflette la stessa divisione osservata nei task:
"Hydrogen va bene, ma onestamente non mi sembra migliore di Sonnet 5.5." — u/FewKey5274 su r/GeminiAI
Non è un benchmark di coding controllato, quindi va preso come un segnale di prudenza: vincere su task isolati non significa necessariamente rendere meglio in un harness end-to-end. Prima di migrare, provate entrambi sullo stesso workflow.
Il listino parte da $4.50 contro $6.00, ma non finisce lì
I prezzi API ufficiali sono lineari. Secondo l'annuncio di Google, Hydrogen costa $1.50 per milione di token in input e $7.50 per milione in output, senza variazioni lungo tutta la finestra di contesto. Sonnet 5.5 costa $2.00 per milione di input e $10.00 per milione di output, secondo i prezzi di Anthropic e il confronto diretto di OpenRouter.
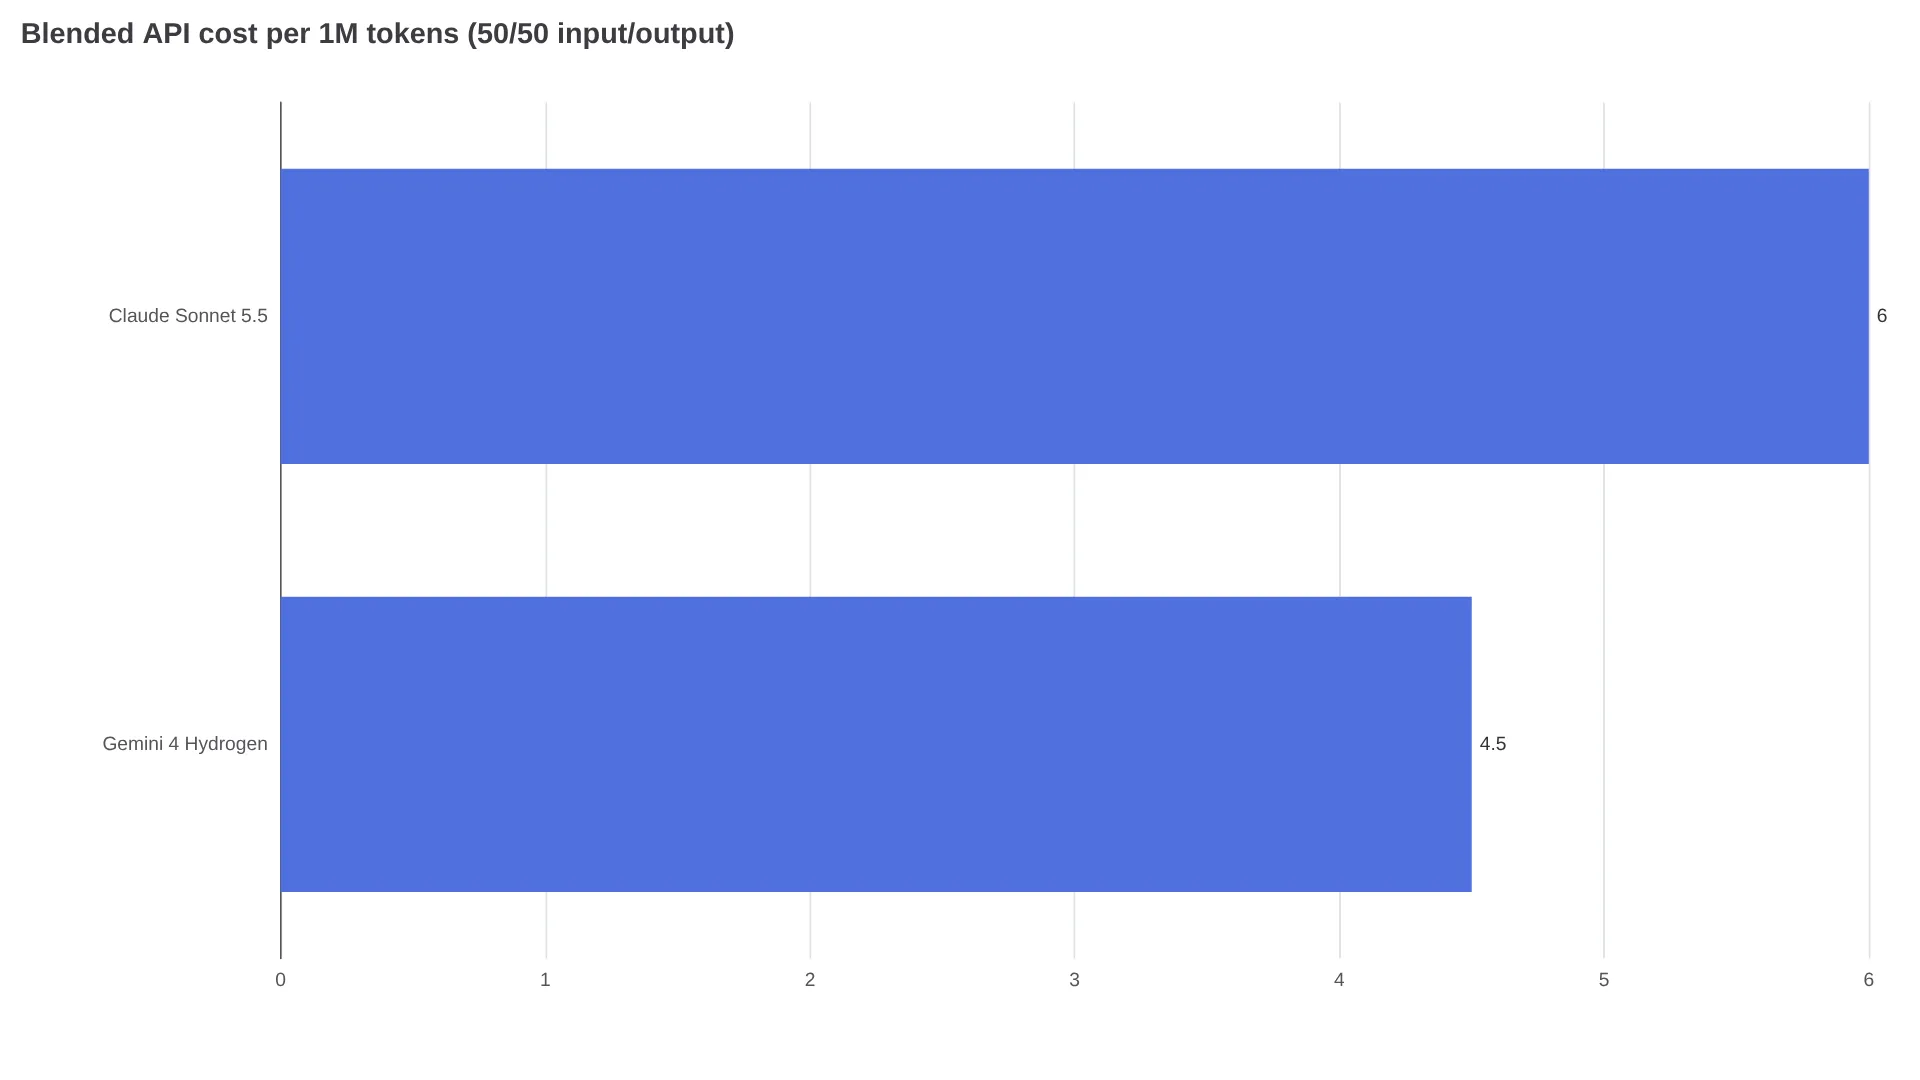
Con un calcolo blended 50/50 — 500K token in input più 500K in output — Hydrogen arriva a $4.50 per milione, contro i $6.00 di Sonnet 5.5. Il divario del 25% è concreto, ma dipende da tre fattori:
- Se l'output pesa di più, il vantaggio cresce. I loop agentici con tracce di ragionamento lunghe spostano il consumo verso l'output, dove lo sconto di Hydrogen è di $2.50 per milione di token.
- Cache e batch non sono inclusi. Le letture dalla prompt cache e gli sconti della Batch API di Anthropic possono modificare il conto reale di alcuni punti percentuali; LLM Leaderboard segnala che nel suo campione di velocità per Hydrogen non era supportato il caching esplicito.
- Un esempio aiuta a mettere i numeri a terra. Un turno agentico con una media di 10K token in input e 3K in output, ripetuto 1.000 volte al giorno, equivale a 10M di input più 3M di output: circa $37.50 al giorno con Hydrogen contro $50.00 con Sonnet 5.5 ai prezzi di listino, ovvero circa $275 al mese di differenza per agente concorrente su 22 giorni lavorativi, prima dei retry.
I retry determinano il vincitore reale. Il costo per task completato corrisponde al costo in token di ogni tentativo diviso per il tasso di successo, più il tempo umano necessario per sistemare il risultato. Solo come esempio, una giornata Hydrogen da $37.50 con un successo al primo passaggio dell'80% costa circa $46.90 per 1.000 task completati considerando i soli token; una giornata Sonnet da $50.00 con il 95% costa circa $52.60. Se i tassi di successo divergono, il vantaggio si riduce rapidamente: meglio monitorare per due settimane il tasso di merge al primo tentativo, invece di fidarsi delle tabelle dei vendor.
I benchmark dividono i ruoli, non incoronano un vincitore assoluto
La tabella di lancio di Google, pubblicata anche nella model card di DeepMind, confronta Hydrogen, Sonnet 5.5 e GPT-6.1 Terra su dieci valutazioni. Hydrogen precede Sonnet 5.5 in sette casi su dieci, mentre Sonnet 5.5 guida nei restanti tre. Le righe vendor usano gli harness di ciascuna parte; le righe indipendenti arrivano dalle riesecuzioni di LLM Leaderboard.
| Famiglia di task | Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| Coding su repository | SWE-sweep (vendor) | 13.5% | 3.1% |
| Coding su repository | Terminal-Bench 4.1, corretto per cheating (vendor) | 57.0% | 63.9% |
| Automazione della conoscenza | Agents' Last Exam v1.1 (vendor, sensibile all'harness) | 71.6% | 60.4% |
| Automazione della conoscenza | AutomationBench-AA (vendor) | 76.1% | 71.8% |
| Automazione della conoscenza | Vending-Bench 2 saldo finale (vendor) | $14,549 | $11,165 |
| Computer use | OSWorld 2.1 subset offline (vendor) | 77.6% | 83.9% |
| Multimodale | MKA Climb WSR (vendor; indipendente 49.52%) | 53.4% | 52.0% |
| Multimodale | Chartography (provenienza mista) | 66.6% | 61.6% |
| Scienza | Terminal-Bench-Science 0.1 (vendor; indipendente 49.52%) | 51.4% | 59.9% |
| Ragionamento | HLE-Diamond (indipendente xhigh) | 58.8% | 53.3% |
Le tool call fanno la differenza negli agenti
I benchmark valutano le risposte; gli agenti vivono di tool call. Devono leggere più file in batch, invocare la funzione corretta e recuperare quando una ricerca non restituisce nulla o un comando fallisce.
Google afferma che Hydrogen esegue in parallelo letture e ricerche sui file, invece di ispezionare i file uno alla volta, e apporta modifiche mirate al repository senza riscrivere file estranei. I report dei partner nel post di lancio citano lavoro su grafi e SQL da 2x a 2.8x più rapido, con il 12%-23% di token in meno rispetto a Gemini 3.8 Flash, oltre a completamenti 2.5x più rapidi con il reasoning high predefinito. Sono numeri di partner selezionati dal vendor: indicano una direzione, non una garanzia.
Il contrappeso è la maturità dell'harness, che emerge nel thread Claude Code vs Antigravity: gli utenti segnalano problemi di uptime di Antigravity e componenti del workflow mancanti, fra cui SSH, hook riutilizzabili, skill e subagent. Sono impressioni degli utenti della settimana di lancio, non una misurazione controllata, e riguardano l'harness più che i pesi del modello.
Prima di spostare un agente di produzione, verificate tre aspetti: affidabilità delle tool call parallele con il vostro numero di server MCP, tasso di recupero dopo un passaggio bash o browser fallito, e comportamento ai confini dei permessi. I controlli interni di Google dichiarano fino all'81% in meno di agentic overreach, il 79% in meno di under-service e il 96.7% di onestà nella propria valutazione sull'agent honesty. Verificatelo con un canary di 50 task fatto di azioni bloccate e ricerche senza uscita.
Livelli di thinking: high come base, xhigh solo quando serve
Hydrogen offre i livelli low, medium, high e xhigh, con high impostato come predefinito. Nella tabella sui livelli di thinking di Google, l'Artificial Analysis Intelligence Index v5.0.1 passa da 27 / 41 / 51 / 54 andando da low a xhigh; il valore high predefinito, 51, supera di poco Argon, a 50. Su Terminal-Bench 4.0, la stessa tabella mostra high al 54.0%, davanti a xhigh al 53.5%; AutomationBench-AA, da 60.5% a 76.1%, e HLE-Diamond, da 32.2% a 58.8%, crescono invece con continuità.
La regola per i loop agentici è semplice: partite da high e passate a xhigh su singoli task solo quando il ragionamento è il collo di bottiglia, ad esempio analisi, sintesi o ricerca su più documenti. Poi controllate la differenza nei token. Secondo la model card di DeepMind, Hydrogen può consumare più token ai livelli di thinking elevati; inoltre il suo knowledge cutoff è marzo 2026, quindi per lavori sensibili all'attualità serve comunque il retrieval.
Prima della migrazione, testate l'harness
Stando alla model card di DeepMind, Hydrogen offre un contesto da 1,048,576 token con fino a 64K token di output sincrono, estendibile a 1M tramite background long decode. Secondo la documentazione di Anthropic, Sonnet 5.5 offre 1M token in input e fino a 128K in output. Sulla carta le finestre sono equivalenti, ma per il lavoro su codebase grandi decide la compattazione: chiedetevi quanto contesto rimane dopo 50 turni, non cosa riporta la scheda tecnica.
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| Limite contesto / output | 1,048,576 token in input; 64K in output sincrono (1M background decode) | 1,000,000 token in input; 128K in output |
| Dove è disponibile | Gemini API, AI Studio, Antigravity, Gemini app, secondo Google | Claude API, Bedrock, Vertex AI, Microsoft Foundry, secondo Anthropic |
Il thread Antigravity vs Claude Code fa emergere un rischio di migrazione più legato alla stabilità dell'harness che alla qualità del modello: gli utenti mettono in dubbio la tenuta della compattazione, la persistenza delle quote e l'uptime. Eseguite lo stesso repository, lo stesso commit, lo stesso prompt e gli stessi test di accettazione in entrambi gli harness; poi confrontate task completati per finestra di abbonamento e tasso di merge al primo passaggio.
La scelta in 60 secondi: tre profili di agente
Non esiste un vincitore unico per ogni agente. Come giudizio editoriale basato sulla divisione nei benchmark riportata sopra, e non come test misurato, conviene assegnare a Hydrogen l'esecuzione parallela e ripetitiva, mentre Sonnet 5.5 è più adatto ai lavori lunghi e sensibili al recupero dagli errori. Le coppie planner-executor dello stesso vendor mantengono coerenti autenticazione e compattazione; mescolare un planner Claude con un worker Hydrogen vale la pena solo dopo aver misurato una baseline monovendor.
| Il tuo agente | Scelta | Perché (livello dell'evidenza) |
|---|---|---|
| Esecutore ad alto volume: correzioni in massa, boilerplate, data wrangling, triage multimodale | Hydrogen a high | Vantaggio nei benchmark vendor su AutomationBench, Agents' Last Exam e Vending-Bench; campione indipendente sulla velocità di circa 198 contro 144 tok/s |
| Agente per completamenti a lungo orizzonte: debug intenso da terminale, automazione OS/browser, tool scientifici | Sonnet 5.5 | Vantaggio nei benchmark vendor su Terminal-Bench 4.1, OSWorld 2.1 e Terminal-Bench-Science; giudizio sull'ecosistema Claude Code per hook e subagent |
| Sintetizzatore per ricerca: documenti lunghi, grafici, audio/video, analisi intensive in Sheets | Hydrogen a high, xhigh per i passaggi più difficili | Vantaggio vendor su HLE-Diamond, Chartography e MKA; con la riserva che la riesecuzione indipendente di MKA si è fermata al 49.52% |
Hydrogen è davvero più veloce di Sonnet 5.5?
Nel campione di LLM Leaderboard, il throughput favorisce Hydrogen, con circa 198 contro 144 token al secondo. Tuttavia, il feed p50 live di OpenRouter mostra Sonnet 5.5 avanti sulla latenza, con una mediana di 2.08s contro 6.92s, perché provider, regione e carico sono diversi. Misurateli entrambi sul vostro provider.
Hydrogen può sostituire Sonnet 5.5 dentro Claude Code?
Non basta cambiare un model ID. Sonnet 5.5 gira nativamente in Claude Code, dove i team si affidano a hook, skill e subagent; Hydrogen funziona tramite Gemini API, AI Studio, Antigravity e Gemini app. Sostituirlo significa migrare anche l'harness.