 AIREITER
Haiku 5.5 costa un ventesimo di Sonnet 5.5, ma solo finché il prompt resta sotto i 100.000 token. Superata quella soglia, il divario scende a 4x e i loop degli agenti ci arrivano più rapidamente di quanto molte aziende si aspettino. Per attività API brevi e ripetibili Haiku 5.5 è sufficiente; nel debugging e nella programmazione a più passaggi, invece, Sonnet 5.5 continua a giustificare il sovrapprezzo.
Il divario di prezzo è di 20x, finché non si supera la soglia dei 100K
Claude Haiku 5.5 e Claude Sonnet 5.5 condividono la stessa capacità dichiarata, ma non lo stesso conto. Entrambi offrono una finestra di contesto da 1M token e un output massimo di 128K token, con gli ID modello claude-haiku-5-5 e claude-sonnet-5-5. Sonnet 5.5 è stato lanciato il 28 settembre 2026 e Haiku 5.5 il 7 ottobre 2026, secondo l'annuncio di Haiku 5.5 di Anthropic e l'annuncio di Sonnet 5.5 di Anthropic. La documentazione della piattaforma Claude per Sonnet 5.5 riporta gli stessi limiti di 1M token di contesto e 128K token di output.
| Specifiche | Claude Haiku 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| ID modello | claude-haiku-5-5 | claude-sonnet-5-5 |
| Uscita | 7 ott. 2026 | 28 set. 2026 |
| Contesto / output massimo | 1M / 128K | 1M / 128K |
| Input / output sotto 100K | $0.10 / $0.50 per 1M | $2 / $10 per 1M |
| Input / output con prompt oltre 100K | $0.50 / $2.50 per 1M | $2 / $10 per 1M (nessuna fascia) |
| Lettura della cache | $0.01 per 1M | $0.10 per 1M |
| Effort predefinito | medium | high |
Si tratta dei prezzi di listino Anthropic. Haiku 5.5 applica la fascia più costosa all'intera richiesta non appena i token del prompt superano 100.000, comprese le letture e le scritture della cache, secondo il riepilogo dei prezzi Anthropic di APIKO.
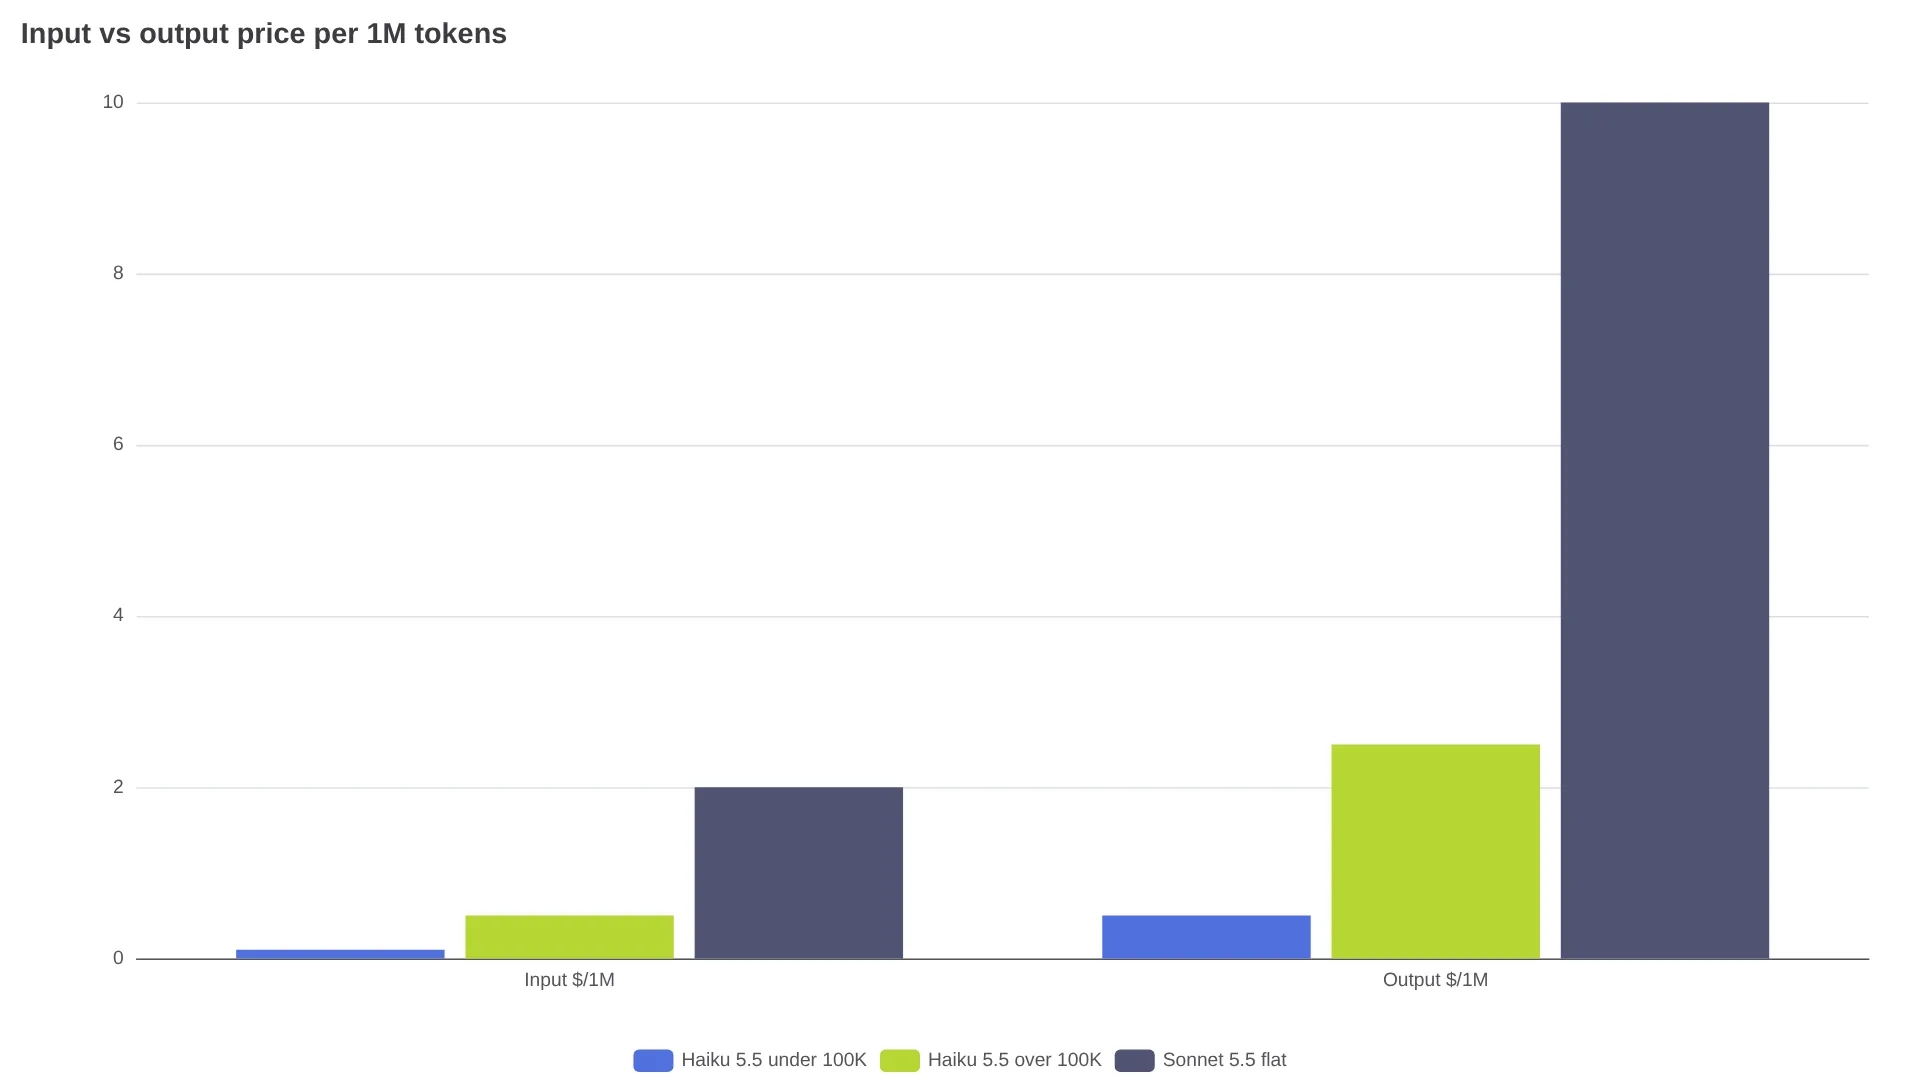
Su 1.000 documenti identici da 99K token con 1K token di output ciascuno, il batch costa circa $10.40 a prezzo di listino (APKO indica $4.54 per lo stesso batch alle proprie tariffe). Con 1.000 documenti da 101K token, invece, si arriva a circa $53.00: cinque volte tanto per appena 2.000 token in più per documento. Sullo stesso batch da 101K, Sonnet 5.5 costa circa $212.00. Il calcolo deriva aritmeticamente dai prezzi di listino riportati nel test di Haiku 5.5 vs Sonnet 5.5 di APIKO. In un batch teorico di 1.000 chiamate con 10K token di input e 1K di output ciascuna, il totale è di $30.00 con Sonnet 5.5 contro $1.50 con Haiku 5.5: una riduzione del 95%, secondo il confronto dei prezzi tra Sonnet 5.5 e Haiku 5.5 di Sim.
I loop degli agenti superano quella soglia quasi senza accorgersene. In una discussione su r/ClaudeAI sull'utilizzo dei token di Haiku 5.5, un utente ha visto le esecuzioni oltrepassare i 100K intorno alla ventesima chiamata al modello; delle 164 chiamate successive, 145 sono state fatturate alla tariffa più alta, perché cronologia e output degli strumenti continuano ad accumularsi. Le soluzioni suggerite nella discussione erano ticket più piccoli, ambiti di file mirati, output dei test ridotto al minimo e subagenti nuovi, invece di una conversazione unica e interminabile. I lavori brevi restano economici con Haiku. Le pipeline che usano contesti lunghi vanno preventivate con Sonnet.
«Il prezzo conveniente di Haiku 5.5 vale solo sotto i 100K di contesto. Oltre 100K di input il prezzo aumenta di 5x; per lavori piccoli come traduzioni e riepiloghi conviene risparmiare, mentre per i contesti lunghi è meglio usare Sonnet.» — @zookmas1314
Per un'analisi più approfondita dei singoli modelli, si possono leggere anche prezzi API di Claude Haiku 5.5 e recensione e prezzi API di Claude Sonnet 5.5.
Cosa distinguono davvero i benchmark di Haiku 5.5 e Sonnet 5.5
I benchmark pubblicati mostrano Sonnet 5.5 in vantaggio in tutti i confronti diretti riportati da Anthropic, con il divario più ampio nei test in cui gli agenti scrivono ed eseguono codice. Nel Terminal-Bench 4.0 per la programmazione agentica, Haiku 5.5 raggiunge il 39,2% contro il 70,6% di Sonnet 5.5. Nel computer use di OSWorld 2.1 il distacco è più contenuto: 72,4% contro 83,9%. In Humanity's Last Exam, senza strumenti, i risultati sono 45,9% contro 56,9%; con gli strumenti, 57,4% contro 64,5%, secondo la tabella dei benchmark raccolta nel confronto di APIKO.
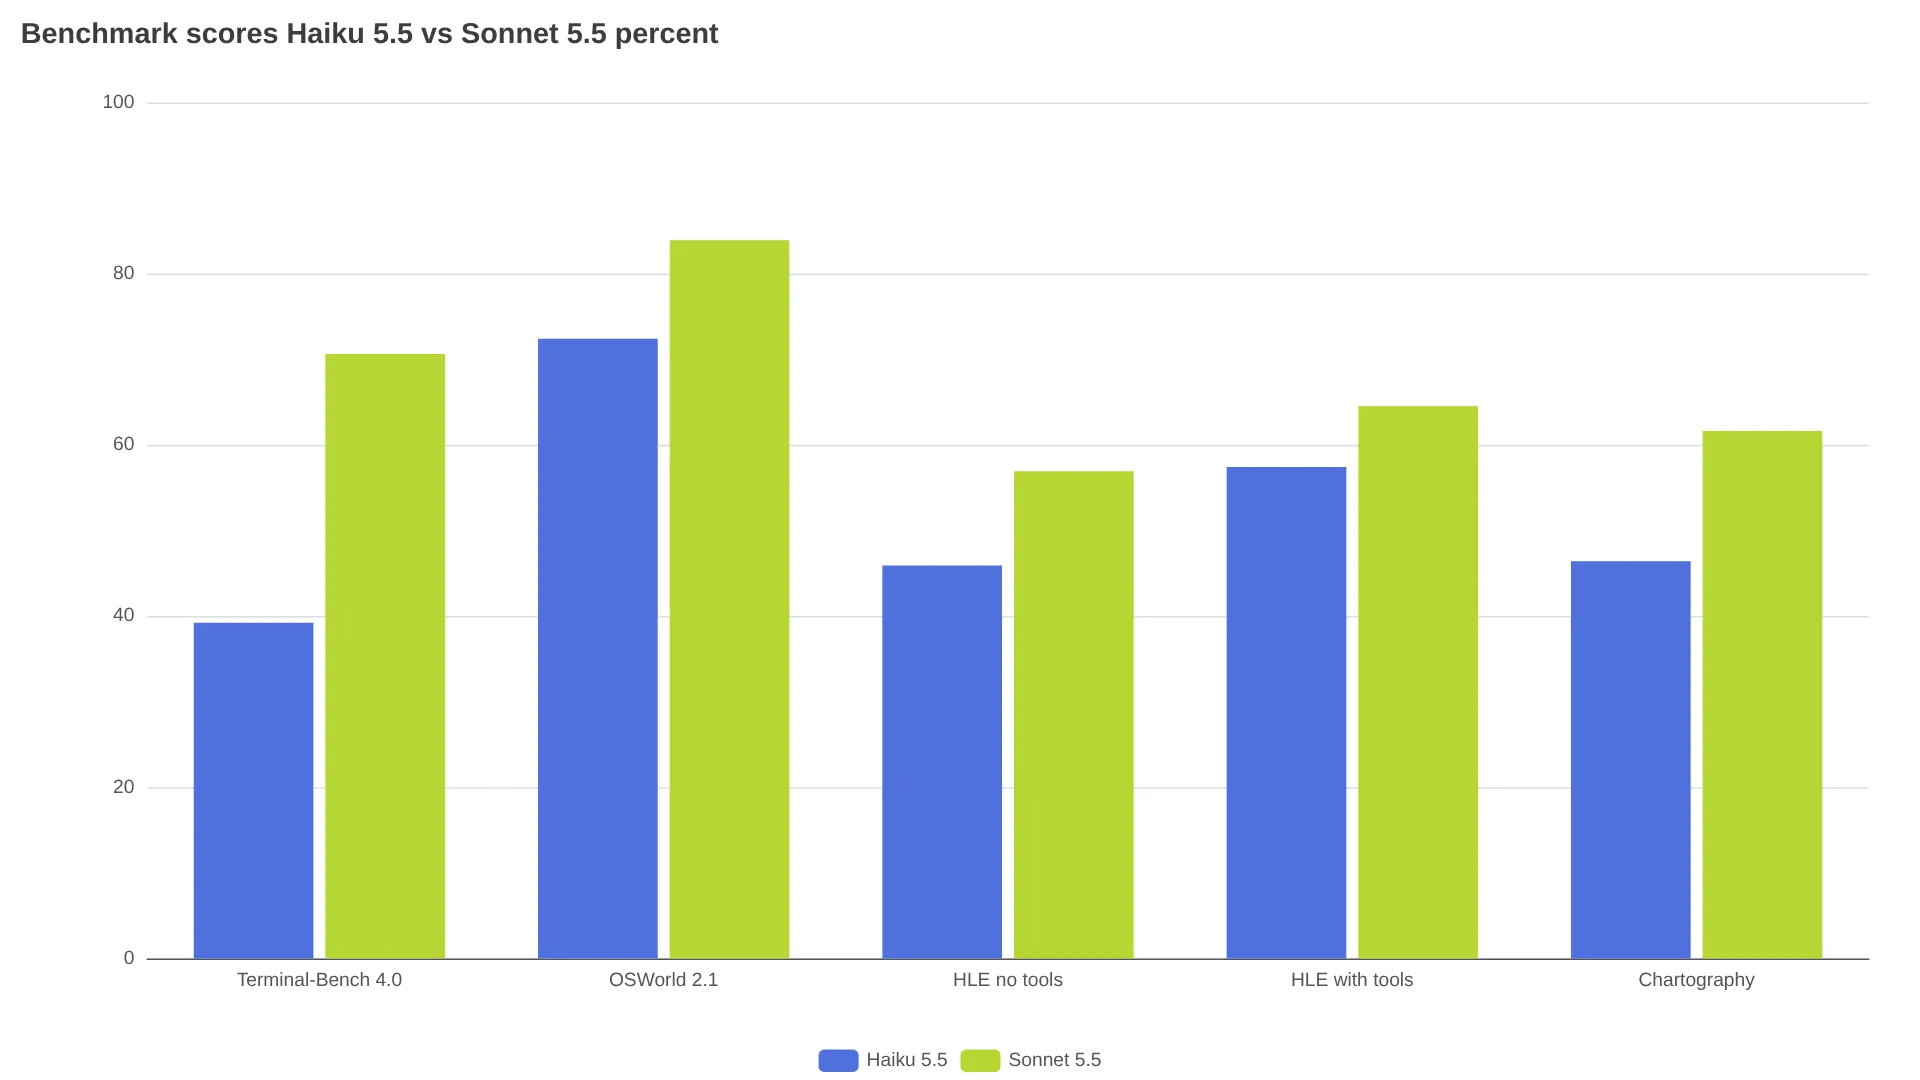
Le impostazioni di effort possono ridurre o ampliare queste differenze. I risultati di Artificial Analysis citati nello stesso confronto assegnano 41 sull'Intelligence Index sia a Haiku xhigh sia a Sonnet medium, con punteggi quasi identici nel Terminal-Bench (29,3% contro 29,8%). Il costo, però, era di $0.12 per attività con Haiku xhigh contro $0.48 con Sonnet medium, mentre i tempi erano rispettivamente di 295 e 122 secondi. In quel dataset nessuna configurazione di Haiku ha raggiunto il punteggio predefinito di Sonnet high, pari a 47. Le cifre sui costi non includono la fascia di Haiku oltre i 100K, quindi vanno considerate una stima minima per i lavori su contesti lunghi.
Per estrazioni e classificazioni circoscritte non serve il vantaggio di Sonnet nella programmazione. Serve invece per il coding guidato da un agente principale, i lunghi loop di strumenti e il ragionamento visivo (46,4% contro 61,6% in Chartography). Un singolo numero Elo o un indice non va preso come classifica universale della qualità. In un test su Reddit, Haiku-medium ha eguagliato Sonnet su una codebase mista Rust e legacy, con un costo di $0.08 contro $1.68; nello stesso flusso di lavoro, Haiku-high ha effettuato 385 richieste senza alcun miglioramento qualitativo, secondo il test controllato di programmazione con Haiku 5.5 su r/ClaudeCode.
L'effort conta più del nome del modello: Haiku low contro Sonnet low
L'impostazione di effort predefinita spiega molte lamentele sul fatto che «Haiku sia prolisso». Haiku 5.5 parte da medium, mentre Sonnet 5.5 usa high; inoltre la configurazione del thinking varia da un modello all'altro. Haiku disattiva il thinking con {"type": "disabled"}, mentre Sonnet usa {"type": "between_tools"} con effort high e inferiori, e adaptive oppure thinking omesso a xhigh/max, come spiegato nella documentazione della piattaforma Claude e nelle note sul comportamento di APIKO.
Nella valutazione APIKO del 10 ottobre 2026, composta da 22 attività e 528 richieste all'endpoint Messages, Haiku a low ha superato 65 test su 66. Sonnet si è fermato tra 64 e 66 su 66, a seconda della configurazione, con un costo sul gateway di circa un diciottesimo per queste attività brevi. Disattivando completamente il thinking, Haiku è sceso a 56 test su 66, soprattutto per errori di ragionamento e di formato rigido, come una somma CSV e un tracciamento del codice. Con l'impostazione predefinita medium, Haiku ha superato 66 test su 66, ma ha generato 4,4 volte più token di output rispetto a low, in gran parte token di thinking.
Da questi dati e dai report degli utenti emergono alcune regole pratiche:
- Partire da Haiku low: per attività delimitate come classificazione, routing, estrazione e JSON brevi, meglio usare Haiku
lowinvece dell'impostazione predefinitamedium. - Spingere Haiku prima di cambiare modello: provare Haiku
highoxhighprima di Sonnetlowquando l'obiettivo è ottenere una qualità migliore restando sui costi di Haiku. Le cifre di Artificial Analysis citate nel confronto di APIKO mostrano Haikumaxa 43 contro Sonnetlowa 36, con un costo di circa il 60%. - Riservare Sonnet ai passaggi delicati: usare Sonnet
mediumo superiore per debugging, implementazioni a più passaggi e lunghe sequenze di strumenti, quando la latenza aggiuntiva di Haiku-high non porta ulteriore qualità. - Configurare il thinking per modello: nel codice condiviso va impostato esplicitamente per ciascun modello. Un template unico che invii
between_toolsa Haiku odisableda Sonnet restituisce un 400 upstream, secondo il test del gateway di APIKO.
«Opus/Sonnet come orchestratore principale e revisore, Haiku come esecutore operativo, con una nuova istanza di Haiku per ogni funzionalità.» — u/ohrajaaa su r/ClaudeAI
Scegli il modello in base alle conseguenze di un errore silenzioso, non alla difficoltà
La domanda utile per il routing non è «questo compito è difficile?», ma «cosa succede se Haiku sbaglia in modo plausibile e nessun revisore se ne accorge?». Diversi test citati dagli utenti descrivono la stessa divisione: Haiku può fallire senza dare segnali evidenti nei compiti di giudizio, mentre Sonnet si ripaga quando verificare il risultato è costoso.
| Se l'attività è | Modello principale |
|---|---|
| Classificazione del sentiment, instradamento dei ticket, conversione da permesso a JSON, riepiloghi di log, OCR e annotazione, selezione SQL, subagenti di compattazione | Haiku 5.5 |
| Ricerca nella codebase, modifiche a un singolo file, elaborazione di documenti in un solo turno | Haiku 5.5 |
| Agente principale di coding, debugging reale, refactoring a più passaggi, fact-checking, attribuzione delle fonti nei documenti | Sonnet 5.5 |
Gli utenti riferiscono una velocità 3x e una forte riduzione dei consumi nei flussi Haiku ad alto volume e a turno singolo. In un caso, sono stati elaborati diversi megabyte di documenti con un costo di pochi dollari, secondo la discussione su r/ClaudeAI «Per cosa è più indicato Haiku 5.5?».
Un confronto tra subagenti su sei attività ha trovato Haiku economico, ma sensibilmente meno affidabile nella ricerca e nelle valutazioni fattuali, con file saltati senza che il risultato finale lo rendesse evidente, secondo il test sui subagenti Haiku vs Sonnet vs Opus di r/ClaudeCode. La regola di sicurezza emersa da quella discussione è netta:
«Se l'output attiva un'azione … va passato a un modello più grande oppure verificato da un modello più grande.» — u/vladgladi su r/ClaudeCode
Resta una cautela importante per la produzione: su Haiku la conformità a un output strutturato non è automatica. La valutazione di APIKO ha registrato un errore di formato rigido a low (etichette corrette racchiuse in un oggetto JSON invece che restituite come array semplice), mentre gli utenti di r/ClaudeCode segnalano verifiche saltate e vincoli ignorati con effort basso, secondo lo stesso test controllato di programmazione.
Una configurazione Haiku-first che regge in produzione
Il codice di configurazione deve gestire thinking, scelta degli strumenti e cronologia in modo specifico per il modello, come mostra il test del gateway di APIKO del 10 ottobre sui pattern documentati. Haiku accetta un tool_choice forzato, mentre Sonnet lo rifiuta upstream (con Sonnet vanno usati auto o gli output strutturati). Inoltre Haiku non può leggere i blocchi di thinking di Sonnet, mentre Sonnet può leggere quelli di Haiku se la cronologia resta append-only; riprodurre blocchi di Sonnet modificati può restituire un 400.
Un pattern Haiku-first su cui utenti diversi stanno convergendo in modo indipendente:
- Chiamare Haiku 5.5 con effort
lowper la prima passata (classificazione, estrazione, bozza); per disattivare del tutto il thinking usarethinking: {"type": "disabled"}. - Accettare solo etichette presenti in una allowlist o JSON valido rispetto allo schema; inviare a Sonnet 5.5 con effort
mediumtutto ciò che è incerto, non valido o potenzialmente decisivo. - Mantenere i subagenti freschi e usa-e-getta: una singola istanza di Haiku per file o funzionalità, invece di lasciare che una conversazione superi i 100K.
- Usare Sonnet o Opus come revisore ogni volta che l'output attiva un'azione, invia un messaggio o modifica codice in produzione.
«Haiku è molto valido se sai cosa chiedergli e come controllarne la qualità.» — u/Awric su r/ClaudeCode
Anthropic presenta Haiku 5.5 come subagente per attività ad alto volume, come i riepiloghi, da affiancare a Sonnet o Opus, secondo @ClaudeDevs. In una configurazione condivisa, Haiku viene usato in sciami per cercare nella repository, mentre Sonnet gestisce diff e test, secondo @mirku21.
FAQ su Haiku 5.5 e Sonnet 5.5
Quanto costa in meno Haiku 5.5 rispetto a Sonnet 5.5?
A prezzo di listino, 20x in meno sotto i 100K token di prompt ($0.10/$0.50 contro $2/$10 per 1M) e 4x in meno oltre i 100K ($0.50/$2.50 contro $2/$10). Le letture della cache costano $0.01 contro $0.10 per 1M.
Haiku 5.5 e Sonnet 5.5 hanno la stessa finestra di contesto?
Sì. Entrambi indicano una finestra di contesto da 1M token e un output massimo di 128K, secondo Anthropic e la documentazione della piattaforma.
Haiku 5.5 è abbastanza affidabile per l'uso in produzione via API?
Per attività circoscritte, ad alto volume e facilmente verificabili, sì, di norma con effort low e validazione dello schema. Per il coding guidato da un agente principale e la ricerca che richiede valutazioni, gli utenti riportano più errori e falsi positivi rispetto a Sonnet 5.5.
Quale modello è migliore per gli agenti di coding?
Sonnet 5.5 per l'agente principale e il debugging (70,6% contro 39,2% nel Terminal-Bench). Haiku 5.5 è più adatto a ricerca, digitazione e lavoro su singoli file affidato a un subagente, con Sonnet o Opus come revisore.
Come posso restare sotto la soglia dei 100K che fa aumentare il prezzo di Haiku?
Dividere i documenti prima di raggiungere la soglia, limitare i subagenti ai file interessati, ridurre l'output verboso dei test e avviare subagenti nuovi per ogni attività. La cronologia degli agenti supera i 100K in circa 20 chiamate.
Posso spostare una conversazione da Sonnet 5.5 a Haiku 5.5 a metà?
Non in modo pulito. Haiku non può leggere i blocchi di thinking di Sonnet: bisogna restare su Sonnet oppure ricominciare con Haiku. Spostare la cronologia di Haiku su Sonnet conserva il ragionamento se la cronologia è append-only.
L'unico compromesso che non puoi aggirare con il routing
| Se il carico di lavoro comprende | Scegli | Perché |
|---|---|---|
| Centinaia di classificazioni, estrazioni, riepiloghi e normalizzazioni JSON | Haiku 5.5 con low | Percentuali di successo vicine a Sonnet sulle attività brevi, a circa 1/18 del costo quando l'output viene validato |
| Una codebase di grandi dimensioni, lunghi loop di strumenti, debugging che deve essere corretto | Sonnet 5.5 | Vantaggio di 31 punti nel Terminal-Bench e meno errori silenziosi |
| Documenti che si avvicinano o superano i 100K | Confronta i prezzi | La fascia 5x di Haiku annulla gran parte del vantaggio; oltre la soglia Sonnet costa solo 4x in più |
| Qualsiasi attività in cui un errore silenzioso finisce in produzione | Bozza con Haiku più revisione con Sonnet | Il costo per risultato verificato è più importante del prezzo nominale dei token |
Haiku 5.5 vince sul prezzo per tentativo. Sonnet può risultare più economico quando revisione e riesecuzioni dominano il costo dei token. Il router va progettato su questa distinzione: così nessuno dei due modelli diventa una scommessa.