 AIREITER
Muse Spark 1.3 est actuellement proposé à 1,25 $ par million de tokens en entrée et 4,25 $ par million de tokens en sortie sur OpenRouter. Mais le prix ne suffit pas à trancher. Le modèle semble particulièrement intéressant pour le codage avec long contexte et les agents capables d’enchaîner les tâches. En revanche, son déploiement est encore récent, le mode de raisonnement maximal n’était pas disponible au lancement et l’attente avant le premier token peut être importante.
Muse Spark 1.3 : de quoi parle-t-on exactement ?
Muse Spark 1.3 est le modèle de raisonnement propriétaire de Meta, conçu pour les tâches d’agents longues, le codage et les usages multimodaux. Meta l’a annoncé le 2 septembre 2026, en précisant son déploiement progressif dans Muse Code et la Meta Model API. Les modes de raisonnement existants étaient disponibles en premier, tandis que le mode de raisonnement maximal devait encore passer des tests de sécurité supplémentaires. (annonce de Meta AI Research)
Le visuel de lancement affiche des résultats en mode maximal, alors que ce mode nécessitait encore des tests de sécurité. Il ne faut donc pas supposer que ces scores seront reproductibles dès le premier jour.
Selon Meta, Muse Spark 1.3 conserve mieux les contraintes sur les tâches longues, gère les interruptions au sein d’un même fil, pose davantage de questions de clarification, demande confirmation avant les actions lourdes de conséquences et reconnaît plus facilement lorsqu’il est bloqué. Meta revendique aussi environ 20 % d’appels d’outils en moins et 25 % de tokens en moins que Muse Spark 1.2 dans ses comparaisons internes de codage. Ces chiffres viennent toutefois du fournisseur et ne s’appuient ni sur un jeu de tâches reproductible ni sur des marges d’erreur.
L’article de lancement présente les poids ouverts comme un élément de la feuille de route future. Les sources consultées ici décrivent Muse Spark 1.3 comme un modèle hébergé, accessible uniquement via API. Elles ne documentent ni checkpoint téléchargeable, ni licence confirmée, ni nombre de paramètres, ni configuration matérielle requise.
Un tarif API lisible, mais un coût réel plus difficile à prévoir
La grille tarifaire publique la plus claire se trouve sur la page OpenRouter de Muse Spark 1.3, et non dans l’article de lancement de Meta. OpenRouter affiche des tarifs standards de 1,25 $ en entrée et 4,25 $ en sortie par million de tokens, auxquels s’ajoutent des frais distincts pour la lecture du cache et les recherches web.
| Usage | Tarif affiché | Point à surveiller |
|---|---|---|
| Entrée | 1,25 $ / 1 M de tokens | Tokens de prompt et de contexte non mis en cache |
| Sortie | 4,25 $ / 1 M de tokens | Environ 3,4 fois le tarif d’entrée |
| Lecture du cache | 0,15 $ / 1 M de tokens | Intéressant pour les contextes d’agents répétés |
| Recherche web | 2,50 $ / 1 000 appels | Facturée séparément des tokens |
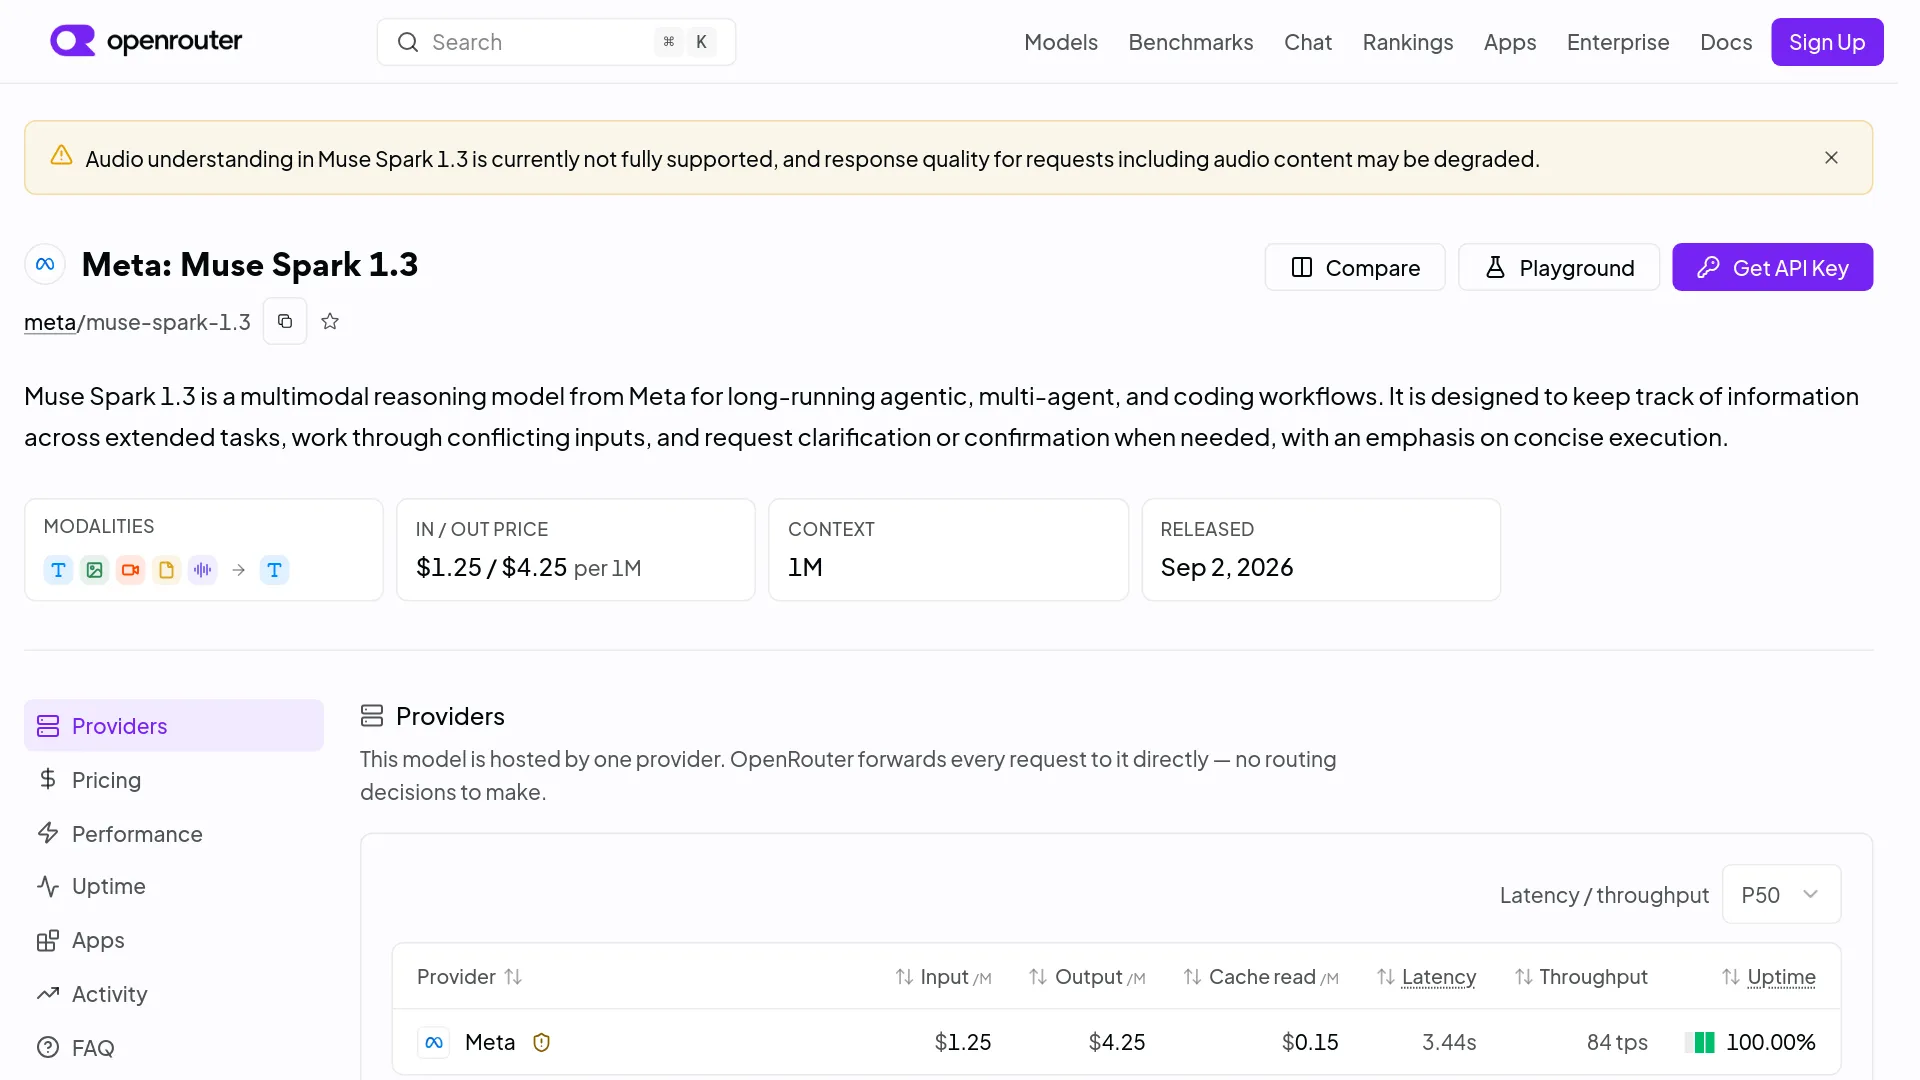
Une requête contenant 100 000 tokens d’entrée non mis en cache et 20 000 tokens de sortie coûte environ 0,21 $, hors cache et recherches web : 0,125 $ pour l’entrée et 0,085 $ pour la sortie. Les boucles d’agents, les nouvelles tentatives et la répétition du contexte font rapidement grimper la facture d’une tâche complète.
Artificial Analysis indique un tarif moyen de 0,78 $ par million de tokens, calculé avec une répartition de 7:2:1 entre tokens lus depuis le cache, tokens d’entrée et tokens de sortie. Les workflows utilisant un contexte entièrement nouveau ou générant beaucoup de texte coûteront davantage. Prenez donc ce chiffre comme une estimation de scénario, pas comme un tarif universel.
Ne transposez pas automatiquement à Muse Spark 1.3 les hypothèses concernant le programme Contributor du guide des tarifs de l’API Muse Spark 1.2. La fiche publique de la version 1.3 confirme le tarif standard indiqué plus haut, mais les sources consultées ici ne permettent pas d’établir un contrat Contributor complet pour la version 1.3, notamment sur l’utilisation des données, les limites de débit ou la disponibilité régionale. Tant que votre fournisseur ne confirme pas le contraire, établissez votre budget sur le tarif standard.
Un modèle de codage solide, pas un champion toutes catégories
Les données disponibles présentent Muse Spark 1.3 comme un modèle performant pour le codage et les longs contextes, pas comme le leader universel. Le tableau ci-dessous reprend les scores de la méthodologie d’évaluation liée par Meta. Les échelles varient selon les benchmarks : un score plus élevé n’est comparable qu’aux autres valeurs de sa propre ligne.
| Évaluation | Muse 1.3 max | Muse 1.3 xhigh | Muse 1.2 xhigh | GPT-5.6 Sol | Claude Opus 5 | Meilleur score affiché |
|---|---|---|---|---|---|---|
| MRCR 512K–1M | 98.1 | 93.1 | 55.5 | 73.8 | — | Muse 1.3 max |
| DeepSWE v1.1 | 75.4 | — | 55.0 | 73.0 | 74.0 | Muse 1.3 max |
| SWE-Atlas Codebase QnA | 59.4 | 54.0 | 46.2 | 53.5 | 52.7 | Muse 1.3 max |
| Terminal-Bench 2.1 | 88.8 | 89.2 | 82.9 | 88.8 | 86.7 | Muse 1.3 xhigh |
| OSWorld 2.0 | 66.9 | 57.2 | 47.6 | 62.7 | 68.3 | Claude Opus 5 |
| DeepSearchQA | 89.4 | 89.4 | 85.9 | 93.0 | 90.4 | GPT-5.6 Sol |
| GDPVal-AA v2 | 1754 | 1709 | 1615 | 1710 | 1824 | Claude Opus 5 |
L’argument le plus convaincant en faveur de Muse Spark 1.3 concerne le codage avec long contexte : son meilleur résultat atteint 98.1 sur MRCR avec un contexte de 512K–1M et 75.4 sur DeepSWE, contre 55.5 et 55.0 pour Muse Spark 1.2 xhigh. Le même tableau fait toutefois apparaître de meilleures alternatives sur certaines évaluations liées au travail professionnel, à l’utilisation d’ordinateurs et à la navigation web.
La méthodologie de Meta précise que les cellules peuvent provenir d’une évaluation interne, d’un classement officiel ou d’un résultat déclaré par un fournisseur. Les tests de codage utilisaient des outils limités et aucun accès à Internet externe. Ils constituent donc des indicateurs utiles, mais pas une comparaison indépendante entièrement rejouée.
Artificial Analysis attribue à Muse Spark 1.3 un score de 61 à l’Intelligence Index, avec un classement de #10 sur 196 modèles comparables, contre une médiane de 36 pour ces modèles. ModelCap affiche un ModelCap Index de 81.7 et une quatrième place, mais n’accorde que 20 % de confiance à son évaluation, fondée sur une seule observation publique de benchmark. Ces deux systèmes convergent vers une même prudence : la base de données reste encore mince.
Pour un workflow réel, commencez par tester Muse Spark 1.3 sur l’exploration de dépôts, les agents de terminal opérant sur de longues séquences et les questions-réponses sur une base de code. N’étendez pas automatiquement ces résultats aux tâches dominées par la navigation web ou à tous les usages professionnels de l’ordinateur.
Le paradoxe de la vitesse : rapide après le démarrage, lent avant
Muse Spark 1.3 semble rapide une fois la génération lancée, mais le premier fragment de réponse peut se faire attendre. Le modèle convient donc mieux aux traitements soutenus ou par lots qu’au pair programming interactif, où chaque tour doit démarrer immédiatement.
Artificial Analysis mesure 181,7 tokens générés par seconde, contre une médiane de 68,1 pour les modèles comparables. Le service mesure également 27,51 secondes avant le premier token, contre une médiane de 3,04 secondes, et estime à 41,26 secondes le temps nécessaire pour produire une réponse de 500 tokens dans ses conditions de test. Sa page consacrée aux fournisseurs affiche par ailleurs 38,51 secondes avant le premier token de réponse et un coût de 0,55 $ par tâche de l’Intelligence Index.
OpenRouter affiche des chiffres P50 différents : 62 tokens par seconde et 1,83 seconde de latence. Ces métriques ne sont pas directement interchangeables, car les pages s’appuient sur des charges et des définitions différentes. Artificial Analysis inclut notamment le temps de raisonnement dans sa mesure du délai avant la première réponse. Dans votre propre environnement de test, mesurez à la fois le délai avant le premier token et la durée totale de la tâche.
« Puisque quelques personnes demandent, mon premier avis (je l’utilise actuellement) : il semble mécanique (excellent pour le travail, je ne sais pas pour la stratégie) et très capable. Il paraît très rapide. » — u/NewYak4281, r/singularity
Ce premier retour, recueilli sans protocole contrôlé, correspond au compromis mesuré : une génération rapide après une attente potentiellement longue, avec un style d’interaction qui peut sembler mécanique. C’est un élément de contexte utile, pas un remplacement à un test maîtrisé.
Fonctions de l’API et limites à vérifier avant la mise en production
Muse Spark 1.3 propose les fonctions d’intégration attendues d’un modèle d’agents moderne, mais plusieurs détails de production restent dépendants du fournisseur ou ne sont pas communiqués. Les éléments les plus solides proviennent actuellement de la fiche active du modèle sur OpenRouter et du suivi des fournisseurs par Artificial Analysis, plutôt que d’une spécification publique complète de Meta dans son article de lancement.
| Fonction ou limite | Éléments actuellement disponibles | Conséquence en production |
|---|---|---|
| Fenêtre de contexte | OpenRouter et ModelCap indiquent 1 048 576 tokens | Confirmer la limite effective du endpoint |
| Sortie maximale | ModelCap indique 944K tokens | Les limites de sortie du fournisseur peuvent être inférieures |
| Entrées | Texte, image, vidéo et fichiers ; l’audio est indiqué avec un avertissement | Considérer la compréhension audio comme incomplète |
| Sortie | Texte | Prévoir un workflow reposant sur le texte |
| Appel d’outils | Fonction indiquée comme prise en charge | Tester les schémas et la gestion des erreurs d’outils dans votre SDK |
| Sortie structurée | Format de réponse avec schéma JSON indiqué | Tester les échecs liés aux schémas stricts |
| Couverture des fournisseurs | Un seul fournisseur Meta apparaît sur la page OpenRouter et dans le suivi d’Artificial Analysis | Ne pas supposer l’existence d’un mécanisme de bascule redondant |
| Poids du modèle | Accès uniquement via API ; aucun poids téléchargeable indiqué | Aucune solution d’auto-hébergement n’est établie |
ModelCap avertit qu’un fournisseur donné peut exposer une limite de contexte ou de sortie inférieure au maximum publié. Le panneau de disponibilité d’OpenRouter affiche un taux de disponibilité de 99,97 % sur trois jours, mais des chiffres inférieurs dans ses vues à 72 heures et 24 heures. Ces valeurs correspondent à des métriques différentes de la page. Pour acheminer du trafic de production, appuyez-vous donc sur les données de statut les plus récentes et sur vos propres journaux d’erreurs.
Dans son article de lancement, Meta ne publie ni le nombre de paramètres, ni l’architecture, ni les limites formelles de débit de l’API, ni les conditions de licence, ni le détail des tests de sécurité. L’entreprise affirme toutefois une meilleure résistance aux injections de prompt et un meilleur discernement face aux actions irréversibles, sans fournir de taux de réussite contre les attaques ni de protocole de red team reproductible.
Faut-il utiliser Muse Spark 1.3 dès maintenant ?
Muse Spark 1.3 mérite un test dès maintenant pour le codage avec long contexte et les agents utilisant de nombreux outils, lorsque le faible coût par token et la génération soutenue comptent davantage qu’une réponse instantanée. En revanche, il n’est pas encore adapté comme unique modèle de production pour les systèmes sensibles à la latence, fortement dépendants de l’audio, traitant des données confidentielles ou exigeant une redondance critique.
| Votre situation | Décision |
|---|---|
| Gros dépôt, questions-réponses sur le code, longue tâche dans le terminal | Tester Muse Spark 1.3 en premier |
| Tâches d’agents par lots où la vitesse de sortie compte | Bon candidat ; mesurer le coût total de la tâche |
| Pair programming interactif | À utiliser uniquement si le délai avant le premier token est acceptable |
| Workflow centré sur l’audio | Attendre ou choisir une solution dont la prise en charge audio est confirmée |
| Code client sensible ou données réglementées | Vérifier d’abord le contrat concernant les données |
| Service critique nécessitant une solution de secours | Conserver un second modèle et une route de bascule |
Un déploiement progressif et peu risqué sera plus instructif qu’une nouvelle capture d’écran de classement :
- Commencez avec un dépôt non sensible et cinq à dix tâches fixes.
- Limitez les outils shell, d’écriture de fichiers, réseau et destructifs au strict minimum.
- Enregistrez le taux de réussite, le nombre d’appels d’outils, la latence avant le premier token, la durée, le nombre de tokens et le coût facturé.
- Comparez les mêmes tâches à votre référence actuelle et gardez un modèle de secours en cas de délai d’expiration ou de modifications peu fiables.
Placez Muse Spark 1.3 derrière un indicateur d’expérimentation pour vos agents de codage, puis prenez votre décision à partir du test sur dépôt plutôt que du classement du jour du lancement. Le prix et les résultats sur les longs contextes justifient l’essai ; la lenteur initiale, le nombre limité de fournisseurs, la prise en charge audio incomplète et les benchmarks encore provisoires plaident contre un déploiement exclusif.
FAQ sur l’API et les tarifs de Muse Spark 1.3
Muse Spark 1.3 est-il officiellement sorti ?
Oui. L’annonce de Meta du 2 septembre 2026 indique que Muse Spark 1.3 était en cours de déploiement dans Muse Code et la Meta Model API. Le mode de raisonnement maximal devait encore faire l’objet de tests de sécurité supplémentaires.
Où puis-je accéder à Muse Spark 1.3 ?
Meta cite Muse Code et la Meta Model API. OpenRouter référence également meta/muse-spark-1.3 ; l’accès peut varier selon le fournisseur, le compte et la région.
Combien coûte Muse Spark 1.3 ?
La fiche OpenRouter affiche 1,25 $ par million de tokens en entrée, 4,25 $ par million de tokens en sortie, 0,15 $ par million de tokens lus depuis le cache et 2,50 $ par 1 000 appels de recherche web. Considérez ces montants comme les tarifs OpenRouter cités ici, sauf si votre fournisseur direct confirme sa propre grille.
Muse Spark 1.3 dispose-t-il d’une fenêtre de contexte d’un million de tokens ?
OpenRouter et ModelCap indiquent 1 048 576 tokens, tandis qu’Artificial Analysis arrondit ce chiffre à 1 million. Confirmez les limites effectives de contexte et de sortie sur le endpoint que vous utilisez.
Prend-il en charge la vision, la vidéo, les outils et les sorties JSON ?
OpenRouter indique la prise en charge des entrées texte, image, vidéo et fichier, ainsi que des appels d’outils et des sorties structurées avec schéma JSON. L’audio est également listé, mais avec un avertissement précisant que sa compréhension n’est pas entièrement prise en charge.
Muse Spark 1.3 est-il open source ou auto-hébergeable ?
Aucun poids téléchargeable ni package d’auto-hébergement n’a été établi dans les sources consultées. Meta présente les poids ouverts comme un travail futur de sa feuille de route, et non comme un artefact Muse Spark 1.3 actuellement disponible.
Le mode de raisonnement maximal est-il disponible ?
Meta a indiqué que les modes de raisonnement existants seraient disponibles en premier et que le mode maximal suivrait des tests de sécurité supplémentaires. L’annonce ne fournit aucune date ferme.
Peut-on supposer que les tarifs Contributor de Muse Spark 1.2 s’appliquent à la version 1.3 ?
Non. Les conditions Contributor de la version 1.2 sont documentées séparément, mais les sources consultées ici ne permettent pas d’établir un contrat Contributor complet pour la version 1.3. Tant que votre fournisseur ne confirme pas un autre niveau de service, une autre politique de données et une autre limite de débit, basez votre budget sur le tarif standard de la version 1.3.
Avant de passer en production, lancez un petit benchmark sur un dépôt non sensible : comparez les mêmes tâches avec votre modèle actuel en mesurant le délai avant le premier token, les modifications terminées, les appels d’outils et le coût. Vous répondrez ainsi à la question du déploiement de manière plus fiable qu’avec les classements du jour du lancement.