 AIREITER
Avec Muse Spark 1.2, Meta applique une grille à deux vitesses : l’écart sur le prix des tokens d’entrée atteint 12.5×. L’offre Standard facture $1.25 par million de tokens en entrée et $4.25 en sortie. Contributor ramène ces tarifs à $0.10 et $0.20, en contrepartie de quoi Meta peut entraîner ses modèles à partir de vos prompts et de leurs réponses. Attention toutefois : cette formule économique est aussi plafonnée à 60 requêtes par minute et à environ 250K tokens par jour. Les économies réelles dépendent donc autant de votre volume de travail que du tarif unitaire.
Standard et Contributor : le même modèle, deux formules
Muse Spark 1.2 (identifiant de modèle : muse-spark-1.2) est un modèle de code orienté raisonnement de Meta, doté d’une fenêtre de contexte de 1,048,576 tokens, selon la documentation développeur de Meta. Les deux offres donnent accès au même modèle ; ce qui change, ce sont le prix, le traitement des données et le débit disponible.
| Critère | Standard | Contributor |
|---|---|---|
| Identifiant du modèle | muse-spark-1.2 | muse-spark-1.2-contributor |
| Entrée (par 1M tokens) | $1.25 | $0.10 |
| Entrée mise en cache (par 1M tokens) | $0.15 | $0.002 |
| Sortie (par 1M tokens) | $4.25 | $0.20 |
| Fenêtre de contexte | 1,048,576 tokens | 1,048,576 tokens |
| Surcoût pour contexte long | Aucun | Aucun |
| Confidentialité des données | Meta ne peut pas entraîner ses modèles sur vos données | Meta peut utiliser les prompts/sorties pour l’entraînement |
Aucun surcoût n’est appliqué aux contextes longs, quelle que soit l’offre, d’après la documentation de Meta.
En Standard, les tokens d’entrée issus du cache sont facturés $0.15/M, soit 8.3× moins qu’une nouvelle entrée. En Contributor, ils tombent à $0.002/M : un avantage considérable lorsque le contexte du dépôt de code est réutilisé.
« Muse Spark 1.2 est génial... son prix est absurde. »
— Utilisateur sur r/opencode
Les limites de débit plafonnent aussi la dépense
Le prix par token ne raconte qu’une partie de l’histoire. L’autre, c’est le débit — et la différence entre les deux offres est marquée :
| Limite | Standard | Contributor |
|---|---|---|
| Requêtes par minute | 3,000 | 60 |
| Tokens par minute | 4,000,000 | Bien moins (plafond quotidien) |
| Plafond quotidien de tokens | Illimité | ~250,000 tokens/jour |
| Application des limites | Par équipe | Par équipe |
Les limites sont appliquées par équipe, et non par clé API. Ajouter des clés ne permet donc pas d’augmenter le débit, comme l’indique la documentation de Meta sur les tarifs et limites de débit.
Ce que représentent 250K tokens par jour en programmation
Le plafond Contributor d’environ 250,000 tokens devient plus parlant avec le scénario de session utilisé ci-dessous : chaque tour envoie 8,000 tokens d’entrée et génère 2,000 tokens de sortie, soit 10,000 tokens. À ce rythme, 250,000 tokens couvrent environ 25 tours avant d’atteindre la limite quotidienne — de quoi faire une session de code ciblée, mais pas une journée entière de développement itératif.
Le coût d’une session de code réaliste
Prenons un cas représentatif : un agent charge 8,000 tokens de contexte — dépôt de code et prompt système —, produit 2,000 tokens de sortie — modifications de code et raisonnement —, puis répète ce schéma 20 fois au cours d’une session.
| Offre | Coût par tour | Session de 20 tours |
|---|---|---|
| Muse Spark Standard | $0.0185 | $0.37 |
| Muse Spark Contributor | $0.0012 | $0.024 |
| GPT-5.6 Terra ($2/$12) | $0.0400 | $0.80 |
| Claude Opus 5 ($5/$25) | $0.0900 | $1.80 |
Une session de 20 tours revient à $0.37 en Standard, contre $0.024 en Contributor ; dans ce dernier cas, elle consomme environ 200K du plafond quotidien de 250K.
En tenant compte des entrées mises en cache — avec le ratio cache:entrée:sortie de 7:2:1 d’Artificial Analysis —, le coût moyen de Muse Spark 1.2 Standard descend à $0.78 par million de tokens.
Muse Spark 1.2 face aux tarifs concurrents
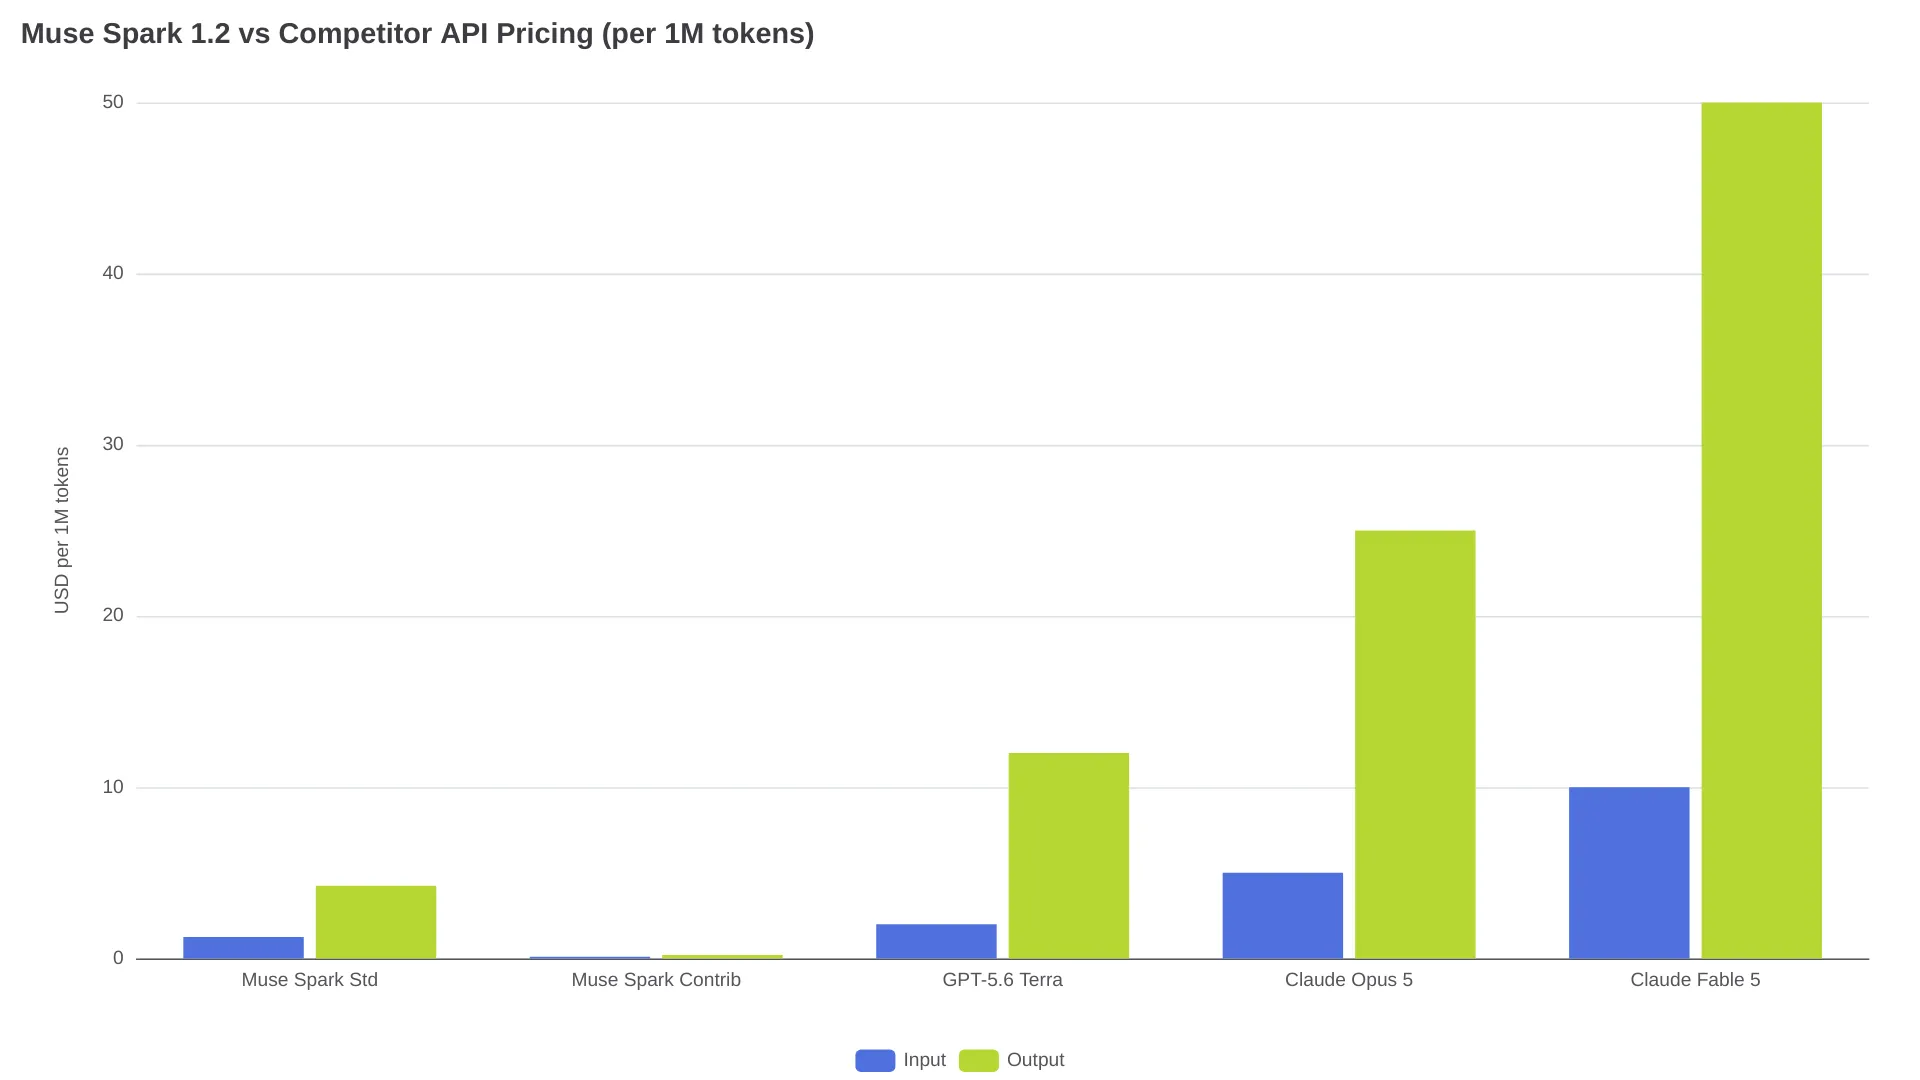
| Modèle | Entrée (par 1M) | Sortie (par 1M) | Coût moyen* |
|---|---|---|---|
| Muse Spark 1.2 Standard | $1.25 | $4.25 | $0.78 |
| Muse Spark 1.2 Contributor | $0.10 | $0.20 | $0.04 |
| GPT-5.6 Terra | $2.00 | $12.00 | $3.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $7.50 |
| Claude Opus 5 | $5.00 | $25.00 | $7.00 |
| Claude Fable 5 | $10.00 | $50.00 | $14.00 |
\*Le coût moyen applique aux lignes Muse Spark un ratio cache:entrée:sortie de 7:2:1 : 0.7 × entrée mise en cache + 0.2 × entrée + 0.1 × sortie. Pour pouvoir comparer, les modèles concurrents reposent sur un scénario de 90/10 entre entrée non mise en cache et sortie. Méthodologie des ratios : Artificial Analysis. Tarifs concurrents : OpenAI et OpenRouter.
Artificial Analysis situe Muse Spark 1.2 sur la frontière de Pareto coût-performance : son niveau d’intelligence serait comparable à celui de Claude Opus 4.8 pour environ un cinquième du coût par tâche. Les montants moyens ci-dessus sont des estimations fondées sur un scénario, non des comparaisons directes de tarifs catalogue ; le tableau de la session à 20 tours offre une comparaison plus homogène, avec la même charge de travail pour chaque modèle.
Côté benchmarks, Muse Spark 1.2 intégré à Muse Code obtient 82.9% sur Terminal-Bench 2.1, contre 86.7% pour Claude Opus 5, selon VentureBeat.
Quelle offre choisir selon votre projet ?
Le choix ne se résume pas au prix : il faut aussi faire correspondre la sensibilité des données, le débit nécessaire et la tolérance à la latence avec votre usage.
Choisissez Standard si :
- Vous manipulez du code propriétaire ou client qui doit rester sous votre contrôle
- Vous avez besoin d’un débit soutenu supérieur à 60 RPM
- Votre consommation quotidienne dépasse 250K tokens
- Vous l’intégrez à un pipeline de production avec une charge prévisible
Choisissez Contributor si :
- Vous travaillez sur des projets open source ou personnels
- Votre utilisation est exploratoire ou largement dédiée au prototypage
- Vous recherchez le coût par token le plus bas pour une exploration à faible volume et pouvez rester sous 60 RPM et ~250K tokens/jour
- Votre équipe accepte que Meta entraîne ses modèles à partir de vos prompts
La latence est un autre facteur à garder en tête. Orca Router mesure un temps jusqu’au premier token de 26.12s pour Spark 1.2, contre 2.90s pour 1.1 : une régression de 9× peu adaptée aux workflows qui exigent une première réponse streamée presque immédiate.
Autre particularité : plusieurs utilisateurs sur Reddit signalent que l’offre Contributor est verrouillée selon les régions. Si elle n’apparaît pas dans la console API, vérifiez d’abord sa disponibilité dans votre région avant de conclure qu’elle n’est pas proposée.
Muse Spark 1.2 est également accessible via des routeurs tiers tels qu’OpenRouter, qui proposent l’offre Standard aux mêmes tarifs de $1.25/$4.25, avec des structures de limites de débit potentiellement différentes.
FAQ
Muse Spark 1.2 propose-t-il une offre gratuite ?
L’API ne propose pas de formule gratuite : Standard comme Contributor fonctionnent à l’usage, selon la page des tarifs de Meta. En revanche, Muse Code, l’agent de programmation de Meta qui utilise Muse Spark 1.2, est gratuit pendant sa bêta, avec des limites quotidiennes de tokens.
Peut-on basculer de Standard à Contributor en pleine session ?
Oui : il suffit d’appeler un autre identifiant de modèle — muse-spark-1.2 ou muse-spark-1.2-contributor —, d’après la documentation de Meta. L’accès à Contributor doit toutefois avoir été activé au préalable dans votre région.
L’offre Contributor convient-elle à la production ?
Uniquement si votre politique de données autorise Meta à exploiter vos prompts et vos complétions pour l’entraînement. Pour du code propriétaire ou client, reportez-vous aux critères de sélection présentés plus haut.
Comment Muse Spark 1.2 se positionne-t-il face à son prédécesseur sur les prix ?
Les tarifs sont inchangés par rapport à Muse Spark 1.1 : les deux offres Standard coûtent $1.25/$4.25 par million de tokens, selon la documentation de Meta. L’offre Contributor est une nouveauté de la version 1.2.