 AIREITER
Muse Spark 1.2 : ce qu’il faut retenir
Meta a lancé Muse Spark 1.2 le 5 août 2026, avec de meilleurs résultats en programmation que la version 1.1 et un nouvel agent de terminal conçu pour l’exploiter. Pourtant, Claude Opus 5 reste devant sur les trois classements de code. C’est toute l’ambivalence de cette version. Les améliorations sont concrètes : Meta a augmenté les ressources de calcul consacrées à l’entraînement au code, coentraîné le modèle avec son agent Muse Code, et les scores ont progressé. Mais une partie du gain entre versions vient du nouvel environnement d’exécution, pas uniquement du modèle. Sur Terminal-Bench, DeepSWE et l’évaluation interne de Meta, le modèle d’Anthropic conserve ainsi entre 4 et 9 points d’avance.
Son prix reste néanmoins son principal attrait. Le tarif standard demeure fixé à 1,25 $/4,25 $ par million de tokens, tandis qu’une offre contributeur le fait tomber à un niveau environ 12 fois inférieur. En contrepartie, la formule proposée par défaut autorise Meta à utiliser votre code pour entraîner ses modèles. Et, au niveau de raisonnement maximal, le délai avant le premier token a été multiplié par environ neuf. Pour évaluer Muse Spark 1.2 en production, ces deux points comptent davantage que son rang dans les benchmarks.
Les évolutions par rapport à Muse Spark 1.1
Muse Spark 1.2 est une mise à jour orientée programmation du modèle de raisonnement de pointe de Meta. Elle est arrivée le 5 août, en même temps que Muse Code, un agent de développement en terminal actuellement en bêta. Meta la décrit elle-même comme une « amélioration modérée » par rapport à Muse Spark 1.1. Une formulation volontairement mesurée pour une version qui cible les scénarios les plus exigeants pour les agents de code : refactorisations sur plusieurs fichiers, longues séances de débogage et tâches qui dépassent largement le cadre d’un prompt unique.
Deux choix d’entraînement expliquent cette progression. D’abord, Muse Code a été intégré à la boucle dès le départ. Meta a coentraîné le modèle à partir de trajectoires issues d’un harness avec échantillonnage par rejet, afin qu’il soit particulièrement efficace dans son propre agent. L’entreprise indique avoir utilisé plusieurs harnesses, ce qui doit permettre au modèle de rester compatible avec d’autres outils de programmation. Ensuite, Meta a mis en place une boucle d’auto-amélioration : Muse Spark 1.1 a généré des environnements de code difficiles et des modèles de suivi d’instructions, puis a évalué les solutions candidates pour constituer le jeu d’entraînement de la 1.2. Selon Meta, cette boucle améliore de façon mesurable le respect d’instructions complexes.
Cette mise à jour s’attaque au principal point faible de la famille Muse. Lors de son lancement en avril 2026, Muse Spark était en retrait pour le code agentique, avec 77,4 sur SWE-Bench Verified, contre 80,8 pour Claude Opus 4.6. Un checkpoint spécialisé en programmation, associé à un harness dédié, constitue la réponse directe de Meta, sans sacrifier les capacités agentiques généralistes.
Benchmarks : ce que disent vraiment les chiffres
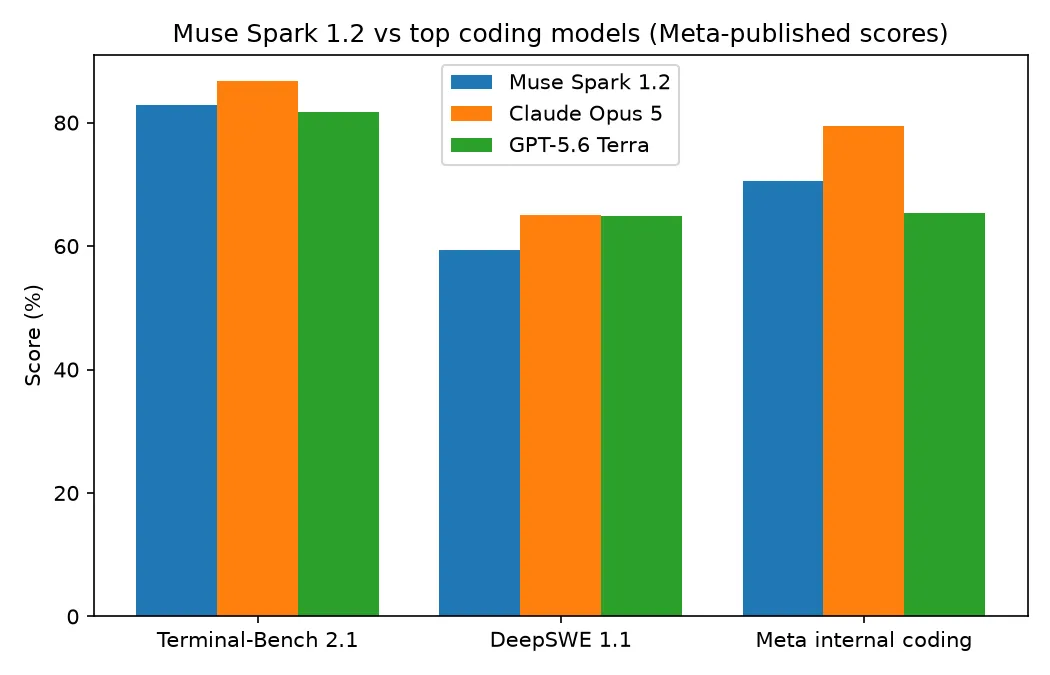
Sur Terminal-Bench 2.1, Muse Spark 1.2 exécuté dans Muse Code atteint 82,9 %, devant GPT-5.6 Terra dans Codex (81,8 %) et Grok 4.5 dans Grok Build (81,6 %), mais derrière Claude Opus 5 à effort maximal dans Claude Code, premier avec 86,7 %. Sur DeepSWE 1.1, il obtient 59,3 %, soit la troisième place derrière Opus 5 (65,0 %) et GPT-5.6 Terra (64,8 %). Le benchmark interne de Meta est le plus révélateur des trois : les 70,6 % de Muse Spark 1.2 dépassent GPT-5.6 Terra (65,4 %) et Gemini 3.6 Flash (63,9 %), mais restent à près de neuf points des 79,4 % d’Opus 5. Claude domine les trois tableaux.
Le progrès générationnel est réel : Muse Spark 1.2 gagne 6,7 points sur Terminal-Bench et 6,3 points sur DeepSWE face à la 1.1. Il faut toutefois lire attentivement les libellés des graphiques avant de comparer les versions. Les résultats de la 1.1 ont été obtenus dans un harness mini-swe-agent générique, alors que la 1.2 tournait dans Muse Code. Une part de l’écart revient donc au nouvel environnement, et pas seulement au modèle. Sur l’Intelligence Index composite d’Artificial Analysis, la 1.2 obtient 54 et se classe 14e sur 186 modèles, pour une médiane de catégorie de 32. C’est mieux que les 51 de la 1.1, mais une progression plus discrète que ne le laissent penser les graphiques dédiés au code.
La comparaison directe avec Claude et GPT est précisément celle que les acheteurs demandent le plus. Sur Reddit, un développeur l’exprimait clairement avant que les données de la 1.2 n’existent :
« Quelqu’un a-t-il utilisé MUSE Spark 1.1 de Meta ? Je voudrais savoir comment il se compare à Claude et GPT en raisonnement, programmation, vitesse, précision et gestion du contexte. »
Les benchmarks de la 1.2 apportent la première réponse rigoureuse : le modèle est compétitif, nettement deuxième en programmation, et devant les options GPT-5.6 et Gemini sur la plupart des graphiques.
Deux limites à anticiper en production
Deux éléments pratiques déterminent si Muse Spark 1.2 a sa place dans un vrai flux de travail. Aucun n’apparaît dans un classement de benchmark.
Le lourd recul de latence en xhigh
Muse Spark est un modèle de raisonnement : il réfléchit avant de répondre, et cette étape ne peut pas être désactivée. Le réglage /effort propose cinq niveaux, de minimal à xhigh, et les tokens de réflexion sont facturés comme des tokens de sortie. Au niveau maximal, le coût est élevé à deux titres. Des mesures indépendantes publiées par OrcaRouter montrent que le délai avant le premier token passe de 2,90 secondes avec la 1.1 à 26,12 secondes en xhigh, soit environ neuf fois plus, tandis que la vitesse de sortie tombe de 213,5 à 165,0 tokens par seconde. L’exécution de l’évaluation Artificial Analysis Intelligence Index sur la 1.2 a coûté 637,85 $, contre 548,07 $ pour la 1.1, soit 16 % de plus, uniquement parce que le modèle délibère davantage. Pour du développement interactif, où un programmeur attend une réponse, l’effort maximal échange souvent trop de latence contre le gain de précision obtenu.
L’offre contributeur échange vos données contre une remise
Meta propose Muse Spark 1.2 selon deux grilles tarifaires, et celle mise en avant auprès des nouveaux utilisateurs comporte une condition. L’offre contributeur (0,10 $/0,20 $ par million de tokens d’entrée/sortie, contre 1,25 $/4,25 $ en standard) est environ 12 fois moins chère en entrée et 21 fois moins chère en sortie ; l’entrée mise en cache coûte presque rien, à 0,002 $. Le compromis est explicite : vous autorisez Meta à utiliser vos prompts et vos complétions pour entraîner de futurs modèles. C’est le tarif le plus bas de cette comparaison ; la contrepartie, ce sont vos données.
Le parcours d’installation par défaut de Muse Code oriente les développeurs vers cette formule. Dans un test rapporté par VentureBeat, l’installeur en une ligne a fonctionné sur un Mac mini — téléchargement de 97 MB puis connexion — mais l’agent s’est arrêté avant toute exécution, indiquant qu’aucun modèle n’était visible et demandant un moyen de paiement, y compris avec l’offre réduite. Le faible coût est réel ; la gratuité ne l’est pas. Les limites de débit sont également plus strictes : 60 requêtes par minute, contre 3 000 en standard. Cela montre clairement que l’offre vise les particuliers et le prototypage, plutôt que la production. Les équipes qui travaillent sur des bases de code propriétaires doivent passer délibérément au tarif standard ou demander une conservation nulle des données auprès du service commercial de Meta.
Tarifs : la place de Muse Spark sur le marché
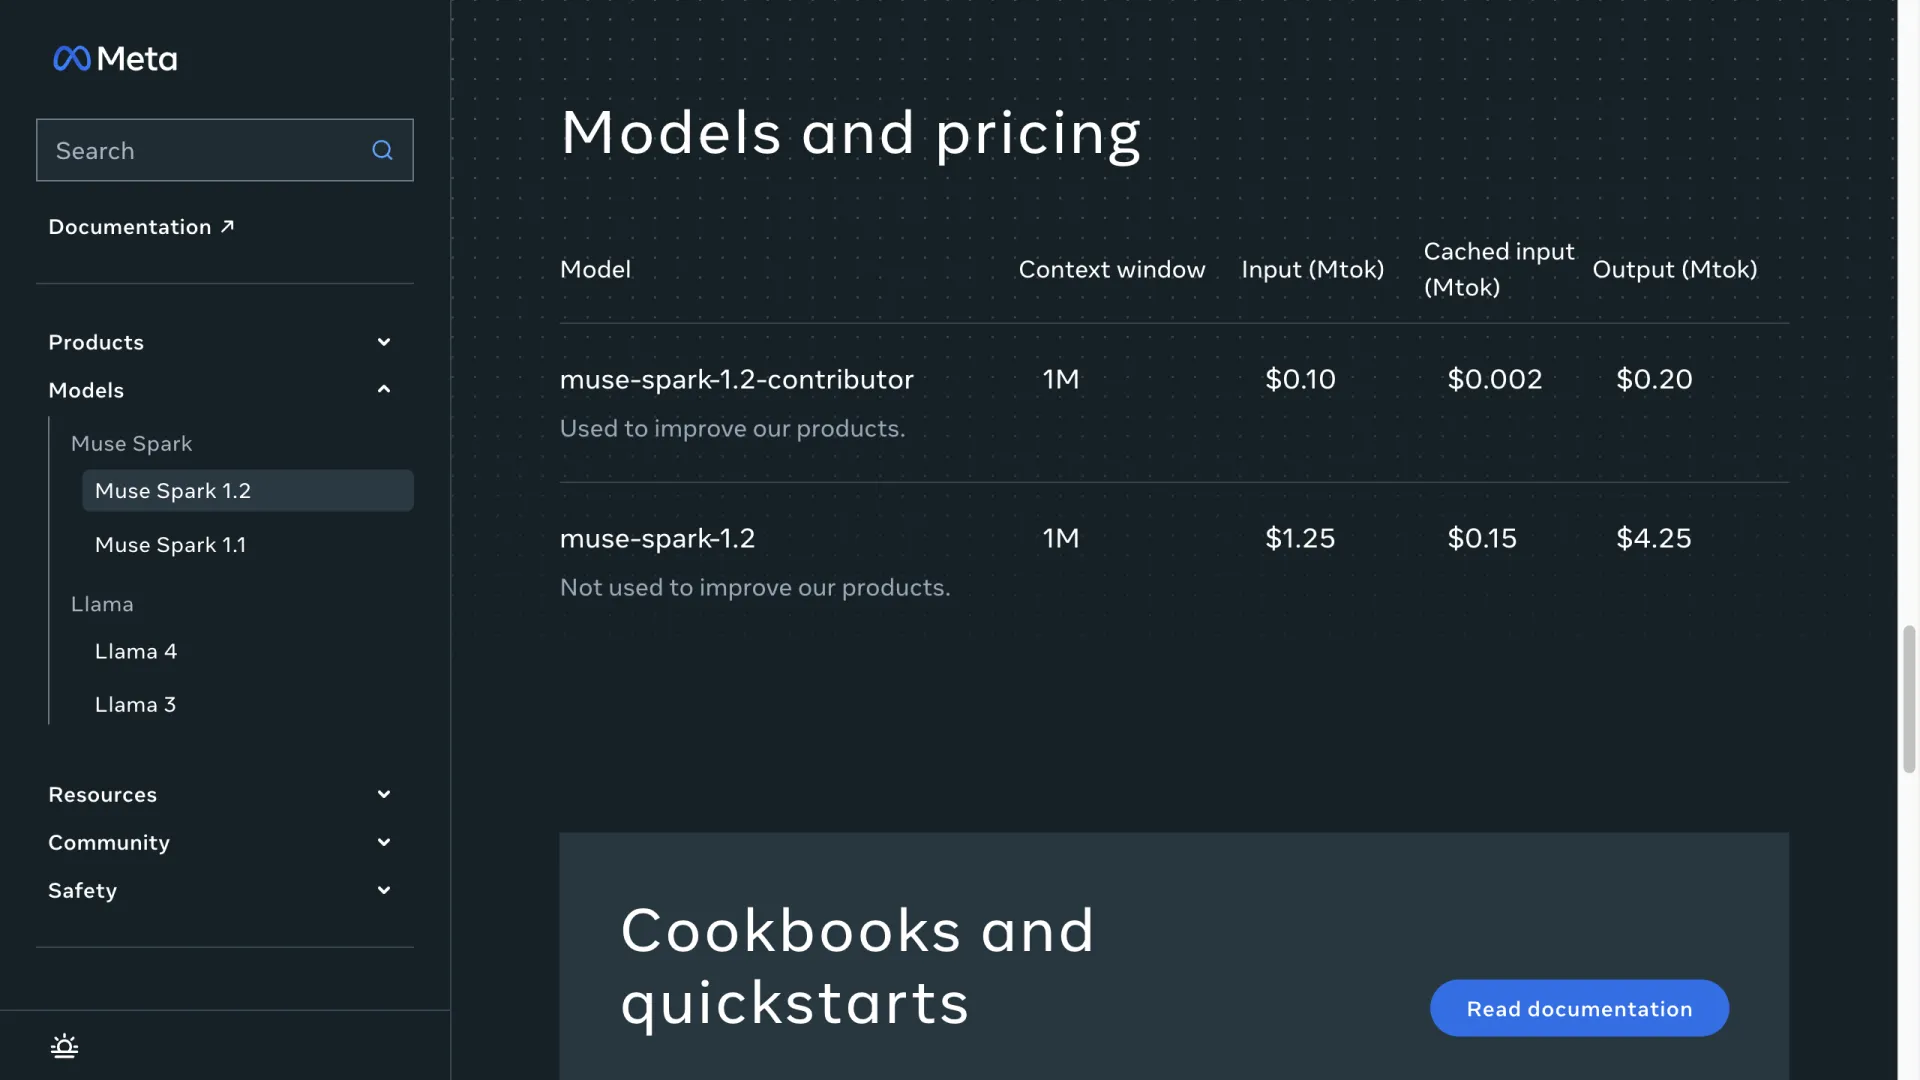
L’offre standard de Muse Spark 1.2 — 1,25 $ par million de tokens d’entrée, 0,15 $ pour le cache et 4,25 $ en sortie, avec une fenêtre de contexte de 1M tokens et sans surcoût pour le contexte long — se situe dans le bas du milieu de gamme des modèles de code. Elle est nettement moins chère que les leaders de la programmation : Claude Opus 5 à 5 $/25 $ et GPT-5.5 à 5 $/30 $ affichent un prix de sortie environ 4 à 7 fois plus élevé. Son tarif est presque identique à celui de GLM-5.2 de Z.ai, à 1,40 $/4,40 $, et inférieur à celui de Grok 4.5, à 2 $/6 $. À l’extrémité la moins chère du marché, DeepSeek V4 Pro à 0,435 $/0,87 $ le sous-cote de plusieurs fois, tout comme l’offre contributeur de Muse Spark elle-même.
| Modèle | Entrée $/M | Sortie $/M | Cache $/M | Contexte |
|---|---|---|---|---|
| Muse Spark 1.2 (standard) | 1.25 | 4.25 | 0.15 | 1M |
| Muse Spark 1.2 (contributeur)* | 0.10 | 0.20 | 0.002 | 1M |
| Claude Opus 5 | 5.00 | 25.00 | — | — |
| GPT-5.5 | 5.00 | 30.00 | — | — |
| GLM-5.2 | 1.40 | 4.40 | — | — |
| Grok 4.5 | 2.00 | 6.00 | — | — |
| DeepSeek V4 Pro | 0.435 | 0.87 | — | — |
\*l’offre contributeur autorise Meta à entraîner ses modèles sur vos données ; limite de 60 req/min.
Disponibilité et alternatives utilisables dès maintenant
Muse Spark 1.2 est accessible à trois endroits : via la Meta Model API, dans l’agent de terminal Muse Code et sur OpenRouter. Il n’est pas encore disponible chez tous les agrégateurs : le catalogue d’AIReiter, vérifié le 6 août 2026, ne le référence pas. Si votre infrastructure repose sur une API unifiée et que vous cherchez un modèle de code dès aujourd’hui, il faut choisir parmi ceux qui sont déjà routés.
L’alternative la plus proche en matière de prix est GLM-5.2, à 1,40 $/4,40 $. Le 6 août 2026, j’ai soumis à glm-5.2, via l’API de la plateforme, une tâche unique mêlant code et raisonnement afin de voir ce que l’option « disponible aujourd’hui » apportait : une fonction Python de retrait sans vérification de découvert. GLM-5.2 a répondu en 3,2 secondes — 85 tokens de prompt et 128 tokens de complétion —, identifié correctement le contrôle de solde manquant, proposé le correctif (if amount > 0 and account_balance >= amount:) et écrit un test qui échoue avant le correctif puis réussit après. Il s’agit d’une seule tâche, pas d’un benchmark, mais c’est un modèle de code fonctionnel, disponible immédiatement et au même niveau de prix. DeepSeek V4 Pro, Kimi K3, Claude Sonnet 5 et la famille GPT-5.6 complètent les options capables de coder déjà présentes dans le catalogue d’AIReiter.
Faut-il utiliser Muse Spark 1.2 ?
La décision dépend de ce que vous cherchez à optimiser, selon trois cas de figure.
Choisissez Muse Spark 1.2 si vous devez programmer à grande échelle avec une forte contrainte de coût — grandes refactorisations multi-fichiers, longues sessions de débogage, tâches agentiques sur un horizon étendu — et que vous acceptez de passer directement par Meta, Muse Code ou OpenRouter. À 1,25 $/4,25 $, il offre des capacités de code de niveau frontier à un tarif intermédiaire. Sa fenêtre de contexte de 1M tokens et la compaction du contexte conviennent aux travaux qui dépassent un prompt unique. Évitez le niveau xhigh, sauf si votre tâche peut supporter un premier token après 26 secondes.
Choisissez Claude Opus 5 si vous avez besoin du meilleur modèle dans les classements de programmation. Il domine les trois benchmarks sur lesquels Muse Spark 1.2 apparaît. Vous payez de 4 à 6 fois plus par token pour cet avantage de précision.
Choisissez un modèle déjà présent chez votre agrégateur si vous devez livrer aujourd’hui et que Muse Spark n’est pas disponible sur votre plateforme. GLM-5.2 offre le même niveau de prix sans attendre ; DeepSeek V4 Pro coûte encore moins cher lorsque le coût brut est le critère dominant.
FAQ
Muse Spark 1.2 est-il meilleur que Claude Opus 5 pour programmer ?
Non. Claude Opus 5 est en tête des trois benchmarks de programmation publiés par Meta — Terminal-Bench 2.1, DeepSWE 1.1 et l’évaluation interne de Meta — avec une avance de 3,8 à 9 points. Muse Spark 1.2 arrive clairement deuxième, devant GPT-5.6 Terra et Gemini 3.6 Flash sur la plupart des graphiques.
Muse Spark 1.2 est-il open source ?
Non. Contrairement à la famille Llama de Meta, Muse Spark est propriétaire : disponible uniquement dans le cloud, sans poids téléchargeables ni auto-hébergement. Mark Zuckerberg a déclaré qu’il aurait « davantage à partager » sur d’éventuelles sorties open source, mais la version 1.2 est fournie sans poids ni licence.