 AIREITER
Avec ses six modèles d’environ 2 milliards de paramètres, Liquid AI LFM3 couvre le texte, la vision, l’audio et les interactions multimodales. Mais au 27 octobre 2026, la page tarifaire officielle de Liquid n’affiche toujours aucun prix pour LFM3. Pour l’instant, cela fait toute la différence entre une famille de spécialistes abordables à déployer sur le edge et une simple solution à télécharger puis héberger soi-même.
LFM3 en bref : six spécialistes 2B, mais aucun tarif API pour l’instant
LFM3 n’est pas un modèle unique, mais la troisième génération de modèles de fondation de Liquid AI conçus pour l’intelligence spécialisée directement sur l’appareil. Toute la famille repose sur le backbone LFM3-1.7B-Base, préentraîné sur 22 000 milliards de tokens, et se décline en six modèles : LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B et d1-Omni-2B (annonce).
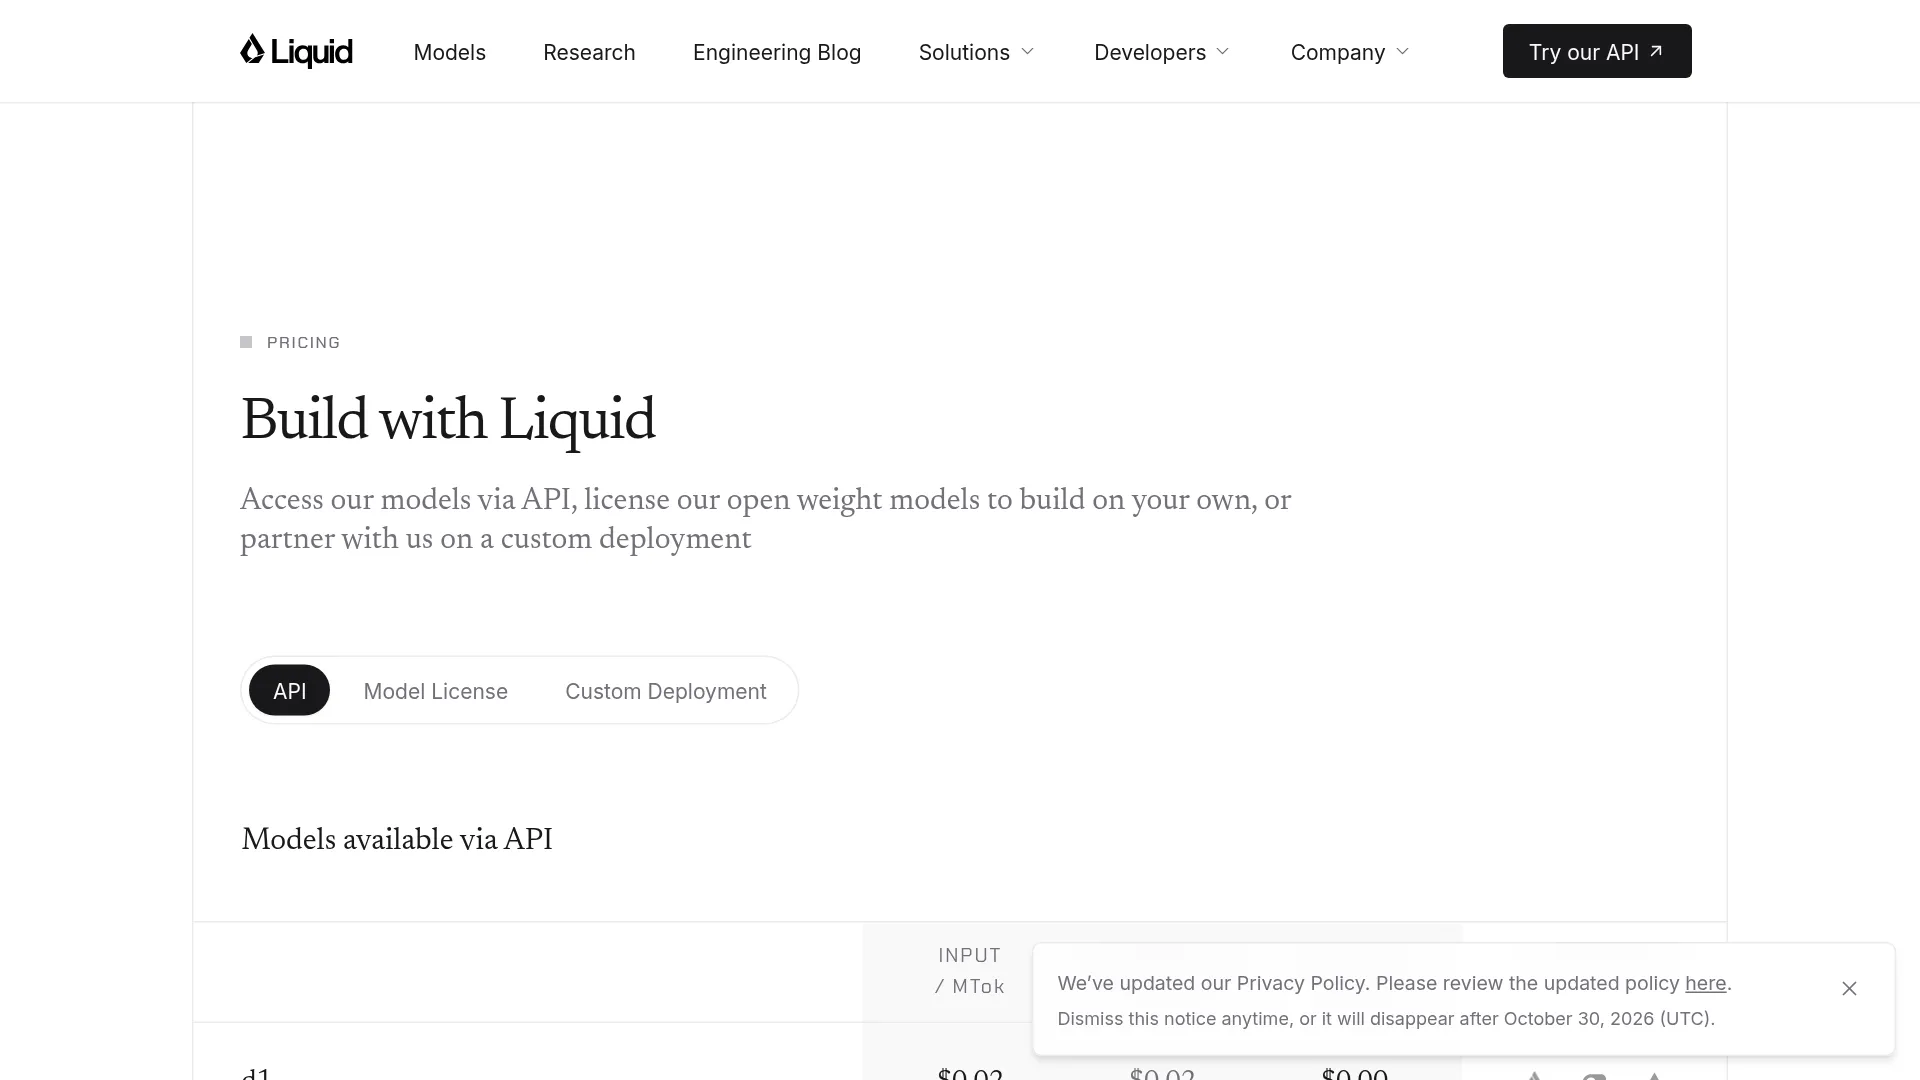
J’ai vérifié la page tarifaire de Liquid AI le 27 octobre : aucune ligne LFM3, seulement les tarifs d1, d1-ultra et LFM2.5 présentés plus bas. L’annonce de LFM3 indique que les poids sont disponibles via Hugging Face, Liquid Playground et Liquid API, mais seuls les deux premiers sont directement vérifiables aujourd’hui. Les nouvelles organisations bénéficient toujours de 2 $ de crédit gratuit sur Liquid Console (tarifs).
Les six modèles LFM3 : lequel choisir selon votre usage ?
Les six checkpoints LFM3 partagent le même backbone, mais ne traitent pas les mêmes entrées et ne produisent pas les mêmes sorties.
| Modèle | Taille approximative | Entrées | Sorties | À utiliser pour |
|---|---|---|---|---|
| LFM3-1.7B | 1.7B | Texte | Texte | Agents locaux, appels d’outils, sorties structurées |
| LFM3-VL-2B | 1.9B | Texte, images, vidéo | Texte | Compréhension d’images et de vidéos, agents visuels |
| LFM3-Audio-2B | 2B | Texte, audio | Texte, parole | Conversation vocale, reconnaissance, synthèse et traduction dans 18 langues |
| LFM3-Omni-2B | 2B | Texte, images, vidéo, audio | Texte, parole | Assistant multimodal unifié |
| d1-2B | 2B | Texte, images, vidéo | Réponses calibrées | Classification, extraction, décisions en un seul passage |
| d1-Omni-2B | 2B | Texte, images, vidéo, audio | Réponses calibrées | Analyse multimodale avec scores de confiance |
LFM3-1.7B dispose d’une fenêtre de contexte de 256K tokens et d’une architecture tri-hybride de 24 couches : 13 couches de convolutions courtes à portes, 5 couches d’attention à fenêtre glissante de 256 tokens et 6 couches d’attention globale (annonce). La dernière phase de mid-training, menée sur 3 500 milliards de tokens, a intégré des trajectoires d’agents et des appels d’outils. C’est ce qui explique le positionnement du modèle texte pour des environnements comme Hermes Agent, Pi et ceux de type OpenClaw (annonce). LFM3-VL-2B est le premier modèle de vision de Liquid à accepter des vidéos en entrée, tandis que LFM3-Omni-2B est son premier modèle omnicanal capable de traiter simultanément la bande sonore et les images d’une vidéo (annonce).
Les modèles de décision adoptent une approche différente. d1-2B et d1-Omni-2B ne génèrent pas de texte de manière autorégressive : ils renvoient directement une réponse calibrée accompagnée de probabilités, en un seul passage (annonce). Liquid annonce pour d1-2B une latence de décision de 5,7 ms sur NVIDIA H100 et de 3,8 ms sur AMD MI325X. Avec d1-Omni-2B et un clip audio de 10 secondes, elle passe respectivement à 12,4 ms et 8,2 ms (annonce).
Ce que Liquid annonce, et ce que l’on peut réellement vérifier
Les performances publiées par Liquid AI proviennent du constructeur lui-même : il faut donc les considérer comme des déclarations commerciales tant que des tests indépendants ne sont pas disponibles. Tous les chiffres ci-dessous sont tirés de l’annonce de Liquid.
| Modèle | Indicateur communiqué par le fabricant | Résultat LFM3 | Ancien modèle / concurrent |
|---|---|---|---|
| LFM3-1.7B | WebArena-Verified | 38.42 | 3.02 (LFM2.5-2.6B) |
| LFM3-1.7B | Taille / vitesse | 35 % de paramètres en moins, environ 25 % plus rapide par paramètre à 8K que LFM2-1.2B | — |
| LFM3-VL-2B | Moyenne vision 62 / encodeur | 71.4 de moyenne ; encodeur de 164M avec 2,2 fois moins de FLOPs | 57.6 de moyenne ; parité revendiquée avec l’encodeur de Qwen3.5-2B |
| LFM3-Audio-2B | UTMOSv2 / latence | 3.83 ; 50 ms minimum avant le premier token ; 87 fois le temps réel sur le CPU d’un M4 Max | 3.22 (LFM2.5-Audio-1.5B) |
| d1-2B | ImajevBench | 75.5 | 64.0 (d1-3B) |
Ce que j’ai pu vérifier directement : la collection LiquidAI LFM3 sur Hugging Face réunit bien les six modèles, avec des variantes quantifiées, MLX et ONNX, tandis que le catalogue de LM Studio propose déjà des variantes LFM3 pour ordinateur. Mieux vaut toutefois voir ces scores comme une indication que comme une promesse. Les moyennes globales masquent les résultats détaillés en OCR, en ancrage et en vidéo, et le chiffre de 1 Go en 4 bits ne comprend ni le cache KV ni la mémoire consommée par l’application.
« C’est fou de voir à quelle vitesse on peut créer des choses aujourd’hui. » — @Nklockiewicz, qui fait tourner LFM3 sur un iPhone en mode avion via MLX/ExecuTorch à 40 tok/s (source)
« Ils dépassent généralement leur catégorie en vitesse et en intelligence, mais d’après mon expérience, ils ne sont pas encore assez intelligents pour du “vrai travail”. » — u/spaceman_, r/LocalLLaMA (source)
Le seuil de licence à 10 M$ à connaître avant une mise en production
La licence open-weight de Liquid AI est gratuite tant que le chiffre d’affaires annuel de l’entreprise reste inférieur à 10 millions de dollars (tarifs). Les développeurs, chercheurs, associations et entreprises sous ce seuil peuvent télécharger, exécuter, affiner et déployer en production tous les LFM ouverts, conserver leurs fine-tunings privés et les installer sur mobile, sur le edge ou en local, sans obligation de licence copyleft (tarifs).
Au-delà de 10 M$ de chiffre d’affaires annuel, les entreprises doivent souscrire une licence enterprise payante, dont le prix dépend de l’échelle du déploiement et se négocie avec les équipes commerciales. La recherche, l’enseignement et l’usage associatif restent gratuits, sans plafond de revenus (tarifs). La LFM Open License cesse donc d’accorder gratuitement les droits commerciaux à partir de ce seuil. Avant d’intégrer les poids dans une application commerciale, faites valider les conditions d’attribution, de redistribution et d’export par votre conseil juridique.
Exécution locale : ce que recouvre vraiment le chiffre de 1 Go
LFM3-1.7B occupe environ 1 Go en 4 bits, mais ce chiffre ne concerne que les poids (annonce). Le processus doit aussi charger le runtime, le cache KV nécessaire aux contextes longs et les encodeurs de vision ou d’audio. Prévoyez donc de la mémoire supplémentaire, en particulier avec les variantes VL et Omni qui traitent des images vidéo ou des clips audio.
Commencez par LFM3-1.7B et ne passez à VL, Audio ou Omni que si votre cas d’usage l’exige. Vérifiez aussi les dépendances propres à chaque fiche modèle avant de lancer vos benchmarks. Les chemins Ollama, LM Studio, llama.cpp, MLX et ONNX sont indiqués pour LFM3 dans la collection Hugging Face et le catalogue de LM Studio.
Lorsqu’un exemple de fiche modèle demande trust_remote_code=True, épinglez le hash d’un commit, inspectez le code du dépôt ou effectuez vos premiers essais dans un environnement isolé : ce paramètre autorise l’exécution du code fourni dans le repository. Liquid annonce 18 langues audio dans sa présentation de LFM3, sans publier de tableau de qualité par langue. Vérifiez donc les performances dans les langues qui vous intéressent avec vos propres données.
Accès API : où appeler LFM3 et comment interpréter les tarifs
L’accès API à LFM3 a bien été annoncé, mais aucun tarif distinct n’apparaît sur la page publique de Liquid. Celle-ci oriente les appels vers Liquid Console, OpenRouter et Vercel AI Gateway (tarifs).
| Modèle API affiché le 27 octobre | Entrée / MTok | Entrée en cache / MTok | Sortie / MTok |
|---|---|---|---|
| d1 | $0.02 | $0.02 | $0.00 |
| d1-ultra | $0.042 | $0.042 | $0.00 |
| LFM2.5-24B-A2B | $0.05 | $0.025 | $0.70 |
| Tarifs texte LFM3-1.7B / VL / Audio / Omni | Non indiqué | Non indiqué | Non indiqué |
Pour l’instant, l’absence de tarif constitue la réponse : prévoyez LFM3 comme un coût de calcul auto-hébergé auquel s’ajoute le temps d’ingénierie, et non comme une ligne de facturation au token. Si un fournisseur propose aujourd’hui des tokens LFM3, comparez son offre aux références d1 et LFM2.5 affichées ici et vérifiez s’il relaie Liquid Console ou s’il fait tourner ses propres poids. Avec une sortie facturée $0.00 par million de tokens, d1 peut notamment se montrer intéressant pour les pipelines d’inspection à gros volume.
FAQ sur LFM3
Combien coûte l’API LFM3 ?
Liquid AI n’affiche aucun tarif distinct par token pour LFM3 au 27 octobre 2026. La page publique présente uniquement les prix de d1, d1-ultra et LFM2.5-24B-A2B.
LFM3 est-il gratuit pour un usage commercial ?
La mise en production commerciale est gratuite pour les entreprises dont le chiffre d’affaires annuel est inférieur à 10 M$, selon la LFM Open License. Les entreprises plus importantes doivent souscrire une licence enterprise payante.
LFM3 peut-il fonctionner sur un téléphone ou un ordinateur portable ?
Oui, pour la variante texte, qui nécessite environ 1 Go en 4 bits, auxquels il faut ajouter la mémoire du runtime. Des chemins Ollama, LM Studio, llama.cpp, MLX et ONNX sont disponibles. Les variantes VL, Audio et Omni demandent davantage de mémoire pour leurs encodeurs et le traitement des médias.
LFM3 est-il meilleur que Qwen ou Gemma pour les agents edge ?
Je n’ai trouvé aucune comparaison indépendante dans les résultats disponibles au lancement. Les victoires revendiquées par Liquid face à Qwen3.5-2B et Qwen2.5-Omni-7B viennent du fabricant (annonce). Testez donc LFM3 face à Gemma et Qwen dans votre propre environnement avant de migrer.
Puis-je affiner LFM3 avec un seul GPU ?
Liquid fournit des notebooks pour le SFT, le DPO, le GRPO et le préentraînement continu, et affirme que chaque modèle peut être affiné sur un seul GPU (annonce). L’entreprise ne publie toutefois pas les besoins en VRAM ni la taille des jeux de données nécessaires.
Un spécialiste privé et économique, ou un petit généraliste qui demande encore du travail
LFM3 a du sens lorsque les données doivent rester sur l’appareil, que les médias ne doivent pas quitter l’environnement local ou que le volume de décisions rend les factures cloud au token trop lourdes. En revanche, il ne faut pas en attendre une vaste couverture des connaissances, un raisonnement créatif long ou une qualité prête à l’emploi sans réglage de votre environnement. Téléchargez une variante, mesurez-la sur vos prompts et votre matériel, puis laissez ces résultats — plutôt que le graphique du lancement — guider votre décision.