 AIREITER
Avec 1 595 Elo, GLM-5.2 occupe la deuxième place du classement Code Arena Frontend d'Arena. Sur FrontierSWE, il se situe à un point de Claude Opus 4.8. Pourtant, les développeurs cherchent activement des solutions de remplacement. Depuis son lancement en juin 2026, les mêmes irritants reviennent dans les discussions : des quotas de Coding Plan qui disparaissent au milieu d'une tâche, des erreurs aux heures de pointe et une consommation de tokens qui rend le tarif affiché de $1.40/$4.40 trompeur dans les longues boucles d'agents. La meilleure alternative à GLM-5.2 dépend donc surtout du problème que vous venez de rencontrer.
Les meilleurs remplaçants de GLM-5.2 selon votre besoin
Voici cinq recommandations immédiates ; les éléments de preuve suivent plus bas.
- Quotas épuisés / coût des boucles d'agents : DeepSeek V4 Flash, à $0.14/M en entrée, $0.28/M en sortie, avec 1M de contexte.
- Boucles d'agents instables : Kimi K2.7 Code, à $0.95/M en entrée et $4.00/M en sortie.
- Plafond plus élevé sur les tâches les plus difficiles : Claude Opus 4.8, qui double le score de GLM-5.2 sur SWE-Marathon, avec la tarification d'un modèle fermé.
- Auto-hébergement ou maîtrise des données : Qwen3-Coder (Apache 2.0), ou les poids MIT de GLM-5.2 lui-même si vous disposez de 372–475 GB de RAM pour une version 4 bits.
- Rien ne cloche, vous voulez simplement du plus récent : GLM-5.3, au même tarif de $1.40/$4.40, confirmé par Z.ai le jour de son lancement.
Les forces de GLM-5.2, et le coût réel de son utilisation
La documentation officielle de Z.ai présente GLM-5.2 comme un modèle phare texte uniquement : fenêtre de contexte de 1M de tokens, sortie maximale de 128K tokens et tarifs API de $1.40/M en entrée, $4.40/M en sortie et $0.26/M pour les entrées mises en cache. Les poids sont sous licence MIT. Ils ont été publiés le 16 juin 2026, après un déploiement le 13 juin qui réservait initialement le modèle au GLM Coding Plan. Sur la fiche modèle : 81.0 à Terminal-Bench 2.1 contre 85.0 pour Opus 4.8, 62.1 à SWE-bench Pro contre 69.2, et 74.4 à FrontierSWE contre 75.1.
Ces résultats placent le modèle aux portes de la frontière des modèles fermés, avec un tarif d'open weights. C'est l'exploitation au quotidien qui fait grincer des dents. Autour du lancement de 5.2, le forfait Pro du Coding Plan est passé de moins de $35 à $65/mois, une hausse documentée par @bridgemindai le jour même. Mais les quotas du forfait suscitent davantage de critiques que son prix :
"GLM 5.2 will end your weekly rate limit in a day." — u/intl_spy, r/opencode
"I like GLM-5.2, but my god it is a token muncher." — @atomtanstudio
Un développeur qui faisait tourner des agents auto-évolutifs sur GLM-5.2 dans un contexte de production indique avoir dépensé plus de $500 sur un seul week-end. Il souligne qu'un changement de modèle pendant l'exécution fait perdre le cache KV et oblige à repayer le même contexte (@Xianbao_QIAN). Un autre développeur résume nettement la limite de la proposition de valeur :
"GLM 5.2 is great but my $200/m Codex sub still gets me more usage for $200 of GLM 5.2 API usage. It's a great supplemental model... but not a replacement by any means." — @mweinbach
À cela s'ajoutent les problèmes de capacité aux heures de pointe. Abonné depuis GLM-4.5, @gengdaJ décrit des serveurs qui « explosent » le soir et le contraignent à revenir à des modèles plus anciens. Voilà pourquoi les recherches sur les alternatives à GLM-5.2 viennent souvent d'utilisateurs qui apprécient pourtant le modèle.
Les alternatives comparées : prix et cas d'usage
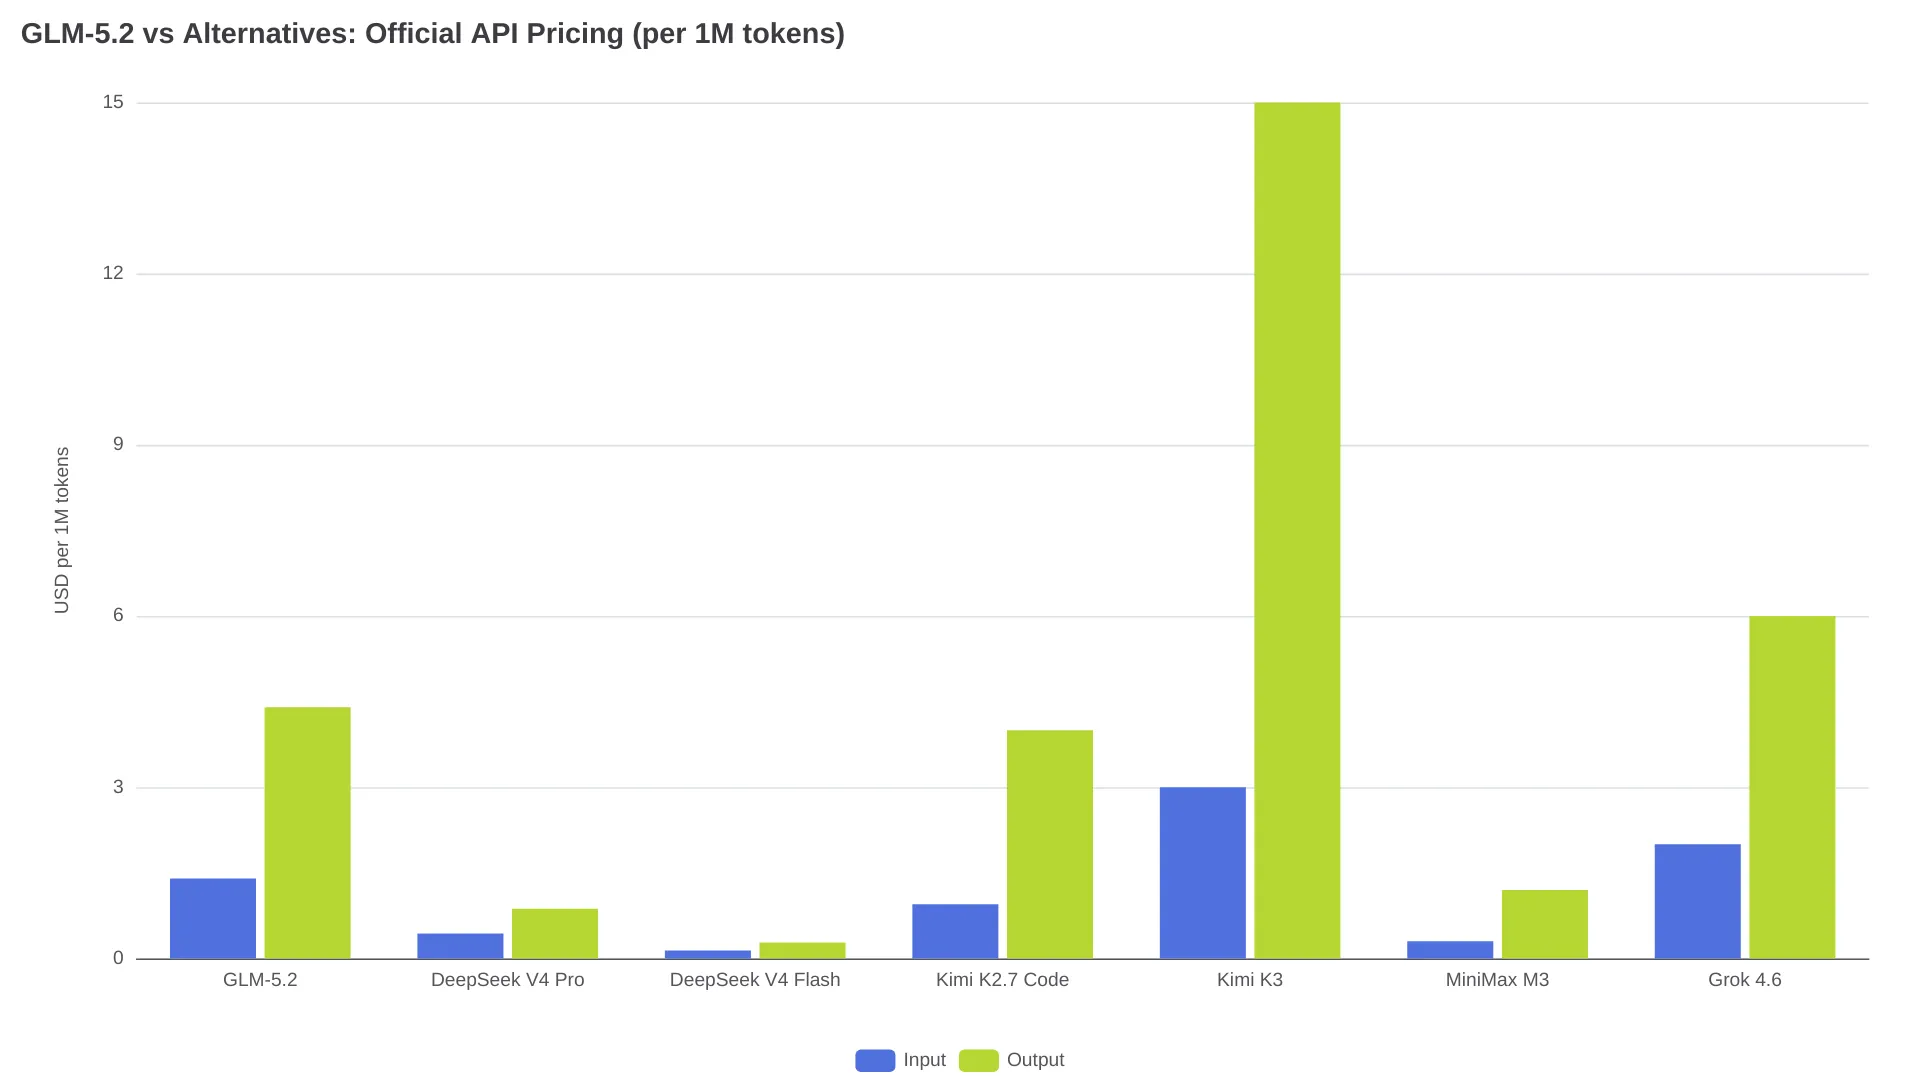
Tous les prix ci-dessous proviennent des pages tarifaires des fournisseurs et ont été relevés en août 2026. Les tarifs de Kimi K3 et MiniMax M3 correspondent aux entrées sans cache ; leurs paliers avec cache sont nettement moins chers.
| Modèle | Contexte | Poids / licence | Prix API ($/1M, entrée / sortie) | À choisir si… |
|---|---|---|---|---|
| GLM-5.2 (référence) | 1M | MIT | $1.40 / $4.40 | — |
| DeepSeek V4 Pro | 1M | Ouvert (MIT, selon Layer3 Labs) | $0.435 / $0.87 | Vous cherchez un raisonnement complexe moins cher avec la même taille de contexte |
| DeepSeek V4 Flash | 1M | Ouvert | $0.14 / $0.28 | Le problème se résume à l'épuisement des quotas |
| Kimi K2.7 Code | 256K | Ouvert (MIT modifiée) | $0.95 / $4.00 | La fiabilité des boucles d'agents compte plus que la taille du contexte |
| Kimi K3 | 1M | Fermé | $3.00 / $15.00 | Vous voulez la stabilité de Kimi et 1M de contexte |
| MiniMax M3 | 1M | Fermé | $0.30 / $1.20* | Vous avez besoin d'entrées multimodales ou de volume à coût maîtrisé |
| Qwen3.8 Max / Qwen3-Coder | 1M | Apache 2.0 | Poids gratuits ; hébergement variable | L'objectif est l'auto-hébergement ou le fine-tuning |
| Grok 4.6 | 500K | Fermé | $2.00 / $6.00 | Vous privilégiez la vitesse et un contexte large mais maîtrisable |
Au-delà de ces sept modèles, deux pistes de mise à niveau sont détaillées plus bas : Claude Opus 4.8 pour les équipes bloquées sur les tâches les plus difficiles, et GLM-5.3 pour évoluer dans la même famille au même prix.
\* Le palier MiniMax M3 s'applique aux entrées ≤512K tokens ; les tarifs doublent au-delà de ce seuil. Selon l'annonce de lancement de Z.ai, GLM-5.3 conserve exactement les mêmes prix que GLM-5.2 ; il est donc absent de cette comparaison de coûts.
Quel modèle choisir selon le problème rencontré ?
Vos quotas fondent : basculez l'exécution vers DeepSeek V4 Flash
Le calcul est sans appel. Pour les entrées sans cache, GLM-5.2 à $1.40/M coûte 10x le prix de DeepSeek V4 Flash à $0.14/M ; en sortie, l'écart entre $4.40 et $0.28 atteint 15.7x. Sur la partie exécution d'une boucle d'agents — modifications de fichiers, corrections de tests, code répétitif — la différence s'accumule à chaque tour. DeepSeek propose la même fenêtre de 1M de tokens avec une sortie maximale de 384K. V4 Pro, à $0.435/$0.87, conserve l'essentiel de l'économie tout en visant les sessions de raisonnement plus exigeantes ; notre comparatif GLM-5.2 vs DeepSeek V4 Pro explique où chaque modèle prend l'avantage, tandis que le face-à-face V4 Flash couvre l'option petit budget.
Chez les abonnés OpenCode Go, le schéma qui ressort n'est pas un remplacement total, mais une répartition des rôles : GLM-5.2 pour la planification et la revue, un modèle plus économique pour le travail répétitif. « I use OpenCode Go GLM 5.2 for planning only », écrit u/narkeeso. Dans le même écosystème, u/Endoky recommande de « only use GLM 5.2 as escalation model or for planning ».
Boucles d'agents instables : Kimi K2.7 Code
Lorsque le souci tient au service plutôt qu'aux capacités du modèle, Kimi est l'alternative la plus souvent citée dans les fils étudiés. Voici le résumé d'un utilisateur, initialement publié en chinois :
"The model capability is about the same, but the inability to serve it stably is why I chose Kimi over GLM." — @wonjder
Kimi K2.7 Code est le choix spécialisé pour le code : $0.95/M en entrée, $4.00/M en sortie, et $0.19/M sur les accès au cache. Sa fenêtre de contexte de 262,144 tokens représente un quart de celle de GLM-5.2 : c'est la véritable contrepartie. Il accepte les entrées texte, image et vidéo, ce qui comble aussi le manque multimodal d'un GLM-5.2 limité au texte. Si 256K ne suffit pas à contenir votre dépôt, Kimi K3 monte à 1M de contexte pour $3.00/$15.00. Ses $15 en sortie équivalent toutefois à 3.4x le tarif de GLM-5.2 : K3 s'achète pour sa stabilité, non pour réduire la facture. Le comparatif Kimi K2.7 Code vs GLM-5.2 détaille la partie benchmarks.
Pour les tâches les plus complexes : Claude Opus 4.8
Sur SWE-Marathon — compilations de compilateurs, travail sur le noyau, tâches autonomes sur plusieurs heures — Opus 4.8 obtient 26.0, contre 13.0 pour GLM-5.2. Sur NL2Repo, le score est de 69.7 contre 48.9, selon la fiche modèle de Z.ai. GLM-5.2 reste le modèle ouvert le mieux classé sur les deux tableaux, d'après cette même fiche, mais l'écart se creuse précisément à mesure que les tâches s'allongent. Opus est propriétaire, ne peut pas être auto-hébergé et coûte plus cher ; notre comparatif GLM-5.2 vs Opus indique quand ce surcoût devient rentable.
Auto-hébergement et contrôle des données : Qwen3-Coder ou les poids de GLM
Qwen3-Coder et Qwen3.8 Max sont publiés sous licence Apache 2.0, avec 1M de tokens de contexte et des variantes compactes adaptées au déploiement sur un seul GPU. Layer3 Labs comme glm5.app les citent comme le choix à privilégier pour l'auto-hébergement. Pour le fine-tuning et les déploiements privés, ce sont les options les plus pragmatiques parmi les alternatives présentées ici ; notre article sur les open weights de Qwen 3.8 Max couvre cette famille.
L'option contre-intuitive consiste à auto-héberger GLM-5.2 lui-même, puisque la licence MIT l'autorise. Mais les contraintes matérielles sont sévères : les poids BF16 occupent 1.51 TB, et même une quantification 4 bits proposée dans la release GGUF d'Unsloth exige 372–475 GB de mémoire pour être chargée. En pratique, une version 4 bits relève d'un serveur multi-GPU et le BF16 complet d'une infrastructure de type cluster. L'outillage local reste récent : llama.cpp n'a intégré le support de l'indexeur de GLM-5.2 que le 24 juillet 2026 (PR #25407). Auto-héberger GLM-5.2 répond à un impératif de souveraineté des données, pas à une recherche de simplicité ; sans cluster, les variantes compactes de Qwen constituent l'alternative adaptée à une station de travail.
Multimodal et gros volumes à bas prix : MiniMax M3
MiniMax M3 associe 1M de contexte à des entrées multimodales pour $0.30/M en entrée et $1.20/M en sortie, dans le palier ≤512K. Les deux tarifs doublent au-delà de ce seuil : prévoyez votre budget en conséquence. Pour les équipes, les plans de tokens de MiniMax coûtent $20/$50/$120 par mois et couvrent la gamme M3, M2.7, image et voix de l'entreprise, avec des quotas comptabilisés sur des fenêtres glissantes de 5 heures et hebdomadaires.
Priorité à la vitesse : Grok 4.6
Grok 4.6 est affiché à $2.00/M en entrée et $6.00/M en sortie, avec 500K de contexte. La page API de xAI revendique des performances de premier plan en code et en appels d'outils, sans publier le tableau de benchmarks correspondant : considérez ce positionnement comme tel. Le signal côté utilisateurs existe néanmoins. @bourneliu66 estime que Grok a remplacé GLM dans son « big three », le jugeant plus puissant, plus rapide et moins cher. Testez cet ordre sur vos propres charges de travail avant de l'adopter.
Vous voulez seulement le GLM le plus récent : GLM-5.3
GLM-5.3 est arrivé dans l'API le 18 août 2026 à exactement le même prix que GLM-5.2, d'après l'annonce de Z.ai. Si vous consultez les alternatives par crainte de manquer une mise à niveau plutôt que par insatisfaction, le comparatif GLM-5.2 vs GLM-5.3 détaille les changements réels.
La stratégie à deux modèles : conserver GLM-5.2, mais le reléguer
Les discussions mentionnées plus haut mènent souvent à autre chose qu'une migration complète. GLM-5.2 devient le planificateur ou le relecteur, tandis qu'un modèle plus abordable se charge de l'exécution. Cela correspond bien à son profil : Z.ai le positionne pour les agents d'ingénierie de longue durée, tout en le plaçant parmi les modèles les plus chers au token dans cette catégorie budgétaire.
Deux mécanismes déterminent la réussite de cette approche. D'abord, la perte du cache KV : changer de modèle ou de fournisseur pour un même modèle au cours d'une exécution impose de repayer le contexte. Ensuite, les écarts entre fournisseurs : des utilisateurs de r/opencodeCLI signalent des différences de vitesse importantes entre Fireworks, NeuralWatt et OpenCode Go pour un même modèle.
Un endpoint unique compatible OpenAI simplifie la partie opérationnelle : vous conservez le même format de requête GLM-5.2 API pour les deux étapes, redirigez le trafic lorsqu'un fournisseur se dégrade et réglez une seule facture. Cela ne rend pas le contexte gratuit : la réutilisation du cache ne se transfère jamais entre modèles ni entre fournisseurs. C'est le coût à l'origine du week-end à $500 rapporté plus haut ; répartissez donc les modèles aux frontières des tâches, jamais au milieu d'une exécution. Si votre répartition s'inscrit dans Claude Code, notre guide GLM-5.2 dans Claude Code couvre la partie intégration.
Le tableau de décision en 30 secondes
| Votre problème | Choix recommandé | Ce que vous perdez |
|---|---|---|
| Le quota hebdomadaire disparaît en une journée | DeepSeek V4 Flash | Une partie du raffinement de GLM en code agentique |
| Les boucles d'agents échouent sur des erreurs de fournisseur | Kimi K2.7 Code | Le contexte de 1M, remplacé par 256K |
| Les tâches les plus difficiles sur plusieurs heures échouent | Claude Opus 4.8 | Les poids ouverts, le tarif bas et l'auto-hébergement |
| Vous avez besoin des poids sur votre propre infrastructure | Qwen3-Coder | Le niveau de GLM en code frontend, leader en Elo |
| Le modèle consomme trop de tokens sur les tâches généralistes | MiniMax M3 | Au-delà de 512K tokens d'entrée, les prix doublent |
| Contraintes réglementaires ou d'achats | Qwen ou poids GLM auto-hébergés | La simplicité d'un service managé |
| Vous voulez le GLM le plus récent | GLM-5.3 | Rien ; le prix est identique |
FAQ
Quelle est la meilleure alternative globale à GLM-5.2 ?
DeepSeek V4 Pro est le substitut le plus proche dans l'ensemble : 1M de contexte, poids ouverts et un coût par token 3 à 5 fois inférieur. Kimi K2.7 Code est préférable si la fiabilité des longues exécutions d'agents compte davantage que l'écart dans les benchmarks.
DeepSeek est-il meilleur que GLM-5.2 pour coder ?
Pour le raisonnement algorithmique difficile, le comparatif de glm5.app classe DeepSeek V4 Pro devant. Pour le travail agentique multi-fichiers sur le long terme, le contexte de 1M de GLM-5.2 et son entraînement pour les agents à horizon long — sa spécialité annoncée par Z.ai — le maintiennent devant. En pratique : DeepSeek exécute, GLM planifie.
Quelle est l'alternative la moins chère à GLM-5.2 ?
DeepSeek V4 Flash, à $0.14/M en entrée et $0.28/M en sortie, avec des entrées sur cache à $0.0028/M, soit un coût quasiment nul pour les contextes répétés.
Quelles alternatives offrent comme GLM-5.2 un contexte de 1M de tokens ?
DeepSeek V4 Pro et V4 Flash, Kimi K3, MiniMax M3 et Qwen3.8 Max annoncent tous une fenêtre de 1M de tokens. Kimi K2.7 Code, avec 256K, et Grok 4.6, avec 500K, ne l'atteignent pas.
Peut-on exécuter GLM-5.2 localement plutôt que de changer de modèle ?
Techniquement, oui : les poids MIT existent. Mais une version 4 bits exige 372–475 GB de RAM, et le support de llama.cpp n'a été fusionné que le 24 juillet 2026. Pour la plupart des équipes, l'API hébergée reste la seule voie réellement pratique.
Combien coûtent par mois les alternatives à GLM-5.2 sur abonnement ?
Les plans de tokens MiniMax vont de $20 à $120/mois. Code CLI de Kimi commence à $19/mois et le Coding Plan de Z.ai à $18/mois, selon la couverture tarifaire de Digital Applied, tandis que l'offre Z.ai Pro est à $65 depuis la hausse de juin.