 AIREITER
Trois semaines seulement après Gemini 3.6 Flash, Google a lancé Gemini 3.7 Flash avec un bond marqué des performances : sur DeepSWE v1.1, le score passe de 48,6 % à 65,3 %. Les deux modèles conservent le tarif promotionnel de 0,75 $/3,75 $ par million de tokens jusqu'en décembre 2026. La migration n'augmente donc pas le coût par token, mais son intérêt dépend fortement de vos usages.
Gemini 3.7 Flash face à 3.6 Flash : les 18 benchmarks comparés
Les chiffres mis en avant par Google DeepMind sur sa page officielle des modèles montrent des progrès généralisés pour 3.7 Flash. Les écarts les plus importants concernent les agents de code et l'automatisation en entreprise. Le tableau ci-dessous reprend les 18 métriques publiées par Google pour les deux modèles, avec Claude Sonnet 5 et GPT-5.6 Terra comme points de comparaison.
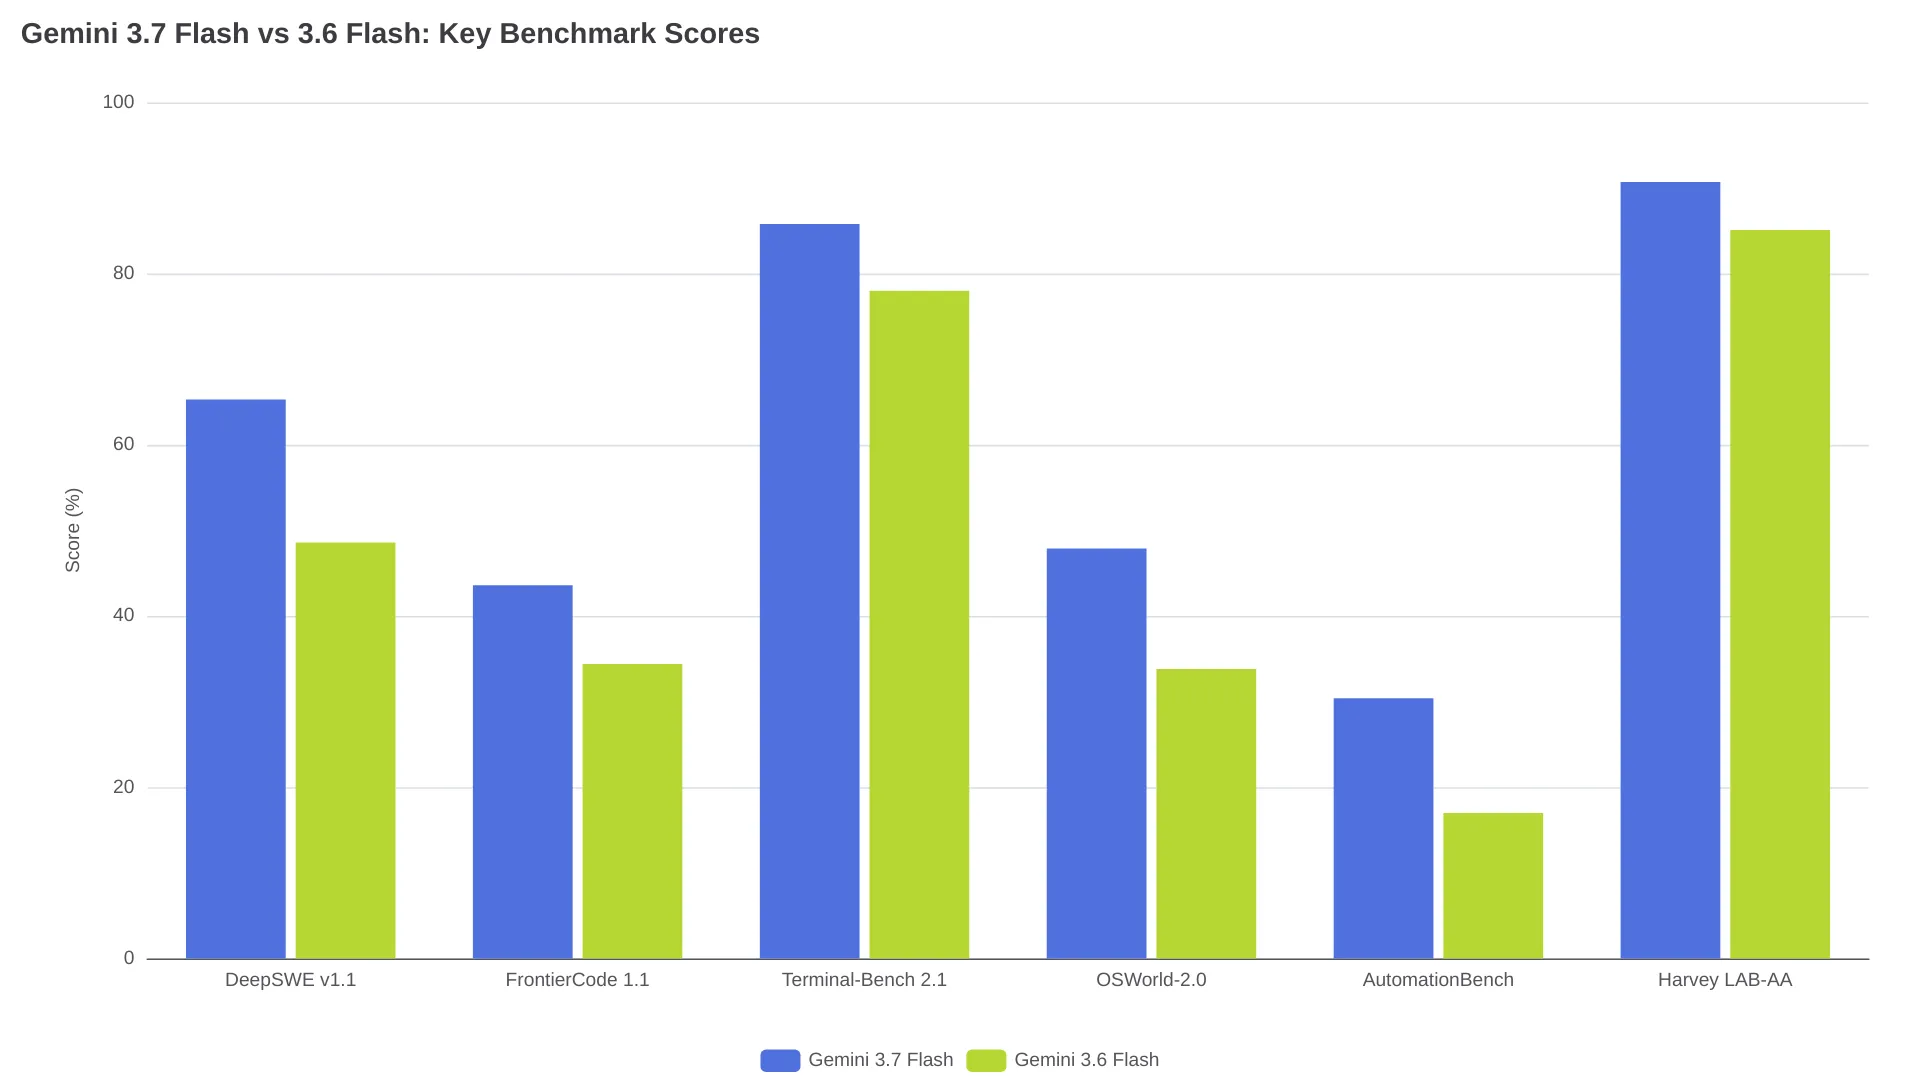
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Écart |
|---|---|---|---|
| Artificial Analysis Intelligence Index (indice composite) | 56 | 52 | +4 |
| FrontierCode 1.1 (qualité du code de production) | 43.6% | 34.4% | +9.2 |
| DeepSWE v1.1 (ingénierie logicielle à long horizon) | 65.3% | 48.6% | +16.7 |
| Code Arena (Elo en développement web) | 1588 | 1538 | +50 |
| Terminal-Bench 2.1 (code en terminal avec agent) | 85.8% | 78.0% | +7.8 |
| Terminal-Bench 3.0 (capacités générales des agents) | 14.9% | 5.4% | +9.5 |
| AutomationBench (automatisation de workflows d'entreprise) | 30.4% | 17.0% | +13.4 |
| GDPVal-AA v2 (Elo pour le travail de connaissance) | 1525 | 1422 | +103 |
| Harvey LAB-AA (workflows juridiques complexes) | 90.7% | 85.1% | +5.6 |
| GDP.pdf (compréhension experte de PDF) | 34.0% | 22.0% | +12.0 |
| CharXiv, sans outils (raisonnement sur graphiques) | 84.5% | 85.2% | −0.7 |
| CharXiv, avec outils | 88.7% | 89.4% | −0.7 |
| LVBench (compréhension de vidéos longues) | 85.4% | 84.2% | +1.2 |
| GDM-MRCR v2, 128k (recherche dans un long contexte) | 97.0% | 91.8% | +5.2 |
| OSWorld-2.0 (utilisation d'ordinateur par agent) | 47.9% | 33.8% | +14.1 |
| Agent's Last Exam (tâches d'agent sur bureau) | 26.3% | 24.2% | +2.1 |
| HLE-Verified (raisonnement expert multidisciplinaire) | 53.6% | 51.2% | +2.4 |
| LABBench2 (tâches de recherche en biologie) | 82.1% | 76.1% | +6.0 |
Toutes ces données sont communiquées par Google DeepMind sur la page de Gemini 3.7 Flash. La plupart de ces benchmarks n'ont pas encore fait l'objet de reproductions indépendantes : considérez donc les écarts comme des indications, et non comme une garantie pour votre charge de travail.
Code et agents : là où 3.7 Flash prend une vraie avance
C'est sur les benchmarks de programmation et d'agents que l'écart est le plus net. DeepSWE v1.1, qui mesure l'ingénierie logicielle à long horizon sur de véritables tâches en dépôt de code, gagne 16,7 points : 65,3 % contre 48,6 %. Sur cette métrique, 3.7 Flash dépasse désormais Claude Sonnet 5 (53,8 %) et se situe entre ce dernier et GPT-5.6 Terra (69,6 %), selon le tableau de benchmarks de DeepMind.
Les autres tests orientés agents vont dans le même sens :
- Terminal-Bench 3.0 (capacités d'agent multi-outils) : de 5,4 % à 14,9 %, soit près du triple
- AutomationBench (automatisation de workflows d'entreprise) : de 17,0 % à 30,4 %
- FrontierCode 1.1 (qualité du code de production) : +9,2 points
- OSWorld-2.0 (utilisation d'ordinateur par agent) : de 33,8 % à 47,9 %
Les premiers retours d'utilisateurs sur Reddit illustrent bien l'écart entre les résultats de benchmark et l'expérience quotidienne des développeurs :
Efficace pour l'implémentation, mais potentiellement moins bon pour la planification, la revue de code et la décomposition de problèmes difficiles.
— Discussion d'utilisateur sur r/google_antigravity
Les retours clients publiés par Google sur la page des modèles DeepMind confortent ce constat. Browser Use indique que « l'agent Gemini 3.7 Flash était 35 % moins cher que 3.6 Flash, avec un taux de réussite observé du cache de prompts supérieur de 8 % et moins d'erreurs d'outils ». Harvey a mesuré un gain de 2,6 points sur le taux de réussite complet de Legal Agent Bench. Nunu.ai a relevé des performances comparables à GPT-5.6-Terra « pour environ la moitié du coût ». Dans les trois cas, les économies sont attribuées à un nombre inférieur d'étapes dans la boucle de l'agent, et non à une remise sur le prix des tokens.
Travail de connaissance et multimodal : des progrès plus mesurés, mais tangibles
Hors programmation, les gains se resserrent. L'Artificial Analysis Intelligence Index passe de 52 à 56, ce qui place 3.7 Flash entre Claude Sonnet 5 (55) et GPT-5.6 Terra (57), d'après le tableau comparatif de DeepMind. L'amélioration hors code la plus marquante concerne la compréhension de documents : GDP.pdf grimpe de 22,0 % à 34,0 %, soit 12 points de plus pour les pipelines qui traitent des documents complexes, des rapports financiers ou des dossiers juridiques. Sur GDM-MRCR v2, qui évalue la recherche dans un contexte de 128K tokens, le score progresse de 91,8 % à 97,0 %.
Harvey LAB-AA, qui évalue des workflows juridiques complexes, passe de 85,1 % à 90,7 %. La compréhension de vidéos longues avec LVBench et les tâches de recherche en biologie avec LABBench2 gagnent toutes deux environ 6 points. Ces progrès comptent pour les usages spécialisés, mais ils ne suffiront probablement pas, à eux seuls, à justifier une migration.
Tarification : le même tarif promotionnel pour les deux modèles
| Modèle | Entrée ($/1M tokens) | Sortie ($/1M tokens) | Tarif standard (à partir du 1er janvier 2027) |
|---|---|---|---|
| Gemini 3.7 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Gemini 3.6 Flash | $0.75\* | $3.75\* | $1.50 / $7.50 |
| Claude Sonnet 5 | $2.00 | $10.00 | — |
| GPT-5.6 Terra | $2.00 | $12.00 | — |
\*Le tarif promotionnel expire le 31 décembre 2026. Tous les tarifs proviennent de la page des modèles DeepMind.
Google a appliqué le tarif promotionnel de 0,75 $/3,75 $ aux deux modèles Flash lors du lancement de 3.7, le 13 août 2026. Auparavant, 3.6 Flash était facturé à son tarif standard de 1,50 $/7,50 $. À compter du 1er janvier 2027, les deux modèles reviendront à 1,50 $/7,50 $, sauf prolongation de la promotion par Google. À prix identique par token, l'écart de coût dépend donc de l'efficacité sur chaque tâche : la réduction de 35 % des coûts d'agent rapportée par Browser Use a été mesurée sur les mêmes charges de travail et s'explique par moins d'appels d'outils et un meilleur taux de réussite du cache, pas par une différence tarifaire.
Pour le détail des coûts de l'API 3.7 Flash, y compris le cache, la Batch API et les frais de grounding, consultez notre guide des tarifs de l'API Gemini 3.7 Flash.
Les rares cas où 3.6 Flash conserve l'avantage
3.6 Flash garde une légère avance en raisonnement sur graphiques. Sur CharXiv sans outils, 3.6 atteint 85,2 %, contre 84,5 % pour 3.7. Avec les outils activés, l'écart reste exactement le même : 89,4 % contre 88,7 %. Ces marges inférieures à un point sont suffisamment réduites pour que les deux modèles se comportent de façon comparable sur des tâches individuelles. Testez-les sur vos propres graphiques avant de choisir votre modèle par défaut.
Aucun autre benchmark du tableau comparatif de Google ne place 3.6 devant 3.7. L'écart sur l'indice d'intelligence, 52 contre 56, est la zone la plus disputée après le raisonnement sur graphiques, mais 3.7 y reste en tête.
Migration : au-delà du simple changement de modèle
Sur le plan mécanique, la migration se résume à remplacer gemini-3.6-flash par gemini-3.7-flash. Selon la page des modèles DeepMind, les deux partagent la même fenêtre de contexte (1M en entrée, 64K en sortie), les mêmes modalités d'entrée (texte, image, vidéo, audio, PDF) et les mêmes capacités d'utilisation d'outils (function calling, search grounding, computer use). La page indique que 3.7 Flash est en disponibilité générale.
Une réserve importante : le passage de 3.5 à 3.6 a introduit des changements silencieux dans le comportement de l'API qui ont surpris les développeurs. Comme l'ont montré des tests indépendants, temperature, top_p et top_k étaient ignorés sans avertissement, thinking_budget est devenu l'énumération sous forme de chaîne thinking_level, et le préremplissage des réponses a été supprimé. Google n'a pas encore précisé si 3.7 Flash introduit des changements comparables. En attendant cette documentation, exécutez votre suite d'évaluation avec les deux identifiants de modèle avant de faire migrer le trafic de production. Gardez 3.6 comme solution de repli.
Faut-il passer à Gemini 3.7 Flash ?
La réponse dépend avant tout de votre charge de travail :
- Passez-y dès maintenant pour les agents de code. DeepSWE v1.1 gagne 16,7 points et Terminal-Bench 3.0 a presque triplé. Au même prix par token, rien ne justifie financièrement de rester sur 3.6 pour des workflows d'agents de programmation.
- Passez-y dès maintenant pour les documents complexes. La compréhension sur GDP.pdf gagne 12 points, de 22,0 % à 34,0 %. La recherche dans un contexte de 128K tokens atteint presque la perfection, à 97,0 %.
- Testez d'abord si le raisonnement sur graphiques est votre usage principal. CharXiv donne un avantage à 3.6 inférieur à 1 point. Faites une évaluation comparative avant de vous engager.
- Restez sur 3.6 si votre pipeline est stable et validé. La page des modèles DeepMind ne mentionne pas de date de retrait pour 3.6 Flash. Si votre workflow passe les tests de régression et que les gains en code ne répondent pas à un besoin immédiat, le coût du débogage des changements de comportement peut dépasser le bénéfice. Migrez un workflow à la fois.
- Tenez compte du rythme des sorties. Google a lancé 3.7 trois semaines après 3.6. Migrez dès maintenant les workflows qui profitent le plus de 3.7, conservez 3.6 comme repli et considérez chaque sortie Flash comme une amélioration incrémentale à évaluer, plutôt que comme un changement de plateforme.
Vous pouvez comparer les deux modèles côte à côte via les interfaces de chat Gemini 3.7 Flash et Gemini 3.6 Flash.
Gemini 3.7 Flash repose-t-il sur une nouvelle architecture ou sur une mise à jour post-entraînement ?
Google n'a pas indiqué publiquement si 3.7 Flash correspond à une nouvelle architecture ou à une mise à jour post-entraînement. L'Artificial Analysis Intelligence Index passe de 52 à 56, tandis que des tests indépendants ont confirmé que 3.5 et 3.6 Flash obtenaient tous deux 50 sur ce même indice. La documentation ne permet pas de déterminer si l'amélioration de 3.7 provient de changements architecturaux ou de meilleures données d'entraînement.
Gemini 3.7 Flash coûte-t-il plus cher que 3.6 Flash ?
Non. Les deux modèles sont facturés 0,75 $ par million de tokens en entrée et 3,75 $ par million de tokens en sortie jusqu'au 31 décembre 2026. Ensuite, ils passeront tous deux à 1,50 $/7,50 $. Les économies liées à la mise à niveau viennent de la réduction du nombre d'appels d'outils et d'étapes de raisonnement nécessaires par tâche, pas d'un prix par token inférieur.
Où Gemini 3.7 Flash est-il disponible ?
Selon la page des modèles DeepMind, 3.7 Flash est disponible via Gemini API, Google AI Studio, Google Antigravity, Vertex AI, Gemini Enterprise et l'application Gemini, avec le statut de disponibilité générale.
Vaut-il mieux attendre la prochaine version de Flash avant de migrer ?
3.7 Flash est un modèle GA, avec des benchmarks publiés et une adoption par des clients. Si votre charge de travail tire parti des progrès en code et en agents, migrez ces workflows dès maintenant, puis réévaluez la situation à la sortie de la prochaine version. Attendre a un coût d'opportunité : vous vous privez de gains déjà disponibles.