 AIREITER
Le 29 juillet 2026, nous avons confié les mêmes quatre tâches à Claude Opus 5 ainsi qu’à GPT-5.6 Sol, Terra et Luna. Résultat : seize réponses, seize réponses correctes. Sur ces quatre vérifications simples, l’exactitude ne permet donc pas de les départager.
En revanche, les écarts sont nets sur deux critères qui ont une incidence directe sur la facture : Opus 5 a comptabilisé 1 642 tokens de sortie, contre 480 pour Sol. Et au-delà de 272 000 tokens en entrée, GPT-5.6 passe sur une grille tarifaire plus élevée, alors que Claude Opus 5 maintient le même tarif sur toute sa fenêtre de 1M. Pour une requête de 200K tokens en entrée et 20K en sortie, les deux modèles phares se tiennent à moins de 7 % au prix catalogue. L’écart se creuse toutefois avec le volume de sortie et après le seuil des 272K : le bon choix dépend donc surtout du profil de vos requêtes et du comportement attendu.
Quatre tâches identiques pour les quatre modèles
Chaque modèle a reçu exactement le même prompt utilisateur pour quatre contrôles aux résultats vérifiables mécaniquement : corriger une fonction Python median boguée, compter les occurrences de lettres dans une chaîne donnée, calculer l’angle de 7,5 degrés affiché par une horloge à 3 h 15, puis refactorer une fonction JavaScript volontairement désordonnée sans en modifier le comportement. Nous avons exécuté les réponses de code sur des cas limites, plutôt que de les évaluer visuellement.
Les quatre modèles ont validé les quatre tests. Toutes les corrections Python géraient correctement les listes de longueur paire ; tous ont répondu 9 et 7,5 lorsque les bonnes réponses étaient 9 et 7,5 ; et les quatre refactorings ont passé un diff comportemental incluant des champs falsy et des filtres de catégorie null.
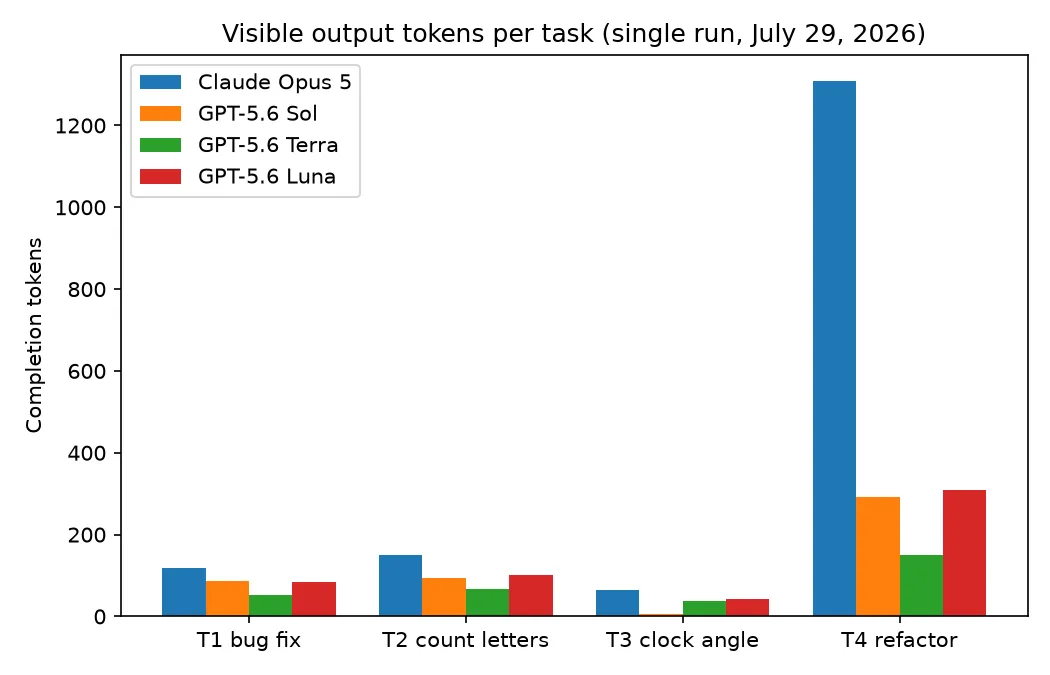
Trois réserves avant de tirer des conclusions de ces chiffres. Il s’agit d’une seule exécution par modèle et par tâche : un test de bon fonctionnement, pas un benchmark. Les appels transitaient par une passerelle qui injecte son propre prompt système ; les tokens d’entrée variaient donc entre 35 et 4 415 selon les requêtes, et nous les avons entièrement écartés. Enfin, les deux éditeurs facturent les tokens de raisonnement invisibles comme des tokens de sortie : ici, « tokens de sortie » désigne ce qui vous est facturé, non ce que vous lisez.
Une observation qualitative demeure malgré cette égalité : Opus 5 a produit le meilleur refactoring des quatre. Il a remplacé les deux boucles d’origine par un seul passage, isolé le multiplicateur de 1,2 dans une constante nommée et ajouté un commentaire précisant que l’égalité souple avait été conservée volontairement afin de préserver le comportement. Sol, Terra et Luna ont tous fourni des versions correctes, mais plus littérales, reposant encore sur deux boucles.
L’écart porte sur les tokens et le temps, pas sur la justesse
Les 16 exécutions ayant abouti au même niveau de correction, la comparaison utile concerne le coût de chaque réponse. Opus 5 a achevé les quatre tâches en 32,4 secondes au total et facturé 1 642 tokens de complétion. Sol a pris 19,7 secondes et 480 tokens ; Terra, 11,7 secondes et 308 tokens ; Luna, 15,3 secondes et 537 tokens.
| Exécution unique, 29 juillet 2026 | Correct | Tokens de sortie | Temps total | Coût de sortie seul |
|---|---|---|---|---|
| Claude Opus 5 | 4/4 | 1 642 | 32,4 s | $0.0411 |
| GPT-5.6 Sol | 4/4 | 480 | 19,7 s | $0.0144 |
| GPT-5.6 Terra | 4/4 | 308 | 11,7 s | $0.0046 |
| GPT-5.6 Luna | 4/4 | 537 | 15,3 s | $0.0032 |
La différence vient du volume de raisonnement, pas de la longueur des réponses finales. Le refactoring d’Opus 5 a facturé 1 308 tokens pour une réponse finale de 492 octets, et le modèle a utilisé 64 tokens pour répondre « 7.5 », là où Sol en a consommé 7. La documentation d’Anthropic précise qu’Opus 5 utilise par défaut un effort élevé via l’API : cet écart relève donc en partie du réglage par défaut, et non d’une caractéristique immuable. Nous avons mesuré le comportement par défaut, pas un minimum incompressible.
Les données de la communauté vont dans le même sens. Un graphique publié sur r/Anthropic, premier résultat Google pour cette requête lors de notre vérification le 29 juillet, place les deux modèles presque à égalité sur les scores de code, tout en montrant qu’Opus prend davantage de temps et consomme sensiblement plus de tokens. Un utilisateur de r/ClaudeCode l’a formulé de façon moins diplomatique :
GPT 5.6 Sol exécute simplement ce que vous lui demandez. Opus 5 écrit « Guerre et Paix » en 12 volumes, puis exécute ce que vous lui demandez.
Les réglages d’effort peuvent néanmoins inverser l’équation économique. Un commentateur sur Hacker News analysant des données d’Artificial Analysis a relevé qu’Opus 5 en effort élevé atteignait environ $1.06 par exécution de l’indice d’intelligence, contre $1.04 pour Sol au niveau max : une quasi-parité lorsque les deux modèles raisonnent intensément.
GPT-5.6, c’est Sol, Terra et Luna
GPT-5.6 ne désigne pas un modèle unique. OpenAI propose trois SKU, et la chaîne simple gpt-5.6 est documentée comme un alias de gpt-5.6-sol, le plus coûteux des trois. Une configuration qui appelle gpt-5.6 est donc facturée au tarif supérieur de la famille : un point à vérifier avant toute comparaison de coûts.
La référence des modèles d’OpenAI présente Sol comme son « modèle frontier pour le travail professionnel complexe », Terra comme l’offre qui « équilibre intelligence et coût », et Luna comme une version « optimisée pour les charges de travail sensibles au coût ». Les trois partagent une fenêtre de contexte de 1,05M tokens, une sortie maximale de 128K, une date de coupure des connaissances fixée au 16 février 2026, ainsi que six niveaux de raisonnement sélectionnables, de none à max.
| Spécification, vérifiée le 29 juillet 2026 | Claude Opus 5 | GPT-5.6 (les trois versions) |
|---|---|---|
| Fenêtre de contexte | 1M tokens | 1,05M tokens |
| Sortie maximale | 128K (300K via Batch API beta) | 128K |
| Date de coupure fiable des connaissances | Mai 2026 | 16 février 2026 |
| Contrôle du raisonnement | Réflexion adaptative, effort réglé par défaut sur high | none / low / medium / high / xhigh / max |
| ID API | claude-opus-5 | gpt-5.6-sol / -terra / -luna |
Deux de ces lignes pèsent réellement dans la décision. La date de coupure des connaissances d’Opus 5, en mai 2026, est postérieure de trois mois à celle de toute la famille GPT-5.6, ce qui compte pour les sujets faisant référence aux sorties du printemps 2026. Les contrôles de raisonnement diffèrent également par nature, et pas seulement en nombre : GPT-5.6 permet de désactiver totalement le raisonnement via none, tandis qu’Opus 5 gère son budget de réflexion de manière adaptative tout en exposant des niveaux d’effort.
Tarifs : une fenêtre plate de 1M face au seuil des 272K
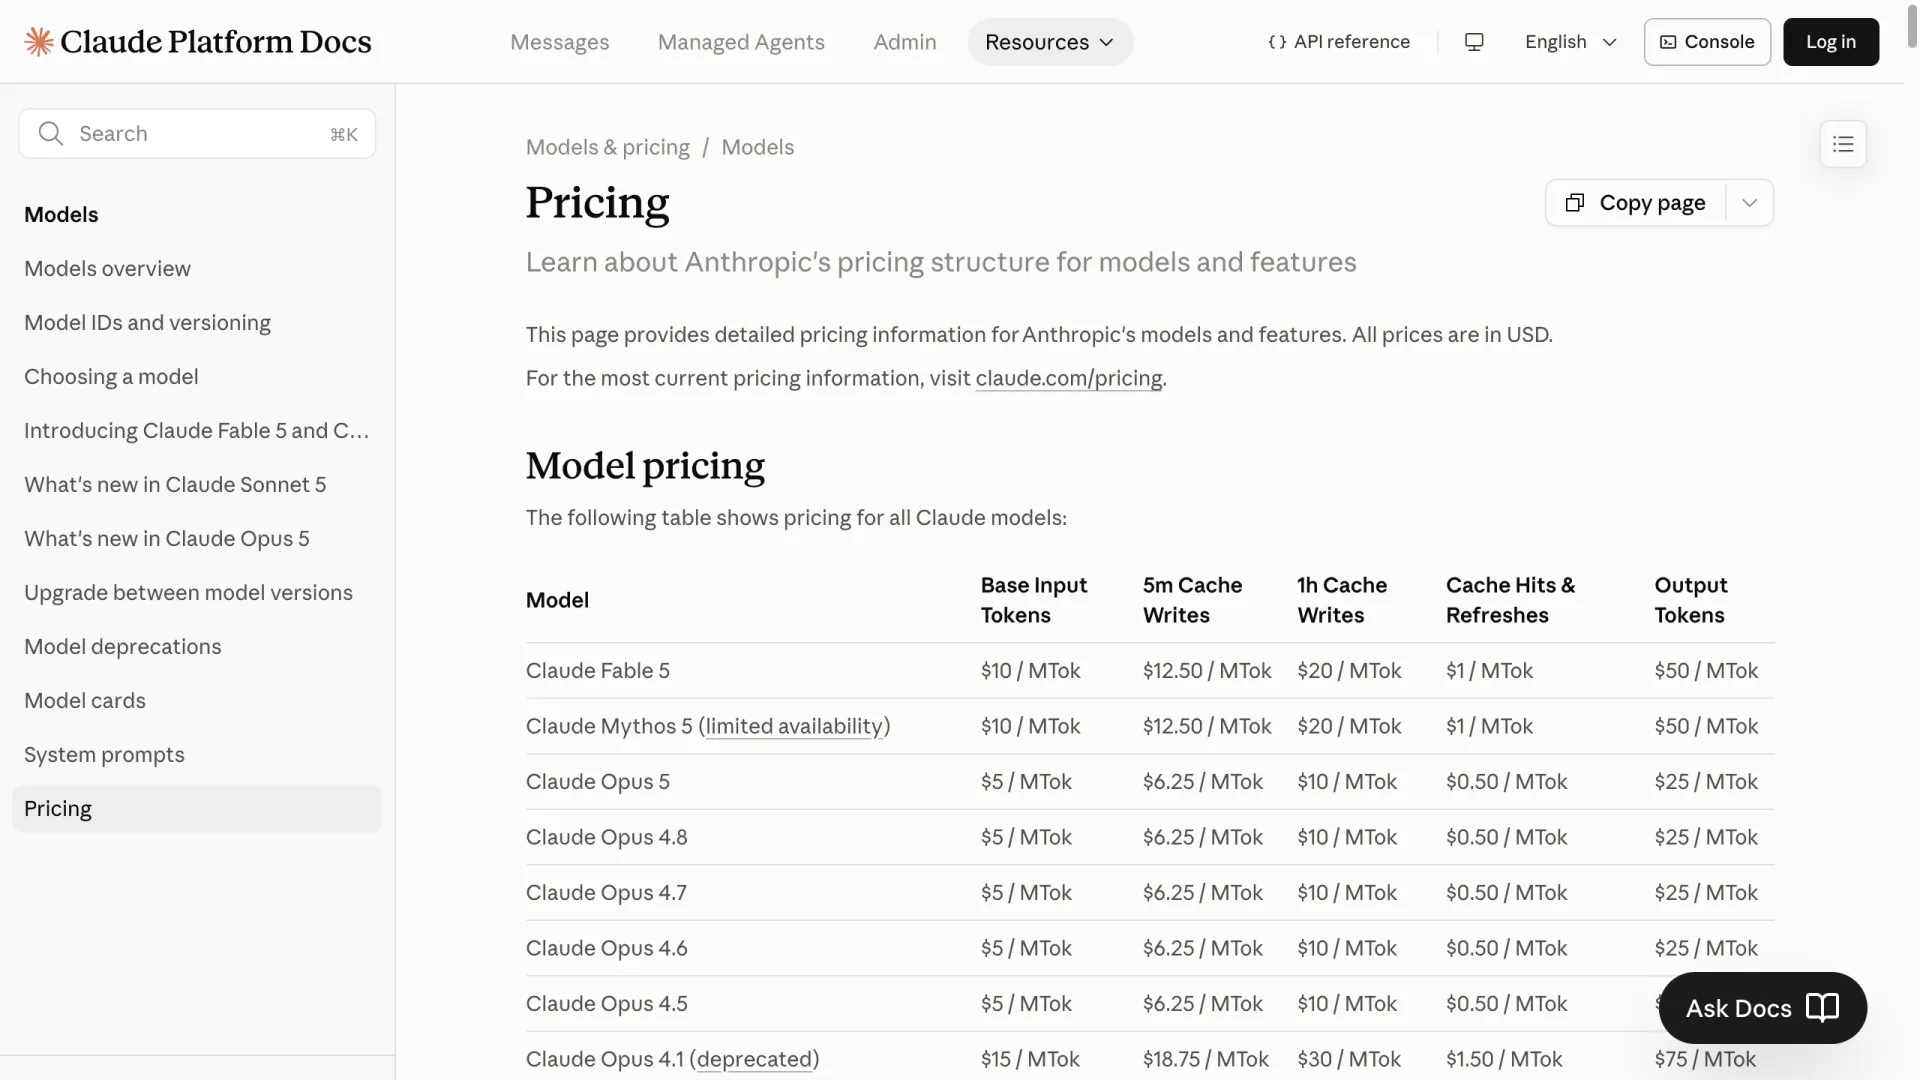
Les deux éditeurs publient des tarifs simples au token et, sous 272K tokens d’entrée, ils sont proches : $5 par million de tokens en entrée pour les deux modèles phares, $25 par million de tokens en sortie pour Opus 5 contre $30 pour Sol, le même tarif de $0.50 pour les entrées mises en cache, et une réduction Batch de 50 % des deux côtés. À ces tarifs, une requête de 200K tokens en entrée et 20K en sortie revient à $1.50 sur Opus 5, contre $1.60 sur Sol.
| Par 1M tokens, prix catalogue au 29 juillet 2026 | Entrée | Entrée mise en cache | Sortie | Batch |
|---|---|---|---|---|
| Claude Opus 5 | $5.00 | $0.50 | $25.00 | $2.50 / $12.50 |
| GPT-5.6 Sol | $5.00 | $0.50 | $30.00 | $2.50 / $15.00 |
| GPT-5.6 Terra | $2.50 | $0.25 | $15.00 | $1.25 / $7.50 |
| GPT-5.6 Luna | $1.00 | $0.10 | $6.00 | $0.50 / $3.00 |
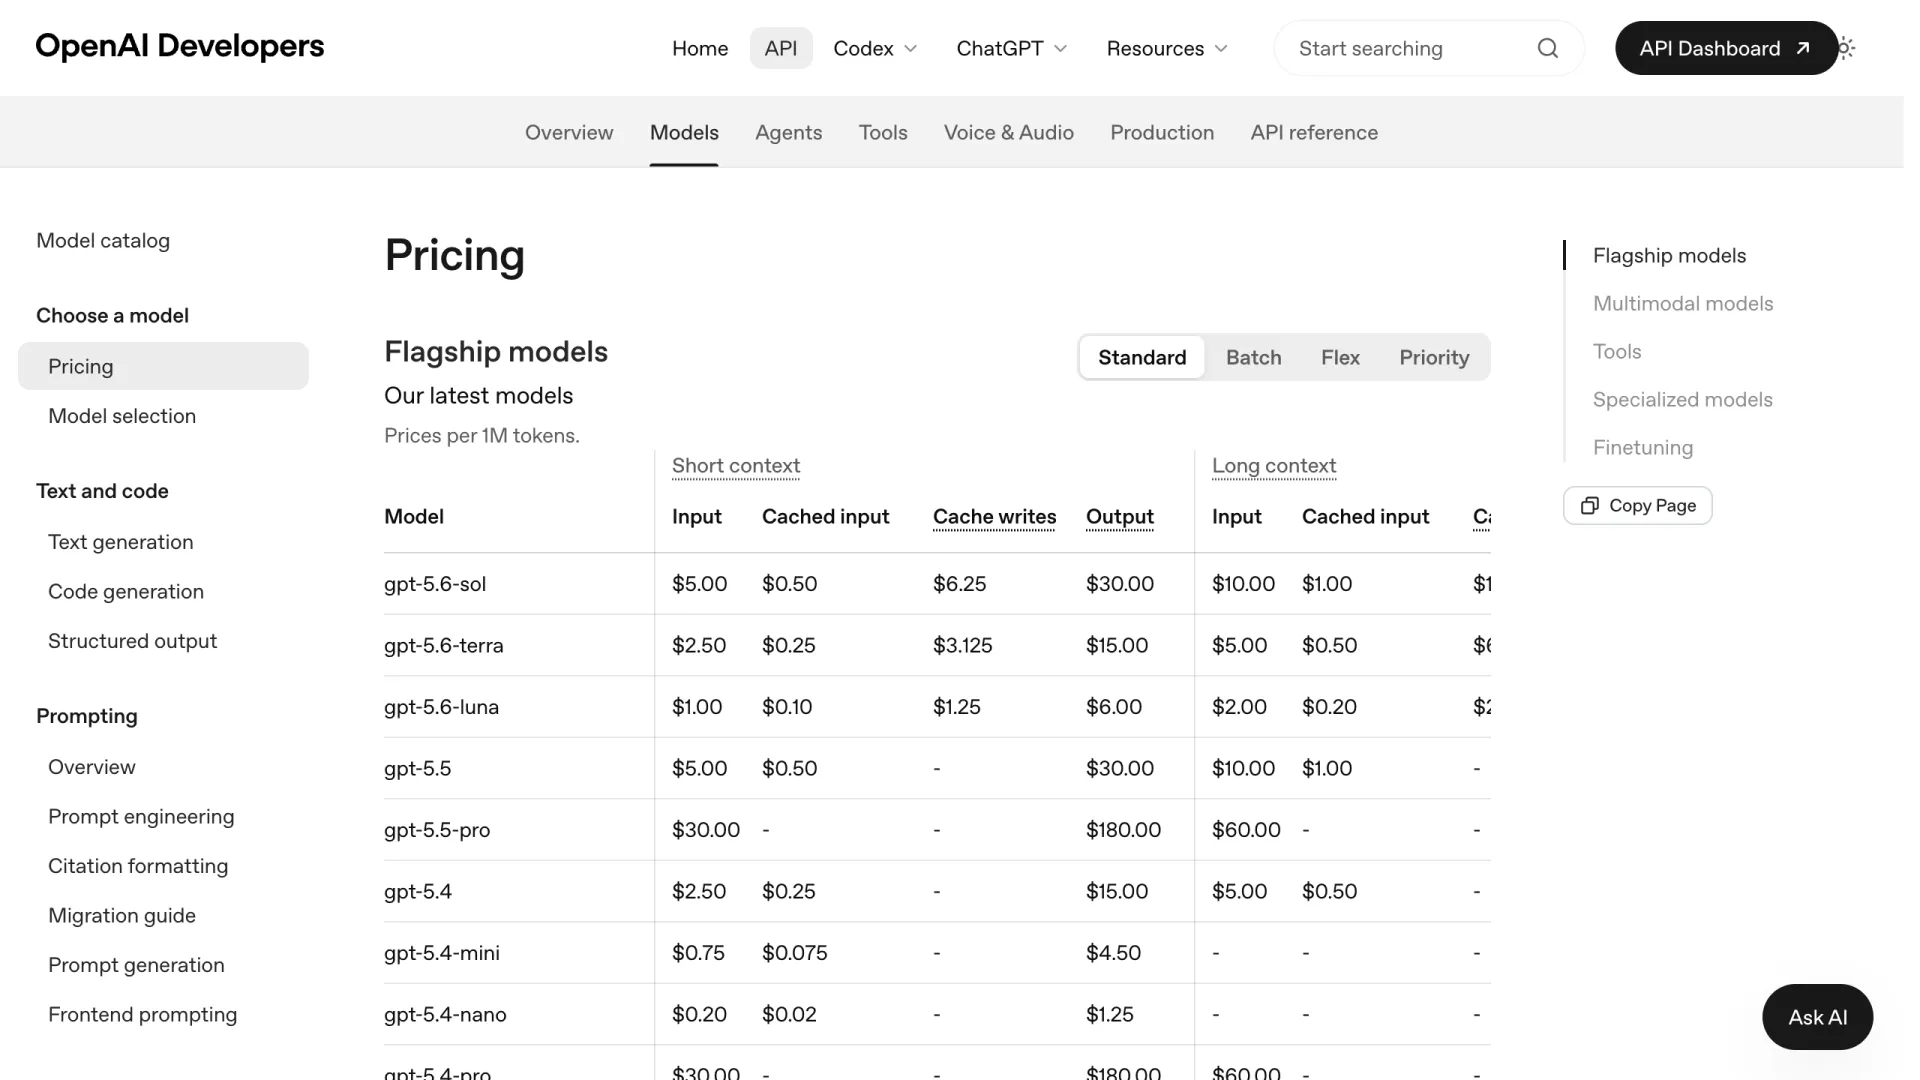
La différence structurelle intervient à 272K tokens en entrée. La page tarifaire d’OpenAI sépare chaque grille GPT-5.6 entre contexte court et contexte long : au-delà de 272K tokens en entrée, le prix de l’entrée est multiplié par 2 et celui de la sortie par 1,5, ce qui porte Sol à $10 et $45. La documentation tarifaire d’Anthropic adopte le principe inverse en une phrase : « A 900k-token request is billed at the same per-token rate as a 9k-token request. »
En dollars, avec 20K tokens de sortie à chaque niveau : une requête de 300K tokens en entrée coûte $2.00 avec Opus 5 et $3.90 avec Sol. À 500K, le coût est de $3.00 contre $5.90 ; à 900K, de $5.00 contre $9.90. Au-delà du seuil, Opus 5 revient à environ la moitié du prix de Sol pour une requête de même profil.
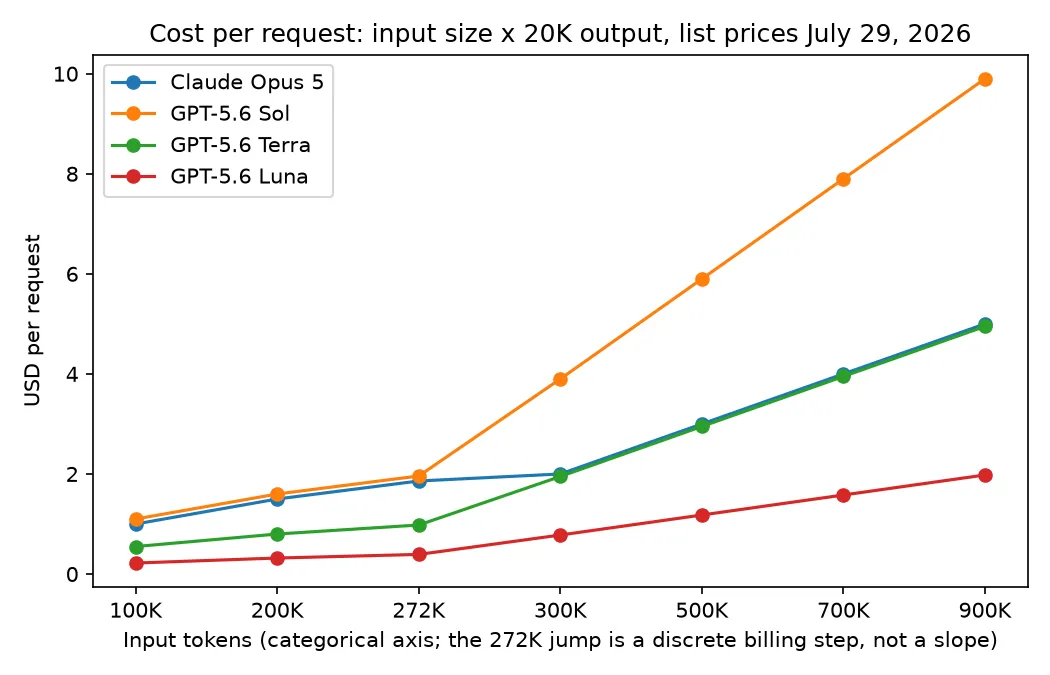
Le graphique réserve toutefois une surprise qui empêche de conclure trop vite en faveur d’Anthropic. Au-delà de 272K, le tarif d’entrée doublé de Terra atteint $5, soit le même prix qu’Opus 5, tandis que son tarif de sortie en contexte long, à $22.50, est inférieur aux $25 d’Opus 5. Avec 20K tokens de sortie, Terra coûte ainsi cinq cents de moins par requête à 300K, 500K, 700K comme à 900K. Ces cinq cents évoluent avec le volume de sortie, pas avec la taille de l’entrée : l’écart est de $2.50 par million de tokens de sortie.
Trois précisions pour la planification budgétaire. Anthropic propose pour Opus 5 un mode rapide en research preview, à $10 en entrée et $50 en sortie ; OpenAI vend une offre priority à deux fois les tarifs standard, uniquement en contexte court. La résidence des données dans la région américaine ajoute environ 10 % chez les deux éditeurs. Enfin, selon une note d’Anthropic, le tokenizer actuel de Claude produit environ 30 % de tokens de plus que les modèles antérieurs à 4.7 pour un même texte. Avant de multiplier les tarifs, le contrôle honnête consiste donc à passer un prompt représentatif dans les deux tokenizers.
Quel modèle choisir selon la charge de travail ?
Puisque les résultats de correction sont à égalité, le routage doit se fonder sur la forme des requêtes et le style de travail. Des développeurs sur r/ClaudeCode utilisent Sol en effort élevé pour la revue et l’assurance qualité, en raison de sa rigueur et de ses bonnes capacités avec un navigateur ; d’autres, sur r/codex, dirigent l’essentiel du travail vers les versions GPT moins chères avec un raisonnement moyen, et y trouvent le meilleur rapport coût-performance.
| Profil de requête | Modèle à appeler | Pourquoi |
|---|---|---|
| Moins de 272K tokens en entrée, boucles d’agents riches en sortie | Claude Opus 5 | $25 contre $30 en sortie ; meilleur jugement de refactoring dans notre exécution |
| Moins de 272K, sensible à la latence ou à fort volume | GPT-5.6 Terra | Le modèle validé le plus rapide et le moins cher de notre test |
| Plus de 272K tokens en entrée | Claude Opus 5 ou Terra | Les tarifs longue fenêtre de Sol doublent ; Terra reste cinq cents sous Opus 5 |
| Revue, QA et vérifications pilotées par navigateur | GPT-5.6 Sol | Six niveaux d’effort pour ajuster la profondeur de revue ; à valider sur votre propre jeu de QA |
| Classification et extraction jetables | GPT-5.6 Luna | $1/$6, avec réussite des quatre vérifications |
Tout le monde ne considère pas Sol comme le meilleur choix pour la QA : un fil sur r/codex le décrit comme une régression par rapport à GPT-5.5, tout en attribuant à Opus 5 davantage de tâches finalisées par plan. Tester les réglages par défaut ne coûte pas grand-chose : les quatre modèles sont présents dans le catalogue d’AIReiter (Opus 5, Sol), ce qui permet de rejouer vos propres tâches côte à côte.
Le seul chiffre à retenir de cette comparaison est 272 000 tokens en entrée. En dessous, choisissez selon le comportement, la latence et l’écart de $5 sur le tarif de sortie. Au-dessus, l’argument prix favorise Anthropic face à Sol, tandis que Terra reste cinq cents moins cher qu’Opus 5 et Luna très en dessous des deux.
FAQ
gpt-5.6 est-il le même modèle que GPT-5.6 Sol ?
Oui. La référence des modèles d’OpenAI indique que la chaîne simple gpt-5.6 est un alias résolu vers gpt-5.6-sol. Elle est donc facturée aux tarifs de Sol : $5 en entrée et $30 en sortie par million de tokens sous 272K tokens en entrée, puis $10 et $45 au-delà.
Claude Opus 5 facture-t-il davantage les requêtes à long contexte ?
Non. Anthropic facture toute la fenêtre de 1M aux tarifs standard via l’API classique, et précise qu’une requête de 900K tokens est facturée au même prix par token qu’une requête de 9K. Seul le mode rapide optionnel applique une majoration, à $10 en entrée et $50 en sortie.
Lequel est le moins cher, Claude Opus 5 ou GPT-5.6 ?
Tout dépend de la version. Sous 272K tokens en entrée, Opus 5 coûte $5 de moins par million de tokens de sortie que Sol, les autres tarifs étant identiques ; Terra et Luna sont beaucoup moins chers que les deux. Au-delà de 272K, Opus 5 revient à environ la moitié du prix de Sol par requête, tandis que Terra demeure légèrement moins cher qu’Opus 5.
Claude Opus 5 est-il meilleur que GPT-5.6 pour le code ?
Lors de notre exécution du 29 juillet, tous les modèles ont correctement corrigé, compté et refactoré. Le graphique publié sur r/Anthropic, premier résultat Google pour cette requête le 29 juillet, les montre presque à égalité sur les scores de code. Opus 5 a fait preuve du meilleur jugement en refactoring, mais a facturé 3,4 fois plus de tokens de sortie que Sol avec les réglages par défaut : le choix pour le code est donc aussi une question d’économie et de verbosité.
Quelles sont les dates de coupure des connaissances d’Opus 5 et GPT-5.6 ?
Anthropic attribue à Claude Opus 5 une date de coupure fiable des connaissances en mai 2026. Les trois modèles GPT-5.6 partagent celle du 16 février 2026, soit environ trois mois plus tôt.