 AIREITER
Anthropic présente désormais Claude Opus 5.5 comme le choix par défaut pour le travail intellectuel sur ses offres payantes. Les résultats vont globalement dans ce sens, mais un point revient sans cesse chez les utilisateurs : sur Pro, Max et Team, le quota s’épuise plus rapidement qu’attendu.
Lancé le 22 septembre 2026 comme premier modèle de la famille Claude 5.5, Opus 5.5 est annoncé par Anthropic au niveau de Claude Fable 5.1 pour la plupart des usages, tout en coûtant 40 % moins cher à exécuter qu’Opus 5 (anthropic.com). Le 12 novembre 2026, le guide d’Anthropic consacré à son usage quotidien a clarifié la stratégie : commencer avec Opus 5.5 au niveau Medium pour la recherche, l’analyse, la rédaction, les rapports, les tableurs et les présentations, puis n’augmenter l’effort qu’en cas de besoin (claude.com). Cet essai recoupe cette documentation, des benchmarks indépendants et des retours sur les quotas ; il ne s’agit pas d’un test de laboratoire réalisé par Anthropic.
Verdict express : gardez Opus 5.5, restez sur Medium
Laissez Opus 5.5 sélectionné et utilisez Medium pour le travail intellectuel courant. Avant de changer de modèle, augmentez l’effort ; basculez vers Sonnet 5.5 ou Haiku 5.5 lorsque la vitesse ou le volume comptent davantage que la qualité du jugement.
Ce choix tient aux chiffres, pas à une préférence de marque. Dans les évaluations d’Anthropic sur le code et le travail intellectuel, Opus 5.5 au niveau Medium a égalé ou dépassé Opus 5 au niveau High. Factory, cité dans le guide daily driver d’Anthropic, a également constaté que Medium atteignait le niveau d’Opus 5 en High avec 20 à 25 % de tokens de sortie en moins. Medium est d’ailleurs le réglage par défaut dans les apps Claude et Claude Code : la plupart des abonnés en bénéficient donc sans modifier le moindre paramètre.
La nuance importante concerne le quota d’abonnement, et non le tarif API. L’API coûte $4 par million de tokens en entrée et $20 en sortie, contre $5/$25 pour Opus 5 ; les lectures de cache sont facturées $0.20 par million. Mais, comme le rappelle le guide daily driver d’Anthropic, les modèles plus coûteux consomment plus vite les limites d’abonnement. Des utilisateurs rapportent des fenêtres de 5 heures vidées en 15 à 30 minutes lors de sessions intensives, ainsi que des plafonds hebdomadaires atteints bien plus tôt que pendant l’euphorie de septembre.
Ce que le changement de modèle par défaut en novembre implique pour Pro, Max et Team
Pour les abonnés, l’enjeu est le fonctionnement des quotas avec ce nouveau réglage par défaut. Au lancement, Anthropic a annoncé relever les limites d’usage sur cinq heures pour les offres Pro, Max, Team et Enterprise avec licences, tout en donnant aux abonnés une réinitialisation de limite enregistrable (anthropic.com), malgré les signalements de fin octobre sur une consommation accélérée détaillés plus bas. Le guide d’Anthropic précise que Fable 5.2 n’est généralement pas inclus dans les limites normales des offres Pro, Team standard et Enterprise avec licences, hors promotions de lancement : Fable puise dans les crédits d’usage. Il faut donc considérer Opus comme le moteur inclus, et Fable comme l’exception facturée à l’usage.
Là où le statut de modèle quotidien se vérifie : recherche, analyse et rédaction
Des notes de recherche qui tiennent face à la vérification de chaque chiffre
Le test le plus exigeant portait sur un rapport sourcé de performance d’entreprise : le communiqué de résultats était volontairement difficile à retrouver, et la moindre donnée ou citation inventée invalidait le rapport entier. Opus 5.5 a réussi 16 rapports sur 18, tous niveaux d’effort confondus ; Anthropic affirme que ni Fable 5.1 ni Opus 5 n’ont franchi ce même seuil lors d’une seule tentative (claude.com). Le contrôle externe de Walleye Capital, également cité dans le billet de lancement d’Anthropic, complète le tableau : Opus 5.5 a largement résolu leur suite au niveau d’effort minimal et, à un niveau supérieur, a détecté une erreur d’indexation à un décalage dans les propres consignes de l’évaluateur — une erreur que Walleye indique n’avoir jamais vu repérée par les modèles précédemment testés.
Au quotidien, cela invite à déléguer les recherches ouvertes avec un livrable défini et des sources jointes, puis à contrôler les chiffres plutôt que de relire chaque tournure.
Analyse : tableurs, calculs de fusion et graphiques denses
Dans le cadre d’une fusion fictive entre deux éditeurs de logiciels RH, Opus 5 et Opus 5.5 ont tous deux produit un modèle Excel et une présentation pour la direction, avec la même conclusion sur l’opération. Opus 5.5 a terminé en 63 minutes contre 93 minutes, a coûté 50 % moins cher selon les données rapportées, a livré un modèle plus complet et commis moins d’erreurs mineures (claude.com). Plus largement sur les flux de travail financiers, Hebbia indique une couverture des critères de 86.6 % pour Opus 5.5 contre 60.3 % pour Opus 5. Rogo indique de son côté avoir dépassé Opus 5 en High sur BigFinance Bench avec environ 60 % de tokens de sortie en moins, selon le billet de lancement d’Anthropic.
La vision s’inscrit dans la même dynamique. Anthropic présente Opus 5.5 comme son meilleur modèle Opus pour l’analyse visuelle — documents denses, valeurs de graphiques, captures d’écran et diagrammes — et indique qu’au niveau d’effort le plus faible, il lit les graphiques complexes plus précisément qu’Opus 5 à son niveau maximal (claude.com). Le score Chartography publié est de 64.4 % sans outils au réglage évalué le plus élevé (claude.com), et de 89.0 % avec outils sur la grille de lancement. Le score Elo GDPval-AA pour le travail professionnel atteint 1846, contre 1735 pour Fable 5.1 et 1708 pour Opus 5 (anthropic.com).
En pratique : demandez directement le tableur finalisé ou le deck de slides, joignez l’image du graphique au lieu de recopier ses valeurs, et indiquez dès le premier message le critère d’arrêt.
Rédaction : des documents et présentations finalisés, pas de simples plans
La promesse sur l’écriture ne se résume pas à un « meilleur style ». Elle porte sur le suivi des consignes et la vérifiabilité. Anthropic affirme qu’Opus 5.5 reste dans le périmètre, commence par les conclusions, emploie moins de jargon, respecte les règles de style fournies et explique ce qu’il a fait, ce qu’il a trouvé et les informations qui lui manquent encore. Les classements indépendants vont dans le même sens : Hayz Labs attribue 100 à Opus 5.5 en rédaction et 100 en code, avec 94 en recherche ; lors de son relevé d’octobre, le site le classait premier pour le WebDev et les agents, et deuxième en écriture créative sur Arena.
La limite à garder en tête : reproduire exactement une charte éditoriale interne demande encore des itérations.
Le niveau d’effort, c’est le vrai levier de coût
Opus 5.5 propose cinq niveaux d’effort — Low, Medium, High, Very High/Extra High et Max — selon le détail des niveaux d’effort d’eesel. La réflexion ne peut pas être désactivée, selon Hayz Labs. Face à ce réglage, le prix unitaire par token pèse relativement peu sur la facture.
Les calculs par tâche rapportés dans le résumé d’eesel des chiffres d’Artificial Analysis estiment une même tâche difficile à environ $0.55 en Low, $1.34 en Medium et $5.98 en Max, pour des scores Intelligence Index proches de 42, 51 et 58. Une exécution en Max peut produire de l’ordre de 119,000 tokens de sortie : à $20 par million de tokens de sortie, c’est là que le coût s’envole. La vue Pareto de Hayz Labs arrive à des ordres de grandeur voisins : environ $1.61 de médiane par tâche agent sur 14 jours ($1.76 de médiane dans le tableau principal), avec High autour de $1.82.
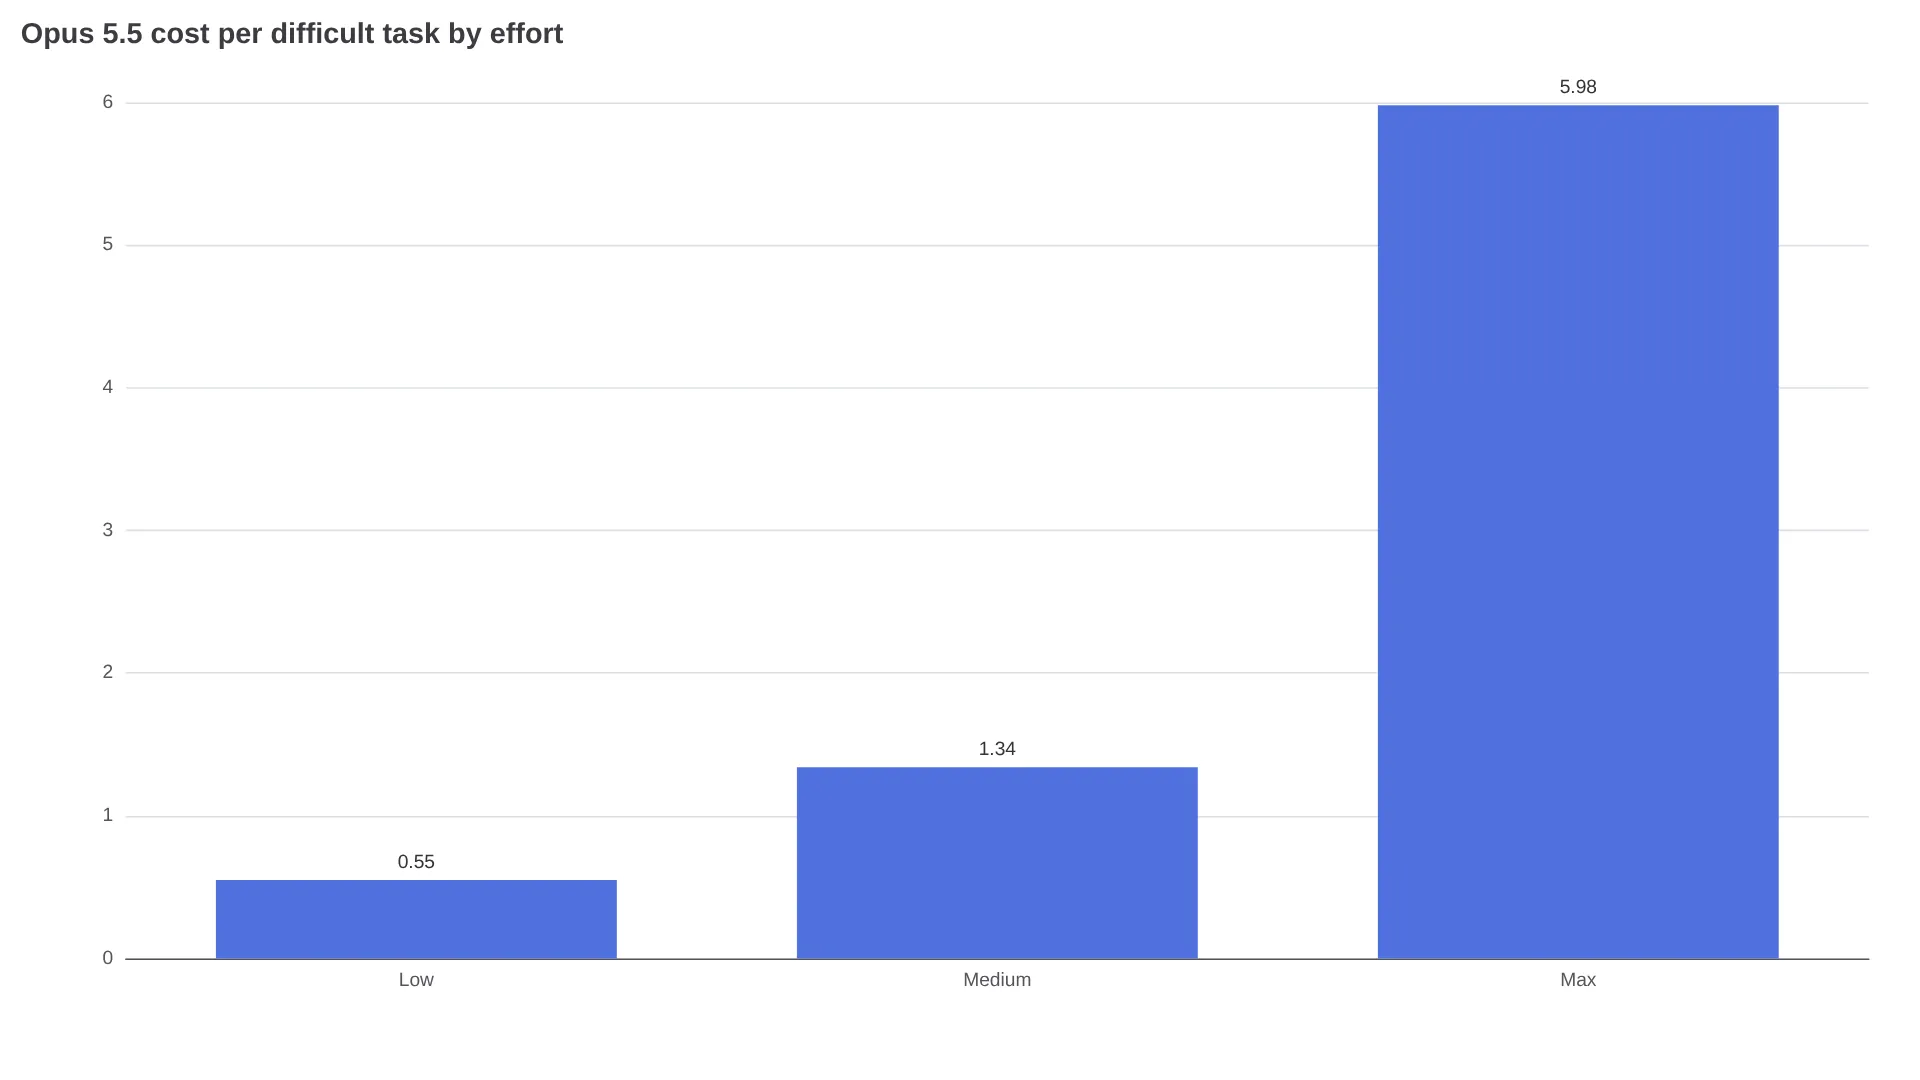
Un effort plus élevé prend davantage de temps et coûte plus cher, sans garantir un meilleur résultat. Anthropic conseille elle-même de retirer des formulations telles que « réfléchis intensément » : le raisonnement est déjà actif, et la profondeur dépend du niveau d’effort comme de la tâche. Ne montez d’un cran que lorsque Medium bloque réellement.
La fenêtre de contexte atteint 1 million de tokens, avec jusqu’à 128,000 tokens de sortie (300,000 en Batch) et une vision native, d’après la fiche technique d’eesel. Il n’existe pas de supplément pour le contexte long, selon l’analyse tarifaire d’eesel, un point important pour les workflows d’audit de documents volumineux.
Quel modèle choisir entre Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.2 ?
Le guide de novembre d’Anthropic et les analyses de coûts indépendantes convergent sur une règle : ajustez d’abord l’effort, changez de modèle ensuite. Les tarifs ci-dessous proviennent du tableau tarifaire du guide daily driver d’Anthropic.
| Modèle | Prix API par 1M (entrée/sortie) | À utiliser pour | Changez lorsque |
|---|---|---|---|
| Haiku 5.5 | $0.10 / $0.50 jusqu’à 100K tokens | Recherches rapides, résumés, tri, tâches ciblées à grand volume | L’analyse s’allonge ou exige davantage de jugement |
| Sonnet 5.5 | $2 / $10 | Tâches claires et bien cadrées, finition de documents, slides à partir d’un brief précis | Vous montez régulièrement à Extra High ou Max |
| Opus 5.5 | $4 / $20 | La plupart des recherches, analyses, travaux financiers et documents finalisés | Medium bloque après une véritable nouvelle tentative en High |
| Fable 5.2 | $8 / $40 | Travail technique ouvert, science, code et finance avec des équipes de sous-agents sur la durée | Le travail intellectuel courant — généralement excessif |
Le seuil à retenir : poussé en Extra High ou Max, Sonnet 5.5 peut coûter presque autant par tâche qu’Opus 5.5 tout en restant moins pertinent sur les tâches de jugement. Des utilisateurs des offres de code décrivent la même mécanique côté abonnement : évitez de laisser Sonnet au-dessus de Medium et passez plutôt la tâche à Opus 5.5 en Low (voir par exemple @cupid25157). Cela correspond à l’échelle officielle « effort avant modèle » et aux calculs de coût par tâche.
Fable représente le plafond, pas un concurrent direct. Dans son fil de novembre sur Fable 5.2, Anthropic réserve Fable et Mythos aux travaux techniques ouverts les plus ambitieux, tout en présentant Opus 5.5 comme le meilleur modèle quotidien pour la plupart des tâches de code et de travail intellectuel (@claudeai). Pour les abonnés, la distinction est encore plus nette : les sièges Pro/Team standard facturent souvent Fable sur crédits. Utiliser Fable sans nécessité peut donc transformer le réflexe du « meilleur modèle » en facture de crédits.
Préserver son quota : pourquoi la fenêtre de 5 heures fond si vite
C’est le point que les benchmarks officiels abordent peu, mais sur lequel les témoignages d’utilisateurs se concentrent. La principale critique ne vise pas les capacités du modèle, mais sa consommation de quota.
« Les limites d’Opus 5.5 se font DÉTRUIRE ce soir !! Plusieurs personnes signalent des quotas sur 5 heures épuisés en SEULEMENT 15 à 30 minutes lors de sessions normales. Les limites hebdomadaires se vident BIEN plus vite » — @TekonBurns, à propos de la consommation lors de sessions Claude Code
Certains décrivent la situation comme la fin brutale de la période de grâce : @kgauravnm écrit que « la phase lune de miel de Claude Opus 5.5 est officiellement terminée », en évoquant un comportement peu impliqué et une consommation hebdomadaire rapide. Des retours sur les sièges Team, comme celui de @ps_ios_dev, décrivent une consommation en Medium qui « file à toute vitesse », y compris après la réinitialisation hebdomadaire gratuite. Il faut toutefois garder une réserve : l’analyse de 67,000 messages de journaux Claude Code menée par @sonuv_dev constate que les appels outils, les taux d’échec et les taux de plaintes sont restés globalement stables — « pratiquement aucune preuve d’un nerf ». Une partie du problème semble donc venir d’un usage par défaut plus intensif et d’un raisonnement plus coûteux, plutôt que d’une dégradation cachée. Le choix du modèle compte aussi au plafond : @mohitsharmadl rapporte un cas où Fable 5.2 en Medium a corrigé des bugs qu’Opus 5.5 en High ne résolvait pas. Utiliser « Opus pour tout » peut ainsi gaspiller du quota sur un modèle qui n’est pas au bon niveau pour la tâche.
Voici une méthode de gestion du quota qui tient compte à la fois des recommandations officielles et des pratiques jugées efficaces par les utilisateurs :
- Réglez tout par défaut sur Opus 5.5 Medium ; considérez High comme une montée en puissance justifiée, pas comme un trait de caractère.
- Répartissez les sous-tâches : Haiku pour la recherche et le tri, Sonnet pour la rédaction cadrée et la finition, Opus pour le jugement, l’audit et la validation finale.
- Ne laissez pas systématiquement Sonnet au-dessus de Medium : comparez le seuil de coût et déplacez plutôt la tâche vers Opus en Low/Medium.
- Joignez les fichiers et connectez les dépôts plutôt que de recoller sans cesse le même contexte ; renvoyer un contexte long ajoute des tokens à chaque tour et augmente l’usage comptabilisé.
- Gardez la réinitialisation de limite pour une vraie semaine d’échéance, au lieu de la dépenser en expérimentations.
- Réservez Fable au créneau où il excelle — projets techniques ouverts, multi-agents et de longue durée — et vérifiez d’abord si votre offre le facture sur crédits.
FAQ : les vraies questions sur l’usage quotidien
Claude Opus 5.5 est-il suffisamment bon comme modèle quotidien ?
Oui, pour les travaux de recherche, d’analyse et de rédaction où le jugement et la vérifiabilité comptent. Hayz Labs le classe premier pour les agents et le WebDev, avec les meilleurs scores en rédaction, tandis que les évaluations d’entreprise citées par Anthropic vont dans le même sens. Gardez toutefois un modèle moins cher à portée de main pour les travaux volumineux.
Opus 5.5 est-il meilleur que Sonnet 5.5 pour le travail courant ?
Oui, pour les tâches ambiguës ou à fort enjeu. Pour les tâches claires, bien cadrées et à gros volume, Sonnet en Low ou Medium est plus rapide — Anthropic classe Sonnet comme Fast contre Moderate pour Opus (claude.com) — et coûte environ la moitié du prix par token. L’erreur consiste à utiliser Sonnet en Extra High ou Max par défaut : l’économie disparaît alors.
Quand utiliser Opus 5.5 plutôt que Fable 5.2 ?
Utilisez Opus pour la plupart des travaux intellectuels et les tâches de code standard. Passez à Fable pour les projets techniques ouverts, de longue durée ou très orientés agents, lorsque Opus en High bloque encore — après avoir vérifié la facturation de votre offre, car les sièges Pro/Team standard imputent souvent Fable aux crédits.
Le contexte de 1 million de tokens est-il fiable pour les documents longs ?
Pour les travaux d’audit avec fichiers joints, il s’agit de la configuration Opus la plus solide qu’Anthropic ait publiée, notamment avec le résultat de 16 rapports sourcés réussis sur 18. Les travaux très longs consomment néanmoins vite le quota d’abonnement : gardez la récupération d’informations sur Haiku et le jugement sur Opus plutôt que de tout faire tourner avec le plus grand contexte.
Le compromis à surveiller
Opus 5.5 est le bon choix par défaut pour le travail intellectuel au niveau Medium. La question ouverte est de savoir si le resserrement des quotas signalé par les utilisateurs fin octobre devient la nouvelle norme ; dans ce cas, une part plus importante de chaque semaine restera sur Sonnet que ne le suggérait la communication de lancement.
À lire aussi : Test des tarifs de Claude Opus 5.5, Test de Claude Opus 5.5 High, Claude Opus 5.5 vs GPT-6.1 Sol.