 AIREITER
Pour faire tourner des agents de code toute la journée, le match Gemini 4 Hydrogen vs Claude Sonnet 5.5 ne se résume ni à un tarif ni à un benchmark. Avec une répartition 50/50 entre entrée et sortie, Hydrogen revient environ 25 % moins cher : 4,50 $ contre 6,00 $ par million de tokens. En revanche, Sonnet 5.5 termine encore davantage de tâches terminal et d’usage informatique sans intervention humaine. Ce qui compte au final, c’est le coût par tâche réellement achevée.
Gemini 4 Hydrogen comme Claude Sonnet 5.5 mettent en avant un contexte de 1M de tokens pour le code rapide et les boucles agentiques. Hydrogen se distingue avec quatre niveaux de réflexion réglables.
Passer de Sonnet 5.5 à Hydrogen : ce qui change vraiment
Pour une équipe qui lance 200 tâches d’agent par jour, le changement se voit à deux endroits : sur la facture et dans le nombre d’interventions nécessaires. Hydrogen réduit le coût au token et atteint environ 198 tokens par seconde, contre 144 pour Sonnet 5.5, dans l’échantillon indépendant de vitesse de LLM Leaderboard. C’est le profil de l’exécutant de masse : brouillons rapides, lectures parallèles de fichiers et correctifs courts.
Sonnet 5.5 joue davantage le rôle du finisseur méticuleux. Dans le tableau de lancement de Google, il devance Hydrogen sur les trois benchmarks les plus orientés terminal et usage informatique — Terminal-Bench 4.1, OSWorld 2.1 et Terminal-Bench-Science — détaillés plus bas. Or ce sont précisément les scénarios où un agent doit se remettre d’une commande ratée plutôt que rester bloqué.
Les échanges sur Reddit au lancement reflètent la même opposition à l’échelle des tâches :
"hydrogen is alright but honestly i don't feel it's better than sonnet 5.5." — u/FewKey5274 sur r/GeminiAI
Ce fil ne constitue pas un benchmark de code contrôlé : il faut le prendre comme un signal de prudence. Une victoire sur une tâche isolée ne prédit pas les performances d’un harness de bout en bout. Testez les deux modèles sur le même workflow avant toute migration.
4,50 $ contre 6,00 $ : la facture ne s’arrête pas là
Les tarifs API officiels sont simples. D’après l’annonce de Google, Hydrogen coûte 1,50 $ par million de tokens en entrée et 7,50 $ par million en sortie, sans variation sur toute la fenêtre de contexte. Sonnet 5.5 coûte 2,00 $ par million de tokens en entrée et 10,00 $ en sortie, selon la tarification d’Anthropic et la comparaison d’OpenRouter.
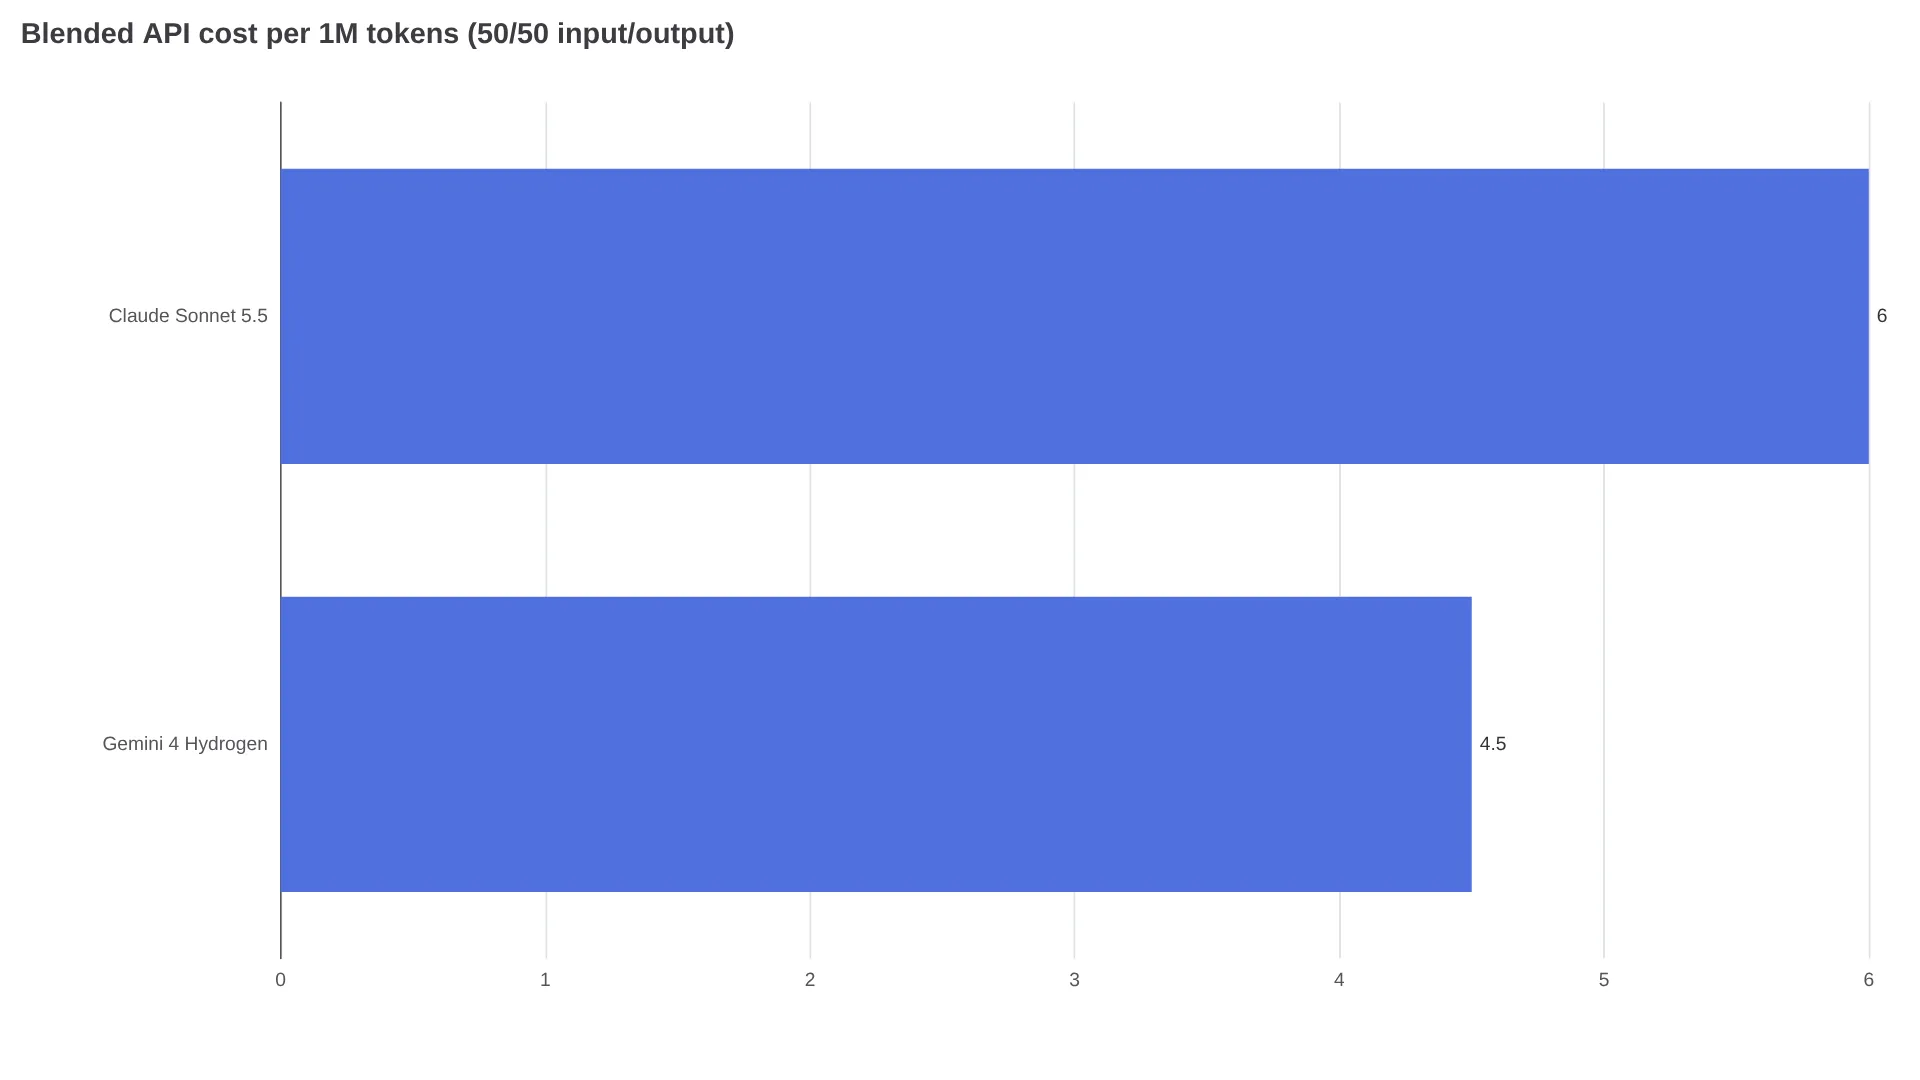
Avec un calcul mixte à 50/50 — 500K tokens en entrée et 500K en sortie — Hydrogen revient à 4,50 $ par million, contre 6,00 $ pour Sonnet 5.5. L’écart de 25 % est bien réel, mais trois éléments déterminent si vous en profitez réellement :
- Les agents qui produisent beaucoup amplifient l’écart. Les boucles agentiques avec de longues traces de raisonnement pèsent davantage sur la sortie : la remise de 2,50 $ par million de tokens de sortie de Hydrogen y compte donc plus.
- Le cache et les tarifs Batch ne sont pas inclus. Les lectures de prompt cache et les remises Batch API d’Anthropic peuvent faire varier la facture réelle de plusieurs pourcents ; LLM Leaderboard précise que le caching explicite n’était pas pris en charge dans son échantillon de vitesse pour Hydrogen.
- Un exemple chiffré permet de garder les pieds sur terre. Pour un tour d’agent moyen de 10K tokens en entrée et 3K en sortie, à raison de 1 000 tours par jour, cela représente 10M de tokens en entrée et 3M en sortie : environ 37,50 $ par jour avec Hydrogen, contre 50,00 $ avec Sonnet 5.5 aux tarifs catalogue. Sur 22 jours ouvrés, l’écart atteint environ 275 $ par mois et par agent concurrent, avant les nouvelles tentatives.
Ce sont justement les retries qui désignent le vrai vainqueur. Le coût par tâche terminée correspond au coût en tokens par tentative divisé par le taux de réussite, auquel s’ajoute le temps de correction humaine. À titre purement illustratif, une journée Hydrogen à 37,50 $ avec 80 % de réussite au premier passage coûte environ 46,90 $ par 1 000 tâches terminées, uniquement en tokens ; une journée Sonnet à 50,00 $ avec 95 % de réussite revient à environ 52,60 $. L’écart se resserre vite lorsque les taux de réussite divergent : suivez le taux de merge au premier passage pendant deux semaines plutôt que de vous fier au tableau d’un fournisseur.
Les benchmarks opposent des métiers, pas un vainqueur absolu
Le tableau de lancement de Google, également repris dans la model card de DeepMind, compare Hydrogen, Sonnet 5.5 et GPT-6.1 Terra sur dix évaluations. Hydrogen devance Sonnet 5.5 dans sept cas sur dix ; Sonnet 5.5 mène dans les trois autres. Les résultats fournisseur utilisent les harnesses de chaque partie, tandis que les lignes indépendantes proviennent de réexécutions par LLM Leaderboard.
| Famille de tâches | Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|---|
| Code sur dépôt | SWE-sweep (fournisseur) | 13.5% | 3.1% |
| Code sur dépôt | Terminal-Bench 4.1, ajusté contre la triche (fournisseur) | 57.0% | 63.9% |
| Automatisation des connaissances | Agents' Last Exam v1.1 (fournisseur, sensible au harness) | 71.6% | 60.4% |
| Automatisation des connaissances | AutomationBench-AA (fournisseur) | 76.1% | 71.8% |
| Automatisation des connaissances | Vending-Bench 2, solde final (fournisseur) | $14,549 | $11,165 |
| Usage informatique | Sous-ensemble hors ligne OSWorld 2.1 (fournisseur) | 77.6% | 83.9% |
| Multimodal | MKA Climb WSR (fournisseur ; indépendant 49.52%) | 53.4% | 52.0% |
| Multimodal | Chartography (provenance mixte) | 66.6% | 61.6% |
| Science | Terminal-Bench-Science 0.1 (fournisseur ; indépendant 49.52%) | 51.4% | 59.9% |
| Raisonnement | HLE-Diamond (indépendant xhigh) | 58.8% | 53.3% |
Les appels d’outils font ou défont un agent
Les benchmarks notent des réponses. Dans la pratique, un agent vit au rythme de ses appels d’outils : regrouper les lectures, appeler la bonne fonction et se rétablir lorsqu’une recherche ne renvoie rien ou qu’une commande échoue.
Google indique que Hydrogen regroupe les lectures de fichiers et les recherches en parallèle au lieu d’inspecter les fichiers un à un, et qu’il cible ses modifications dans un dépôt sans réécrire des fichiers sans rapport. Les retours de partenaires cités dans le billet de lancement évoquent des travaux sur graphes et SQL 2x à 2.8x plus rapides, avec 12 % à 23 % de tokens en moins que Gemini 3.8 Flash, ainsi qu’une exécution 2.5x plus rapide avec le raisonnement high par défaut. Ce sont des chiffres de partenaires sélectionnés par le fournisseur : ils donnent une direction, pas une garantie.
Le contrepoint, c’est la maturité du harness. Dans le fil Claude Code vs Antigravity, des utilisateurs signalent des problèmes de disponibilité d’Antigravity et l’absence de briques de workflow, comme SSH, les hooks réutilisables, les skills et les sous-agents. Il s’agit d’un ressenti d’utilisateurs pendant la semaine de lancement, pas d’une mesure contrôlée, et cela concerne le harness plutôt que les poids du modèle.
Avant de déplacer un agent de production, vérifiez trois points : la fiabilité des appels d’outils parallèles avec votre nombre de serveurs MCP, le taux de récupération après un échec dans bash ou le navigateur, et le respect des limites d’autorisation. Les tests internes de Google annoncent jusqu’à 81 % de dépassements agentiques en moins, 79 % de sous-service en moins et 96.7% d’honnêteté dans son évaluation de l’honnêteté des agents. Validez-le avec votre propre canari de 50 tâches incluant des actions bloquées et des recherches sans issue.
Niveaux de réflexion : high par défaut, xhigh à réserver
Hydrogen propose les niveaux low, medium, high et xhigh, avec high activé par défaut. D’après le tableau des niveaux de réflexion de Google, l’Artificial Analysis Intelligence Index v5.0.1 passe de 27 à 41, puis 51 et 54 entre low et xhigh ; le niveau high par défaut (51) devance Argon (50). Sur Terminal-Bench 4.0, le même tableau donne 54.0% à high, devant les 53.5% de xhigh. À l’inverse, AutomationBench-AA (de 60.5% à 76.1%) et HLE-Diamond (de 32.2% à 58.8%) progressent régulièrement.
Pour les boucles d’agents, la règle est simple : démarrez en high et ne passez une tâche isolée en xhigh que lorsque le raisonnement bloque réellement — analyse, synthèse, recherche multi-documents — puis mesurez le surcoût en tokens. Selon la model card de DeepMind, Hydrogen peut consommer davantage de tokens aux niveaux de réflexion élevés. Sa date de coupure des connaissances est mars 2026 : pour les tâches sensibles à l’actualité, il faut donc une couche de retrieval dans tous les cas.
Avant de migrer, mettez le harness à l’épreuve
Selon la model card de DeepMind, Hydrogen offre un contexte de 1,048,576 tokens et jusqu’à 64K tokens de sortie synchrone, ou jusqu’à 1M via un long décodage en arrière-plan. D’après la documentation d’Anthropic, Sonnet 5.5 accepte 1M tokens en entrée et produit jusqu’à 128K tokens en sortie. Les fenêtres annoncées semblent équivalentes, mais le vrai sujet pour les gros dépôts est la compaction : demandez ce qu’il reste après 50 tours, pas ce qu’affiche la fiche technique.
| Gemini 4 Hydrogen | Claude Sonnet 5.5 | |
|---|---|---|
| Contexte / plafond de sortie | 1,048,576 tokens en entrée ; 64K en sortie synchrone (1M en décodage en arrière-plan) | 1,000,000 tokens en entrée ; 128K en sortie |
| Où il fonctionne | Gemini API, AI Studio, Antigravity, Gemini app, selon Google | Claude API, Bedrock, Vertex AI, Microsoft Foundry, selon Anthropic |
Le fil Antigravity vs Claude Code fait de la stabilité du harness un risque de migration plus important que la qualité du modèle : les utilisateurs s’interrogent sur la survie après compaction, la persistance des quotas et la disponibilité. Lancez le même dépôt, le même commit, le même prompt et les mêmes tests d’acceptation dans les deux harnesses, puis comparez les tâches terminées par fenêtre d’abonnement et le taux de merge au premier passage.
Choisir en 60 secondes : trois profils d’agents
Il n’existe pas de vainqueur universel. Voici un jugement éditorial fondé sur la répartition des benchmarks ci-dessus, et non sur un essai mesuré : orientez l’exécution parallèle et répétitive vers Hydrogen, et les tâches longues où la récupération est critique vers Sonnet 5.5. Les couples planificateur-exécutant d’un même fournisseur conservent des mécanismes d’authentification et de compaction cohérents ; associer un planificateur Claude à un worker Hydrogen ne mérite d’être testé qu’après avoir établi une base de référence mono-fournisseur.
| Votre agent | Choix | Pourquoi (niveau de preuve) |
|---|---|---|
| Exécutant à gros volume : correctifs en masse, boilerplate, préparation de données, triage multimodal | Hydrogen en high | Avantage dans les benchmarks fournisseur sur AutomationBench, Agents' Last Exam et Vending-Bench ; échantillon de vitesse indépendant à ~198 contre ~144 tok/s |
| Finisseur longue durée : débogage très orienté terminal, automatisation OS/navigateur, outils scientifiques | Sonnet 5.5 | Avantage dans les benchmarks fournisseur sur Terminal-Bench 4.1, OSWorld 2.1 et Terminal-Bench-Science ; appréciation de l’écosystème autour des hooks et sous-agents de Claude Code |
| Assistant de synthèse pour la recherche : documents longs, graphiques, audio/vidéo, analyses poussées dans Sheets | Hydrogen en high, xhigh pour les passes les plus difficiles | Avantage fournisseur sur HLE-Diamond, Chartography et MKA ; réserve : la réexécution indépendante de MKA descend à 49.52% |
Hydrogen est-il réellement plus rapide que Sonnet 5.5 ?
Le débit est à l’avantage de Hydrogen dans l’échantillon de LLM Leaderboard, avec environ 198 contre 144 tokens par seconde. Mais le flux p50 en direct d’OpenRouter donne l’avantage à Sonnet 5.5 en latence : 2.08s contre 6.92s de médiane. Le fournisseur, la région et la charge étant différents, mesurez les deux sur votre propre fournisseur.
Hydrogen peut-il remplacer Sonnet 5.5 dans Claude Code ?
Pas par un simple changement d’identifiant de modèle. Sonnet 5.5 fonctionne nativement dans Claude Code, où les équipes s’appuient sur les hooks, les skills et les sous-agents ; Hydrogen passe par Gemini API, AI Studio, Antigravity et l’application Gemini. Le remplacer implique donc de migrer de harness.