 AIREITER
Generar 38,5 segundos de audio en 2,81 segundos, de forma local y sin pagar una factura en la nube, es el reclamo que acompaña ahora a ZONOS3-Mini, el modelo de texto a voz de Zyphra. Se publicó el 9 de noviembre de 2026, tiene 800 millones de parámetros en total y utiliza solo unos 100 millones en cada paso gracias a su arquitectura de mezcla de expertos. Pero hay una salvedad importante: las primeras demostraciones se hicieron en inglés y con hardware potente. El texto, el idioma y la GPU determinarán si en tu equipo puedes acercarte a esas cifras.
Qué es ZONOS3-Mini y cómo puedes ejecutarlo
ZONOS3-Mini es un modelo de texto a voz de Zyphra con clonación de voz zero-shot: le das un texto y un breve fragmento de referencia, y lo reproduce con esa voz. También puedes elegir entre 27 voces predeterminadas y modificar su edad, acento y textura. Los pesos usan licencia Apache 2.0 y el código de ejecución, MIT, por lo que se permite su uso local y comercial. Eso sí, clona únicamente voces que sean tuyas o para las que tengas autorización.
Por dentro encontramos una arquitectura MoE dispersa con 64 expertos y enrutamiento top-2, además de 11 capas que combinan, en una proporción de 3:1, Gated DeltaNet y atención global. El modelo estrena el códec de audio Zyphra Audio Codec 1 (ZAC-1), que funciona a 15 fotogramas por segundo frente a los 86 Hz del DAC utilizado por ZONOS2. Según Zyphra, este cambio reduce los tokens de voz de 774 a 150 por segundo y, con datos equivalentes, consigue una tasa de error de palabras aproximadamente 10 veces menor que DAC.
Entre sus especificaciones destacan la salida a 44,1 kHz, generaciones de hasta 10 minutos, referencias para clonación directa limitadas a 60 segundos y referencias para clonación mediante embedding de hasta 120 segundos. El entrenamiento se realizó con 112 GPU NVIDIA H100 durante 2,5 días.
Hay cinco formas de utilizarlo:
- Un playground WebGPU en el navegador, sin instalación
- Una aplicación nativa en C++/ggml para CPU, CUDA, Metal o Vulkan
- Un servidor Apple MLX
- SGLang o vLLM en servidores NVIDIA
- La API alojada de Zyphra, en
zyphra/zonos3-mini, mediante un endpoint compatible con OpenAI:/v1/audio/speech
Las cifras de latencia del fabricante hablan de menos de 570 ms hasta el primer audio en un navegador de Pixel 9 y menos de 150 ms en un MacBook Air M3. En un H100 con SGLang, la mediana se sitúa entre 57 y 80 ms, con un rendimiento máximo de hasta 457 segundos de audio por segundo. Conviene tomar las cifras del teléfono y del portátil como escenarios ideales. En su propio hilo de lanzamiento, Zyphra citó valores más conservadores: menos de 800 ms y menos de 450 ms en esos mismos dispositivos. Prueba tu hardware antes de prometer resultados similares.
Los materiales de lanzamiento también dejan dos cuestiones sin resolver. El artículo técnico habla de 800 millones de parámetros totales, mientras que la página del modelo indica 886 millones. Además, ninguno de los dos documentos explica cómo funcionan la marca de agua, los controles contra usos indebidos o la conservación de las voces de referencia subidas.
Empieza en el navegador antes de instalar nada
El playground del navegador ejecuta la inferencia en tu propia GPU mediante WebGPU, sin servidor ni instalación. La parte menos visible llega en la primera visita: un probador temprano afirmó que la página descarga unos 920 MB entre el modelo y el códec antes de generar nada. Después, el navegador guarda esos archivos en caché.
Como primera toma de contacto, el playground es difícil de superar: prueba la clonación y el control por fragmentos, y compara la latencia en el dispositivo más limitado que tengas previsto utilizar. WebGPU puede comportarse de forma muy distinta según el navegador, los controladores y la GPU.
"¡No deis por muestro el TTS en la nube cada vez que un modelo pequeño funciona en un navegador! La compatibilidad de WebGPU entre navegadores y controladores está llena de problemas. ¡Que una demo en inglés funcione bien no dice nada sobre si vuestro texto de producción dará la talla!" — @GKev1n, usuario real que recomienda no sustituir un TTS alojado basándose únicamente en una demo
Si tus usuarios utilizan teléfonos antiguos, gráficos integrados o navegadores que no estén basados en Chromium, no extrapoles la cifra del Pixel 9 sin hacer tus propias pruebas.
Qué ofrece: clonación sin transcripción y control palabra por palabra
- Clonación zero-shot: hasta 60 segundos de audio de referencia, sin necesidad de transcripción. El modo de fragmento original ofrece el resultado más natural, mientras que el embedding de voz permite reutilizarlo y modificarlo después.
- Diseño de voz: puedes fijar una edad aproximada, llevar la presentación de masculina a femenina, elegir entre acentos estadounidense, británico y australiano, y combinar rasgos como suave, ronca, brillante o grave.
- Control de la interpretación: ajusta ritmo, emoción, proyección, vivacidad, activación y susurro, incluso por fragmentos de palabras. Por ejemplo, puedes hacer que solo susurre "I didn't say" y mantener neutra el resto de la frase.
- Edición tras la generación: un modelo al estilo de VoiceCraft cambia palabras después de generar el audio sin alterar la voz ni los ajustes. Un nombre mal pronunciado no obliga a renderizar de nuevo toda la frase.
La advertencia de Zyphra se aplica a todas estas funciones: los valores de emoción e interpretación son objetivos, no garantías. Además, ajustar el ritmo puede modificar también el volumen y el tono, mientras que la vivacidad puede cambiar el tono y la duración.
Pruebas de hardware publicadas: velocidad, VRAM y dos problemas en Windows
| Configuración | Resultado medido | Fuente |
|---|---|---|
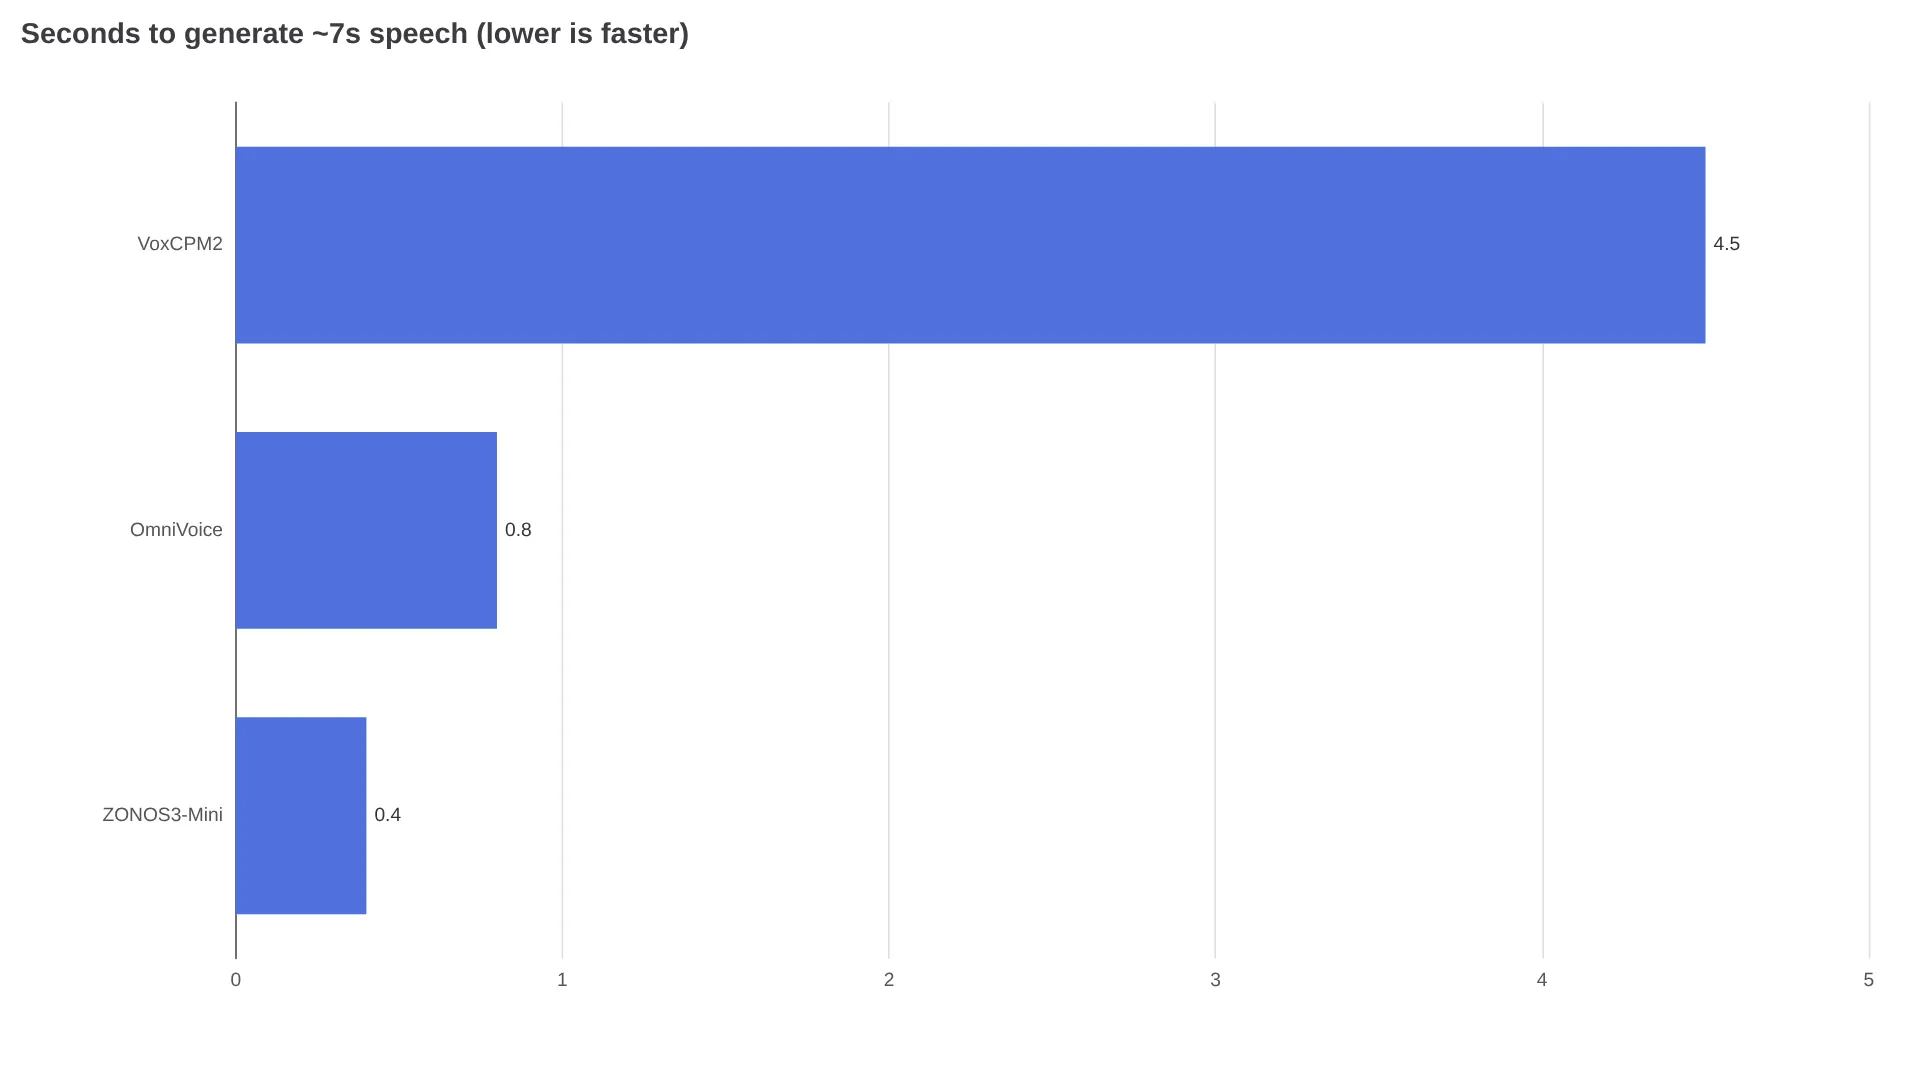
| RTX 5080, ggml cuantizado (0,66 GB para el backbone + 0,45 GB para el decodificador) | ~7,1 s de voz en japonés en 0,40 s; 2,4 GB de VRAM total: un factor de tiempo real de 0,056, aproximadamente 18 veces más rápido que el tiempo real | prueba de VRAM16 |
| El mismo equipo: pasaje de 31 s; fragmento de 7,2 s solo con CPU | 1,50 s a 2,5 GB en GPU; la CPU necesitó 1,45 s de cálculo (2,38 s desde el lanzamiento hasta el final) | prueba de VRAM16 |
| Mac mini M5 Pro de 64 GB, servidor MLX | 38,5 s de audio en 2,81 s; entre 75 y 100 ms hasta el primer audio; ~16 GB de pico al clonar por primera vez | @pratikg |
El resultado de la GPU es aproximadamente el doble de rápido que la medición anterior de OmniVoice realizada en la misma prueba y queda muy por delante del factor 0,63x registrado para VoxCPM2.
El decodificador completo de 2,2 GB elevó el consumo hasta 4,2 GB, aunque el probador no pudo confirmar ninguna diferencia audible. Las transcripciones realizadas con Whisper large-v3 coincidieron con el texto previsto en japonés e inglés. Eso demuestra inteligibilidad, pero no permite sacar conclusiones sobre naturalidad o similitud con la voz de referencia.
El informe local más rápido procede de un probador con Apple Silicon que utilizó un Mac mini M5 Pro de 64 GB y el servidor MLX:
"PROBADO: ... funciona hasta 13,7 veces más rápido que el tiempo real. Lo he probado en mi Mac mini M5 Pro de 64 GB, completamente en local y usando su servidor MLX: unos 75-100 ms hasta el primer audio (TTFA) con las voces predeterminadas. Generó un clip de audio de 38,5 s en 2,81 s. Cloné una voz nueva a partir de un clip de audio de 11-13 s, que empezó a hablar después de unos 1,3 s. ... WER del 0-4 %. Solo utilizó unos pocos GB de memoria (~16 GB de pico durante la clonación inicial de la voz)." — @pratikg, usuario real con datos y notas publicados
Hay un detalle importante en ese resultado: la clonación inicial alcanzó casi 16 GB de memoria, mientras que las voces clonadas almacenadas en caché funcionaron a la misma velocidad que las voces predeterminadas. Si vas a clonar muchos locutores por lotes, calcula el consumo a partir de ese pico, no del estado estable.
Los usuarios que compilaron el código en Windows se encontraron con dos problemas documentados por el probador de VRAM16 y solucionados mediante parches. El compilador de Microsoft rechazaba una estructura que tenía un miembro llamado también head, aunque GCC y Clang lo aceptaban. Por eso, con el parche de renombrado incluido, solo hay que compilar zonos3-cli, zonos3-server y spk-encoder-cli. Además, las versiones japonesas de Windows pasan el texto de la CLI como CP932 en lugar de UTF-8, lo que produce audio ininteligible hasta que el programa vuelve a leer la línea de comandos mediante GetCommandLineW. Las peticiones JSON a zonos3-server deberían utilizar UTF-8, aunque no se verificó.
Para evitar complicaciones, utiliza una ruta sin espacios ni caracteres no ASCII, como C:\zonos3. Instala Visual Studio 2022 con las herramientas de C++, además de Git y FFmpeg, y calcula unos cinco minutos para una instalación CUDA limpia, con aproximadamente 1,2 GB para los pesos predeterminados y unos 2 GB para CUDA local (notas de instalación).
Coste de la API alojada: qué significa pagar 10 $ por un millón de bytes UTF-8
La opción alojada utiliza un endpoint de voz compatible con OpenAI en https://api.zyphracloud.com/api/v1/audio/speech, al que se llama con el modelo zyphra/zonos3-mini y un bearer ZYPHRA_API_KEY. El ejemplo siguiente inicia un servidor SGLang-Omni local (recetario de SGLang) con la misma estructura de petición que la API en la nube. Esa compatibilidad es precisamente lo interesante: puedes crear el prototipo contra localhost y después cambiar la URL base por Zyphra Cloud.
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
El precio se calcula por bytes, no por caracteres ni por minutos de audio: 10,00 $ por cada millón de bytes UTF-8, con 1 petición concurrente, 100 generaciones al día, caracteres de entrada ilimitados y los límites de clonación de 60/120 segundos indicados arriba. En inglés sencillo, con aproximadamente un byte por carácter y suponiendo entre 800 y 900 caracteres hablados por minuto, 10 $ darían para unas 1.100-1.250 minutos, es decir, menos de un céntimo por minuto. El mismo cálculo penaliza el texto CJK, porque cada carácter cuesta unos tres bytes: aproximadamente 3 veces más por carácter. Para chino, japonés o coreano, ejecuta tus propios scripts y calcula el coste por minuto con tus textos.
La inferencia local o en el navegador tiene un coste marginal casi nulo una vez comprado el hardware. El nivel alojado resulta útil para prototipos y picos puntuales, pero no puede sostener una producción a gran escala con 1 petición concurrente y 100 generaciones diarias. Los equipos que necesiten más capacidad deberían calcular el precio de un despliegue propio con SGLang o vLLM en lugar de extrapolar la cifra de 10 $.
Frente a ElevenLabs, Fish, Qwen y la medalla del primer puesto
Las páginas de Zyphra comparan ZONOS3-Mini con Fish Audio, Qwen, Cartesia, ElevenLabs y OmniVoice mediante tres guiones: un monólogo de tráiler dramático, un largo pasaje cómico de "directo a la cárcel" para poner a prueba la consistencia y un fragmento conversacional con estilo de podcast. También incluyen un gráfico de Pareto con latencia y rendimiento. Escucha las muestras por tu cuenta. Las páginas ofrecen reproductores, pero no declaran un ganador por escrito, no indican las versiones de los modelos competidores, no proporcionan las semillas ni explican si se utilizaron ajustes equivalentes.
El ranking numérico merece la misma cautela. El ZTTS2-Eval de Zyphra cubre 35 idiomas limpios y 20 idiomas reales de uso cotidiano, con 420 combinaciones de métrica, conjunto e idioma. Su Capability Index coloca a ZONOS3-Mini en primera posición entre los modelos abiertos, por delante de Fish S2 Pro y MOSS TTS v1.5. En otras palabras, el fabricante está corrigiendo sus propios deberes con una prueba nueva diseñada por él mismo. El método es público, pero en el momento de publicar este análisis no había una reproducción independiente. Las comparaciones con modelos cerrados son únicamente de audio y no incluyen una puntuación común.
Como Zyphra no ofrece puntuaciones por idioma ni victorias independientes en pruebas de escucha, siguen sin estar demostradas la precisión tonal en mandarín, la acentuación tonal del japonés, los caracteres polifónicos y la emoción en textos largos. Pruébalos antes de tomar una decisión. La lectura honesta es que ZONOS3-Mini destaca por eficiencia y flexibilidad de despliegue, pero todavía no está demostrado que lidere en calidad.
Quién debería cambiar ya
| Equipo | Veredicto | Motivo |
|---|---|---|
| Uso offline, en el dispositivo o con requisitos de privacidad (juegos, lectores, quioscos) | Probar ya | Apache 2.0, descarga predeterminada de 1,2 GB, 2,4 GB de VRAM, funcionamiento viable en CPU y sin contador por minuto |
| Pipeline de audiolibros o NPC que necesite muchas voces | Hacer un piloto | El control palabra por palabra y la edición posterior reducen el coste de volver a renderizar, pero hay que comprobar la similitud de la clonación en cada locutor |
| Producción en idiomas distintos del inglés, especialmente en chino | Esperar a tener una evaluación propia | No hay puntuaciones del fabricante por idioma; las afirmaciones sobre error de palabras y prosodia siguen orientadas al inglés hasta probar caracteres polifónicos y tonos |
| TTS alojado con alta concurrencia | Alojarlo por cuenta propia o mantener la solución actual | El nivel en la nube limita a 1 petición concurrente y 100 generaciones al día; SGLang/vLLM es la vía real para producción |
| Equipos que necesiten marca de agua o trazabilidad | Esperar | Los materiales de lanzamiento no describen ninguna política de marca de agua o conservación para los clips de referencia |
Haz las pruebas en este orden: playground del navegador, compilación local en el dispositivo más débil y, por último, API alojada. Cambia solo si tu hardware supera los requisitos de 2,4 GB de VRAM y WebGPU y tu idioma supera una prueba de escucha a ciegas. De lo contrario, conserva tu API cerrada y vuelve a evaluar la situación cuando aparezcan benchmarks multilingües independientes.
Preguntas frecuentes
¿Cuánta VRAM necesita ZONOS3-Mini?
Unos 2,4-2,5 GB en total en la configuración probada con RTX 5080 (4,2 GB con el decodificador completo; pico de ~16 GB durante la clonación inicial en Mac).
¿Puede funcionar en un navegador o solo con CPU?
Sí. Funciona con WebGPU, con una descarga de unos 920 MB la primera vez, y la síntesis solo con CPU tardó aproximadamente un tercio del tiempo real incluido el lanzamiento en la única prueba publicada.
¿Qué tal funciona la clonación de voz?
Clonación zero-shot a partir de hasta 60 segundos sin transcripción. Una prueba independiente registró un error de palabras del 0-4 %, pero la similitud con cada locutor requiere tu propia prueba de escucha.
¿Se puede utilizar comercialmente?
Los pesos tienen licencia Apache 2.0 y el código, MIT, pero necesitas derechos o consentimiento para clonar cualquier voz.
¿Cuál es el endpoint y cuánto cuesta la API?
POST https://api.zyphracloud.com/api/v1/audio/speech, compatible con OpenAI y con el modelo zyphra/zonos3-mini, a 10 $ por cada millón de bytes UTF-8 (1 petición concurrente, 100 al día).
Lecturas relacionadas: Mejor API de texto a voz, Mejor API de clonación de voz de 2026, Guía local de Kokoro 82M TTS