 AIREITER
Cuando ChatGPT o la API de OpenAI devuelven upstream connect error or disconnect/reset before headers, el origen está en la infraestructura de OpenAI. El mensaje lo genera Envoy, el proxy situado en el perímetro de OpenAI, porque no ha podido obtener una respuesta válida de su backend. En la web de ChatGPT suele aparecer como Error Code 111. La parte que sigue a reset reason: contiene el diagnóstico concreto, mientras que before headers indica que el proxy abandonó antes de recibir siquiera una cabecera de respuesta. Es decir, ese 503 no incluye una respuesta real del backend: es la propia respuesta de Envoy. No puedes arreglar la infraestructura de OpenAI, pero los siguientes pasos cambian según el motivo del reinicio y según te ocurra en el navegador o en tu código.
Identifica tu caso:
- ChatGPT en web o app: consulta status.openai.com y después recarga o inicia una sesión nueva.
- API de OpenAI desde código: revisa el motivo del reinicio, guarda el ID de solicitud y aplica una política de reintentos.
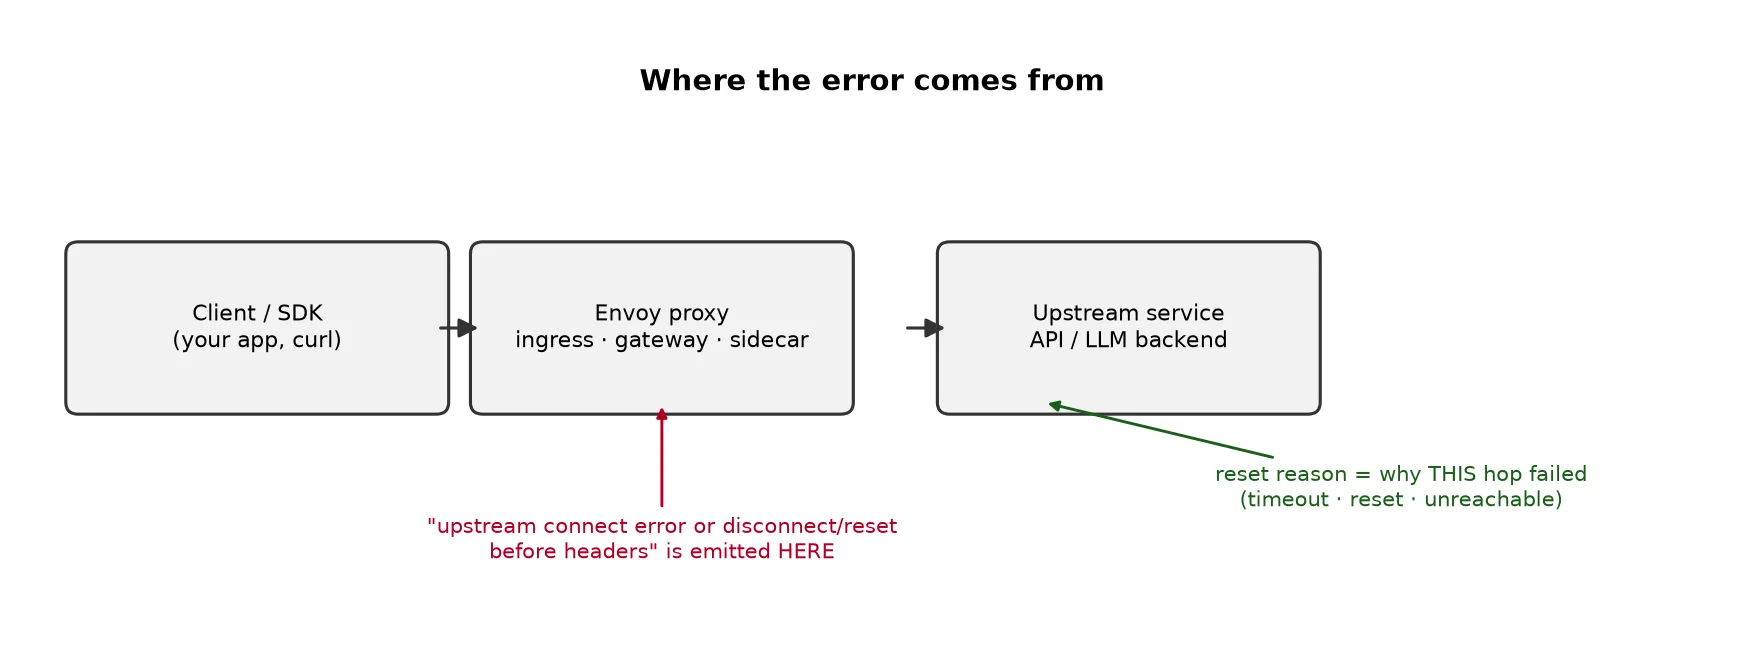
Qué indica realmente este error
Envoy actúa como intermediario entre tu solicitud y el backend de OpenAI. Al llegar una petición, abre una conexión con ese backend, reenvía la solicitud y espera las cabeceras de respuesta. Si la conexión falla, se reinicia, vence el tiempo de espera o alcanza un límite de capacidad antes de que llegue una cabecera, Envoy devuelve este mensaje con un HTTP 503, y en ocasiones con un 502. Puede verse en las pantallas de caída de ChatGPT, en trazas de openai.InternalServerError y en registros de agentes.
El texto puede variar. La fórmula retried and the latest reset reason significa que Envoy ya reintentó la operación y que el fallo corresponde a su último intento. En todos los casos, es el proxy de OpenAI informando de que su propio backend no respondió; no es un problema de tu prompt ni del cuerpo de la petición.
Cómo interpretar el motivo del reinicio
El motivo del reinicio revela qué encontró el proxy de OpenAI y, por tanto, si merece la pena reintentar.
| reset reason | Qué encontró el proxy de OpenAI | Qué puedes hacer |
|---|---|---|
connection timeout | El backend tardó demasiado en aceptar la conexión | Reintenta con backoff y revisa el estado |
overflow | Se alcanzó un límite de capacidad o de tasa; el backend está sobrecargado | Reduce la concurrencia, aplica backoff y vuelve a intentarlo |
connection failure / remote connection failure | No se pudo alcanzar el backend o rechazó la conexión | Reintenta; si persiste, revisa el estado e informa del problema |
connection termination / connection reset | El backend cerró la conexión a mitad de la solicitud | Reintenta; normalmente coincide con una incidencia |
protocol error | Un problema de protocolo del lado de OpenAI | Reintenta; si continúa, repórtalo con tu ID de solicitud |
overflow y connection timeout son los dos casos que más aparecen en los reportes de la comunidad de OpenAI, algo coherente con un backend que agota capacidad ante picos de carga. Ninguno se soluciona tocando nada en tu equipo: lo útil es comprobar el estado, aplicar backoff y disponer de conmutación por error.
Si ocurre en la web o la app de ChatGPT (Error Code 111)
Lo primero es consultar status.openai.com. Si hay una incidencia publicada, la principal solución es esperar a que se resuelva, aunque un fallo persistente que afecte solo a tu cuenta merece abrir un caso con soporte. Si el estado aparece en verde, recarga la página, abre otra pestaña o cierra sesión y vuelve a entrar: una sesión obsoleta puede mantener una conexión muerta. Cambiar de red o desactivar una VPN o proxy corporativo solo ayuda si esa capa es la que está reiniciando la conexión; pruébalo antes de dar por hecho que es un fallo de OpenAI.
Si usas la API de OpenAI desde código
En la API, este error suele ser intermitente y depender de la carga. Un desarrollador informó en el seguimiento de incidencias de openai-python de que fallaba aproximadamente el 5% de sus llamadas con openai.InternalServerError: upstream connect error or disconnect/reset before headers al realizar cientos de solicitudes por hora; el otro 95% funcionaba. Una tasa de fallo parcial así apunta a saturación del backend, y los trabajos intensivos por lotes —embeddings masivos o ingesta de documentos grandes— lo sufren más porque elevan la concurrencia. Normalmente la solución es una política de reintentos, no cambiar el payload, aunque controlar la concurrencia y encolar los trabajos masivos resulta igual de importante con cargas altas.
Antes de escalar el caso, recoge suficiente información para demostrar que el problema está en el proveedor: la marca de tiempo, el endpoint y el modelo, el estado y cuerpo HTTP, el x-request-id, la versión de tu SDK, el número de solicitudes en curso y si los fallos coinciden con una incidencia publicada. Después, aplica una política de reintentos apta para producción:
import random, time
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI()

def with_retry(fn, max_attempts=5, cap=30.0):
    for attempt in range(max_attempts):
        try:
            return fn()
        except (APIConnectionError, APIStatusError) as e:
            status = getattr(e, "status_code", None)
            # retry connection drops and 5xx (incl. this 503); never blindly retry 4xx
            if isinstance(e, APIStatusError) and status and status < 500 and status != 429:
                raise
            if attempt == max_attempts - 1:
                raise
            retry_after = float(getattr(e, "response", None).headers.get("retry-after", 0)) if getattr(e, "response", None) else 0
            backoff = retry_after or min(cap, 0.5 * 2 ** attempt) * (0.5 + random.random())
            time.sleep(backoff)
Los SDK de OpenAI ya reintentan por su cuenta los errores transitorios —max_retries, con un valor predeterminado de 2—, así que configura ese comportamiento de forma deliberada, por ejemplo con OpenAI(max_retries=0), antes de envolver las llamadas. De lo contrario, tu capa y la del SDK se acumularán. Limita tanto los intentos totales —3–5— como la concurrencia global para que los reintentos no amplifiquen el pico que provocó el overflow. Trata los errores 429 según su Retry-After; reintenta 408/409 solo cuando sea seguro repetir la operación. Ten especial cuidado con llamadas no idempotentes o de streaming: un reintento ciego puede duplicar trabajo o reproducir un stream consumido a medias.
Cómo se ve desde el lado del cliente
Muchas veces ni siquiera llegas a ver el cuerpo 503 de Envoy, porque la conexión se corta antes. Un curl -v contra un endpoint caído devuelve curl: (52) Empty reply from server después de Request completely sent off: la solicitud salió, pero no volvió nada. La variante de Envoy es un 503 cuyo cuerpo contiene el texto upstream connect error.... Los reportes públicos coinciden: un usuario publicó en el subreddit de OpenAI la cadena exacta retried and the latest reset reason: connection timeout junto a «Network connection lost», y el seguimiento de openai-python recoge el mismo mensaje como un InternalServerError con un volumen alto de solicitudes.
Cuándo conviene usar una ruta alternativa
Como el salto que falla está entre la puerta de enlace de OpenAI y su backend, frente a un único endpoint solo puedes reintentar y aplicar backoff. La otra opción es la redundancia: usar una capa capaz de conmutar a otro backend cuando un upstream vence el tiempo de espera o se desborda. Las pasarelas multiproveedor, como OpenRouter y AIReiter, se sitúan delante de varios proveedores de modelos y desvían el tráfico cuando uno va lento. Es el mismo modelo de enrutamiento multiproveedor en el que se basa OpenRouter: un upstream lento puede traducirse en un cambio de ruta en lugar de un 503 expuesto. Hay contrapartidas reales —un salto adicional, dependencia de la disponibilidad del propio router y diferencias de precio, tratamiento de datos y observabilidad que debes valorar—, pero reduce la exposición a la inestabilidad de un único proveedor.
Preguntas frecuentes
¿Qué es ChatGPT Error Code 111?
Algunos usuarios de ChatGPT ven este mensaje junto a la etiqueta «Error Code 111». Significa que el proxy de OpenAI no consiguió una respuesta de su backend; es un problema del servidor. Consulta status.openai.com y recarga la página.
¿Por qué solo ocurre con carga o de forma aleatoria?
Los fallos que dependen de la carga suelen indicar overflow —un límite de capacidad o de tasa— o saturación del backend que hace que la conexión supere su tiempo de espera. Ambos aparecen cuando aumenta la concurrencia, de ahí que el mismo código funcione la mayor parte del tiempo.
¿Puede deberse a una VPN o al firewall?
Solo si esa capa es la que está reiniciando la conexión entre tu sistema y OpenAI. Conviene descartarlo cambiando de red, pero no solucionará una caída real de OpenAI ni un 503 del lado de la API.
¿Es lo mismo que un error 429 por límite de tasa?
No. Un 429 es una respuesta explícita de límite de tasa que sí recibiste. Este 503 significa que no llegó ninguna respuesta utilizable. Respeta Retry-After ante un 429; aplica backoff y reintenta ante el 503.
¿Qué significa «retried and the latest reset reason»?
Envoy ya reintentó la solicitud, y ese es el motivo por el que falló el último intento. Apunta a un problema persistente en el backend de OpenAI, no a un fallo puntual.