 AIREITER
El nombre Unlimited OCR tiene una letra pequeña importante: el archivo de configuración de Baidu fija max_position_embeddings en 32.768. Es el dato clave antes de plantear un despliegue. El modelo puede reemplazar el OCR página a página por una única pasada de inferencia, pero solo mientras el documento entre en un presupuesto de 32K tokens y los escaneos tengan una calidad razonable.
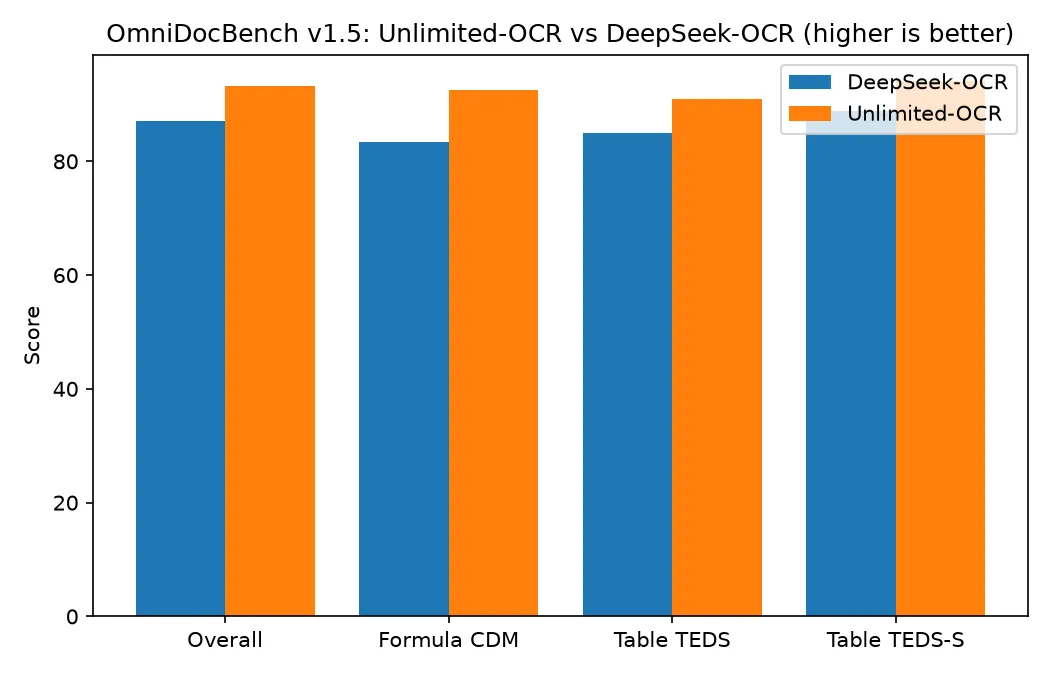
Aun con ese límite, el lanzamiento tiene bastante peso. Los pesos usan licencia MIT, los metadatos de safetensors indican 3.336.106.240 parámetros en BF16 y el modelo alcanza 93,23 global en OmniDocBench v1.5, frente al 87,01 de DeepSeek-OCR, la base sobre la que se construyó. El 2026-07-29 acumulaba 2.694.935 descargas en los últimos 30 días en Hugging Face, además de 3.389 likes.
El límite real de Unlimited OCR
En el flujo multipágina, cada página se codifica a 1024×1024 y se comprime 16 veces hasta quedarse en unos 256 tokens visuales. Con ello, se puede calcular el presupuesto por página antes de escribir una línea de código.
| Páginas en una pasada | Tokens visuales (prefill) | Tokens disponibles para salida | Presupuesto por página |
|---|---|---|---|
| 10 | ~2.560 | ~30.200 | ~3.020 |
| 20 | ~5.120 | ~27.600 | ~1.380 |
| 40 | ~10.240 | ~22.500 | ~560 |
Una presentación o un contrato poco denso pueden entrar sin problemas en 40 páginas. Pero una página de periódico a dos columnas y cargada de texto puede superar por sí sola los 560 tokens de markdown, así que el límite práctico baja bastante de 40 páginas para ese tipo de material. El paper lo dice claramente: con una ventana de contexto finita, el análisis no puede ser ilimitado, porque el prefill sigue creciendo con el número de páginas. La hoja de ruta de Baidu contempla una versión con 128K de contexto y un «prefill pool» para recuperar bloques de páginas bajo demanda. El término unlimited se refiere a una longitud de decodificación ilimitada respecto al tamaño de caché, no a un número ilimitado de páginas.
Qué aporta R-SWA frente a DeepSeek-OCR
Respecto a DeepSeek-OCR hay dos cambios. Se conserva el encoder visual DeepEncoder, una cascada SAM-ViT-B más CLIP-L, que permaneció congelado durante el entrenamiento. Todas las capas de atención del decoder se sustituyeron por Reference Sliding Window Attention: cada token generado atiende a todos los tokens de referencia —los visuales y el prompt—, pero solo a los últimos 128 tokens de salida. El config.json lo confirma: sliding_window_size: 128, 12 capas de decoder, 64 expertos enrutados y 6 activos por token.
La mejora no se limita a una métrica concreta y aparece sobre todo en los elementos de página que exigen generaciones largas. En OmniDocBench v1.5, el CDM de fórmulas pasa de 83,37 a 92,61 y el TEDS de tablas de 84,97 a 90,93; además, la distancia de edición del orden de lectura se reduce a la mitad, de 0,086 a 0,045. Como el encoder no se reentrenó, estas diferencias proceden del cambio en el decoder, no de una pila visual más capaz.
La contrapartida es que el modelo sigue arrastrando los fallos del encoder. Generar durante más tiempo no mejora el reconocimiento de caracteres en un fax desvaído.
La ventaja de velocidad aparece con salidas largas
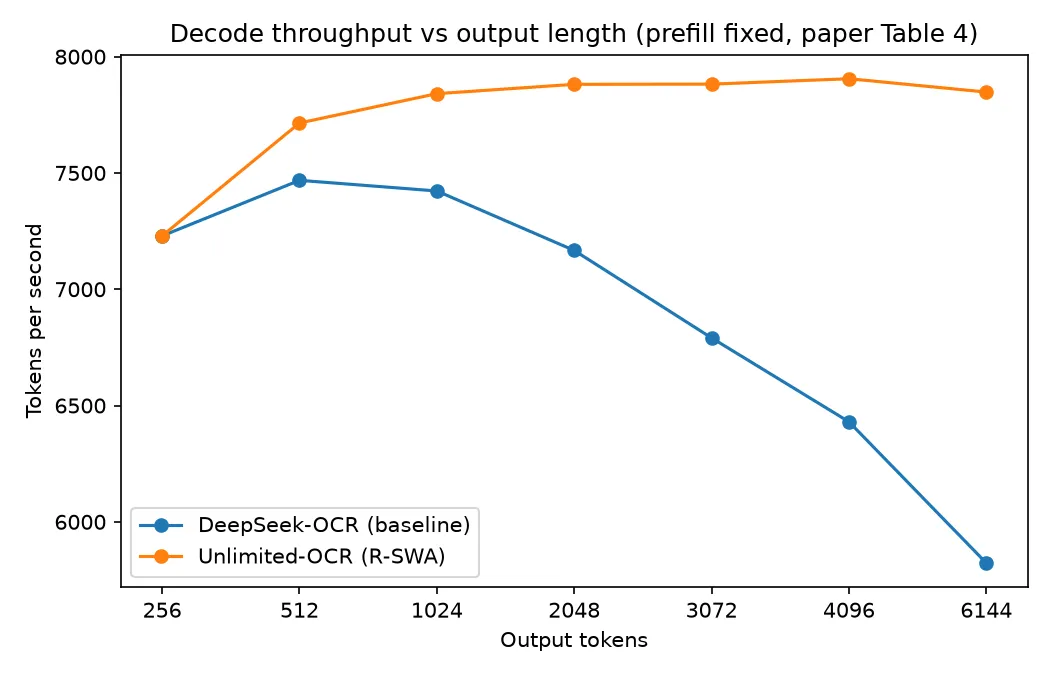
Con 256 tokens de salida, los dos modelos rinden igual: 7.229,52 frente a 7.229,32 tokens por segundo. La diferencia surge a medida que la generación se alarga: con 6.144 tokens de salida, el modelo base cae a 5.822,87, mientras Unlimited OCR mantiene 7.847,71, aproximadamente un 35% más rápido.
En la ejecución completa de OmniDocBench en modo base y con 512 de concurrencia, la ventaja se reduce al 12,7% —5.580 frente a 4.951 tokens por segundo—, porque el batching ya oculta buena parte del coste de atención en cada paso. Procesar facturas de una página a alta concurrencia apenas gana nada con R-SWA.
La precisión aguanta hasta 40 páginas, pero no es plana
El paper mide la distancia de edición según el número de páginas en una sola pasada, y la curva deja claro que la calidad no se mantiene completamente estable.
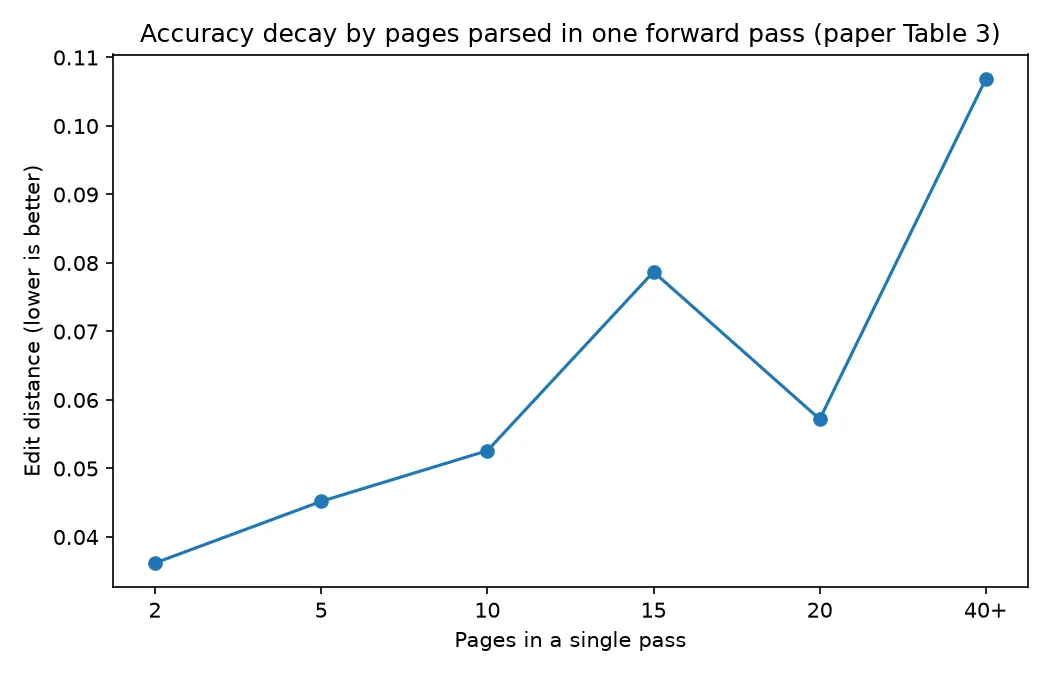
Con dos páginas, la cifra es 0,0362; con diez, 0,0526. Al llegar a 40 páginas o más, sube a 0,1069 y Distinct-35 cae de alrededor del 99,9% al 96,90%, señal de que empiezan a repetirse n-gramas en la salida. La medición de 15 páginas, 0,0787, es peor que la de 20, 0,0572, así que conviene interpretar la curva como una tendencia y no como una garantía por número de páginas. Baidu atribuye los fallos de repetición sobre todo al texto pequeño a la resolución base de 1024×1024, no a una deriva de atención. Encaja con la limitación: las entradas multipágina y PDF no pueden usar el modo de recorte de mayor detalle disponible para imágenes individuales.
Por qué «8 GB son suficientes» no cuenta toda la historia
La receta de vLLM indica que una sola GPU con 8 GB o más basta para inferencia BF16. Los informes de la comunidad no coinciden con ello, y la propia configuración del modelo explica la diferencia.
El único archivo safetensors ocupa 6,673 GB. La parte de caché se deriva de cuatro campos de config.json: num_hidden_layers: 12, num_attention_heads: 10, num_key_value_heads: 10, v_head_dim: 128, junto a use_mla: false. Al ser iguales los recuentos de cabezas de query y key/value, se usa MHA convencional, sin GQA ni MQA para repartir el coste. La caché por token es, por tanto, 2 —K y V— × 12 capas × 10 cabezas × 128 dimensiones × 2 bytes = 61.440 bytes, o 60 KiB. De ahí salen tres cifras:
- Prefill completo de 32K: 32.768 × 60 KiB = 1,875 GiB de caché
- Lado de decodificación R-SWA, limitado por
sliding_window_size: 128: 7,5 MiB, constante - El mismo decoder sin R-SWA con 6.144 tokens de salida: 360 MiB, con crecimiento lineal
Son tamaños teóricos de caché, no la asignación máxima. Por encima se suman las activaciones del encoder visual, la fragmentación del asignador y el bloque de caché preasignado por el motor. Por eso los pesos más un prefill largo saturan una tarjeta de 8 GB. Una ejecución local de SGLang en una RTX 4070 Ti Super de 16 GB registró alrededor de 12 GB en uso, algo coherente con estas cuentas, aunque no las demuestra. La cifra de 8 GB debe entenderse como el mínimo para una página corta, no como una especificación para el caso de 40 páginas.
Estos números también ponen en perspectiva lo que aporta R-SWA: al limitar la caché de decodificación se ahorran cientos de megabytes, no gigabytes, para un modelo de este tamaño. La ganancia práctica es que el coste de atención por paso deja de crecer, justo lo que refleja la curva de rendimiento.
No hay API oficial: así se ejecuta en la práctica
La página del modelo en Hugging Face indica: «This model isn't deployed by any Inference Provider.» No existe un endpoint de primera parte ni una página de precios alojada por Baidu. Para servirlo por cuenta propia hay tres vías: Transformers con trust_remote_code, SGLang o la receta de vLLM. Esta última requiere vLLM 0.25.0 o superior desde el contenedor específico vllm/vllm-openai:unlimited-ocr, porque la arquitectura todavía no está en una wheel pip estable.
Hay cuatro ajustes que determinan si se obtiene salida o no:
- Registrar el procesador de logits n-gram (
NGramPerReqLogitsProcessor). Sin él, los documentos largos entran en bucles con los tokens de coordenadas<|det|>. - Configurar el n-gram correcto:
ngram_size: 35conwindow_size: 128para imágenes individuales y1024para entradas multipágina o PDF. - Empezar el contenido de texto con el token literal
<image>, como en<image>Multi page parsing.El modelo no incluye una plantilla de chat. - Pasar
skip_special_tokens: False. Si se deja el valor predeterminado, devuelve cadenas vacías.
Las generaciones sin procesar incluyen marcado de grounding. Para obtener markdown limpio, conserva el texto dentro de <|ref|> y elimina las cajas delimitadoras <|det|>. Tampoco emite de forma nativa los límites entre páginas; si los necesitas para una trazabilidad de auditoría, pídelos en el prompt.
El servidor y la petición que la receta considera probados son estos:
docker run --rm --gpus all --network host --ipc host \
  vllm/vllm-openai:unlimited-ocr baidu/Unlimited-OCR \
  --trust-remote-code \
  --logits_processors vllm.model_executor.models.unlimited_ocr:NGramPerReqLogitsProcessor \
  --no-enable-prefix-caching --mm-processor-cache-gb 0
client.chat.completions.create(
model="baidu/Unlimited-OCR",
messages=[{"role": "user", "content": [
{"type": "text", "text": "<image>Multi page parsing."},
{"type": "image_url", "image_url": {"url": page_data_url}},
]}],
max_tokens=8192, temperature=0.0,
extra_body={"skip_special_tokens": False,
"vllm_xargs": {"ngram_size": 35, "window_size": 1024}},
)En tarjetas Hopper, usa la etiqueta de imagen unlimited-ocr-cu129. También hay que tener presente que varias imágenes en una misma petición fuerzan el modo base sin recorte; es el caso que requiere window_size: 1024.
Coste por 1.000 páginas: autoalojamiento frente a API gestionada
Los pesos abiertos son gratuitos; ejecutarlos no. Una de las pocas cifras publicadas a partir de uso real procede de una persona en el hilo de Hacker News, que convirtió aproximadamente 200 páginas por hora de un PDF japonés de gramática en una RTX 4090 mediante Transformers. Como referencia de hardware alquilado, RunPod cobra $0,34 por hora por una 4090 en su tarifa Community.
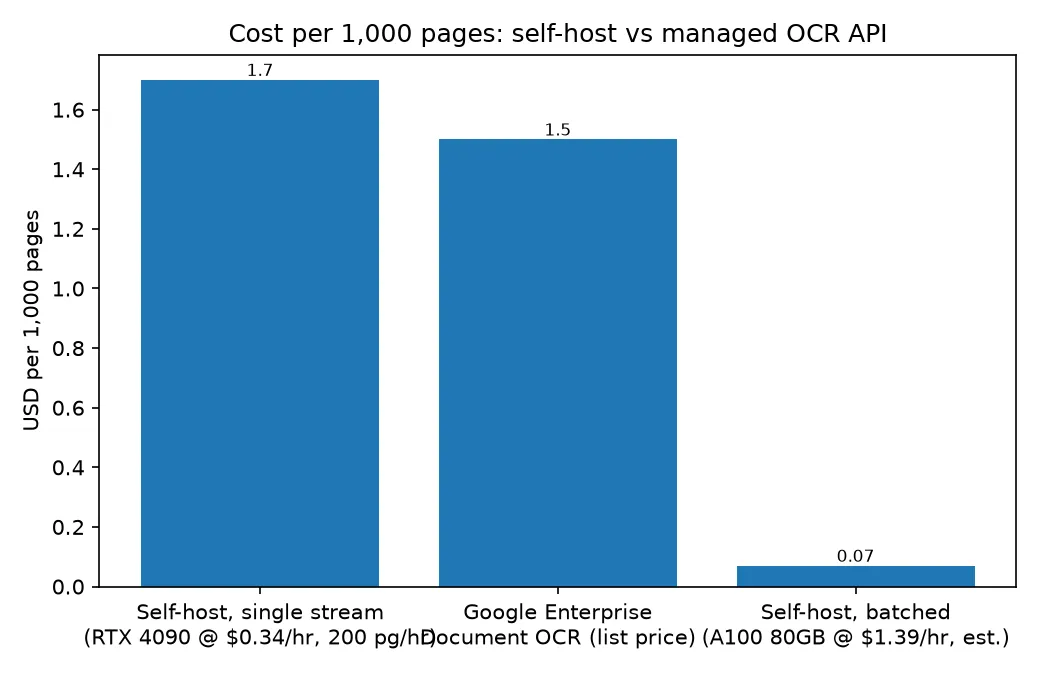
| Opción | Coste por 1.000 páginas |
|---|---|
| Autoalojado, flujo único (4090 a $0,34/h, 200 páginas/h) | ~$1,70 |
| Google Enterprise Document OCR, de 1K a 5M páginas/mes | $1,50 (tarifa de lista) |
| Google Layout Parser, mismo volumen de páginas | $10,00 (tarifa de lista) |
| Autoalojado, mínimo con lote saturado (A100 80GB a $1,39/h, modelado) | ~$0,07 |
Tarifas de lista a fecha de 2026-07-29. Las primeras 1.000 páginas mensuales de Google son gratuitas y la tarifa baja a $0,60 por encima de 5 millones de páginas. La última fila es un mínimo modelado, no una medición, y varía según la longitud de salida: con los 5.580 tokens por segundo del paper bajo concurrencia de 512, 700 tokens de salida por página dan unas 28.700 páginas por hora ($0,05 por 1.000), 1.000 tokens dan unas 20.000 ($0,07) y una página densa de 2.000 tokens da unas 10.000 ($0,14). Ese rendimiento se midió en el clúster de evaluación de Baidu, no en una A100 alquilada, por lo que la fila mezcla una tasa de benchmark con un precio de alquiler. Los despliegues reales quedan por encima de las tres cifras al sumar capacidad ociosa, reintentos de páginas fallidas, preprocesado y almacenamiento.
Un despliegue de flujo único en una tarjeta de consumo cuesta aproximadamente lo mismo que el OCR gestionado de Google. El autoalojamiento gana por concurrencia y residencia de datos, no por la licencia. Además, extraer el texto es solo la mitad del trabajo: convertir ese markdown en campos sigue requiriendo una llamada a un modelo de texto con contexto largo, donde se vuelve a facturar por token y no por página, tanto en infraestructura propia como a través de algo como la API GPT-5.6.
Casos en los que falla
Los modos de fallo reportados son los esperables de un encoder congelado. La misma ejecución en una 4070 Ti Super obtuvo salidas corruptas, regiones omitidas y deriva estructural en recibos, manuscritos y escaneos complejos, mientras que las páginas impresas limpias salían correctamente. Quienes participaron en el hilo de Hacker News describen errores de VLM-OCR relevantes para trabajos de cumplimiento: palabras extranjeras traducidas silenciosamente al inglés y un nombre manuscrito «corregido» a una grafía más probable. Son dos anécdotas individuales, así que deben tratarse como comportamientos que hay que probar, no como tasas medidas.
También importa su posición en el mercado. Unlimited OCR no encabeza las tablas de precisión. En los listados agregados de OmniDocBench, PaddleOCR-VL-1.6 alcanza 96,33 —dato autodeclarado por el proveedor— frente a 93,92 en v1.6, y el modelo todavía no aparece en olmOCR-Bench. La precisión por página no es el eje en el que compite.
¿Merece la pena ejecutarlo?
Encaja bien si tu pipeline actual recorre las páginas en bucle y luego recompone el texto, si los documentos son digitales de origen o escaneos limpios, y si estructuras entre páginas —como tablas partidas por un salto de página— están deteriorando tu salida actual.
Encaja mal si procesas miles de facturas de una página al día —los pipelines por página agrupan mejor y cuestan menos—, si los manuscritos o recibos fotografiados representan una parte relevante de las entradas, o si hoy necesitas un SLA y una trazabilidad de auditoría en lugar de una GPU y una etiqueta de contenedor.
En cualquier caso, hay que probarlo antes de comprometerse. Un mínimo razonable son 50 documentos de tu propio corpus, agrupados por longitud —1 a 5 páginas, 6 a 20 y 20 o más— y por calidad de entrada —digital de origen, escaneo limpio y fotografiado—; diez de ellos con ground truth transcrito a mano. Mide por separado tasa de error de caracteres, distancia de edición del orden de lectura y TEDS de tablas, en vez de promediarlos, y registra los segundos reales por página en la GPU que piensas alquilar. Compáralo con lo que uses ahora sobre esos mismos 50 archivos y fija el umbral donde realmente falla tu etapa posterior, que en extracción de campos suele ser la estructura de las tablas y no el CER bruto. Como referencia de cuánto puede mover la cifra una optimización, un equipo que procesa PDFs a escala empresarial comunicó un 0,94% de tasa de error de caracteres tras reescribir la capa de inferencia en Rust.
Preguntas frecuentes
¿Unlimited OCR es gratuito?
Los pesos tienen licencia MIT y se pueden descargar gratis desde Hugging Face o GitHub, incluido para uso comercial. La inferencia no es gratis: calcula aproximadamente entre $0,07 y $1,70 por cada 1.000 páginas según la eficacia del batching, además del tiempo de ingeniería.
¿Existe una API oficial de Unlimited OCR?
No. La página del modelo no muestra ningún despliegue de Inference Provider, así que cualquier endpoint disponible será de un tercero que sirve los pesos abiertos, con precios y límites de tasa definidos por ese proveedor y no por Baidu.
¿Unlimited OCR es ahora mismo el mejor modelo OCR?
No en las tablas de precisión: PaddleOCR-VL-1.6 declara 96,33 en OmniDocBench frente al 93,92 de Baidu en v1.6, y el modelo aún no tiene entrada en olmOCR-Bench, por lo que su consistencia entre benchmarks no está demostrada. Su ventaja medida es la pasada única de 40 páginas con una distancia de edición de 0,1069.
¿Puedo ejecutar Unlimited OCR en Ollama?
La ficha oficial documenta únicamente Transformers, vLLM y SGLang, y la arquitectura personalizada necesita trust_remote_code. Existen cuantizaciones de la comunidad en Hugging Face, pero conviene considerar cualquier compilación para Ollama como no verificada hasta comparar su salida con la ruta de referencia usando tus propios archivos.