 AIREITER
Alibaba ha puesto fecha a un modelo bastante peculiar: el 25 de agosto de 2026, ModelScope publicó una cuenta atrás para Qwen3.8-Flash-Next, un modelo que estrena arquitectura antes incluso de que exista oficialmente la familia de productos a la que dará paso. En el momento de redactar este artículo, la publicación de los pesos estaba prevista para el 26 de agosto a las 23:00 UTC+8. La idea es que el ecosistema de inferencia open source tenga tiempo de preparar kernels, cuantizaciones y soporte de despliegue antes de la llegada de Qwen4.
Qué es realmente Qwen3.8-Flash-Next —y qué no es—
Qwen3.8-Flash-Next es un modelo multimodal de mezcla de expertos (MoE) construido sobre la arquitectura que usará la futura familia Qwen4. No es Qwen4. Es, más bien, un demostrador tecnológico funcional: expone los nuevos mecanismos de atención, la estructura de capas y los patrones de dispersión para que los frameworks de inferencia puedan incorporar soporte antes del lanzamiento completo de Qwen4.
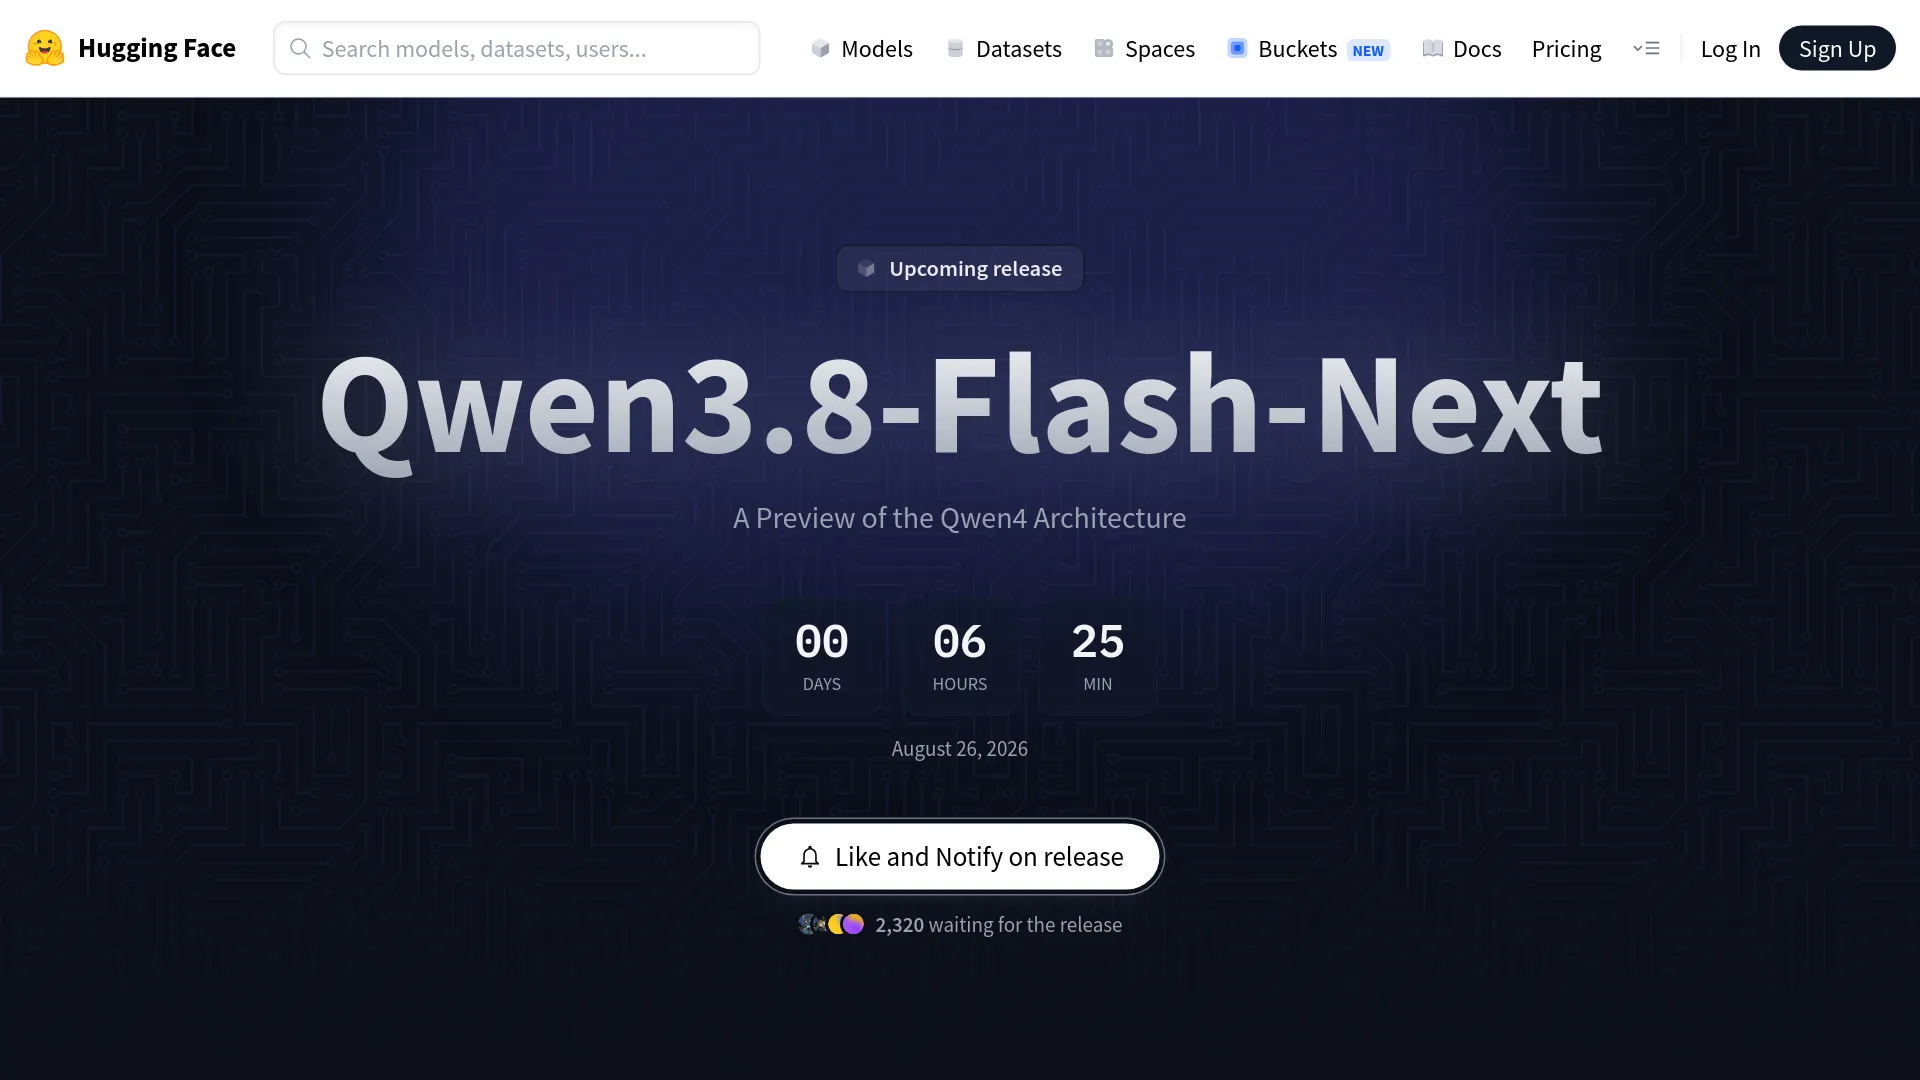
La página del equipo de Qwen en Hugging Face lo presenta como un «Upcoming release» y «A Preview of the Qwen4 Architecture». Por su parte, la cuenta atrás de ModelScope mostraba el lema «Onward to the Next-Gen — Lightning-Fast.» Ambos son canales oficiales de Qwen, así que el lanzamiento está confirmado, aunque todavía no se había completado al cierre de este artículo.
Esto es lo que está confirmado frente a lo que sigue siendo especulación de la comunidad:
| Confirmado por canales oficiales | Aún sin confirmar |
|---|---|
| Lanzamiento con pesos abiertos en ModelScope y Hugging Face | Cifras definitivas de parámetros (125B/6B/51B) |
| Multimodal (visión + texto) | Licencia (probablemente Apache 2.0 por precedentes) |
| Arquitectura híbrida GDN y Qwen Sparse Attention | Puntuaciones de benchmarks de cualquier tipo |
Variante FP8 (Qwen/Qwen3.8-Flash-Next-FP8) | Precio o disponibilidad de la API |
| Adelanto de la arquitectura Qwen4 | Longitud de contexto (se especula con 256K nativos, ampliables hasta 1M) |
Las cifras que todo el mundo está citando —125B de parámetros totales, 6B activos por token y 51B en embeddings de n-gramas— aparecieron en una ficha de ModelScope que se mostró brevemente y después fue recortada por el equipo de Qwen. Son datos plausibles y coherentes con lo observado por varias fuentes independientes, pero no constituyen documentación oficial estable. Como resumió ghosty, fundador de SaaSCity:
«Cualquiera que publique hoy una gráfica de benchmarks de este modelo se la está inventando.»
Una arquitectura que obliga a replantear la inferencia
Qwen3.8-Flash-Next se separa claramente de los modelos actuales de Qwen por tres componentes arquitectónicos. Cada uno exige que los frameworks de inferencia incorporen código nuevo para los kernels; no basta con cambiar una opción de configuración.
Capas GDN: estado recurrente de tamaño fijo y menos memoria en contextos largos
Gated Delta Network (GDN) sustituye a la atención estándar en la mayoría de las capas. En un transformer convencional, la caché KV crece con la longitud de la secuencia. GDN utiliza en cambio un estado recurrente de tamaño fijo: en esas capas, la memoria permanece constante independientemente de la longitud del contexto y el coste computacional escala de forma lineal, no cuadrática. Las capas de atención completa de esta arquitectura híbrida siguen usando caché KV para recuperar información con precisión.
En la práctica, esto abarata de forma notable las cargas de trabajo con contextos largos. Una conversación de 100K tokens no necesita reservar una caché KV equivalente a 100K tokens. Según el análisis de la comunidad sobre la ficha de ModelScope que estuvo visible durante poco tiempo, la mezcla de capas de la arquitectura Qwen3.8 sería de 69 capas GDN y 23 capas de atención completa, aproximadamente en una proporción de 3:1. Las capas de atención completa conservan la capacidad de recuperación global, mientras que GDN procesa la mayor parte de la secuencia.
La idea no es completamente nueva en Qwen. Qwen3-Next (septiembre de 2025) introdujo Gated DeltaNet con 80B de parámetros totales y 3B activos, y según los informes, las familias Qwen3.5/3.6/3.7 mantuvieron un patrón híbrido similar. La novedad de Flash-Next está en la escala —125B de parámetros totales con esta arquitectura— y en la incorporación de los dos componentes siguientes.
QSA: atención dispersa cuyo funcionamiento aún no está claro
Qwen Sparse Attention (QSA) aparece mencionada en la ficha, pero sin explicación técnica. El consenso de la comunidad es que sustituye la atención densa por un patrón disperso: cada token atiende solo a un subconjunto de los demás tokens, en lugar de recorrer toda la secuencia. Lo que todavía se desconoce es si QSA emplea dispersión aprendida, bloques dispersos, ventanas deslizantes o una combinación de estos métodos. El informe técnico dirá si estamos ante una mejora incremental o ante un mecanismo de atención realmente nuevo.
La tabla de n-gramas de 51B: decodificación especulativa sin modelo borrador
El elemento más inusual es una tabla de embeddings de n-gramas con 51B de parámetros. La hipótesis de trabajo de la comunidad es que funciona como un mecanismo rápido de consulta de tokens, en esencia, un modelo borrador integrado para la decodificación especulativa. En lugar de ejecutar un modelo pequeño independiente que anticipe los siguientes tokens para que el modelo principal los verifique después, la tabla de n-gramas proporcionaría directamente candidatos baratos para el siguiente token.
Las incógnitas son importantes: ¿la tabla debe residir en la VRAM o puede mapearse en memoria? ¿Cómo se comporta al cuantizarla? ¿Está incluida en la cifra de 125B o se contabiliza aparte? Hasta que el informe técnico o los primeros benchmarks de la comunidad respondan a estas preguntas, conviene tratar los 51B como una variable para planificar el despliegue, no como un coste fijo.
Dónde encaja Flash-Next dentro de la familia Qwen
Flash-Next no es simplemente el siguiente escalón de una progresión lineal, sino una línea paralela:
| Modelo | Lanzamiento | Parámetros totales | Parámetros activos | Función |
|---|---|---|---|---|
| Qwen3-Next | Sep 2025 | 80B | 3B | Primer banco de pruebas de la arquitectura GDN |
| Qwen3.8-27B | Aug 2026 | 27B (denso) | 27B | Modelo denso de gama media para uso general |
| Qwen3.8-Max | Aug 2026 | ~2.4T | ~95B | Buque insignia con pesos abiertos |
| Qwen3.8-Flash-Next | Aug 26, 2026 | ~125B | ~6B | Adelanto de la arquitectura Qwen4 |
| Qwen4 | TBD (months) | Desconocidos | Desconocidos | Familia completa de nueva generación |
La regla aproximada que está usando la comunidad es: sqrt(125B x 6B) = 27B. Si se cumple, Flash-Next podría ofrecer una calidad parecida a la de un modelo denso de 27B, pero con un consumo de cómputo de inferencia más cercano al de un modelo de 6B. Como señaló Lucas Souza, de Beer And Code, es una regla orientativa, no un teorema: todavía no se han medido la calidad del enrutamiento, la calidad de los datos ni la contribución de la tabla de n-gramas.
La estrategia —descrita en varios análisis de la comunidad como una «apuesta por la plataforma, no por el benchmark»— consiste en dar tiempo a frameworks de inferencia como llama.cpp, vLLM y SGLang para añadir soporte de kernels antes del lanzamiento de Qwen4. Unsloth ya ha anunciado que trabaja en ofrecer soporte desde el primer día.
¿Se puede ejecutar de verdad? La realidad del hardware
| Formato | Memoria aproximada para los pesos |
|---|---|
| BF16 / FP16 | ~250 GB |
| FP8 | ~125 GB |
| Q4 / 4-bit | ~65–70 GB |
Estas cifras corresponden solo a los pesos, sin contar el contexto, la caché KV ni la sobrecarga del runtime. Un modelo cuantizado en Q4 necesitaría aproximadamente 65–70 GB solo para los pesos principales, además de lo que ocupe la tabla de n-gramas de 51B. Si esa tabla debe permanecer en la VRAM, el total supera lo que pueden manejar la mayoría de las configuraciones de una sola máquina. Si puede mapearse en la RAM del sistema, un equipo con 128GB+ de memoria unificada —Mac Studio (M2 Ultra / M3 Ultra al máximo), AMD Strix Halo, NVIDIA DGX Spark— podría ser viable. Una sola RTX 4090 o 5090 no es suficiente.
En Reddit, u/KURD_1_STAN cuestionó la descripción de este modelo como «apto para uso local»: «Con los precios de la RAM tan altos, ¿cómo puedes llamarlo apto para uso local?». La diferencia entre el reclamo de «6B activos» y unos requisitos de memoria de 250GB es evidente. En X, @Dicklong1999 señaló que el patrón de activación dispersa podría ofrecer una velocidad de generación razonable a quienes sí dispongan del hardware, pero que «125B, la gente normal básicamente puede olvidarse de ejecutarlo en local».
Qué esperar de la disponibilidad y el precio de la API
En el momento de publicación, Qwen3.8-Flash-Next todavía no tenía precio ni disponibilidad anunciados para API. Qwen3.8-Max cuesta $2.00/M de entrada y $6.00/M de salida, según la página oficial de precios de Qwen; con 6B de parámetros activos, Flash-Next debería ser bastante más barato. La variante FP8 reduce a la mitad la memoria de los pesos frente a BF16, por lo que es un formato lógico para servir el modelo mediante API. La disponibilidad dependerá de que los frameworks de inferencia incorporen soporte: conviene revisar los catálogos de los proveedores después de la publicación de los pesos.
Qué hacer antes de que se publiquen los pesos
Si eres desarrollador o investigador y estás valorando si Qwen3.8-Flash-Next encaja en tu stack, esta es la lista de comprobaciones:
1. Comprueba tu hardware. Si piensas ejecutarlo en local, confirma que tienes 128GB+ de memoria unificada o una configuración con varias GPU. Si no, tendrás que recurrir al acceso mediante API.
2. Vigila el repositorio de Hugging Face. La ficha del modelo será la primera fuente fiable sobre las especificaciones reales, la licencia y la longitud de contexto. Guarda huggingface.co/Qwen/Qwen3.8-Flash-Next.
3. Prepara tu pipeline de evaluación. Ten listos los prompts de benchmark y los scripts de evaluación antes de que lleguen los pesos. Las primeras 24 horas de benchmarks de la comunidad aportarán más información que cualquier cifra oficial.
4. No migres cargas de producción. Todavía no existen benchmarks independientes. La arquitectura es nueva, el soporte del runtime aún está verde y la licencia no está confirmada. Úsalo para evaluar, no para nada cuya interrupción pueda costarte dinero.
5. Si mantienes herramientas de inferencia, empieza ya. La combinación GDN + QSA requiere trabajo específico en los kernels, no simples cambios de configuración. Cuanto antes entiendas la arquitectura, antes podrás publicar soporte.
Preguntas frecuentes
¿Cuándo estarán disponibles los pesos?
La cuenta atrás de ModelScope apuntaba al 26 de agosto de 2026, aproximadamente a las 23:00 UTC+8. Los espejos de Hugging Face suelen aparecer pocas horas después de un lanzamiento en ModelScope. El equipo de Qwen confirmó el calendario a través de canales oficiales: @Alibaba_Qwen insinuó «what surprise we're dropping tonight» y @QwenDevs mencionó directamente el modelo.
¿Esto es Qwen4?
No. Es un adelanto de la arquitectura Qwen4 que utiliza la nomenclatura Qwen3.8. Qwen4 como tal se espera en meses, no en semanas. Flash-Next existe para que el ecosistema pueda preparar el soporte de ejecución antes de que llegue la familia completa.
¿Qué licencia utiliza?
No está confirmado. Los lanzamientos recientes de Qwen con pesos abiertos, como Qwen3.8-27B y Qwen3.8-Max, han utilizado Apache 2.0, por lo que es el resultado más probable. Compruébalo en la ficha del modelo cuando los pesos estén disponibles.
¿Puedo ejecutarlo en una RTX 4090?
No. Incluso con cuantización Q4, los pesos principales necesitan aproximadamente ~65–70 GB. Una sola RTX 4090 tiene 24 GB. Necesitas un sistema con 128GB+ de memoria unificada —Mac Studio, Strix Halo— o varias GPU con mucha VRAM.
¿Superará a Qwen3.8-27B?
Se desconoce. No hay benchmarks. La heurística sqrt(125B x 6B) = 27B apunta a una calidad comparable a la de un modelo denso de 27B, pero es una estimación, no una medición. Habrá que esperar a evaluaciones independientes para cada caso de uso.
¿Qué velocidad tendrá?
La cifra de 6B de parámetros activos por token apunta a una velocidad de generación más cercana a la de un modelo pequeño que a la de un modelo de 125B. Sin embargo, el patrón de acceso a memoria de la tabla de n-gramas y la eficiencia de los kernels GDN son variables todavía desconocidas. Los primeros benchmarks de la comunidad resolverán esta duda.
¿Estará disponible en plataformas de API?
Casi con toda seguridad. La variante FP8 está pensada precisamente para servir el modelo mediante API. AIReiter y otras plataformas suelen añadir los modelos de Qwen pocos días después de la publicación de los pesos. El cuello de botella será el soporte de los mecanismos de atención novedosos por parte de los frameworks.
¿Qué pasó con el Qwen3-Next del año pasado?
Qwen3-Next se lanzó en septiembre de 2025 con 80B de parámetros totales y 3B activos, e introdujo Gated DeltaNet. Fue una prueba de la arquitectura a menor escala que demostró que el enfoque híbrido de GDN podía funcionar. Flash-Next es su continuación ampliada. Un usuario de X, @LufzzLiz, comentó que la serie Next del año pasado «was a letdown»; precisamente por eso es importante esperar a los benchmarks esta vez.