 AIREITER
Con el cierre de OpenAI previsto para el 26 de agosto de 2026, el error más peligroso es pensar que basta con cambiar unos cuantos nombres. El fin de vida de Assistants API se anunció con un año completo de margen, en el aviso de deprecación del 26 de agosto de 2025, y su sustituto es Responses API. Sobre el papel, los objetos encajan con facilidad; en la práctica, la orquestación que los sostiene cambia por completo. Incluso desarrolladores que siguieron la guía oficial terminaron publicando integraciones rotas. Esto es lo que desaparece, lo que esconden esas equivalencias y cómo actuar según el margen que te quede.
Qué deja de funcionar el 26 de agosto de 2026 y qué se conserva
Toda la familia de endpoints de Assistants devolverá errores después de la fecha límite. El cierre afecta a /v1/assistants, /v1/threads, los mensajes de threads, runs y run steps, así como a cualquier flujo que siga enviando la cabecera OpenAI-Beta: assistants=v2. Las configuraciones de asistentes y el historial de threads dejarán de ser accesibles mediante la API.
No todo lo que forme parte de una integración con Assistants desaparece:
| Desaparece el 26 de agosto de 2026 | Sigue disponible |
|---|---|
Endpoints CRUD de /v1/assistants | Vector stores y archivos subidos, reutilizables mediante file search en Responses |
/v1/threads y mensajes de threads | Chat Completions API, que no entra en este cierre |
| Runs y run steps | Responses API y Conversations API |
Flujos con OpenAI-Beta: assistants=v2 | Realtime API |
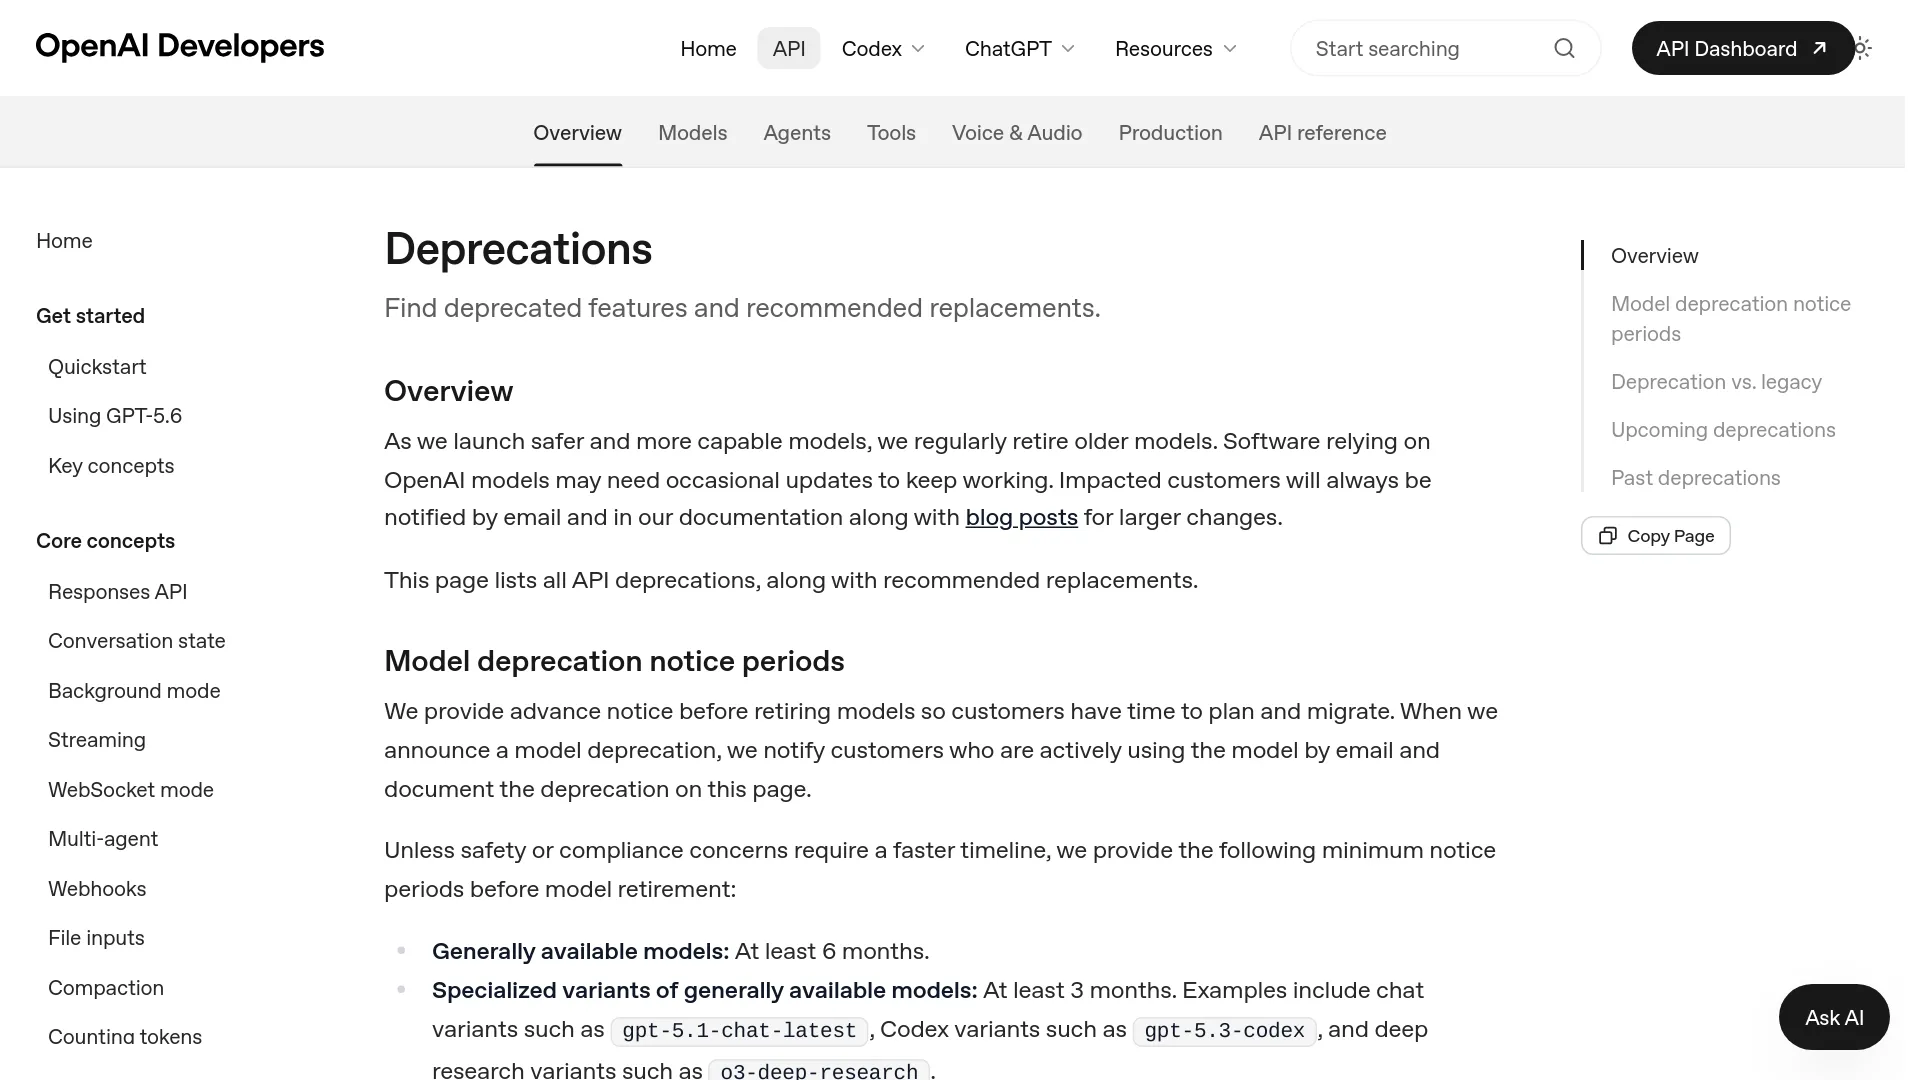
El propio registro de deprecaciones de OpenAI señala a Responses y Conversations como los reemplazos designados:
Las cuatro equivalencias de objetos y dos detalles que cambian la arquitectura
La guía de migración de OpenAI traslada cuatro conceptos de Assistants a sus equivalentes en la era de Responses:
| Assistants API | Sustituto | Qué cambia de verdad |
|---|---|---|
Assistants | Prompts | La configuración pasa a un objeto versionado creado desde el dashboard |
Threads | Conversations | Almacena items generales —mensajes, llamadas a herramientas y resultados—, no solo mensajes |
Runs | Responses | El ciclo de crear un run, consultar su estado y recuperar el resultado se concentra en una llamada a responses.create |
Run steps | Items | Un tipo unión que cubre mensajes, llamadas a funciones y resultados |
La simplificación del ciclo se aprecia en los ejemplos oficiales: un run completado en gpt-4.1 registra 34 tokens de prompt y 130 tokens de completion, mientras que una response completada en gpt-5.5 registra 17 tokens de entrada y 150 de salida. La carga de trabajo tiene una forma similar, pero los campos se llaman de otra manera.
Y ahí está el primer detalle importante. Los paneles de facturación y parsers de payloads basados en los campos antiguos pueden fallar silenciosamente al cambiar esos nombres:
| Campo de Assistants | Campo de Responses |
|---|---|
usage.prompt_tokens | usage.input_tokens |
usage.completion_tokens | usage.output_tokens |
max_completion_tokens / max_prompt_tokens | max_output_tokens |
truncation_strategy | truncation |
object: "thread.run" | object: "response" |
El segundo detalle es arquitectónico. Los Prompts solo pueden crearse desde el dashboard, no mediante API. Esto rompe cualquier sistema que genere dinámicamente un Assistant para cada cliente, workspace o conjunto de documentos. La propia guía oficial recomienda revisar el calendario de deprecación de Prompts antes de adoptarlos en una integración de larga duración, porque los objetos Prompt reutilizables también conllevan riesgo de retirada. El patrón más duradero consiste en mantener instrucciones, esquemas de herramientas y elección de modelo en tu propio control de versiones, y enviarlos con cada solicitud. Sobre el historial de threads, la postura de OpenAI se resume en una frase: "No proporcionaremos una herramienta automatizada para migrar Threads a Conversations."
Cómo trasladar las tres herramientas integradas
Cada herramienta de Assistants tiene un destino concreto en Responses, pero todas desplazan parte del trabajo a tu aplicación:
| Herramienta de Assistants | Destino en Responses | Qué pasa a gestionar tu aplicación |
|---|---|---|
| File search | Los vector stores se conservan; debes proporcionar vector_store_ids en la definición de la herramienta al realizar la solicitud | Resolver los IDs correctos de los stores antes de cada llamada |
| Code interpreter | Un contenedor configurado con type: "auto" | El ciclo de vida del contenedor |
| Functions | Desaparece la clave anidada function; name, description y parameters suben un nivel | El ciclo de herramientas: ejecutar la llamada, devolver el resultado con su call_id correspondiente y decidir si se repite el ciclo |
La fila de file search es el cambio arquitectónico menos evidente para las aplicaciones multi-tenant. Antes, asignar un vector store a cada tenant era una vinculación de configuración en el objeto Assistant; ahora, el tenant propietario de la sesión entrante debe resolver los IDs de stores correctos antes de enviar la solicitud.
Problemas que ya han encontrado equipos migrados
OpenAI sostiene que Responses ha alcanzado paridad de funcionalidades. Los informes de migración apuntan a una paridad a nivel de objetos, pero con una refactorización real por debajo. El responsable de un SaaS de chatbots multi-tenant documentó una migración de dos semanas en r/aiagents, y los fallos persistieron pese a seguir fielmente la guía oficial:
Tuve que adaptar todos los campos opcionales como
["type", "null"], lo que parece un apaño para sortear el sistema de tipos. — u/aidenclarke_12
Los esquemas estrictos de herramientas obligan a declarar las propiedades opcionales como anulables y a mantenerlas en required. Los esquemas crecen, y cada handler que interpretaba la ausencia de un campo como ausencia real necesita una segunda revisión. El mismo desarrollador señaló dónde está el cambio más profundo:
El cambio en la infraestructura de vector stores es el verdadero giro arquitectónico. — u/aidenclarke_12
El streaming es el segundo punto de ruptura silencioso. El streaming de runs de Assistants no se adapta tal cual a Responses: hay que reescribirlo con eventos server-sent tipados como response.created, response.output_text.delta, response.completed y response.function_call_arguments.delta / .done. Hay eventos de finalización explícitos y nuevas estructuras para las llamadas a herramientas; los nombres de eventos están recopilados en la cobertura sobre la migración. Tanto los proxies SSE como los handlers de cliente requieren cambios, incluida la lógica de reconexión.
El tercer problema no proviene tanto de la API como del retraso del ecosistema:
La Responses API lleva disponible mucho tiempo, pero muchos SDK de frameworks aún no la soportan. — u/zhlmmc
Si tu stack se apoya en un framework de agentes que todavía presupone el modelo Threads/Runs —el retraso con el que se encontró u/zhlmmc—, reserva tiempo para esa capa además de tu propio código de integración.
Qué estrategia de estado elegir: encadenar, Conversations o reproducir el historial
Responses ofrece tres formas de mantener el contexto en conversaciones de varios turnos, y no son intercambiables:
| Estrategia | Mejor para | Ten en cuenta |
|---|---|---|
previous_response_id | Encadenado sencillo y cambios mínimos | El contexto previo sigue contando como entrada facturable |
| Conversations API | El análogo más cercano a Threads; historial en el servidor | Debes construir tú el backfill; no hay herramienta del proveedor |
Reproducción manual, store: false | ZDR y requisitos estrictos de retención | Todo el estado queda en tus manos; hay que conservar los reasoning items |
Para convertir el historial de un thread antiguo, OpenAI recomienda esta secuencia:
- Enumera los mensajes del thread en orden ascendente.
- Convierte cada mensaje de texto del usuario en
input_text. - Convierte cada mensaje de texto del asistente en
output_text. - Convierte el contenido de URL de imagen en
input_image, conservandoimage_urlydetail. - Crea la Conversation con los
itemsconvertidos.
Equivocarse al asignar un rol tiene un modo de fallo concreto: el modelo interpreta sus propias respuestas anteriores como nuevas instrucciones del usuario. Las responses almacenadas tienen un TTL predeterminado de 30 días, salvo que pases store: false. Las conversations quedan fuera de ese TTL de responses y no tenían una duración publicada por separado a finales de julio de 2026, según la cobertura de migración que hizo seguimiento de ello. Es un detalle importante si tus avisos prometen un plazo de eliminación.
El impacto de la migración en la factura de tokens
Hay dos aspectos de facturación que importan.
El primero: previous_response_id aporta comodidad, no descuento. La guía de migración a Responses de OpenAI indica que los tokens de entrada previos de la cadena de responses siguen facturándose como tokens de entrada. Por tanto, las conversaciones largas crecen linealmente si no recortas el contexto.
El segundo: la entrada cacheada cuesta mucho menos que la no cacheada, aproximadamente una décima parte de la tarifa de entrada en los niveles GPT-5.x listados en julio de 2026. Además, las pruebas internas comunicadas por OpenAI registraron entre un 40 y un 80% más de aprovechamiento de caché en Responses que en Chat Completions, según la cobertura recopilada. Considera ese rango una cifra del proveedor hasta que tus propios paneles lo confirmen. La comprobación de paridad relevante es tu recuento de tokens por sesión, antes y después del cambio.
Si aprovechas la migración para replantear el precio de la carga de trabajo GPT-5.x, el desglose de precios de GPT-5.6 explica el cálculo por token, y endpoints compatibles con OpenAI como la página de la API GPT-5.6 ejecutan cargas de trabajo del estilo de Responses para compararlas directamente.
Un plan de migración según el tiempo que te queda
Quedan entre 1 y 6 días. Haz primero una copia de seguridad: enumera assistants y vector stores con limit=100, descarga tus archivos y serializa los objetos del SDK con model_dump(). Las guías centradas en el backup advierten de una limitación importante: no existe un endpoint para listar threads, así que solo podrás exportar los IDs de threads que tu aplicación ya hubiera guardado. Después, activa el cambio tras una feature flag: las sesiones nuevas pasan inmediatamente a Responses y los threads antiguos se rellenan bajo demanda solo si un usuario vuelve a abrirlos.
Queda una semana o más. Convierte de punta a punta un flujo de bajo riesgo antes de tocar el resto. Reconstruye el ciclo de herramientas y verifica que cada resultado de función lleve su call_id correspondiente; sustituye el manejo de streams por ramificación según el tipo de evento; después compara comportamiento, latencia, uso de tokens y tasa de errores con la referencia de Assistants antes de ampliar el tráfico.
Ya ha pasado la fecha límite. Los endpoints devolverán errores y las configuraciones de asistentes habrán desaparecido del lado de la API. La recuperación exige reconstruir a partir de lo que conserven tu base de datos de aplicación y tus copias de seguridad, aunque los vector stores y archivos seguirán siendo accesibles mediante file search.
El intercambio pendiente de resolver es claro: pasas de un ciclo de vida gestionado por el servidor —polling, truncado y ciclo de herramientas— a un modelo de una sola llamada cuya orquestación puedes ver y probar. Un desarrollador que lanzó productos con ambos enfoques lo resumió así:
Responses API es el punto medio perfecto: se encarga del trabajo pesado, pero sigue siendo lo bastante flexible para gestionar funcionalidades propias. — u/landongarrison
Preguntas frecuentes sobre el cierre de OpenAI Assistants API
¿También se cierra Chat Completions API?
No. Chat Completions no forma parte del cierre del 26 de agosto de 2026, y la guía de OpenAI plantea su migración a Responses flujo a flujo, no con una fecha límite obligatoria.
¿OpenAI migrará automáticamente mis threads existentes?
No. La guía oficial de migración lo dice claramente: "No proporcionaremos una herramienta automatizada para migrar Threads a Conversations." El backfill es código de aplicación que debes escribir siguiendo la secuencia de conversión de items anterior.
¿Puedo seguir usando Assistants API después del 26 de agosto de 2026?
No. Assistants, threads, mensajes, runs y run steps devolverán errores después de esa fecha, incluidos los flujos con assistants=v2. Exporta todo lo que necesites antes de la fecha límite.
¿Caducan las responses almacenadas?
Sí. Las responses almacenadas tienen por defecto una ventana de retención de 30 días, salvo que pases store: false; las conversations quedan fuera de ese TTL según la información publicada en julio de 2026.
¿Tengo que trasladar la configuración de mi asistente a Prompts?
No. De hecho, no deberías hacerlo si generas asistentes dinámicamente. Los Prompts solo se crean desde el dashboard, y la propia guía oficial recomienda revisar la deprecación de los objetos Prompt reutilizables. Mantener instrucciones y esquemas de herramientas en el control de versiones y enviarlos con cada solicitud es el patrón más duradero.