 AIREITER
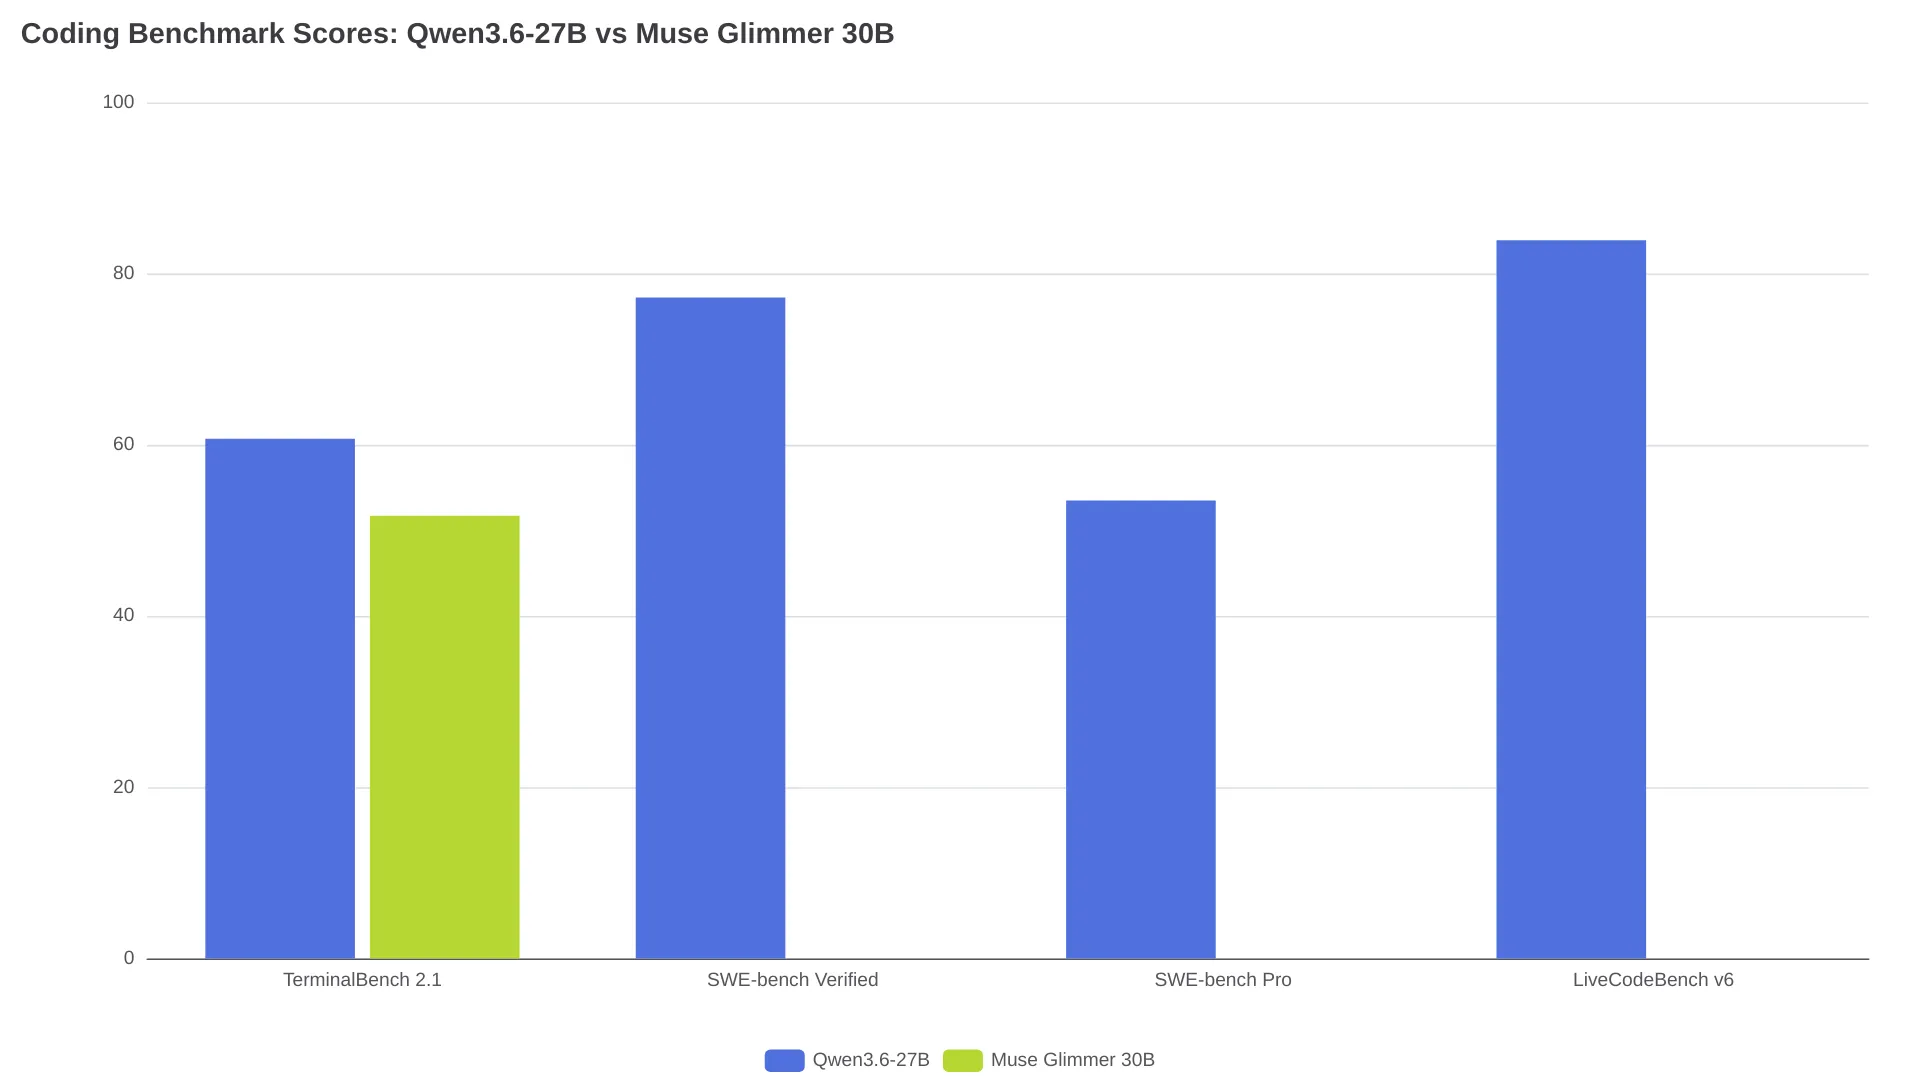
Para programar, los benchmarks favorecen con claridad a Qwen3.6-27B: obtiene 60.7 en TerminalBench 2.1, frente a los 51.7 de Muse Glimmer, y su resultado oficial en SWE-bench Verified es 77.2. Pero esa no es toda la historia si ejecutas modelos en local. Muse Glimmer 30B puede ofrecer una ventaja decisiva de VRAM y contexto en una única GPU. Qwen3.6-27B llegó en abril de 2026 con una tabla completa de benchmarks en su model card de Hugging Face; Muse Glimmer 30B le siguió en agosto de 2026 como lanzamiento de pesos abiertos de Meta, y la comunidad de LLM locales empezó a enfrentarlos en pruebas pocos días después.
TerminalBench 2.1: Qwen gana por 9 puntos
TerminalBench evalúa la fiabilidad de agentes que trabajan en terminal durante tareas de varios pasos, incluido el uso de herramientas y la capacidad de mantener contexto en sesiones largas. En las conversaciones comunitarias enlazadas, TerminalBench 2.1 aparece con frecuencia como la comparación disponible más directa entre ambos agentes de programación.
Resultados de TerminalBench 2.1 comunicados por la comunidad, recogidos en debates de r/LocalLLaMA del 10 y 11 de agosto de 2026:
| Modelo | TerminalBench 2.1 | Tipo de fuente |
|---|---|---|
| Qwen3.6-27B | 60.7 | Reportado por la comunidad |
| Muse Glimmer 30B | 51.7 | Reportado por la comunidad |
| Gemma 4 31B | 43.4 | Reportado por la comunidad |
Hay una salvedad importante: TerminalBench mide el conjunto formado por el modelo y su harness, no solo el modelo base. La ficha oficial de Qwen3.6-27B especifica un harness Harbor/Terminus-2 con un límite de 3 horas, 32 CPU, 48 GB de RAM, 80K de salida máxima, 256K de contexto y promedio de cinco ejecuciones. La puntuación de Glimmer podría proceder de una configuración distinta o menos optimizada; por eso, la diferencia de 9 puntos puede reducirse o ampliarse según cómo montes tu agente.
Benchmarks publicados de código: Qwen tiene datos, Glimmer todavía no
Qwen3.6-27B cuenta con resultados oficiales en su model card. En las fuentes enlazadas revisadas para esta comparativa no se encontró ningún benchmark oficial de SWE-bench, LiveCodeBench o un equivalente de programación agéntica para Muse Glimmer hasta agosto de 2026. Qwen dispone, por tanto, de una base de evidencia publicada más sólida, aunque todavía no existe un cara a cara oficial en igualdad de condiciones.
Benchmarks oficiales de programación de Qwen:
| Benchmark | Qwen3.6-27B (oficial) |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| SWE-bench Multilingual | 71.3 |
| Terminal-Bench 2.0 | 59.3 |
| LiveCodeBench v6 | 83.9 |
Son resultados publicados por el proveedor. La model card indica que las evaluaciones de SWE-bench usan el scaffold interno de Qwen para bash y edición de archivos, con temperatura 1.0, top-p 0.95 y una ventana de contexto de 200K. Los resultados de SWE-bench Pro se calcularon sobre un conjunto refinado de tareas en el que Qwen corrigió elementos problemáticos, por lo que la comparación directa con los valores de la clasificación pública puede no ser equivalente. El análisis de terceros de morphllm señala que estos resultados dependen del scaffold de agente de Qwen y que su reproducción independiente es limitada.
Pruebas de programación reales: lo que encontraron los usuarios locales
Prueba con OpenCode Q4 en un M5 Pro
Un desarrollador ejecutó Muse Glimmer cuantizado a Q4, en la compilación de Unsloth, sobre un M5 Pro con 48 GB de RAM mediante OpenCode. El modelo utilizó aproximadamente 20 GB de RAM y generó 17 tokens por segundo. Su conclusión fue:
"En conjunto, queda por debajo de Qwen3.6 27B" - u/curiousily_
El código generado para frontend y backend recibió una valoración inferior a Qwen, aunque el autor destacó un punto positivo: Muse Glimmer no falló ninguna llamada a herramientas durante la prueba. No se configuraron bucles de razonamiento ni pensamiento extendido, algo que pudo limitar el rendimiento de Glimmer.
El problema de max_tokens
Otro usuario de r/LocalLLM descubrió que Muse Glimmer puede parecer mucho peor de lo que realmente es si el presupuesto de tokens de salida resulta demasiado bajo. El modelo consume ese presupuesto durante el razonamiento antes de generar una salida visible, con respuestas vacías o truncadas como resultado. Al aumentar max_tokens, su harness de pruebas pasó de 6/13 tareas superadas a 11/13, casi el doble de aciertos sin cambiar el modelo. Si pruebas Glimmer con los límites de salida predeterminados, quizá estés midiendo tu configuración y no el modelo.
Bucles en terminal con Hermes
Otro usuario informó de que Muse Glimmer se quedaba atascado ejecutando demasiados comandos de terminal al combinarlo con el framework de agentes Hermes, un comportamiento que no había encontrado con Qwen3.6-27B en la misma configuración. Esta anécdota encaja en dirección general con la diferencia observada en TerminalBench, aunque no permite aislar el modelo de la configuración de Hermes.
Eficiencia de tokens: una ventaja cualitativa
La publicación con la galería de benchmarks de u/NoFaithlessness951 planteó otra posibilidad relacionada con la eficiencia:
"Es un poco menos listo que Qwen, pero usa muchos menos tokens por tarea." - u/NoFaithlessness951
Se trata de una observación cualitativa de la comunidad, no de una medición controlada de tokens por tarea completada con éxito. Ningún estudio cara a cara ha cuantificado la ventaja de Glimmer en consumo de tokens frente a Qwen con tareas, tasas de éxito y datos de latencia equivalentes. Conviene tomar esta afirmación como una pista prometedora, no como un hecho establecido.
VRAM y contexto: la ventaja de hardware de Glimmer
Aquí Muse Glimmer toma una clara delantera. Un usuario de r/LocalLLaMA demostró que Muse Glimmer 30B en Q4_K_XL, con decodificación especulativa DFlash, proyector multimodal y caché KV completa en F16, cabe en aproximadamente 22-23 GB de una sola RTX 3090, con una ventana de contexto configurada de 262,144 tokens.
Misma RTX 3090 y misma cuantización Q4_K_XL:
| Modelo | Contexto KV F16 | Contexto KV Q8 | VRAM utilizada |
|---|---|---|---|
| Muse Glimmer 30B | 262,144 | N/A | ~22-23 GB |
| Qwen3.6-27B | 70,000 | 125,000 | Cabe en 24 GB |
| Gemma 4 31B | 52,000 | 81,000 | Cabe en 24 GB |
El autor calificó los 70K de contexto F16 de Qwen como "apenas utilizables" para flujos de trabajo que cargan en el prompt el contexto de repositorios grandes.
Rendimiento comunicado para Muse Glimmer en esa RTX 3090:
- Generación: 64-124 tokens por segundo, según fuera código o prosa
- Procesamiento del prompt: ~1,400 tokens por segundo
- Recuperación con contexto largo: superó en el primer intento una prueba de dos agujas en un pajar con ~150K tokens
En ese mismo hardware, Qwen3.6-27B necesita compresión de caché KV en Q8, sacrificando fidelidad de salida para ganar contexto, o descargarse parcialmente en una máquina más potente. El usuario indicó que trasladaba Qwen a su DGX Spark cuando necesitaba el contexto completo, un dispositivo considerablemente más caro.
Con hardware de gama más alta, una compilación NVFP4 de Qwen3.6-27B en una DGX Spark alcanzó 28-33 tokens por segundo en una única sesión y contextos de hasta 128K, según el análisis de benchmarks de kie.ai. Por su parte, una compilación Unsloth de Muse Glimmer Q5_K_M en una RTX 5090 alcanzó supuestamente 220-253 tokens por segundo al generar parches de código mediante una ruta DFlash modificada de llama.cpp.
Qué modelo elegir según tu caso
| Tu escenario | Elige | Motivo |
|---|---|---|
| Programación exclusivamente, generación de una sola pasada | Qwen3.6-27B | Evidencia publicada más sólida en benchmarks de programación; lidera la comparación comunitaria disponible de TerminalBench 2.1 |
| Programación agéntica con contexto grande en una sola GPU de 24 GB | Muse Glimmer 30B | 262K de contexto F16 frente a 70K de Qwen en el mismo hardware con la configuración Q4_K_XL/DFlash |
| Tareas largas en terminal | Qwen3.6-27B | 60.7 frente a 51.7 en TerminalBench 2.1; existen informes comunitarios de bucles de Glimmer en frameworks de agentes |
| Trabajo de alto volumen sensible al coste | Muse Glimmer 30B (posiblemente) | Un informe de la comunidad apunta a menos tokens por tarea; no hay comparación equivalente de coste por éxito |
| Programación a nivel de repositorio con contexto amplio | Muse Glimmer 30B (si la VRAM limita) | Qwen necesita compresión KV Q8 o varias GPU para manejar contexto grande con 24 GB |
| Máxima precisión al programar, sin restricciones de hardware | Qwen3.6-27B | Benchmarks publicados más sólidos y puntuaciones oficiales |
Preguntas frecuentes
¿Muse Glimmer tiene una puntuación oficial en SWE-bench?
No se encontró ninguna puntuación oficial de SWE-bench, LiveCodeBench o TerminalBench para Muse Glimmer 30B en las fuentes revisadas para esta comparativa hasta agosto de 2026. La puntuación de 51.7 en TerminalBench 2.1 procede de pruebas comunitarias publicadas en hilos de Reddit, no de una evaluación oficial de Meta.
¿Pueden ejecutarse ambos modelos en una sola RTX 3090?
Sí. Muse Glimmer 30B en Q4_K_XL cabe con 262K de contexto y caché KV F16 completa en ~22-23 GB. Qwen3.6-27B en Q4_K_XL también cabe, pero queda limitado a 70K de contexto F16 o 125K con compresión de caché KV Q8 en la misma GPU.
¿Muse Glimmer está censurado para tareas de programación?
Un usuario informó de que Muse Glimmer se negó a ayudar a depurar código Python para controlar un ratón, al plantearlo como una posible cuestión de seguridad. Es un único informe anecdótico, con un prompt de sistema y una configuración no especificados. No basta para determinar si ese comportamiento procede del propio modelo o del entorno de inferencia.
¿Cuál es mejor para flujos de programación agéntica?
Qwen3.6-27B parece más fiable para tareas de agentes de terminal a largo plazo, según las puntuaciones de TerminalBench y los informes de la comunidad. Muse Glimmer 30B es más viable con hardware limitado gracias a su eficiencia de VRAM y podría generar menos tokens por tarea, lo que reduciría el coste y la latencia en bucles de agentes de alto volumen, aunque todavía no hay una comparación controlada que lo cuantifique.
¿Qué valor de max_tokens debería usar para programar con Muse Glimmer?
Configura un presupuesto de salida generoso. Un usuario comprobó que límites ajustados de max_tokens hacían que Glimmer agotara el presupuesto durante el razonamiento antes de producir una respuesta visible, dando lugar a respuestas vacías o truncadas que parecían fallos. Al aumentar el límite, su harness pasó de 6/13 a 11/13 tareas superadas. La model card de Qwen3.6-27B recomienda 32,768 tokens para consultas generales y 81,920 para tareas difíciles de benchmark; hasta que Meta publique sus propias indicaciones, aplicar el mismo presupuesto de salida es un punto de partida razonable para Glimmer.