 AIREITER
¿Puede un modelo multimodal denso de 30B sustituir a Qwen 3.6 27B en hardware de consumo? Desde el lanzamiento de Muse Glimmer por parte de Meta el 10 de agosto de 2026, la comunidad de IA local ha puesto esa cuestión a prueba. La respuesta breve es matizada: cabe en una sola RTX 3090 con los 262K de contexto completos y alcanza 236 tok/s en una RTX 5090 con DFlash, pero pierde por 9 puntos frente a Qwen 3.6 27B en TerminalBench 2.1 y tiende a rechazar tareas de automatización a nivel del sistema operativo.
Qué es Muse Glimmer 30B
Muse Glimmer es un modelo multimodal denso de 30B parámetros, publicado por Meta Superintelligence Labs bajo licencia Apache 2.0. Está orientado específicamente a flujos de trabajo con agentes locales y residentes, no a liderar los rankings de programación. Combina un decodificador de texto de 27.9B con un codificador visual ViT de 1.9B y un proyector multimodal basado en GELU, por lo que entiende tanto texto como imágenes. Los detalles de arquitectura que aparecen a continuación proceden del blog de soporte Day-0 de SGLang.
Arquitectura de un vistazo
| Especificación | Detalle |
|---|---|
| Parámetros totales | 30B |
| Decodificador de texto | 27.9B denso |
| Codificador visual | ViT de 1.9B |
| Capas Transformer | 52 |
| Atención | Grouped-query (32 cabezas de consulta, 2 cabezas KV - GQA 16:1) |
| Feed-forward | SwiGLU |
| Ventana de contexto | 128K+ (probado hasta 262K) |
| Licencia | Apache 2.0 |
La arquitectura recurre a un esquema híbrido de atención: tres capas de atención con ventana deslizante de 2,048 tokens y, cada cuatro pasos, una capa de atención sobre la secuencia completa. El diseño combina RoPE en las capas de ventana local con NoPE en las de atención completa, lo que permite ampliar el contexto más allá del límite de entrenamiento. La proporción 16:1 de grouped-query attention mantiene reducido el caché KV: una medición de la comunidad sitúa su consumo en unos 1.8 GiB para 131K tokens en F16. Por eso el modelo puede mantener el contexto completo en una GPU de 24 GB, mientras Qwen 3.6 27B se queda en 70K tokens con la misma configuración F16.
¿Puede Muse Glimmer funcionar en tu hardware?
Depende en gran medida de la cuantización elegida. SGLang ofrece checkpoints oficiales en BF16, NVFP4+MXFP8, GGUF Q4_K_M, GGUF Q4K-Dynamic y MLX de 4 bits. La comunidad también ha llevado el modelo a GGUF de 2 bits para equipos con VRAM extremadamente limitada.
VRAM necesaria según la configuración
| Configuración | VRAM aproximada | Hardware objetivo |
|---|---|---|
| BF16 | ~60 GB | Una sola H100 |
| NVFP4 + MXFP8 | ~19.5 GB | RTX 5090 / DGX Spark |
| NVFP4 + BF16 DFlash | 18 GB + 5 GB para speculator | RTX 5090 |
| Q4_K_XL + DFlash + mmproj + contexto de 262K | ~22-23 GB | RTX 3090 (24 GB) |
| GGUF de 2 bits | ~14 GB | RTX 4060 Ti / gama inferior |
| MLX Q4 (Apple Silicon) | Memoria unificada | Mac mini / MacBook Pro |
Un usuario de Reddit demostró que Muse Glimmer en Q4_K_XL, con decodificación especulativa DFlash, el archivo de proyección multimodal y caché KV F16, entra holgadamente en 22-23 GB de una sola RTX 3090, con los 262,144 tokens de contexto activos. En el primer intento recuperó dos agujas de un pajar de aproximadamente 150K tokens.
Como referencia, Qwen 3.6 27B en esa misma RTX 3090 solo alcanza 70K tokens con caché KV F16, o 125K con caché KV Q8. Gemma 4 31B llega a 52K en F16, u 81K en Q8. La eficiencia del caché KV que aporta la proporción GQA 16:1 de Muse Glimmer es la razón principal de que pueda mantener más contexto con el mismo hardware.
Opciones de instalación: En NVIDIA, usa SGLang o llama.cpp con el checkpoint NVFP4 o GGUF y activa --speculative-algorithm DFLASH. En Apple Silicon, utiliza el backend MLX; DFlash no está disponible. Un usuario con un M3 Max y 96 GB de memoria unificada reportó 17 tokens/s y señaló que Muse Glimmer era más rápido que Qwen y Gemma en ese sistema.
Rendimiento de Muse Glimmer
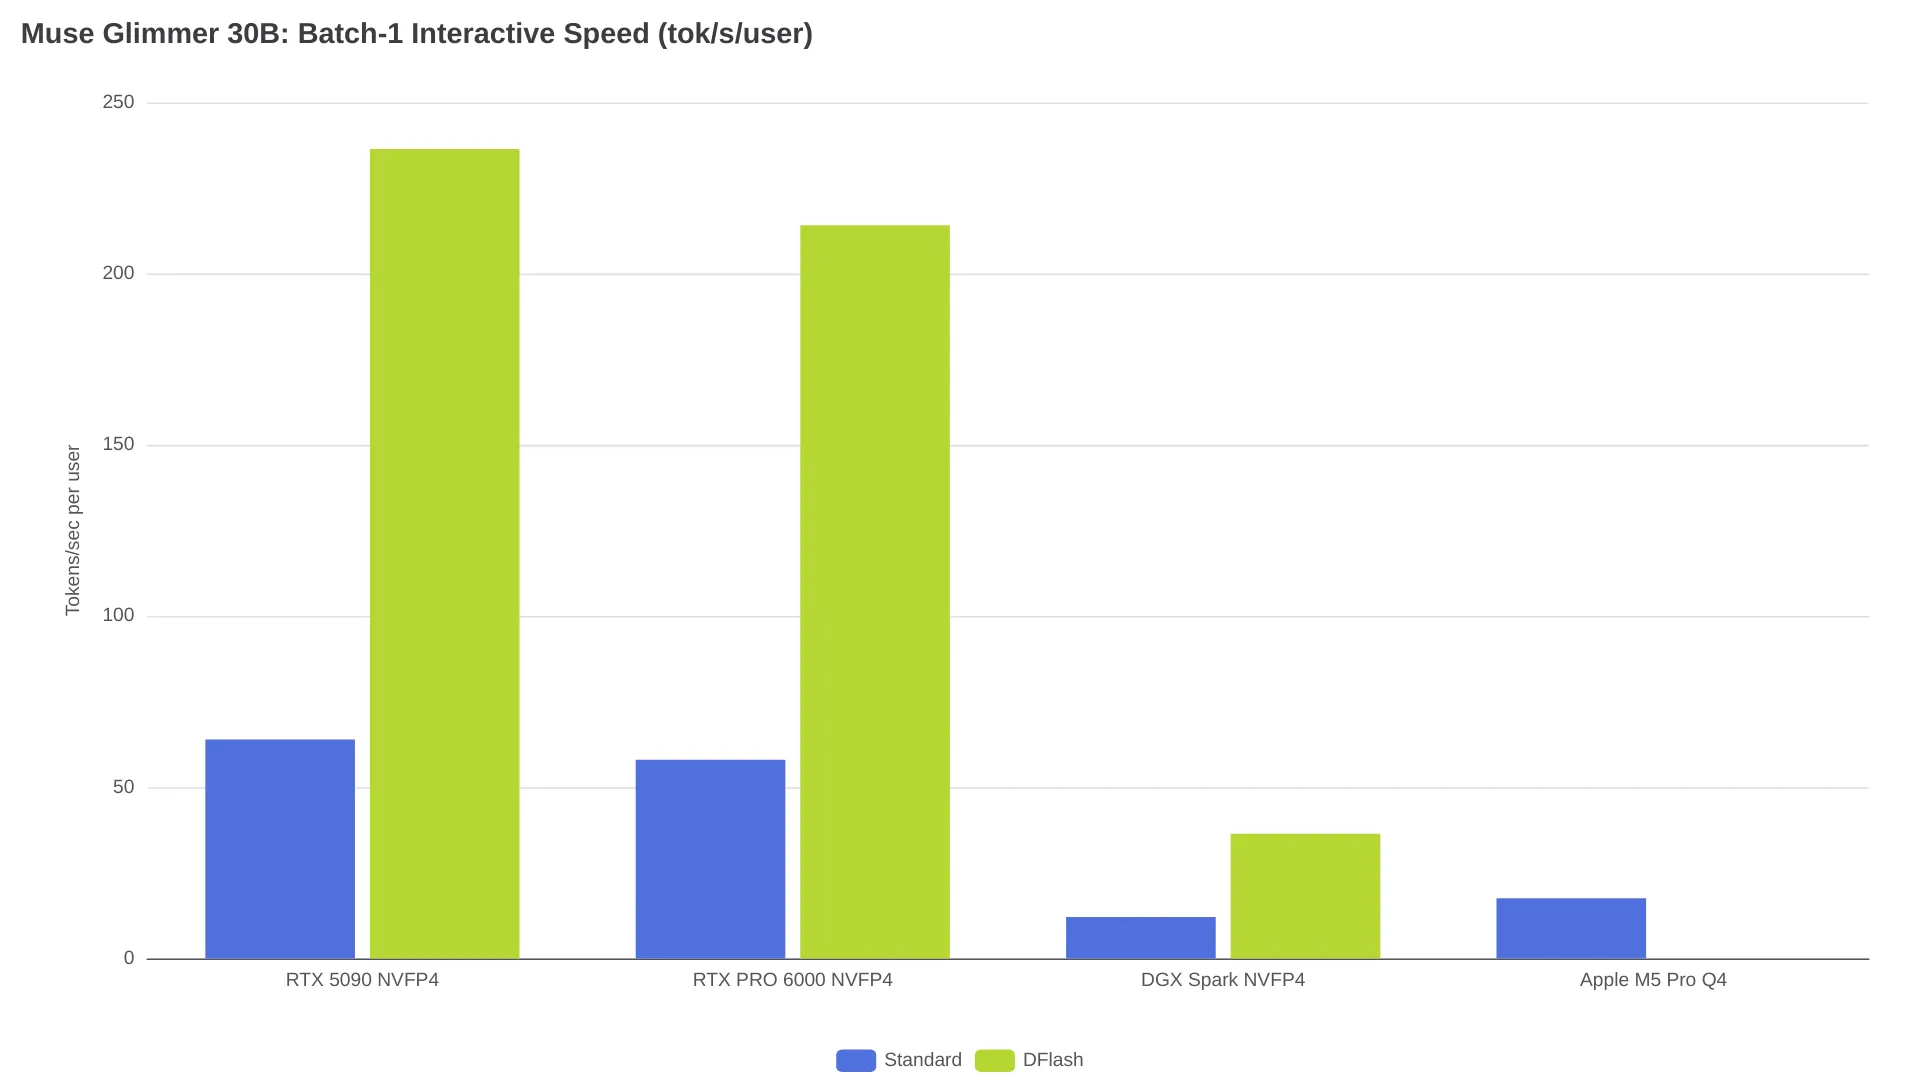
SGLang publicó una tabla de benchmarks en siete configuraciones de hardware, con tamaños de lote de 1 a 8. La decodificación especulativa DFlash, activada con --speculative-algorithm DFLASH, acelera entre 1.9x y 4.3x el rendimiento interactivo con lote 1 en plataformas NVIDIA.
Cifras clave de los benchmarks de SGLang
| Plataforma | Precisión | Decodificación | tok/s/usuario con lote 1 | tok/s con lote 8 |
|---|---|---|---|---|
| NVIDIA B300 | BF16 | DFlash | 308.51 | 261 |
| RTX 5090 | NVFP4 | DFlash | 236.4 | 1,452 |
| RTX 5090 | Q4_K_M | DFlash | 140.7 | 332 |
| RTX PRO 6000 | NVFP4 | DFlash | 214.11 | 403 |
| DGX Spark | NVFP4 | DFlash | 36.4 | 301 |
| Apple M5 Pro | Q4 | Estándar | 17.6 | 56.9 |
Los 1,452 tokens de salida por segundo con lote 8 en una RTX 5090 representan rendimiento agregado. Para la inferencia local de un único usuario, la cifra relevante son los 236 tok/s con DFlash y NVFP4. Sin DFlash, esa misma configuración baja a 63.9 tok/s. Los informes de la comunidad son coherentes con ello: un usuario con una RTX 5090 y la cuantización Q5_K_M de Unsloth comunicó entre 220 y 253 tokens/s.
El rendimiento de DFlash depende de las tasas de aceptación de los borradores. Usuarios con Vulkan/RX 7900 XTX y SYCL/B70 reportaron una aceptación baja de borradores y un rendimiento global más lento.
Muse Glimmer frente a Qwen 3.6 27B: cuál elegir
Resultados en TerminalBench 2.1
| Modelo | TerminalBench 2.1 | Contexto en RTX 3090 (KV F16) |
|---|---|---|
| Qwen 3.6 27B | 60.7 | ~70K tokens |
| Muse Glimmer 30B | 51.7 | ~262K tokens |
| Gemma 4 31B | 43.4 | ~52K tokens |
Puntuaciones de TerminalBench 2.1 citadas en una discusión de la comunidad. Cifras de contexto procedentes de pruebas en una RTX 3090.
Qwen 3.6 27B aventaja en 9 puntos a Muse Glimmer en TerminalBench 2.1, el benchmark que buena parte de la comunidad considera clave para medir si un modelo puede ejecutar comandos de terminal de forma fiable durante tareas largas. La diferencia también se repite en pruebas directas de programación: la suite de evaluación privada de un usuario dio 12/13 a Qwen y 11/13 a Glimmer. Qwen generó correctamente a la primera una página de turismo de Tokio de 953 líneas, mientras que Glimmer produjo menos de 200 líneas (hilo completo).
"Ni se acerca a Qwen 3.6 27B" —usuario de Reddit BarberIcy366, después de que Glimmer generara solo 220 líneas de HTML para un juego de billar de bola 8 tras consumir 21,000 tokens (r/LocalLLaMA). En el mismo hilo se informa de que Qwen 3.6 27B completó una implementación de Tetris 1.7x más rápido con MTP activado.
Aun así, Glimmer tiene ventajas reales en ámbitos concretos:
- Capacidad de contexto: 262K tokens en una sola RTX 3090 frente a 70K de Qwen con el mismo ajuste KV F16; una ventaja de 3.7x para trabajar con bases de código grandes.
- Eficiencia del caché KV: La proporción GQA 16:1 hace que el caché KV de Glimmer sea mucho menor y deja más VRAM disponible para contexto.
- Capacidad visual: Glimmer es multimodal de serie; Qwen 3.6 27B es solo de texto en su versión base.
- MCP y preguntas y respuestas con herramientas: Un usuario señaló que, aunque Glimmer queda por detrás de Qwen para programar en terminal, promete en flujos de búsqueda en bases de código y preguntas y respuestas asistidos por MCP.
- Calidad de redacción: Varios usuarios prefirieron la salida en lenguaje natural de Glimmer frente a la de Qwen.
Un comentario resumió el equilibrio así: Glimmer es «Qwen 3.6 27B con un 5% más de estilo de escritura y un 5% menos de capacidad agéntica».
Veredicto
Si tu carga de trabajo principal es la programación de una sola pasada o los agentes autónomos de terminal, Qwen 3.6 27B sigue siendo la opción más sólida: obtuvo 9 puntos más en TerminalBench 2.1 y no presenta los rechazos de seguridad que dificultan la automatización a nivel de sistema operativo en Glimmer. Si necesitas recuperación con contexto largo, entradas multimodales o flujos asistidos por MCP en una única GPU de consumo, merece la pena probar Muse Glimmer. Si requieres automatización fiable de terminal, espera a los fine-tunes de la comunidad.
Problemas conocidos y puntos a vigilar
La trampa de max_tokens
Muse Glimmer consume una parte importante de su presupuesto de tokens en razonamiento interno antes de producir una salida. Si max_tokens se establece demasiado bajo, el modelo puede agotar el presupuesto a mitad de razonamiento y devolver una respuesta vacía. Un usuario obtuvo inicialmente un 6/13 con Glimmer en su suite de evaluación; al aumentar el presupuesto de tokens de salida, llegó a 11/13 (hilo de referencia). Ajusta max_tokens lo bastante alto como para cubrir esa sobrecarga de razonamiento o las respuestas pueden terminar a mitad de idea.
Rechazos de seguridad en automatización del sistema operativo
Varios usuarios informan de que Muse Glimmer rechaza tareas que implican controlar el ratón, automatizar el teclado u otras llamadas a herramientas a nivel de sistema operativo. El modelo las plantea como posibles riesgos de seguridad, incluso cuando la solicitud se limita al uso habitual de bibliotecas de Python.
"Mover un ratón mediante programación puede usarse indebidamente para automatización, clickjacking o para sortear avisos de seguridad." —rechazo de Muse Glimmer comunicado por el usuario de Reddit Cold_Tree190 (r/LocalLLaMA)
Iniciar una sesión nueva aportando más contexto sobre el caso de uso previsto puede resolver el rechazo en ocasiones. Sin embargo, si el modelo ya se ha negado dentro de una sesión, suele mantener su postura.
Llamadas a herramientas poco consistentes
Los informes de la comunidad sobre la fiabilidad de las llamadas a herramientas van desde «no ha fallado ni una vez» en una base de código C hasta bucles interminables y respuestas API vacías en otras configuraciones. En algunos casos, las cuantizaciones Unsloth Q4 y Q5 entraban en muchos bucles durante las llamadas a herramientas, mientras que los GGUF oficiales orientados a 24 GB y 32 GB de VRAM podrían comportarse de forma más fiable (hilo de referencia).
Restricciones regionales de descarga
Según los informes, la página oficial de Hugging Face desactiva las descargas en Hong Kong, Macao y China. Como alternativa, siguen disponibles distribuciones GGUF de terceros de Unsloth.
Lecturas relacionadas: Guía de precios de la API de Muse Spark 1.2 | Los mejores modelos gratuitos de OpenRouter para programación en 2026