 AIREITER
Los embeddings multivector ya son ciudadanos de primera clase en Sentence Transformers. La versión 6.0, anunciada el 18 de agosto de 2026, incorpora MultiVectorEncoder junto a los modelos densos, dispersos y rerankers. Pero los benchmarks de lanzamiento de Hugging Face rebajan bastante las expectativas: la interacción tardía superó a su gemelo denso idéntico en 9 de los 13 conjuntos de datos de NanoBEIR, con una ventaja media de alrededor de un punto de NDCG@10. A cambio, el índice sin comprimir del ejemplo ocupa 42 veces más que la referencia MiniLM de 384 dimensiones, y todavía 21 veces más que un modelo denso de tamaño comparable. La decisión depende, sobre todo, de qué tipo de consultas recibes.
Qué son los embeddings multivector con interacción tardía
En vez de condensar todo un documento en un único vector agregado, un modelo multivector conserva un vector por token. En los modelos compatibles de Hugging Face, esos vectores de token suelen tener 128 dimensiones, frente a las 384, 768 o 1.024 de un embedding denso convencional. Al puntuar, el operador MaxSim busca para cada token de la consulta el producto escalar más alto frente a cualquier token del documento, y suma después esos máximos: MaxSim(Q,D) = Σᵢ maxⱼ(qᵢ · dⱼ). Como estos modelos están normalizados con L2, cada componente queda en el intervalo [-1, 1], y la puntuación final crece con la longitud de la consulta.
La interacción tardía queda así a medio camino entre las dos arquitecturas de las que toma elementos:
| Arquitectura | Lado del documento | Puntuación | Perfil de coste |
|---|---|---|---|
| Bi-encoder denso | Un vector agregado, precalculado | Un único producto escalar | La recuperación más rápida; el pooling pierde detalle de los tokens |
| Interacción tardía | Un vector por token, precalculado | MaxSim entre pares de tokens | Emparejamiento más rico; el índice crece con la longitud del documento |
| Cross-encoder | No se precalcula nada | Una pasada completa por cada par consulta-documento | El más preciso por par en el artículo de lanzamiento de Hugging Face; demasiado costoso como primera etapa |
El artículo original de ColBERT definió este enfoque como «interacción tardía contextualizada».
Su ventaja se aprecia a nivel de token. En el ejemplo de Hugging Face con lightonai/mLateOn, el token de consulta «live» se emparejó con el token «inhabit» del documento con una similitud de 0.94: una relación semántica sin ninguna coincidencia léxica.
Los casos en los que un modelo multivector marca la diferencia
Los benchmarks de pasajes cortos no reflejan del todo dónde se justifican estos modelos. Los escenarios más favorables se repiten en las cinco fuentes comparadas para este artículo: el anuncio de Hugging Face, TopK, el análisis técnico de Qdrant, la guía de producción de Data AI Hub y la comparativa de búsqueda en producción de Suhas Bhairav:
- Identificadores exactos dentro de búsquedas semánticas. Códigos de producto, nombres de funciones, apellidos, cadenas de error o números de cláusulas. Un vector agregado los difumina; los vectores por token permiten localizarlos.
- Consultas con varias condiciones. En una búsqueda como «X con Y y Z», cada token de la consulta puede encontrar de forma independiente el token que lo respalda en el documento, sin que ninguna condición se diluya en un promedio.
- Documentos largos cuyo resultado relevante es un pasaje menor. En el benchmark multilingüe de documentos largos MLDR, el modelo multivector
mLateOnobtuvo 77.92 frente a 51.59 demDenseOn: una diferencia de un orden de magnitud mayor que los promedios de pasajes cortos. - PDF, tablas y páginas escaneadas. Los modelos de la familia ColPali indexan directamente imágenes de páginas a partir de consultas de texto, sin OCR. El anuncio de Hugging Face sitúa la recuperación visual de documentos como el terreno de referencia de la interacción tardía, y el análisis de TopK informa de que un recuperador multivector compacto superó en +34% de recall en ViDoRe v3 a un modelo de vector único 80 veces mayor, elevando el recall en documentos industriales de aproximadamente 42% a 76%.
- Vocabulario fuera del dominio. El anuncio de Hugging Face señala mejoras con datos ajenos al dominio de entrenamiento, donde la compresión aprendida por un modelo denso puede eliminar detalles necesarios para las consultas de producción.
Las cifras de Hugging Face ayudan a entender por qué la recuperación visual encaja tan bien: una página renderizada genera alrededor de 755 vectores de token con colqwen2.5-v0.2, frente a unos 125 en un pasaje de texto medio. Cuanto más rica sea la página —gráficos, maquetación, tablas—, más información tendrá que descartar un único vector agregado.
La mejora de calidad existe, pero es más limitada que el hype
La comparación más limpia es la pareja de LightOn: LateOn y DenseOn comparten el mismo backbone ModernBERT de 149M parámetros y los mismos datos de entrenamiento. Solo cambia la cabeza del modelo: vectores de token de 128 dimensiones frente a un único vector de documento de 768 dimensiones.
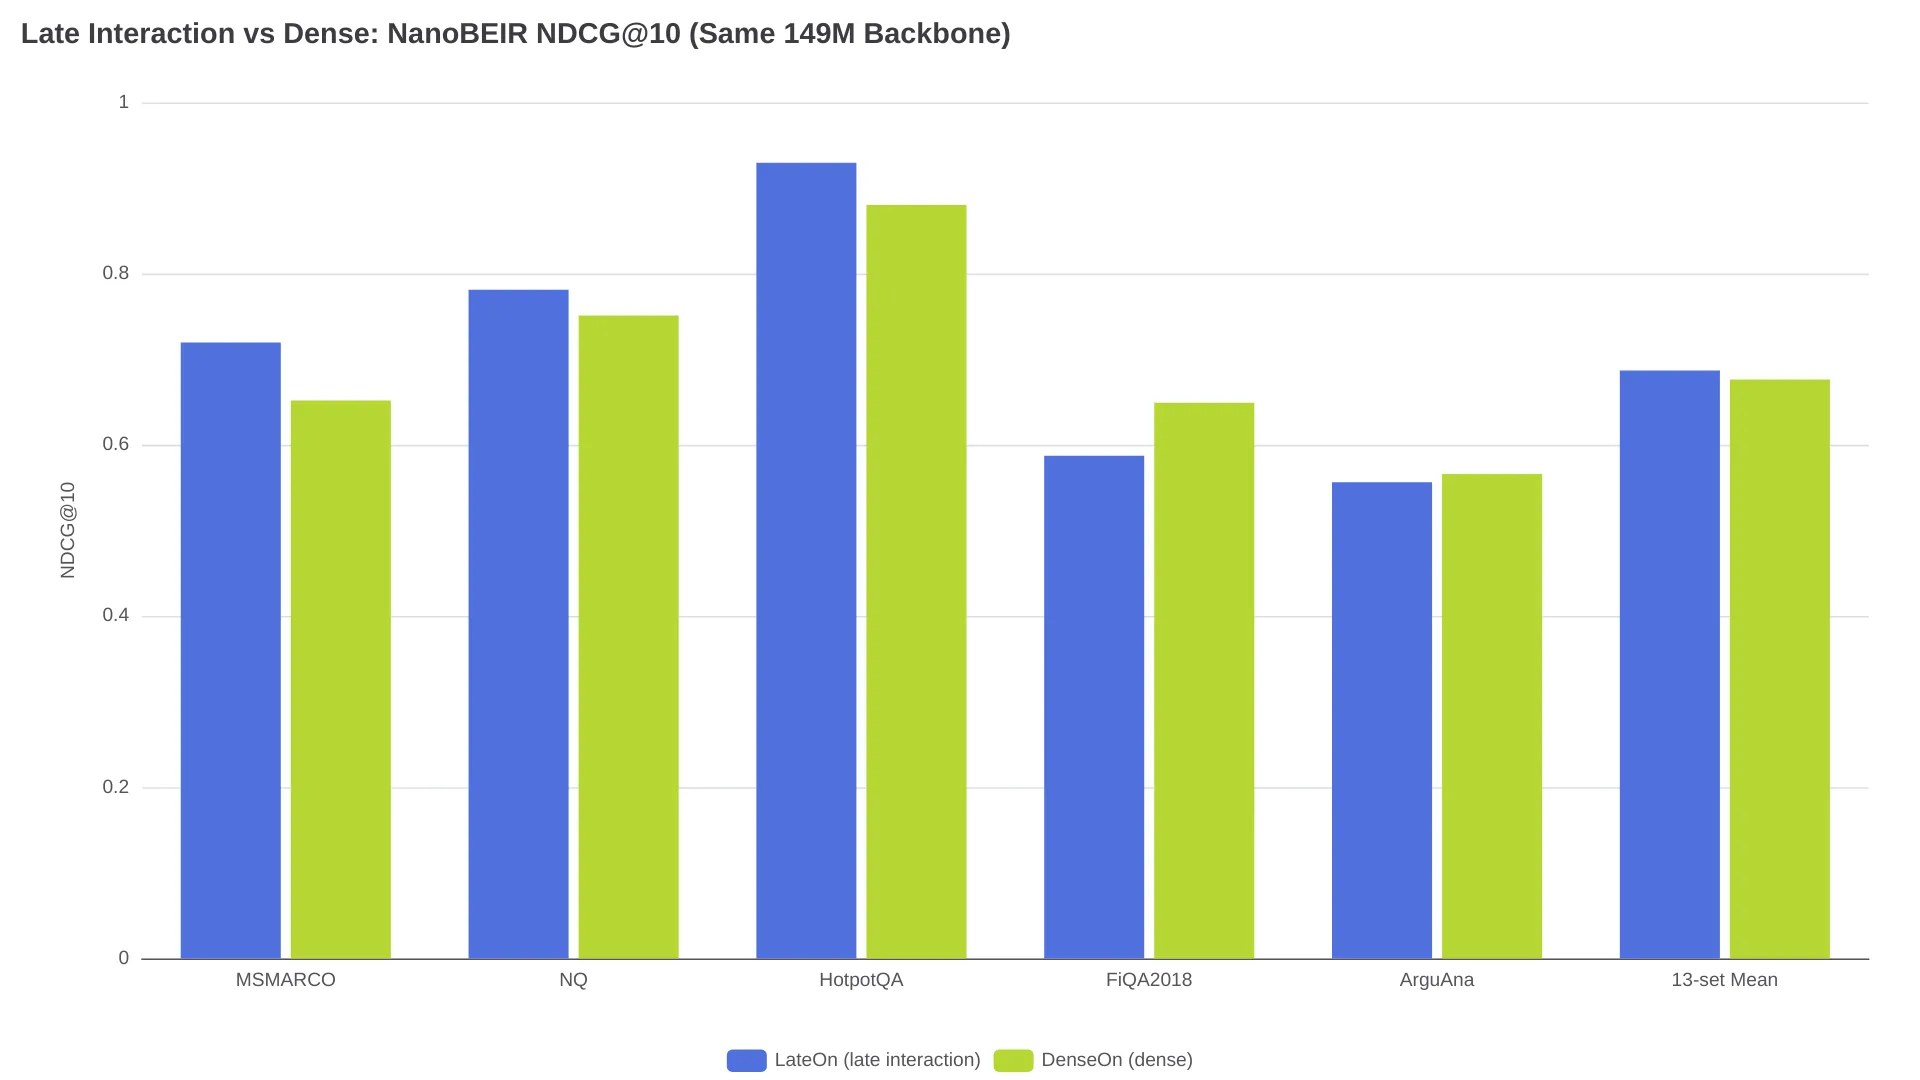
LateOn gana en 9 de los 13 conjuntos de NanoBEIR y también en la media: 0.6868 frente a 0.6764 NDCG@10. En los 15 conjuntos completos de BEIR, logra 57.22 frente a 56.20. DenseOn sigue imponiéndose claramente en ArguAna, FiQA2018, SCIDOCS y SciFact. Esa es la lectura honesta: una mejora media relevante con el mismo tamaño de modelo, no un salto de categoría.
Tras el anuncio de la versión 6.0 por parte del mantenedor Tom Aarsen, el desarrollador @saen_dev formuló la duda que muchos profesionales repetían: «¿Cómo rinde frente a los bi-encoders en corpus específicos de dominio?» (hilo). La respuesta honesta es alrededor de un punto de media, con las grandes ganancias concentradas en documentos extensos. El propio anuncio de Hugging Face recomienda evaluar cada tarea de recuperación concreta, porque las mejoras varían según el conjunto de datos.
El coste de almacenamiento: 42x antes de comprimir
El ejemplo de Hugging Face calcula el tamaño de un índice sobre 4.874 pasajes de Natural Questions. lightonai/LateOn genera 608.414 vectores de token, una media de 124.8 vectores por pasaje.
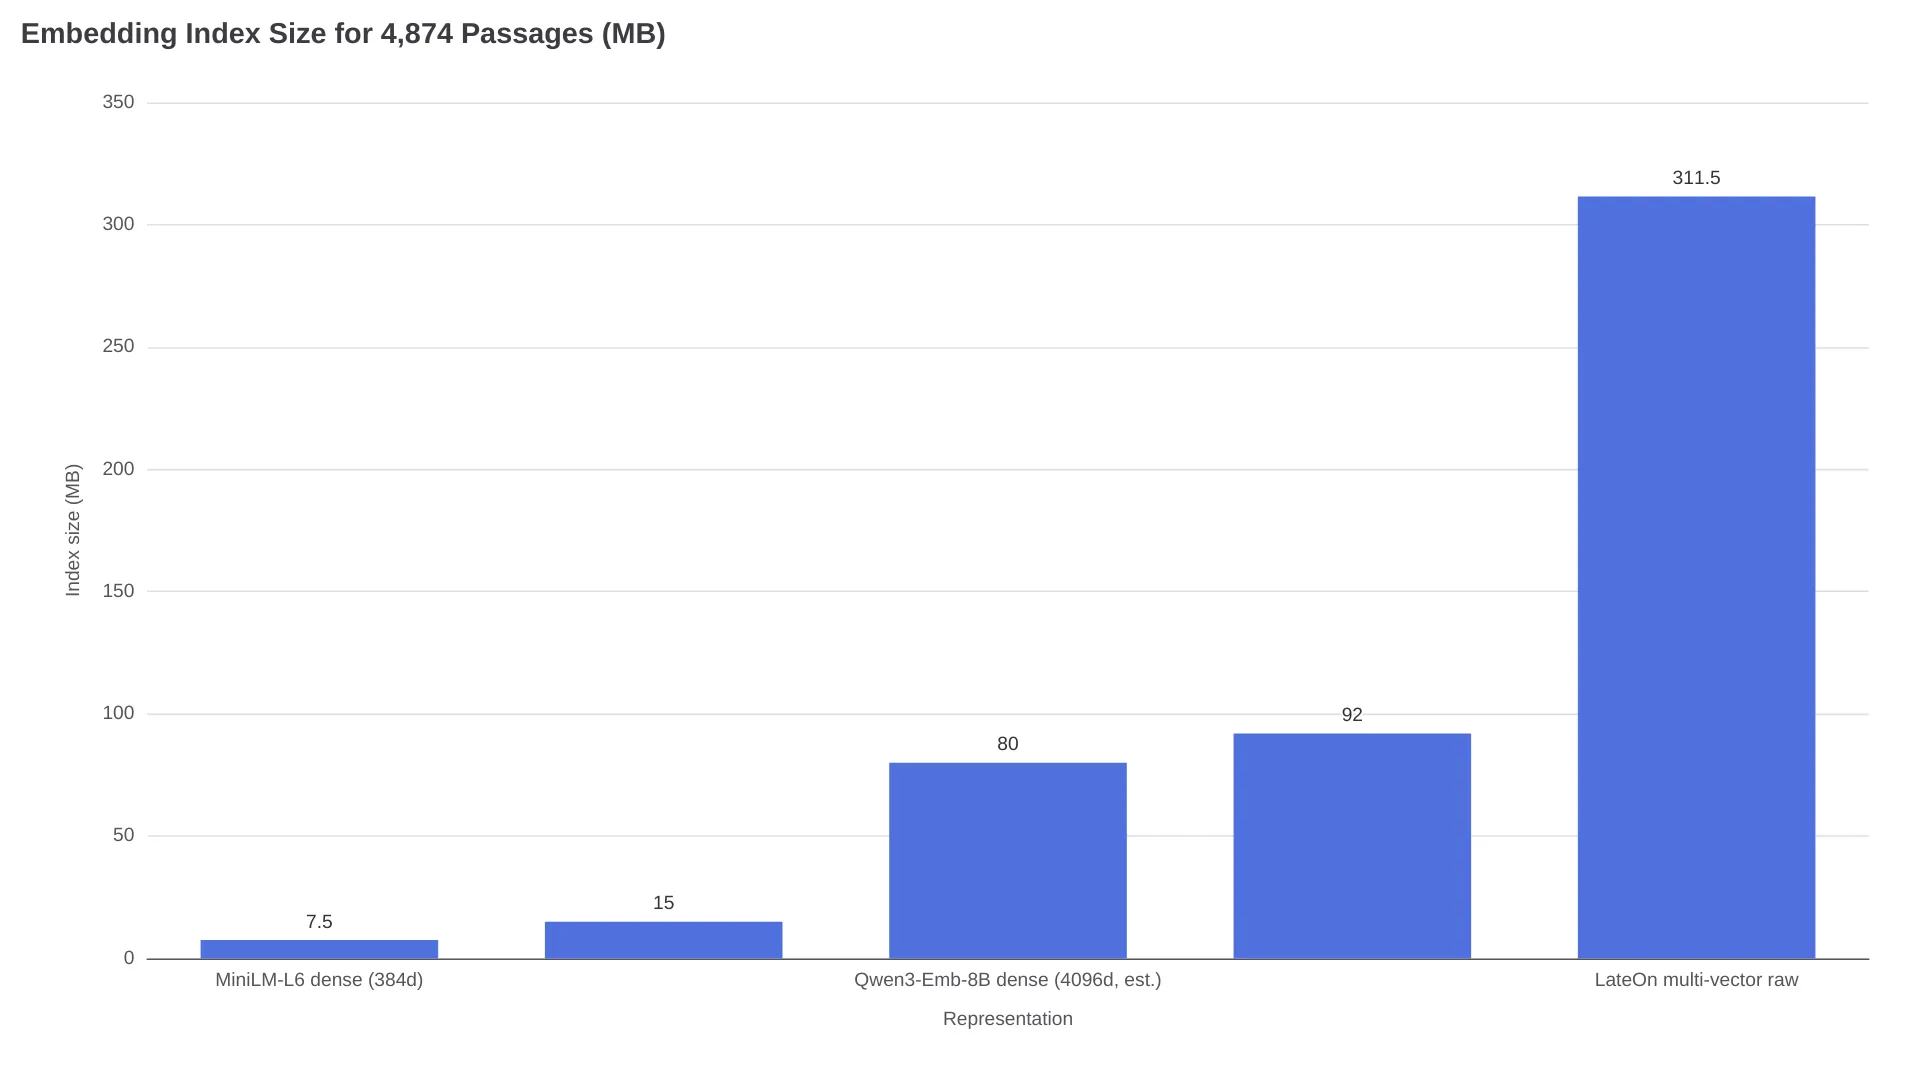
El índice multivector sin comprimir en float32 ocupa 311.5 MB. Los mismos pasajes con el modelo denso all-MiniLM-L6-v2 necesitan 7.5 MB: una diferencia de 42x, o 62 KiB por pasaje. Frente a gte-modernbert-base, un modelo denso de 768 dimensiones de la misma categoría, la diferencia es de 21x (15 MB). TopK sitúa el rango entre 10–100x según la longitud del documento y la precisión, y estima miles de veces más trabajo de puntuación por consulta que en una comparación de vector único.
El día del lanzamiento, un desarrollador resumió sin rodeos la preocupación de producción:
El pooling de tokens es lo que decide si esto llega a producción. La interacción tardía suele morir por el tamaño del índice y la memoria, no por la precisión. - @JudeJobs en X
Como referencia, un índice denso Qwen3-Embedding-8B de 4.096 dimensiones sobre el mismo corpus ocupa unos 80 MB, cerca de los 92 MB del índice de interacción tardía comprimido que aparece más abajo.
Tres formas de reducir el índice
1. Pooling de tokens. Sentence Transformers v6.0 incluye HierarchicalTokenPooling, que agrupa los vectores de token del documento mediante enlace de Ward sobre distancia coseno y sustituye cada grupo por su media. Por defecto, el pooling solo se aplica a los documentos: las consultas son cortas y más sensibles a la distorsión. En el corpus de 608.414 vectores:
| Factor de pooling | Vectores de token | Índice float32 | Retención de recuperación reportada |
|---|---|---|---|
| 1 (sin pooling) | 608.414 | 311.5 MB | 100% |
| 2 | 305.438 | 156.4 MB | 100.6% |
| 3 | 204.407 | 104.7 MB | 99.0% |
| 4 | 153.936 | 78.8 MB | tendencia de ~98% |
El pooling del corpus completo tardó unos 6 segundos. La variante regularizada de LightOn reporta 99.4% de calidad con una compresión de 5x en el artículo de Hugging Face, aunque Hugging Face indica que el entrenamiento con ese regularizador todavía no estaba integrado en la biblioteca al publicar v6.0.
2. Índices comprimidos. Un índice fast-plaid (Rust PLAID) con los mismos vectores ocupa 92 MB, se construye en 5 segundos y responde en 11 ms con una RTX 3090 + i7-13700K. Es aproximado: en la prueba de Hugging Face, las mejores puntuaciones pasaron de 11.92 a 11.88, aunque se mantuvo el orden del ranking. MUVERA de Weaviate aceleró la ingesta 3x y las consultas 1.8x, pero perdió un resultado correcto dentro de los 50 primeros en su corpus de prueba.
3. Cuantización y ajuste de inferencia. Los experimentos de Qdrant con cuantización escalar uint8 sobre embeddings de token redujeron la memoria 4x, mientras SciFact NDCG@10 pasó de 0.70724 a 0.70297: una variación despreciable. Hugging Face informa de que fp16 junto con Flash Attention alcanza 2.44x el rendimiento de codificación de fp32 sin pérdida de calidad medida; int8 en CPU cuesta alrededor de 0.4% de precisión.
Si combinas pooling con factor 2–3 e índice comprimido, la diferencia efectiva frente a los vectores densos baja de 42x a una cifra de un solo dígito, a costa de incorporar dos controles más que ajustar.
La arquitectura por defecto: reranker primero
MaxSim exhaustivo puntuó los 4.874 documentos en 98 ms, o 122.7 ms de extremo a extremo, sobre una única RTX 3090. Es perfectamente válido para unos miles de documentos, pero su coste lineal se vuelve inviable con millones. Las tres guías de despliegue comparadas aquí coinciden en la misma arquitectura: una primera etapa densa o dispersa barata recupera candidatos, y la interacción tardía los reordena.
- El ejemplo de Hugging Face recupera los 50 mejores resultados densos y después aplica reranking con MaxSim. Los documentos se codifican una sola vez en lote y se puntúan con multiplicación de matrices, mucho más barato que una pasada de cross-encoder por cada par.
- Qdrant, que ofrece soporte nativo para multivector desde v1.10, recomienda usar interacción tardía sobre todo para rerankear unos cientos de candidatos, no para escaneos completos.
- La guía de producción de Data AI Hub propone recuperación híbrida de los 150 primeros, reranking por interacción tardía hasta 20 y, opcionalmente, un cross-encoder para los 5 finales enviados al LLM.
El patrón de solo reranking tiene un límite ineludible: no puede recuperar documentos que la primera etapa no encontró. Además, el resto del pipeline dista mucho de estar resuelto:
apenas existe una estrategia universalmente buena de chunking, recuperación y reranking. - u/gamerx88, r/MachineLearning
Qué bases de datos lo soportan y con qué limitaciones
El artículo de lanzamiento de Hugging Face compara los principales motores sobre el mismo corpus de 4.874 pasajes. Las cifras siguientes proceden de sus pruebas, no del marketing de los proveedores:
| Motor | Multivector nativo desde | Ingesta / consulta (su prueba) | Limitaciones |
|---|---|---|---|
| Qdrant | v1.10 | 26.3 s / 18 ms | MAX_SIM exacto; se recomienda servidor |
| Weaviate | v1.29 | 41 s / 17 ms | MUVERA es más rápido, pero perdió un resultado correcto; sin modo embebido en Windows |
| Vespa | «desde hace años» | ~80 s / 75 ms en caliente | MaxSim como expresión tensorial; la segunda fase por defecto solo reordena 100 candidatos y perdió 2 de los 3 mejores resultados correctos |
fast-plaid | - | 5 s / 11 ms | Sin servidor; puntuaciones aproximadas, aunque se mantuvo el ranking |
| LanceDB | v0.15.0 | sin benchmark | MaxSim nativo |
| Milvus | v2.6.4 | sin benchmark | Almacenamiento como array de estructuras |
| VectorChord | - | sin benchmark | Operador MaxSim para PostgreSQL |
| Elasticsearch / OpenSearch | - | - | Solo rescore; la función de ES es una vista previa técnica en el nivel Enterprise |
La indexación de interacción tardía de turbopuffer figuraba como beta privada en la tabla comparativa de Hugging Face.
Qué cambia con Sentence Transformers v6.0
Antes del 18 de agosto de 2026, ejecutar modelos de la familia ColBERT exigía frameworks independientes: PyLate, el repositorio Stanford ColBERT o colpali-engine. La versión 6.0 convierte MultiVectorEncoder en el cuarto tipo de modelo de primera clase de la biblioteca, con entrenamiento, inferencia e interpretabilidad integrados. Carga checkpoints de Sentence Transformers, PyLate, Stanford ColBERT y ColPali; también puede cargar un transformer sin más, pero con una proyección aleatoria que requiere entrenamiento. Los requisitos son transformers v5.x, torch 2.2+ y huggingface-hub v1.x.
Tres trampas de la documentación de lanzamiento:
- Consultas y documentos no son simétricos.
encode_query()yencode_document()aplican prompts, límites de longitud y máscaras de puntuación distintos. Usarencode()de forma genérica para ambos es la manera más rápida de degradar los resultados sin darte cuenta. - El truncamiento no avisa. Un pasaje de 662 tokens enviado al límite de 300 tokens de documento de LateOn produjo 273 vectores; el resto se descartó. Subir el límite a 512 funciona, pero aleja al modelo de su distribución de entrenamiento y aumenta el índice.
- Flash Attention tiene excepciones. Los modelos con expansión de consulta no atendible, entre ellos
colbert-ir/colbertv2.0yanswerai-colbert-small-v1, necesitan"sdpa"en su lugar.
Según las puntuaciones publicadas por Hugging Face, el catálogo de modelos compatibles abarca dos órdenes de magnitud:
| Segmento | Modelo de ejemplo (parámetros) | Puntuación (NDCG@10 medio) |
|---|---|---|
| Texto para edge | mxbai-edge-colbert-v0-17m (17M) | 0.6407 NanoBEIR |
| Texto pequeño | answerai-colbert-small-v1 (33M) | 0.6550 NanoBEIR |
| Líder en texto | Familia LateOn (149M) | 0.6868–0.6897 NanoBEIR |
| Documento visual | colqwen2.5-v0.2 (3.8B) / webAI-ColVec1.1-8b (8.4B) | 0.5402 / 0.6580 NanoViDoRe |
Cuándo los vectores densos únicos siguen siendo la opción correcta
El error que conviene evitar es adoptar multivector para cargas que no lo necesitan. Prescinde de él si las consultas son amplias y temáticas («artículos sobre cadenas de suministro»), si los textos son cortos —títulos, pares de preguntas frecuentes o tuits—, si la tarea es clustering, deduplicación o recomendación, es decir, cualquier caso que requiera similitud del elemento completo, o si una canalización densa con reranker ya cumple tus SLO de recall y el coste es la restricción principal. La guía de Data AI Hub añade que los checkpoints ColBERT centrados en inglés pueden rendir peor que una combinación de bi-encoder multilingüe y reranker en corpus multilingües, y que los corpus con muchas escrituras y actualizaciones en tiempo real encajan mal con índices a nivel de token.
Preguntas habituales, respondidas con cifras
¿Se puede usar un modelo denso convencional como modelo multivector?
A veces, y con resultados sorprendentes. Los experimentos de Qdrant tomaron los embeddings de token de salida de BAAI/bge-small-en, un modelo denso de 33M, y los puntuaron con MaxSim: 0.73696 NDCG@10 en SciFact, por encima de colbert-ir/colbertv2.0 con 0.69579 y del propio vector agregado de bge-small con 0.68213. En ArguAna, el orden se invirtió y ganó el denso agregado. Es una técnica válida para añadir una fase de reranking sin un modelo nuevo, no una garantía.
¿Cuánto acelera un índice multivector comprimido?
En el corpus de 4.874 pasajes: MaxSim exhaustivo tarda 98 ms, frente a 11 ms de fast-plaid, con 92 MB en lugar de 311.5 MB.
¿Los modelos multivector sustituyen a los rerankers cross-encoder?
En términos económicos, sí: las representaciones de documentos se precalculan y se puntúan con multiplicación de matrices en vez de una pasada por cada par consulta-documento. Aun así, el artículo de lanzamiento de Hugging Face sitúa al cross-encoder como la opción más precisa por par, de ahí que los pipelines exigentes lo mantengan para los 5–20 resultados finales.
¿Merece la pena la interacción tardía para RAG?
Como etapa de reranking sobre candidatos híbridos o densos, sí: es el patrón que recomiendan las tres guías de despliegue anteriores. Como recuperador de primera etapa, solo si el recall medido en esa primera fase es tu problema y el índice de vectores de token cabe en tu presupuesto.
Tabla de decisión
| Tu carga de trabajo | Recomendación |
|---|---|
| Consultas cargadas de identificadores o con varias condiciones, documentos largos, texto legal o técnico | Recuperación o reranking multivector: este es el territorio de los +26 puntos de MLDR |
| PDF, páginas escaneadas, tablas o gráficos como imágenes de página | Multivector de la familia ColPali; no hace falta una canalización de OCR |
| Búsqueda temática amplia, textos cortos, clustering/deduplicación/recsys | Vectores densos únicos; aquí las pérdidas del pooling son irrelevantes |
| La calidad casi alcanza el objetivo, pero el presupuesto es ajustado | Mantén una primera etapa densa y añade reranking MaxSim a los 50–150 mejores |
| Millones de documentos y coste como restricción principal | Denso + reranker cross-encoder, o interacción tardía comprimida —pooling de factor 2–3 + fast-plaid— tras medir |
Queda pendiente la disyuntiva que señaló @JudeJobs: la retención tras comprimir se mide en benchmarks, no en corpus de producción desordenados. Empieza con pooling de factor 2 y deja que el recall medido sobre tus propios datos determine hasta dónde bajar por la curva de compresión.